В контексте кубера?
Нет. Базы в кубе - чур меня
 Oleg


 Ivan
https://youtu.be/7CR5eH6a8Fo
Шотам? Столяров опять рассказывает, что нужно все переписать на руби и собрать монолит из микросервисов?
 𝚔𝚟𝚊𝚙𝚜
искази - это вобще протокол.
В этом котексте я имел ввиду различные хардверные решения, ынтырпайз СХД или простая хранилка с рейдом и доступом по iscsi
Oleg
Я для теста запихивал Прометей в цеф. И благополучно проебал данные. Нет, сделав бы лишние движения все бы восстановил. Но... это такое.
 Oleg
Сейчас у нас цель - базы на железе, вычислительная нагрузка в кубе
Oleg
Ну а пока... 2к виртуалок

 Михаил
Про стейтфулл согласен, но в кубе в вм есть смысл. Оркестратор оркестратору рознь
Я не против куба в вм. Мне не понятно куб со стейтом в вм)
 Vadim
Я для теста запихивал Прометей в цеф. И благополучно проебал данные. Нет, сделав бы лишние движения все бы восстановил. Но... это такое.
добро пожаловать к клуб, вот футболка где рукава внизу расположены
 Sergey
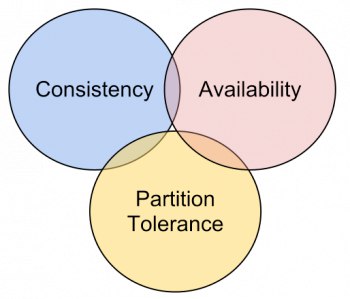
CAP-теорема в действии
Так кап теорема в чистом виде давно считается устаревшей и там пару ее видов принесли расширенных
Михаил
пока Cluster API не взлетел ответ простой - чтобы при гибели ноды погибала не вся железяка, а только кусок виртуалки
Ну, у тебя может упасть нода с кучей вм)
Михаил
Vadim
Ну, у тебя может упасть нода с кучей вм)
отож, текущие решения далеко не идеальные - для этого пилится Cluster API чтобы прослоек поменьше было
Ivan
Ну, у тебя может упасть нода с кучей вм)
Отказоустойчивый кластер - берёшь ноду, нарезаешь на ней виртуалочки, поднимаешь на них куб.
𝚔𝚟𝚊𝚙𝚜
Так кап теорема в чистом виде давно считается устаревшей и там пару ее видов принесли расширенных
Как и модель OSI не является полностью правдивой, но она хороша для обучения и описания логики работы сети :)
Sergey
Как и модель OSI не является полностью правдивой, но она хороша для обучения и описания логики работы сети :)
Ну сейчас мы живём в мире tcp/ip модели, если так можно сказать
Sergey
𝚔𝚟𝚊𝚙𝚜
 Sergey
тоже аж глаз режет...
Sergey
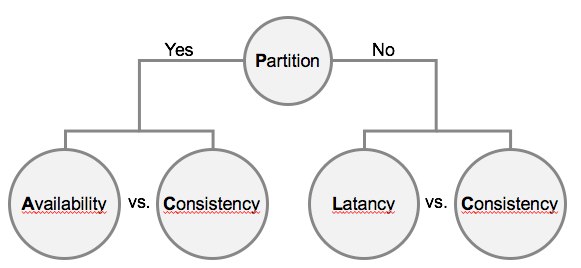
Как раз цепх жертвует задержками в пользу консистентности
 ShadoWalkeR
Sergey
Больше всего от консистентности страдают банки
Sergey
Anonymous
"Missing data from clusters (unavailable)"
сюка тупой gke мне кластер вырубил
Anonymous
нет ну это прям напоминает вымогательство, теперь мне типа надо оплатить их саппорт и попросить врубить обратно? rly??
Sergey
Ты ещё его автоскейлинг пулов в гке попробуй
Sergey
Incognito
Splunk все, проинтегрирован
𝚔𝚟𝚊𝚙𝚜
# cat access.yaml | grep -A 1 strategy
strategy:
type: Recreate
# cat access.yaml | grep repl
replicas: 1
# kubectl get pod | grep access
access-69d88c4f6d-sqgp9 1/1 Terminating 0 17m
access-69d88c4f6d-tf882 1/1 Running 0 114s
𝚔𝚟𝚊𝚙𝚜
хотя я по прежнему не очень уверен
 Roman
# cat access.yaml | grep -A 1 strategy
strategy:
type: Recreate
# cat access.yaml | grep repl
replicas: 1
# kubectl get pod | grep access
access-69d88c4f6d-sqgp9 1/1 Terminating 0 17m
access-69d88c4f6d-tf882 1/1 Running 0 114s
Так, я уже запутался.
При смерти ноды, поды деплоймента будут перезапущены на другой ноде или надо руками прибить те, которые unknown?
𝚔𝚟𝚊𝚙𝚜
𝚔𝚟𝚊𝚙𝚜
например использует ли твой deployment attachable volume
G72K
Да, про это я знаю, но там кейс не требующий прям высокого ha и простой в пару тройку минут допустим.
Такой простой почти всем допустим, но инженерам скучно :)
Roman
cephfs вроде не требует attach
Возможно, я ещё разбираюсь в этом :)
Хорошо, например самый простой кейс, deployment вообще без использование volume
G72K
получается надо каждую тразнакцию реплизировать.
Это не имеет отношения к Кубу, а вопрос к базе. В PG есть синхронная репликация скажем.
 Mark ☢️
Это не имеет отношения к Кубу, а вопрос к базе. В PG есть синхронная репликация скажем.
А нахрен она нужна, когда можно в цеффс разместить егойную бд ? И при смерти нода запустить с той же фс на другом ноде
Mark ☢️
Есть нюанс что мой способ не защищает от багов поцгреса
Mark ☢️
И требует абсолютнг точной одинаковой версии
Mark ☢️
И чтения будут медлинней
Mark ☢️
Ибо по сети
G72K
Репликация базой всегда лучше чем репликация ФС. Точно так же как репликация ФС лучше репликации блоков. Чем выше уровнем, тем лучше и производительнее
Mark ☢️
Тож верно
G72K
s,репликация,HA,
Mark ☢️
Но мой вариант по размеру скейлица лихко
Mark ☢️
И по иопсам тоже
𝚔𝚟𝚊𝚙𝚜
Возможно, я ещё разбираюсь в этом :)
Хорошо, например самый простой кейс, deployment вообще без использование volume
Деплоймент заспавнит новый под, старый останется висеть в Unknown - это стандартное поведение Deployment, но про spec.strategy.type=Recreate я бы еще уточнил.
𝚔𝚟𝚊𝚙𝚜
Репликация базой всегда лучше чем репликация ФС. Точно так же как репликация ФС лучше репликации блоков. Чем выше уровнем, тем лучше и производительнее
> репликация ФС лучше репликации блоков
Я бы не согласился, но о какой фс идет речь?
G72K
> репликация ФС лучше репликации блоков
Я бы не согласился, но о какой фс идет речь?
Да о любой. Чем больше магия знает о том, что на самом деле происходит, тем надёжней и производительнее она
𝚔𝚟𝚊𝚙𝚜
Да о любой. Чем больше магия знает о том, что на самом деле происходит, тем надёжней и производительнее она
В таком случае я не согласен, имхо, я предпочитаю стандартные ФС типа ext4 поверх реплицируемого блочного устройства - это всегда работает быстрее и надежнее чем тот же GlusterFS, CephFS, LizardFS и иже с ними.
G72K
просто раньше цеффс был гавно
Кворумные локи по определению не могут быть быстрее локальных. Цеффс не сможет обогнать постгрес репликацию, даже с консервативным synchronous_commit = remote_apply, а ведь есть ещё remote_write который не ждёт записи на диск на репликах.
Mark ☢️
Кворумные локи по определению не могут быть быстрее локальных. Цеффс не сможет обогнать постгрес репликацию, даже с консервативным synchronous_commit = remote_apply, а ведь есть ещё remote_write который не ждёт записи на диск на репликах.
А постгрес не использует никакие локи в фс. Они как были между процессами в рамках одного ядра, так и остались
Mark ☢️
Так что дело не в локах. Вплане тпс будет тоже самое. А вот чтение будет медлинние потому не локальное
Mark ☢️
Но если бд большая или нагруженная то придется чтото мультидисковое делать всиравно
Mark ☢️
И получится эдакий полуцеф. На квждом ноде рейд из ссд, данные на которых по сути синхронизируются через постгрес
Mark ☢️
Что, я не прав ?
Mark ☢️
Обслуживать рэйды это тот еще прикол. А вот бездисковые куберноды это сука интересно