Слушай, а у тебя и пупет и кубы?
Или это разные проекты?
Новый проект без пуппетов, кубы, облака, ансиблы
 Denis


 Vlad
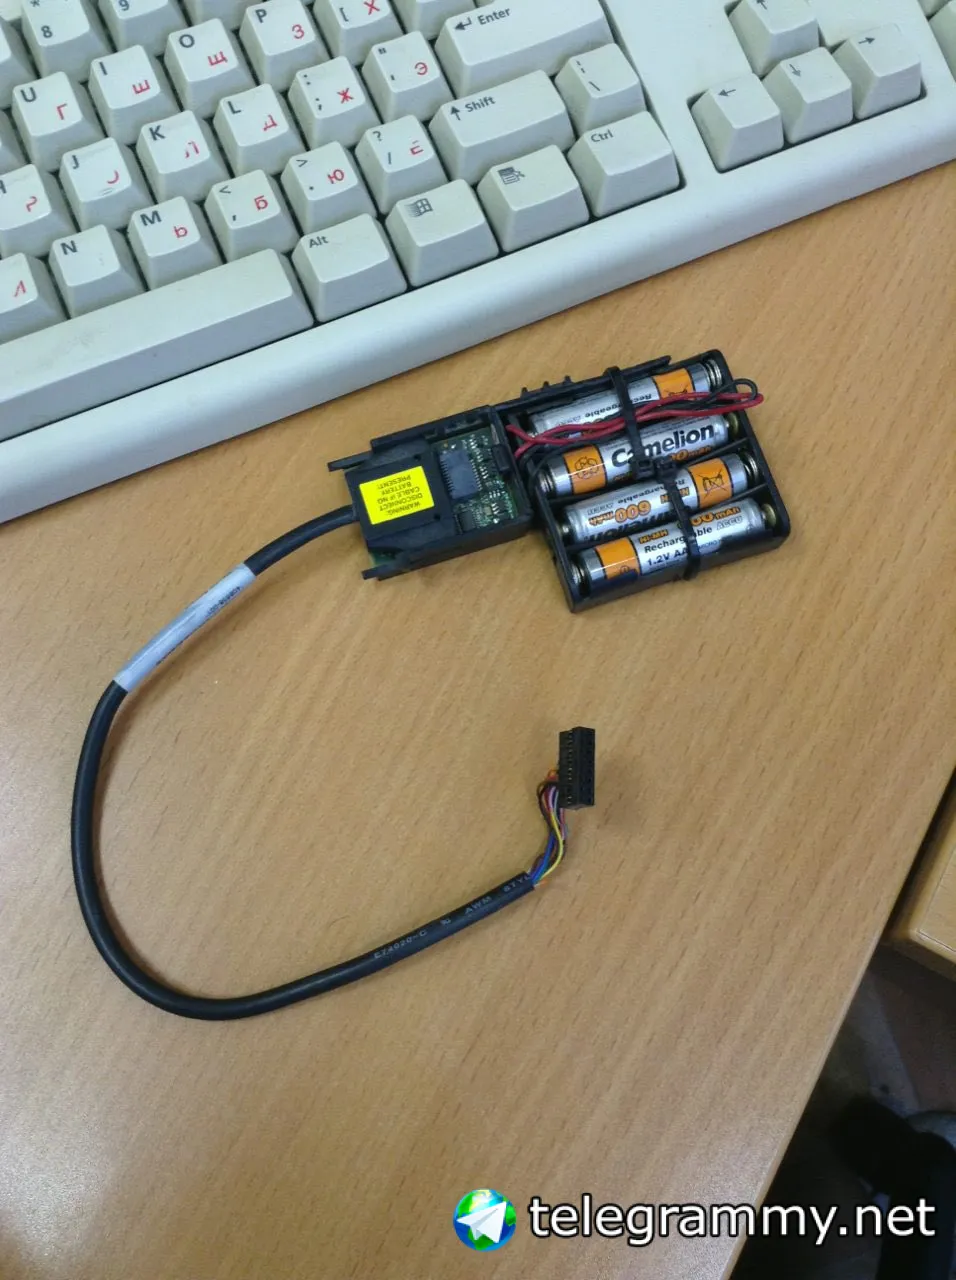
Когда внезапно вспухла батарейка на hp smart array и надо срочно костылить замену
 Dmitry
Та часть что про оптимистичный подход
Dmitry
Когда внезапно вспухла батарейка на hp smart array и надо срочно костылить замену
Надо было мониторить нормально
 Mark ☢️
 Dmitry
В смарте есть параметр battery_width
Dmitry
Или нет?
Dmitry
Я думаю надо у Сергея спросить
 Roman
Dmitry
Я бы не использовал железные рейды
 Никита
ну не совсем блочного....
Мысль в том, что что-то до устройства может не успеть доехать. Но я начал вспомниать детали, и это получается оч плохо)
Mark ☢️
Мысль в том, что что-то до устройства может не успеть доехать. Но я начал вспомниать детали, и это получается оч плохо)
тогда постгресу не ответят на фсинк журнала, а он не ответит клиенту что закоммитил. если еответил — ну окей, значитдругой инстанс это увидит в цеффсе.
Mark ☢️
там прямо пиздец очень консистентно
Dmitry
тогда постгресу не ответят на фсинк журнала, а он не ответит клиенту что закоммитил. если еответил — ну окей, значитдругой инстанс это увидит в цеффсе.
Обычно есть датасет который ещё не на блочке
 𝚔𝚟𝚊𝚙𝚜
И зачем CephFS, почему не RBD?
Mark ☢️
И зачем CephFS, почему не RBD?
потому что рбд ресайзить трудна. и подключить к двум нодам — ниоч. можно но сука очень апасно
Mark ☢️
в слечае пиздеца ты теряешь весь рбд ибо коррапт структур фс на нем
Mark ☢️
а в случае цеффс повреждения данных меньше
 engelbart
У меня в helm chart есть такое
containers:
volumeMounts:
- mountPath: /usr/share/elasticsearch/data
name: data
- mountPath: /usr/share/elasticsearch/config/elasticsearch.yml
name: config
subPath: elasticsearch.yml
Значит ли это что я как то попроще могу этот elasticsearch.yml править?
Mark ☢️
и цеффс изначально рассчитан на подключение к нескольким нодам одновременно
𝚔𝚟𝚊𝚙𝚜
потому что рбд ресайзить трудна. и подключить к двум нодам — ниоч. можно но сука очень апасно
А CephFS значит не опасно к двум нодам цеплять? (в рамках одного положения)
Mark ☢️
имеется в виду повреждения связанные со сплитбрейном
Mark ☢️
А CephFS значит не опасно к двум нодам цеплять? (в рамках одного положения)
не опасно. могут пострадать данные в нём. а в случае рбд не только данные но и метаданные фс в нём
Mark ☢️
в целом, при сплитбрейне если ты запустишь два постгреса на одних и тех же данных на разных нодах пиздец БД гарантирован
Mark ☢️
хоть так хоть так
𝚔𝚟𝚊𝚙𝚜
в целом, при сплитбрейне если ты запустишь два постгреса на одних и тех же данных на разных нодах пиздец БД гарантирован
Вот и я о том же, а куб тебе никогда RBD на двух нодах не смаунтит одновременно
Mark ☢️
Вот и я о том же, а куб тебе никогда RBD на двух нодах не смаунтит одновременно
дада. и при смерти одного нодна попытка смаунтить на другом покажет тебе хуй
Mark ☢️
на 30 секунд
Mark ☢️
или минут... не помню
𝚔𝚟𝚊𝚙𝚜
А для совсем параноиков у ext4 есть multimount protection
Mark ☢️
защитный интервайл в цефе
Mark ☢️
как второй инстанс узнает, работает ли первый
Mark ☢️
может просто выключили внезапно
Mark ☢️
не фейловер, а фейлэгэин
Mark ☢️
ну кароч минимизирует урон
Mark ☢️
но за это время постгрес уже нахуевертит
Alexander
Всем привет. Тут вопросец по ингрессу.
Есть два кластера k8s. В них абсолюнто одинаково задеплоен минио и nginx который раздает видосики. Так вот в одном все ок. А во втором при запросе к видео ingress (nginx) не отдает его рейнджами а сначала грузит его весь, а потом уже начинает воспроизводить. На второй аналогичной конфигурации теже деплойменты работают как надо. В чем может быть дело ? Спасибо
Mark ☢️
Всем привет. Тут вопросец по ингрессу.
Есть два кластера k8s. В них абсолюнто одинаково задеплоен минио и nginx который раздает видосики. Так вот в одном все ок. А во втором при запросе к видео ingress (nginx) не отдает его рейнджами а сначала грузит его весь, а потом уже начинает воспроизводить. На второй аналогичной конфигурации теже деплойменты работают как надо. В чем может быть дело ? Спасибо
один кластер с пиками точёными.... второй с хуями дрочёными. какой сам смотреть будешь, а какой на раздачу видео поставишь ?
Alexander
один кластер с пиками точёными.... второй с хуями дрочёными. какой сам смотреть будешь, а какой на раздачу видео поставишь ?
Кластером с пиками надобномы кластер с хуями починить и разадчу видео на обоих поставить
𝚔𝚟𝚊𝚙𝚜
Ну а вообще я бы не рекомендовал нагруженную базу на Ceph держать
Mark ☢️
Ну а вообще я бы не рекомендовал нагруженную базу на Ceph держать
а что делать? какие варианты ? я б заменил БД или переделал сторудж на чтонть другое (не поцгрес)
𝚔𝚟𝚊𝚙𝚜
а что делать? какие варианты ? я б заменил БД или переделал сторудж на чтонть другое (не поцгрес)
Local-volumes, Linstor или iSCSI
Mark ☢️
что там у нас с репликацией
Mark ☢️
?
𝚔𝚟𝚊𝚙𝚜
Где именно?
Mark ☢️
с внезапным сгоранием нода целиком вместе с данными ?
Mark ☢️
искази - это вобще протокол.
Mark ☢️
LINSTOR can also be used independently to control DRBD resources without the Kubernetes, OpenStack, OpenNebula or OpenShift front-end.
Mark ☢️
понятно
Mark ☢️
дрбд это тот ещё кусок кала
Mark ☢️
𝚔𝚟𝚊𝚙𝚜
с внезапным сгоранием нода целиком вместе с данными ?
Тебе уже писали что у patroni кворум нормальный, на local-volumes будет просто летать
Mark ☢️
Тебе уже писали что у patroni кворум нормальный, на local-volumes будет просто летать
если каждый врайт так или иначе реплицируется, то с чего это будет летать?
Mark ☢️
ну мож на чтение разве что
 Oleg
В монге есть врайт концерн или как-то так
𝚔𝚟𝚊𝚙𝚜
если каждый врайт так или иначе реплицируется, то с чего это будет летать?
Тут была классная диаграмка...
Oleg
То есть запись не произойдёт, пока не произойдёт на Н нодах
Mark ☢️
к ней вопросов нет
Mark ☢️
началось блять
Mark ☢️
просто зависает, теряет кворум и т.д.
𝚔𝚟𝚊𝚙𝚜
Ммм, сдается мне ты просто не умеешь его готовить
Mark ☢️
может уже и торт, я хз. ранее дрбд тестил — даже в базовых кейсах было все плохо