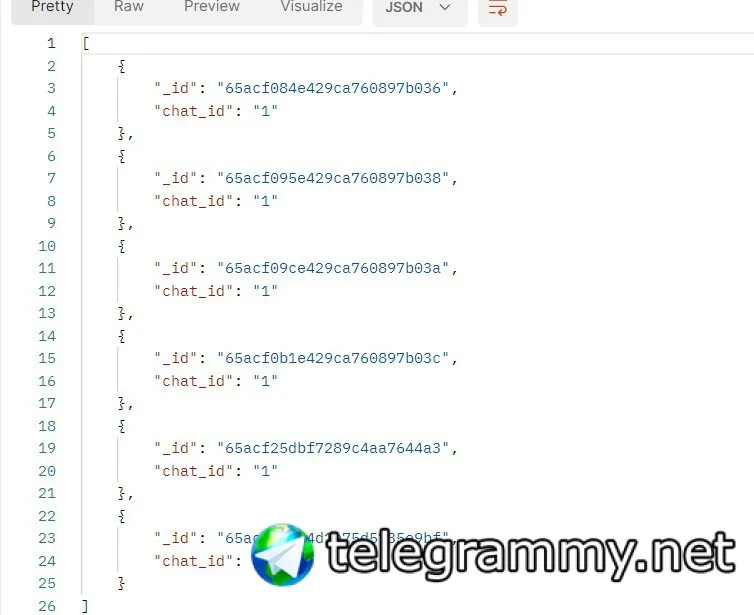
Нет
А ты хоть пробовал?
 Данил


 Jk
Yes
Jk
Он мне пример создания на языке программирования предложил
Alexandr
 Павел
Привет, подскажите плиз, можно ли в монго такое сделать.
Например есть вот такие записи
{
"_id" : "111",
"zipMasks" : [
"123*",
"45*"
]
}
{
"_id" : "222",
"zipMasks" : [
"33*",
"44*"
]
}
{
"_id" : "333",
"zipMasks" : [
"70*",
"999*"
]
}
Нужно написать запрос, который по переданному полному zip code будет искать все записи у которых маска в zipMasks матчится с этим полным zip code
Тоесть если zip code 70756 то я ожидаю получить запись с айди 333 потому что в ее zipMasks есть маска 70*.
Tetra
Привет, подскажите плиз, можно ли в монго такое сделать.
Например есть вот такие записи
{
"_id" : "111",
"zipMasks" : [
"123*",
"45*"
]
}
{
"_id" : "222",
"zipMasks" : [
"33*",
"44*"
]
}
{
"_id" : "333",
"zipMasks" : [
"70*",
"999*"
]
}
Нужно написать запрос, который по переданному полному zip code будет искать все записи у которых маска в zipMasks матчится с этим полным zip code
Тоесть если zip code 70756 то я ожидаю получить запись с айди 333 потому что в ее zipMasks есть маска 70*.
нет, можно разве что формировать тупо набор масок, если все такого плана и тогда простым поиском
in: ["70566", "7056*", "705*" ....
Павел
нет, можно разве что формировать тупо набор масок, если все такого плана и тогда простым поиском
in: ["70566", "7056*", "705*" ....
Спасибо, похоже да, придется в java делать
 yopp
Привет, подскажите плиз, можно ли в монго такое сделать.
Например есть вот такие записи
{
"_id" : "111",
"zipMasks" : [
"123*",
"45*"
]
}
{
"_id" : "222",
"zipMasks" : [
"33*",
"44*"
]
}
{
"_id" : "333",
"zipMasks" : [
"70*",
"999*"
]
}
Нужно написать запрос, который по переданному полному zip code будет искать все записи у которых маска в zipMasks матчится с этим полным zip code
Тоесть если zip code 70756 то я ожидаю получить запись с айди 333 потому что в ее zipMasks есть маска 70*.
проще всего сложить в массив все подходящие почтовые коды и по массиву сделать индекс. либо сделать коллекцию с инверсий отношения: _id: <полный почтовый код>, foo_id: "333"
хранить в одном документе вероятно будет эффективнее, за счёт лучшего сжатия за счёт низкой энтропии как у документа так и у индекса. даже без сжатия размер будет 16 байт на код если хранить строкой и 10 байт если числом. т.е у вас даже документы будут в пределах нескольких килобайт
а так как во всём мире уникальных почтовых кодов около 10 млн, это совсем верхний предел по размеру таких отношений, что совсем не много 🙂
 Easy Rider
Такой момент интересный. Монга в логах при старте пишет предупреждение что строго рекомендуется использовать файловую систему XFS. Иначе вроде как возможны проблемы с производительностью, вплоть до того что иногда всё виснет.
А у меня KVM, но там какая-то tmpfs, в общем, насколько это критично?
Mllse
$project: {
result: {
$filter: {
input: '$result',
as: 'notification',
cond: {
$or: [
{ $eq: ['$$notification.isRead', isRead] },
{ $eq: ['$$notification.userId', id] },
],
},
},
},
},
Всем привет, кто нибудь может объяснить. По isRead нормально фильтрует, находит. Как только я добавляю userId, все, тупо не ищет. Я убежден, что в обе стороны обозначены как Objectid
Mllse
$project: {
result: {
$filter: {
input: '$result',
as: 'notification',
cond: {
$or: [
{ $eq: ['$$notification.isRead', isRead] },
{ $eq: ['$$notification.userId', id] },
],
},
},
},
},
Всем привет, кто нибудь может объяснить. По isRead нормально фильтрует, находит. Как только я добавляю userId, все, тупо не ищет. Я убежден, что в обе стороны обозначены как Objectid
Разобрался в чем дело. Это называется слабоумие и отвага. Кто то делал "удалить массивы userId" на уровне миддлавра
Daniil
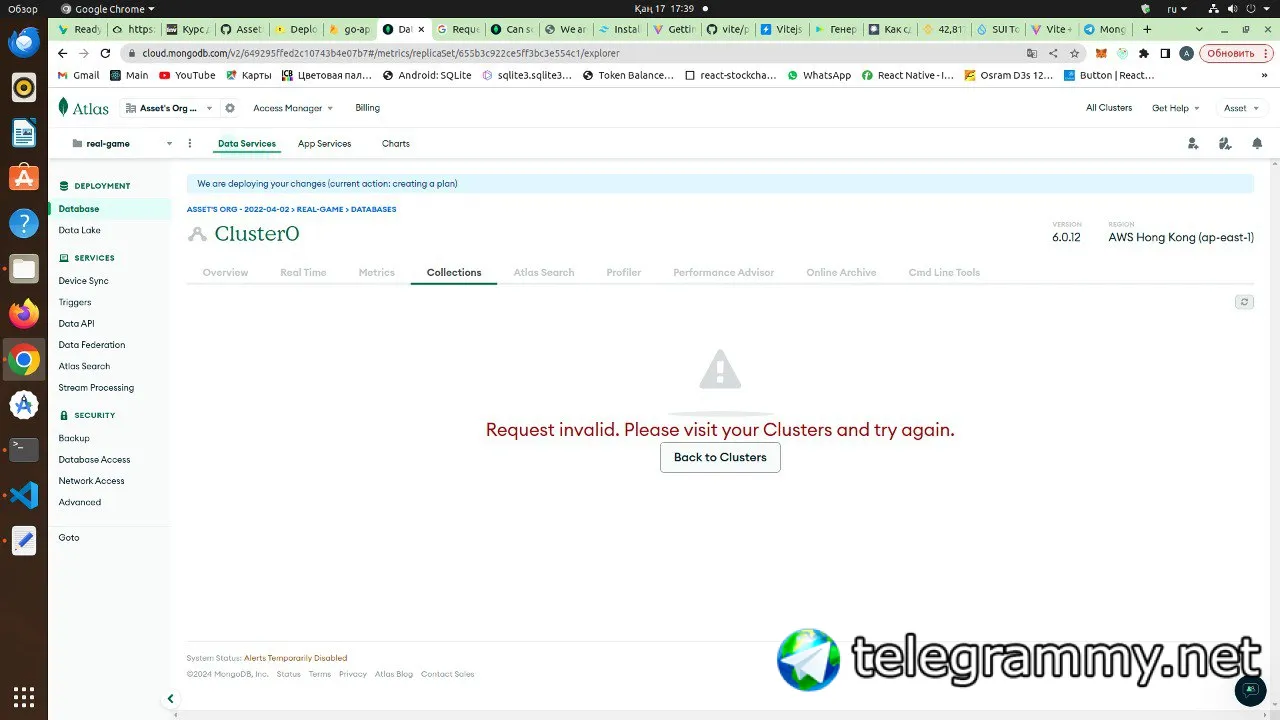
У атласа какие то проблемы сегодня, пока видимо только с изменениями конфигурации и метриками, будьте внимательны)
Daniil
Как всегда когда срочно надо что то сделать)) (не могу новый ip добавить в вайтлист)
 Александр
кто то использует атлас? 🤨
 Asset
 Asset
подскажите что за проблема
Daniil
есть проблемы у атласа
Александр
ужс
Easy Rider
вот почему лучше иметь свой сервер
Daniil
вот почему лучше иметь свой сервер
точнее три + человека с опытом обслуживания и настройки этого всего на зп
Daniil
еще неизвестно, где больше риски в таком случае
Easy Rider
точнее три + человека с опытом обслуживания и настройки этого всего на зп
для мелких проектов можно обойтись одним, для крупных такие расходы несущественны. есть еще политический риск же. могут просто отменить. от нас это не зависит
Arsen
Привет. Подскажите пожалуйста как правильнее поступать:
- делать один большой запрос в монгу
- разбить его на набор более мелких
С одной стороны большой запрос разом может сильно нагрузить БД + кроме него будет еще N запросов от самых разных клиентов.
С другой стороны мелкие запросы, хоть и легче, будут многочисленными и непонятно сильно ли будет легче БД справляться с ними.
 Nick
Привет. Подскажите пожалуйста как правильнее поступать:
- делать один большой запрос в монгу
- разбить его на набор более мелких
С одной стороны большой запрос разом может сильно нагрузить БД + кроме него будет еще N запросов от самых разных клиентов.
С другой стороны мелкие запросы, хоть и легче, будут многочисленными и непонятно сильно ли будет легче БД справляться с ними.
правильно - определить критерии правильности для своего проекта, потом уже выбор становится очевидным. Ну и потестить на нагрузке
Arsen
правильно - определить критерии правильности для своего проекта, потом уже выбор становится очевидным. Ну и потестить на нагрузке
Критерий правильности - чтобы БД не была перегружена. И мне неизвестно, что хуже для перформанса - большой набор маленьких запросов или один большой запрос.
В итоге конечно все протестится, но интересно было бы узнать, есть ли заренее известный лучший подход
Asset
для мелких проектов можно обойтись одним, для крупных такие расходы несущественны. есть еще политический риск же. могут просто отменить. от нас это не зависит
Вот тут вообще плаваю вроде и postgress подключал но не могу понять свой сервер это сама физическая машина с сервером или арендованное пространство под сервер это одно и тоже
Daniil
Daniil
но наверняка у кого то остались собственные железки в шкафах)
Nick
Критерий правильности - чтобы БД не была перегружена. И мне неизвестно, что хуже для перформанса - большой набор маленьких запросов или один большой запрос.
В итоге конечно все протестится, но интересно было бы узнать, есть ли заренее известный лучший подход
ну чтоб не перегружать, можно просто купить больше ресурсов и не тратить более дорогое время разработки. Всеравно если у вас такие вопросы, то через полгода год вам придется перестраивать работу с БД вместе со структурой
Nick
Критерий правильности - чтобы БД не была перегружена. И мне неизвестно, что хуже для перформанса - большой набор маленьких запросов или один большой запрос.
В итоге конечно все протестится, но интересно было бы узнать, есть ли заренее известный лучший подход
с точки зрения БД будет плюс минус одинаково и разница только в том на сколько удобно это будет закодить. Вы либо усложняете код и делаете более простые запросы, либо усложняете запросы, делая более простой код. В любомслучае без доп инфомрации по объемам данных, типах запросов и их сути сказать какой вариант будет лучше невозможно даже примерно
Arsen
ну чтоб не перегружать, можно просто купить больше ресурсов и не тратить более дорогое время разработки. Всеравно если у вас такие вопросы, то через полгода год вам придется перестраивать работу с БД вместе со структурой
Вполне возможно, что и не придется. Подозреваю, что со стороны клиента не должно приходить чего-то неадекватного + всегда можно договориться о контрактах на использование. Скорее всего сейчас подстрахуюсь - буду делить запросы на части. Код для обоих вариантов уже есть. Так что если по итогам окажется лишним - всегда можно откатиться
Спасибо)
Asset
👍
 Cooman
Всем привет, а есть тут те кто использует ide datagrip?
Hugo Charles
😆
Andrey
Можно используя mongoose получать данные из бд без создание схемы, если да, то как?
Nick
Можно используя mongoose получать данные из бд без создание схемы, если да, то как?
именно монгус такое не позволяет. Но можно добратсья к самому драйверу, который используется монгусом, https://mongoosejs.com/docs/api/connection.html#Connection.prototype.db
Andrey
именно монгус такое не позволяет. Но можно добратсья к самому драйверу, который используется монгусом, https://mongoosejs.com/docs/api/connection.html#Connection.prototype.db
А какие альтернативы есть, чтобы вытаскивать из бд данные? Монгодб библу использовать?
Nick
А какие альтернативы есть, чтобы вытаскивать из бд данные? Монгодб библу использовать?
а что мешает сам монгус использовать?
Andrey
а что мешает сам монгус использовать?
да я пробовал, получилось только коллекцию создать, но у меня уже есть готовая коллекция. Мне нужно цеплять оттуда данные
Nick
да я пробовал, получилось только коллекцию создать, но у меня уже есть готовая коллекция. Мне нужно цеплять оттуда данные
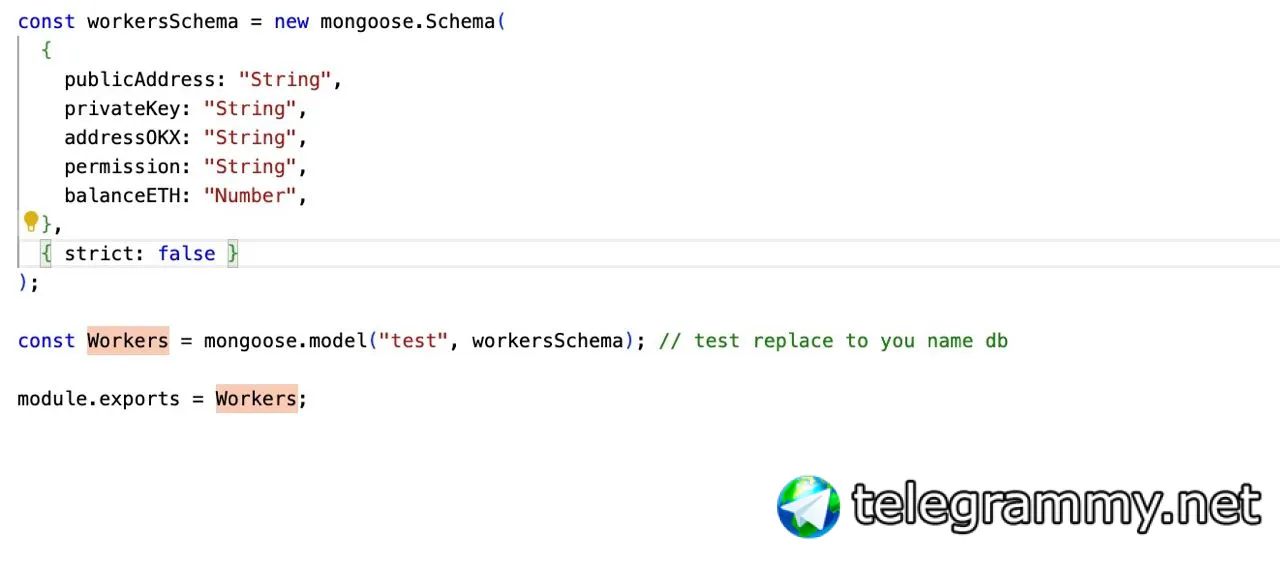
если не хочется заморачиваться с описание схемы, то есть вариант с strict: false как описано тут https://stackoverflow.com/questions/71790464/how-to-query-mongodb-with-mongoose-without-having-a-model
https://mongoosejs.com/docs/guide.html#strict
 Semyon V
парни, а как сказать монге в докере, чтобы она забирала всю память, а не половину?
yopp
парни, а как сказать монге в докере, чтобы она забирала всю память, а не половину?
Это не нужно делать: в кеше WiredTiger, который занимает почти всё из выделенной половины, хранятся данные без сжатия. Документы сжимаются только когда сбрасываются на диск. Вся оставшаяся память, эта вторая половина памяти, используется ОС под кеш файловой системы, следовательно в ней хранятся данные уже в сжатом виде.
Если выделить под кеш всю память, то в этом случае итоговое количество документов которые хранятся в памяти только уменьшится
Semyon V
ого себе. спасибо за инфу. просто в моём случае я не наблюдаю чтобы занимаемая память хоть когда либо переходила порог в 50%
yopp
Да, ОС обычно отображает память выделенную под дисковый кеш как «свободную», так как в случае если кто-то попросит ОС выделить им память, данные из кеша будут вытеснены и выделение произойдёт из освобожденного пространства
Semyon V
очень интересно. спасибо ещё раз
yopp
очень интересно. спасибо ещё раз
Если вам интересно, то вот статья какие инструменты для просмотра содержимого дискового кеша есть: https://www.fromdual.com/who-else-is-using-my-memory-file-system-cache-analysis
Andrey
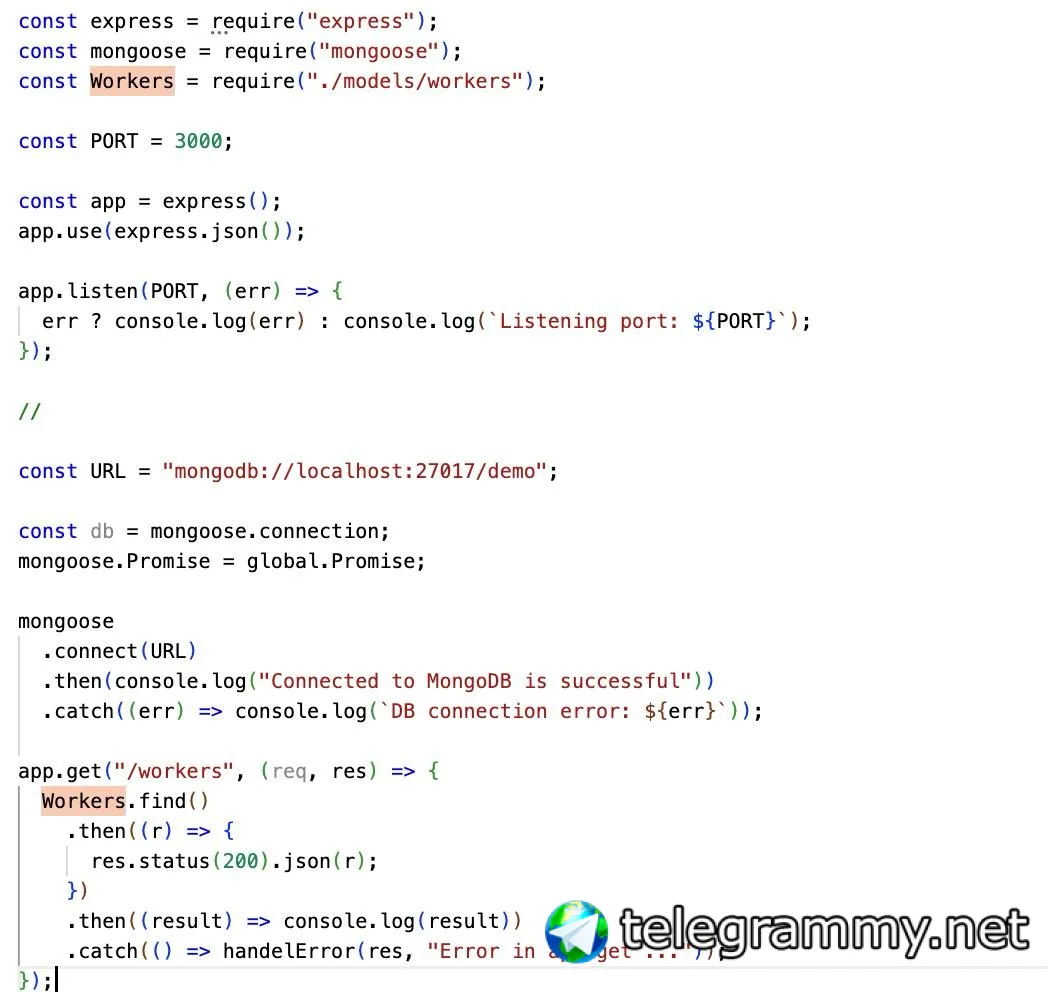
Почему при запросе выдает " [] " если база не пустая
Andrey
 Andrey
 Nick
 of Astora 𒉭
Asset
Asset
Всем салам, mongoose только в меня не подгружает
Asset
))) написал заработала кого из Вас боится
 Андрей
 Нуриддин
Андрей
Возможно ты имел ввиду то что находится в этой статье?
https://www.mongodb.com/docs/manual/reference/command/compact/
то есть, тоже надо, перезаписывать ДБ, из-за пустых фрагментов?
Нуриддин
Если верить этой части документации то да, но из опыта скажу что не так уж часто
Андрей
Если верить этой части документации то да, но из опыта скажу что не так уж часто
ну вот если я буду записывать/удалять 10Гб/минуту, то как часто придётся юзать эту команду?
Андрей
ну можно предположить что размер БД на диске будет увеличиваться со скоростью 10Гб в минуту, таким образом через 10 минут будет 100ГБ? или она там всё же что-то оптимизирует?
Nick
Нуриддин
зачем об этом думать?
вот такая просьба, может вы поможете найти статью о том как mongo хранит данные?
Nick
вот такая просьба, может вы поможете найти статью о том как mongo хранит данные?
https://www.mongodb.com/docs/manual/storage/
за хранение отвечает движок wiredtiger
Нуриддин
ну можно предположить что размер БД на диске будет увеличиваться со скоростью 10Гб в минуту, таким образом через 10 минут будет 100ГБ? или она там всё же что-то оптимизирует?
я ошибся, та статья была об индексной переестройке, чтобы его ускорить
Нуриддин
Нуриддин
ну можно предположить что размер БД на диске будет увеличиваться со скоростью 10Гб в минуту, таким образом через 10 минут будет 100ГБ? или она там всё же что-то оптимизирует?
если у вас мало дисков вы можете подключить компрессирование данных в конфигурации монгодб, а так монга спокойно живёт без этого
Nick
ну можно предположить что размер БД на диске будет увеличиваться со скоростью 10Гб в минуту, таким образом через 10 минут будет 100ГБ? или она там всё же что-то оптимизирует?
не будет такого, распухания от дефрагментации в монге практически нет и как правило на фоне просто прироста данных оно незаметно
Андрей
не будет такого, распухания от дефрагментации в монге практически нет и как правило на фоне просто прироста данных оно незаметно
понял, спасибо, попробую сделать тестовую прогу на монге
 Влад
 Александр
разобрался
 Danil
ребят. использую distinct, который возвращает массив строк, а могу ли я как-нибудь вернуть из него массив объектов?
Danil