 Maxmudjon


 Danil
 Ящик водки
 Магомед
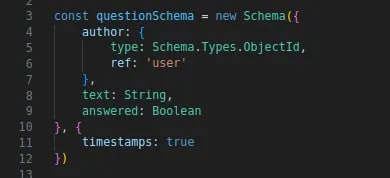 Магомед
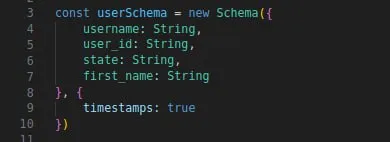 Магомед
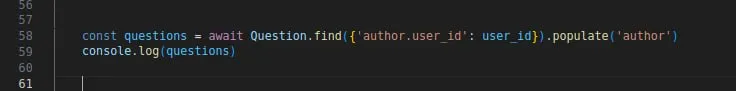 Магомед
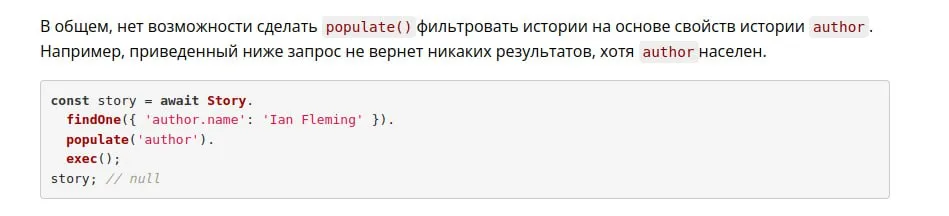 Магомед
HELP ME, PLEASE!
 Nick
Магомед
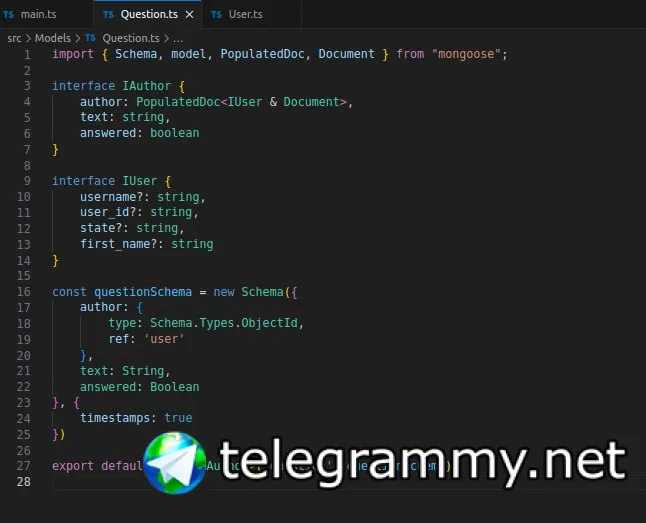
написать обычную агргеацию с лукапом и фильтром
 Nick
Магомед
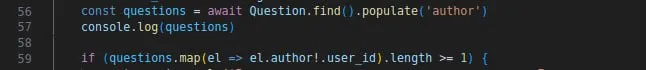
не понял а в чем тут решение?
 Магомед
не понял а в чем тут решение?

 Максим
Привет.
Максим
Подскажите, какой тип данных в схеме mongoose указать для баланса пользователя? (Может быть отрицательным, а также может быть не целым числом, а с десятыми и сотыми после запятой).
Nick
Подскажите, какой тип данных в схеме mongoose указать для баланса пользователя? (Может быть отрицательным, а также может быть не целым числом, а с десятыми и сотыми после запятой).
https://www.mongodb.com/docs/manual/tutorial/model-monetary-data/
 Артем
Всем привет, кто-то использовал realm для синхронизации с mongo db поднятой на собственном удаленном сервере?
Dimitrii
Гайс, всем привет!
Кто очень глубокого познания в шардах монги - уделите своё внимание моему вопросу, пожалуйста.
У меня есть стенделон и шард (3 шарда) базы с одинаковым набором данных на несколько терабайт.
Сейчас замечаю, что шарды в определённых запросах (например где нужно считать по фильтру, find(param).count() ) в десятки или сотни раз медленнее, чем стенделон.
Изменения стратегий не приводят к результату.
Скажите, как работать с каунтом в шардах? ну, и вобще какие особенности при работе с шардами, из тех, которым в документации недостаточно внимания уделяется. Спасибо!
PS для поиска сообщения по ключевым словам
shards, shard, standalone, bigdata
Dimitrii
ключ шардирования должен подходить к find(param)
а варианты для param, который не является ключ-шардом существуют?
в моём случае ключ-шард имеет большое ко-во уникальных записей, но поле по которому хочу отфильтровать - нет, и оно не может быть по этому хорошим ключём для шардинга
Ivan
а варианты для param, который не является ключ-шардом существуют?
в моём случае ключ-шард имеет большое ко-во уникальных записей, но поле по которому хочу отфильтровать - нет, и оно не может быть по этому хорошим ключём для шардинга
If a query does not include the shard key, the mongos must direct the query to all shards in the cluster. These scatter gather queries can be inefficient. On larger clusters, scatter gather queries are unfeasible for routine operations.
https://www.mongodb.com/docs/manual/core/distributed-queries/#read-operations-to-sharded-clusters
Dimitrii
If a query does not include the shard key, the mongos must direct the query to all shards in the cluster. These scatter gather queries can be inefficient. On larger clusters, scatter gather queries are unfeasible for routine operations.
https://www.mongodb.com/docs/manual/core/distributed-queries/#read-operations-to-sharded-clusters
Так и нет никаких методик для подобных задач при шардах, даже если это требуется?
Надеялся, что кто-то может поделиться опытом, как они работают с шардами при подобных задачах.
Andrey
странная история, совсем недавно обновлялся до 7.0.5, а до этого инсталлировал по инструкции из документации, а сегодня на машину устанавливаю по инструкции и
Hit:1 http://mirror.yandex.ru/ubuntu jammy InRelease
Hit:2 http://mirror.yandex.ru/ubuntu jammy-updates InRelease
Hit:3 http://mirror.yandex.ru/ubuntu jammy-backports InRelease
Hit:4 http://security.ubuntu.com/ubuntu jammy-security InRelease
Ign:5 https://repo.mongodb.com/apt/ubuntu jammy/mongodb-org/7.0 InRelease
Err:6 https://repo.mongodb.com/apt/ubuntu jammy/mongodb-org/7.0 Release
404 Not Found [IP: 65.9.55.16 443]
Reading package lists... Done
E: The repository 'https://repo.mongodb.com/apt/ubuntu jammy/mongodb-org/7.0 Release' does not have a Release file.
P.S. через какое-то время заработало, странно.
 Андрей
Здравствуйте! подскажите как узнать через mongoc.h размер БД в байтах, типо сколько дискового пространства занимает
 yopp
Здравствуйте! подскажите как узнать через mongoc.h размер БД в байтах, типо сколько дискового пространства занимает
В любом драйвере это возможно через dbStats
https://www.mongodb.com/docs/manual/reference/command/dbStats/
Андрей
В любом драйвере это возможно через dbStats
https://www.mongodb.com/docs/manual/reference/command/dbStats/
не понял, чё это такое и как мне это использовать? У меня сишный код, там даже точек нет
Андрей
 yopp
не понял, чё это такое и как мне это использовать? У меня сишный код, там даже точек нет
Это команда, которая выполняется через http://mongoc.org/libmongoc/current/tutorial.html#executing-commands
Андрей
yopp
 E1ecti
а через драйвер никак?
command = BCON_NEW("dbStats", BCON_INT32(1));
if (mongoc_client_command_simple (
client, "mydb", command, NULL, &reply, &error)) {
str = bson_as_canonical_extended_json (&reply, NULL);
printf ("%s\n", str);
bson_free (str);
} else {
fprintf (stderr, "Failed to run command: %s\n", error.message);
}
Андрей
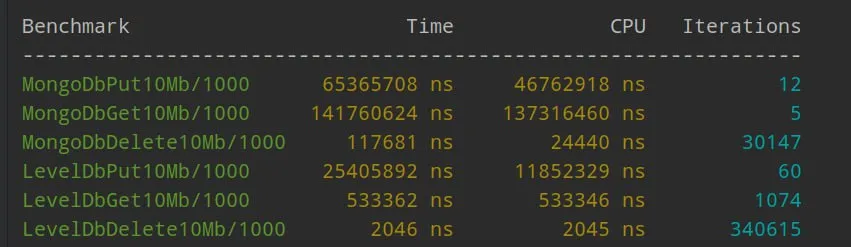
LevelDB это key-value сторадж и реалистичного сравнения с монгой к сожалению не будет
ну я под конкретный кейс их сравниваю, логирование данных и возможно последующее удаление, файлы от 1Мб - 2Гб будут
yopp
ну я под конкретный кейс их сравниваю, логирование данных и возможно последующее удаление, файлы от 1Мб - 2Гб будут
Зависит от того что вы хотите в дальнейшем с логами делать
Если вам не нужна сложная обработка то самый быстрый и дешевый способ это хранить логи в файлах
yopp
Быстрее чем append ничего не будет
Плюс когда вы делаете бенчмарк, убедитесь что вы тестируете при условиях когда данные реально пишутся на диск, а не только в кеш. Т.е вам нужно сложить в сторадж, по хорошему, 4х от размера оперативной памяти.
Показательный бенчмарк очень сложно сделать
Андрей
Зависит от того что вы хотите в дальнейшем с логами делать
Если вам не нужна сложная обработка то самый быстрый и дешевый способ это хранить логи в файлах
да понимаю, но мне ж как-то надо начальству аргументировать выбор бд
yopp
А какой у вас кейс для хранения логов?
Андрей
А какой у вас кейс для хранения логов?
есть документ в нём поля отправитель, получатель, время, несколько флагов, (флаги могут меняться по ходу нахождения в хранилище) и плюсом файл до пары Гб
это всё хранится копится, по некоторым условиям удаляется. Пользовались sqLite но его приходится вакуумировать, потому что пустые пропуски появляются. сказали смотри всякие noSql
Bon
Всем привет. Есть схема командировки, с полями start и end. Нужно сделать квери которая отдает длительность всех командировок (а-ля статистика). Но есть проблема с переходом на летнее время (+1/-1 час). Как лучше это сделать? Записывать время командировки в схему, или офсет? Или можно как-то на уровне квери посчитать? Сейчас приходится пересчитывать сам респонс с бд
Nick
Всем привет. Есть схема командировки, с полями start и end. Нужно сделать квери которая отдает длительность всех командировок (а-ля статистика). Но есть проблема с переходом на летнее время (+1/-1 час). Как лучше это сделать? Записывать время командировки в схему, или офсет? Или можно как-то на уровне квери посчитать? Сейчас приходится пересчитывать сам респонс с бд
хранить все в utc, и если сильно надо рядом местное время или таймзону. Ну и вам надо длительности прям в часах? обычно командировки это сутки, т.е. просто даты, какая разница им на летнее время?
 U
Ребятки, я же правильно понимаю, к примеру, у меня есть документы в которых не больше 2-3 полей, и мне если мне надо получить к примеру 1 поле из 1000 документов, если я буду делать получения по 1 полю из документа, то это будет работать более медленнее чем я буду получать весь документ?
Bon
хранить все в utc, и если сильно надо рядом местное время или таймзону. Ну и вам надо длительности прям в часах? обычно командировки это сутки, т.е. просто даты, какая разница им на летнее время?
Спасибо. По требованиям необходимо в часах. Время сохраняется в формате в iso
Андрей
Здравствуйте! я не очень понимаю, если мне нужно сохранить файл более 16Мб то делаю это через GridFs
а нельзя ли файл GridFs вложить просто в файл?
Байтур
Всем привет не могу создать user с role Read and write to any database выходит ошибка код 8000 хотя у меня есть роль atlasAdmin@admin
Nick
Ребятки, я же правильно понимаю, к примеру, у меня есть документы в которых не больше 2-3 полей, и мне если мне надо получить к примеру 1 поле из 1000 документов, если я буду делать получения по 1 полю из документа, то это будет работать более медленнее чем я буду получать весь документ?
В целом да, больше по сети данных гонять, можно использовать проекцию и указать список полей который нужно вернуть, возможно это то что вы ищите. Но с точки выполнения запроса будет одинаково, если нет покрывающих индексов.
Nick
Здравствуйте! я не очень понимаю, если мне нужно сохранить файл более 16Мб то делаю это через GridFs
а нельзя ли файл GridFs вложить просто в файл?
Файл это массив байт, берите этот массив и вкладывайте
Андрей
Файл это массив байт, берите этот массив и вкладывайте
там как я понял, можно чанку отдельно выдрать? допустим я не хочу весь файл выгружать, а только флаги для него?
Nick
там как я понял, можно чанку отдельно выдрать? допустим я не хочу весь файл выгружать, а только флаги для него?
Да, посмотрите апишку для полного понимания что можно а чего нет
Artur
Как правильно установить MongoDB на ArchLinux, чтобы можно было подключиться к базеданных через ГУИ
 Нуриддин
Как правильно установить MongoDB на ArchLinux, чтобы можно было подключиться к базеданных через ГУИ
Если установлен докер, то просто выводить порт на порт сервера или компьютера
Нуриддин
Если хотите чисто на железку поставить то есть документация от самой монги по этой теме
 Нуриддин
А вы в этом смысле, а монго разве поддерживает такой прямой вариант?! Это же СУБД используйте compass чтобы к нему подключиться или любое другое ide
Нуриддин
Datagrip к примеру
Jurgen
Подскажите, отличается ли по скорости поиск документа по id, и по любому другому полю?
Нуриддин
Подскажите, отличается ли по скорости поиск документа по id, и по любому другому полю?
Если размер всей коллекции смотреть это метод countdocumets()
Нуриддин
Если хотите ограничить поиск то для быстрого счёта используйте индексы
Jurgen
Мне не размер нужен, а найти документ по полю
Нуриддин
Быстрее через индекс идти
Нуриддин
Indexes — MongoDB Manual
https://www.mongodb.com/docs/manual/indexes/
 Aram
Мне не размер нужен, а найти документ по полю
Смотря что за поле. Но по id почти всегда будет быстрее всего
Jurgen
Поле текстовое
Aram
Делай по id и не парься
 none
По id будет быстрее практически всегда
none
Добавить на поле индекс и тоже будет хорошо
Andrey
По скорости записи, dev среда. Переносим данные из одной standalone инсталляции, в тестовый кластер(3 cfg(rs), 2 shards - по 1 + 1 mongos). Предварительно выгрузили данные, все записи уникальные, в кластер гружу через mongoimport, кластер, vm, диски nvme. Создал базу, в ней шардированную коллекцию, индекс, по ключу, который +- равномерно распределится между шардами. _id - кастомный Binary. Вставка с --bypassDocumentValidation и majority w: 0
1 млрд записей - шла вставка на уровне 80Kps, после 2 млрд. упала, не замерили. Между 5 млрд и 6 млрд - скорость вставки 15Kps, данные распределяются равномерно. Сервера(shards) не нагружены совсем, от силы на 30% по CPU, по памяти тоже норм. Что может быть, что померить еще?
Air
Подключаюсь к бесплатному shared Mongo Atlas, через раз вылезает такая ошибка
Как победить?
Error: querySrv ESERVFAIL _mongodb._tcp.cluster.fsdff4s.mongodb.net
at QueryReqWrap.onresolve [as oncomplete] (node:internal/dns/promises:275:17) {
errno: undefined,
code: 'ESERVFAIL',
syscall: 'querySrv',
hostname: '_mongodb._tcp.cluster.fsdff4s.mongodb.net'
}
 Fops
 Fops
 Daniil
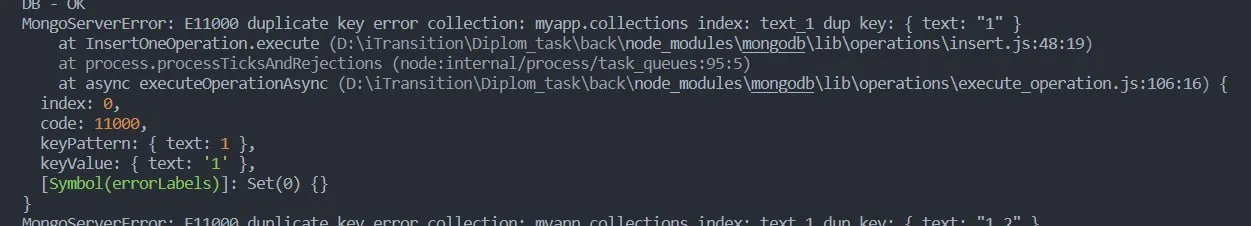
напрямую нужно подключиться через mongosh и посмотреть .getIndexes() для этой коллекции
Fops
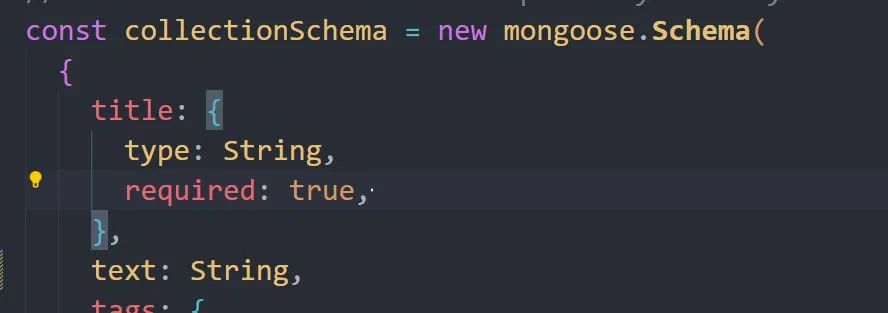
значит когда то было прописано, уникальный индекс создан, после монгус его не удалит сам
Да, было прописано, думал если просто уберу все получится