Сайт разрывает соединение
Ну, используй vpn, если лень заморачиваться, просто нагугли бесплатный прокси, может успеешь через него скачать пока он не отвалится
 Easy Rider

 Easy Rider
в браузере в настройках можно (если это файрфокс) или на системном уровне если хром
Easy Rider
5-ю версию щас тебе загружу сюда, норм? msi для винды
 Ёж
Все, через впн зарегался.
Ёж
Спасибо большое
 Nick
Все, через впн зарегался.
вы на atlas лезете или хотите себе поставить? второе не требует регистраций
Ёж
вы на atlas лезете или хотите себе поставить? второе не требует регистраций
Не знаю, бота надо поставить туда.
 Нуриддин
А вы раньше пользовались этой базой данных?
Нуриддин
О круто
 Egor
 Nick
Egor
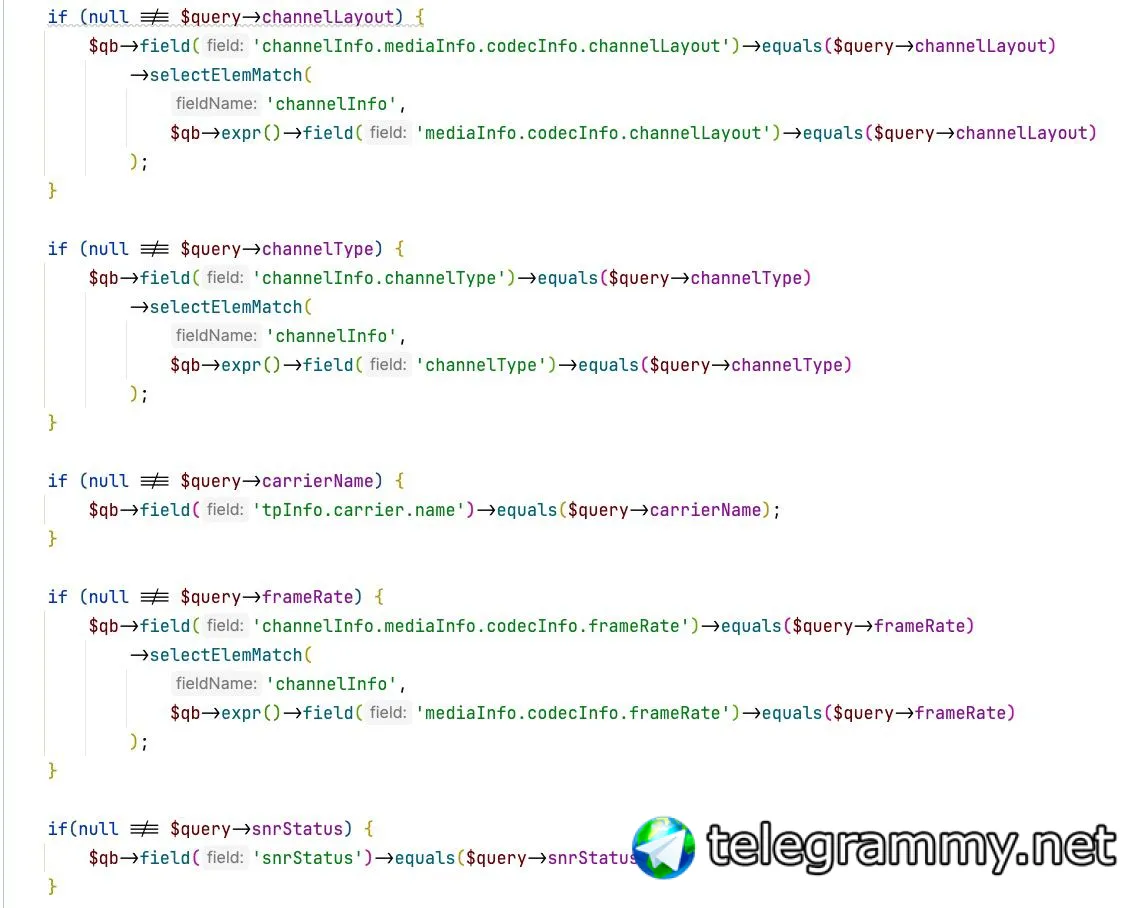
Ну вот в паре месте, где структура запроса жесткая, я через $unwind, вручную делал запрос, потом из Compass'а в код, так и делал некоторые вещи. А тут именно UI с кучей фильтров, которые суть поля документа на разных уровнях. И бизнесу надо как бы фильтровать по любому из этих полей.
Nick
Ну вот в паре месте, где структура запроса жесткая, я через $unwind, вручную делал запрос, потом из Compass'а в код, так и делал некоторые вещи. А тут именно UI с кучей фильтров, которые суть поля документа на разных уровнях. И бизнесу надо как бы фильтровать по любому из этих полей.
Структура и возможности бд не отвечают потребностям, берем время на рефакторинг, закладывая в новую структуру реальные потребности
.
659d894b5301713249cb8df77
.
Кто равно знает
.
Как читал
.
Обжект ид
Ёж
Парни, киви токен уже никак не получить? Даже через код элемента?
Egor
В монго нет инструментов для работы с множественными уровнями массивов. Только с первым через елемМатч который итак использовали. А так только раскручивать в агрегации через $unwind. Но в целом такие структуры не предполагают возможности изменения без выгрузки в код и заливки уже перестроенного дока обратно через реплейс или большой апдейт
 Вячеслав
Mllse
Всем привет. Как применить условие if из cond в lookup? Чтобы lookup менялся зависимо от условий. Пытался делать так $lookup: { $cond: {} }, но как говорится, далеко послан
Nick
Mllse
Чего вы хотите добиться по сути?
В объекте есть поле type: NEW_MESSAGE | NEW_COMMENT и от них зависит поля которые есть
если type: NEW_MESSAGE, то по сути открываются поля: {messageId: ObjectId, userId: ObjectId} ( так же раскрываю messageId через lookup с unwind чтобы один объект был, а не массивом )
если type: NEW_COMMENT, то будут поля: {commentId: ObjectId, userId: ObjectId} ( так же раскрываю commentId через lookup с unwind чтобы один объект был, а не массивом )
Я хочу чтобы он так адаптировался зависимо от значений type
Mllse
но если хоть одно поле (messageId, commentId) будет отстутвовать, то выдать ошибку, потому что не такого поля
Mllse
Конечно там объект миксированный, никакой там типизиации
Mllse
Вот это очень грустно
Nick
В объекте есть поле type: NEW_MESSAGE | NEW_COMMENT и от них зависит поля которые есть
если type: NEW_MESSAGE, то по сути открываются поля: {messageId: ObjectId, userId: ObjectId} ( так же раскрываю messageId через lookup с unwind чтобы один объект был, а не массивом )
если type: NEW_COMMENT, то будут поля: {commentId: ObjectId, userId: ObjectId} ( так же раскрываю commentId через lookup с unwind чтобы один объект был, а не массивом )
Я хочу чтобы он так адаптировался зависимо от значений type
могу предложить только сделать два разных запроса и объединять результаты через $unionWith
Mllse
могу предложить только сделать два разных запроса и объединять результаты через $unionWith
Как хороший вариант, попробую его применить, спасибо
 Данил
 Данил
 Данил
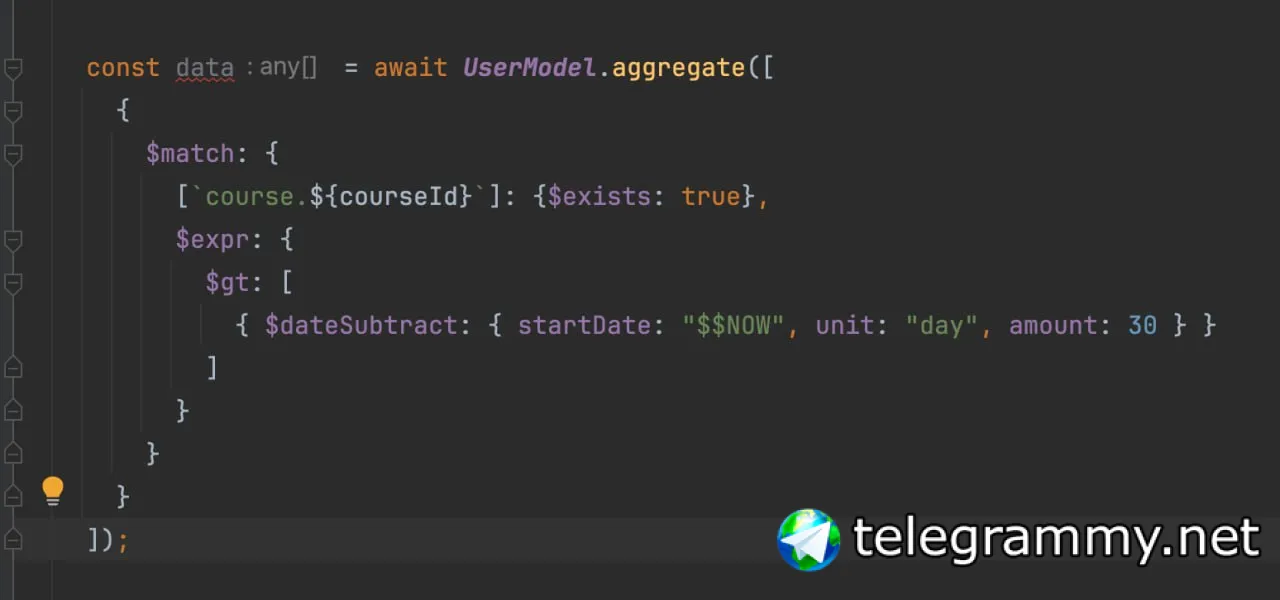 Данил
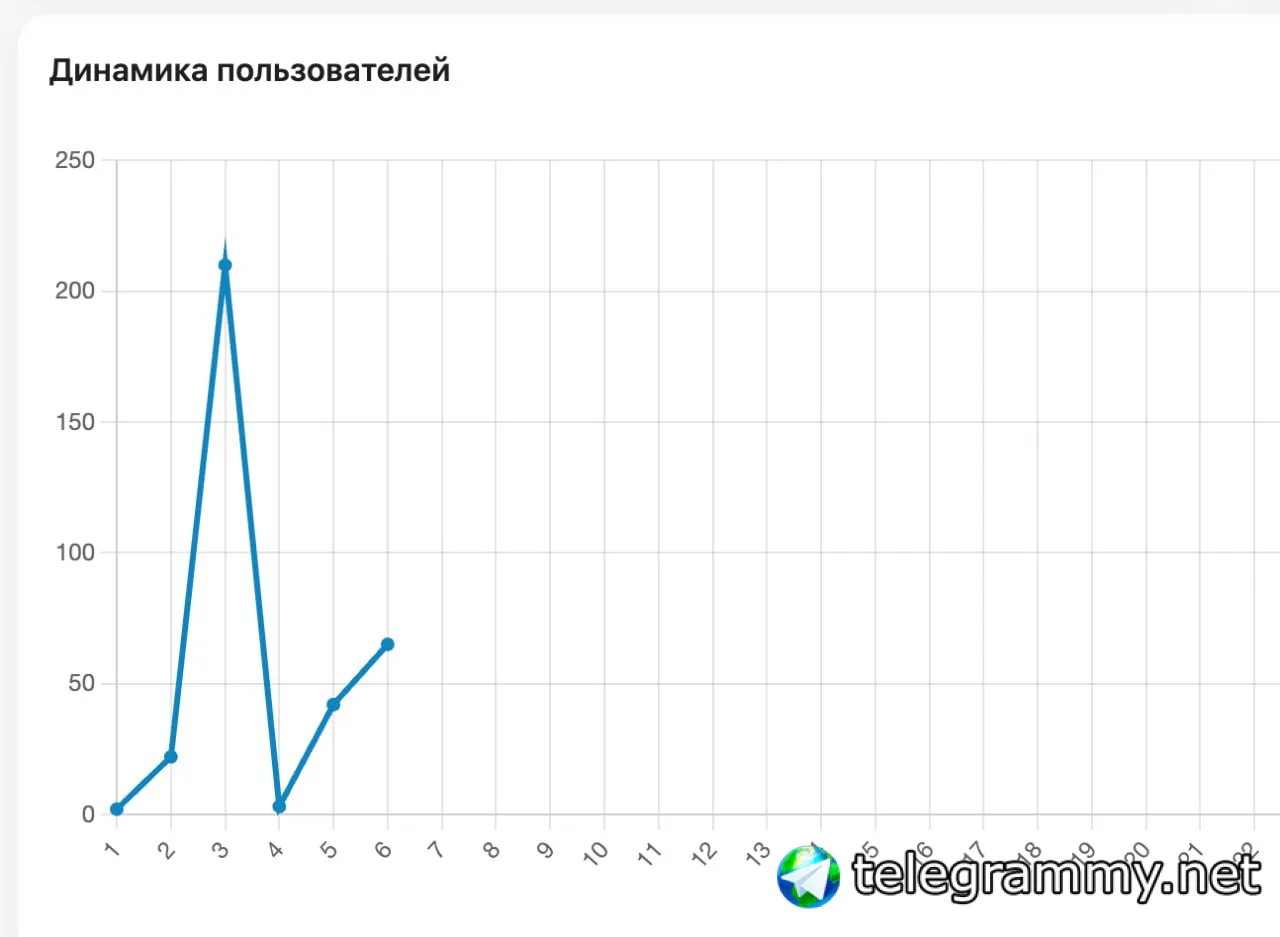
 web tryharder
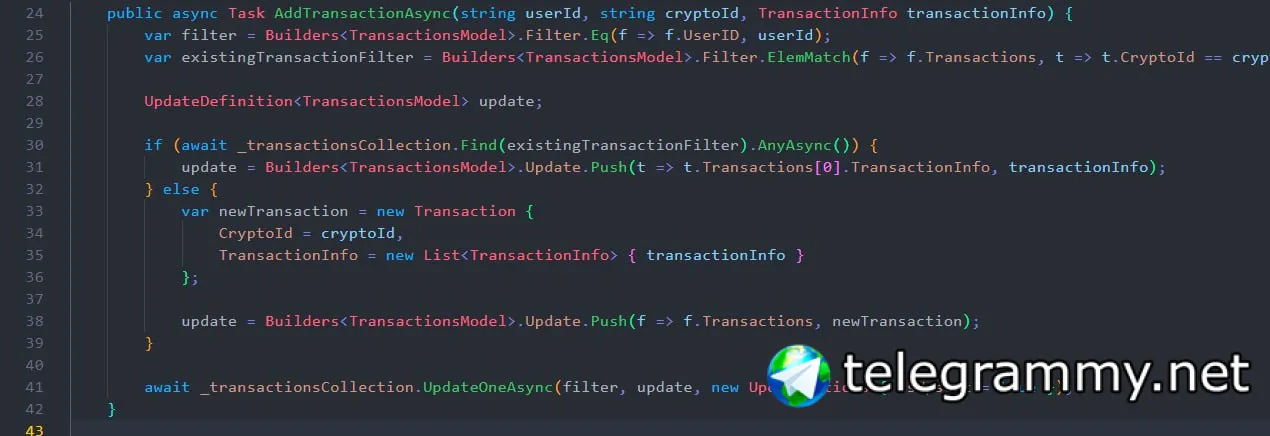 web tryharder
 Nick
web tryharder
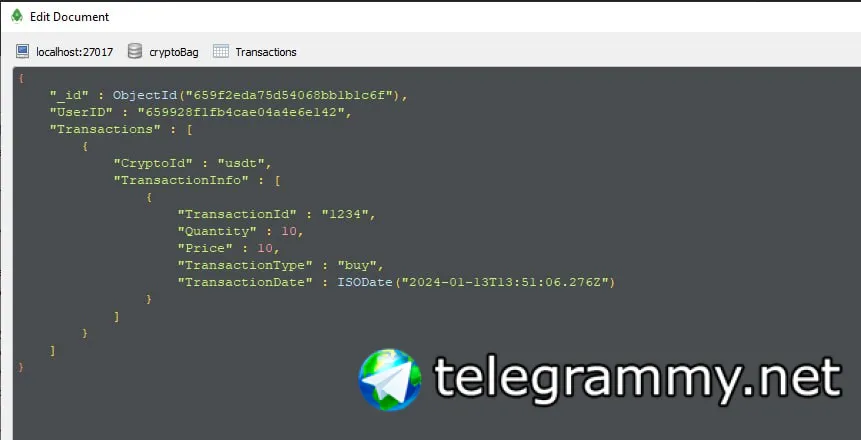
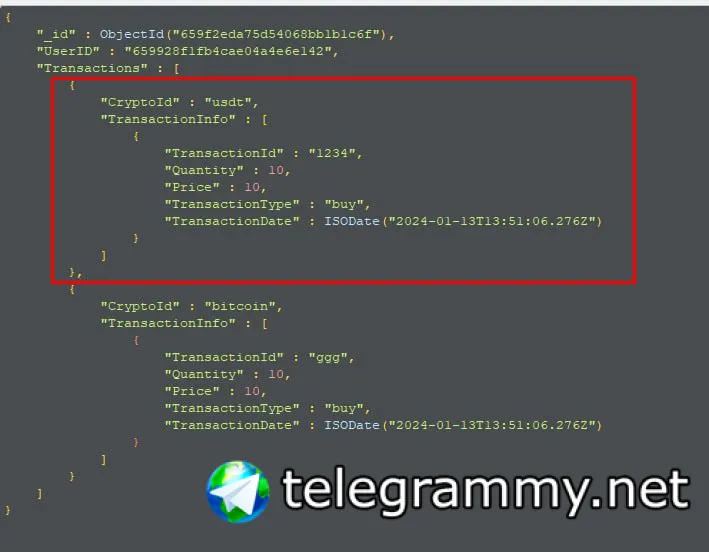
что такое "первый объект"?
 Nick
Нуриддин
У меня очень странный вопрос:"
Для чего кроме _id в коллекции нужен objectid() метод?"
Этот вопрос с недавних пор тревожит, буду рад если поделитесь мнением и опытом
Nick
У меня очень странный вопрос:"
Для чего кроме _id в коллекции нужен objectid() метод?"
Этот вопрос с недавних пор тревожит, буду рад если поделитесь мнением и опытом
в названии типа как бы и заложена суть - для идентификаторов оно и больше ни для чего, по сути упрощенная замена uuid
Нуриддин
в названии типа как бы и заложена суть - для идентификаторов оно и больше ни для чего, по сути упрощенная замена uuid
Это я прикрастно знаю, просто встретил индивида который хочет группировать по нему данные, что ввело в дикий ступор
Mllse
Это я прикрастно знаю, просто встретил индивида который хочет группировать по нему данные, что ввело в дикий ступор
А что в этом плохого? Строго типизация
Nick
Это я прикрастно знаю, просто встретил индивида который хочет группировать по нему данные, что ввело в дикий ступор
смотря как группировать, можно из ид вытащить время и процесс. С датой понятно, а второе сложно придумать как использовать для группирвоки
Нуриддин
А что в этом плохого? Строго типизация
Просто как это звучит понравилось:" Группировать коллекцию по индефикатору документа"
web tryharder
Нуриддин
смотря как группировать, можно из ид вытащить время и процесс. С датой понятно, а второе сложно придумать как использовать для группирвоки
Вот именно, лучше придумать веловсепед чем строить ракету из камня, как по мне
Nick
Просто как это звучит понравилось:" Группировать коллекцию по индефикатору документа"
ну по такой фразе может быть вариант, что в каком то поле есть id на связанный док и тогда вполне себе обычная группировка
Нуриддин
ну по такой фразе может быть вариант, что в каком то поле есть id на связанный док и тогда вполне себе обычная группировка
Хотя да, вы правы, об этом не подумал
Mllse
Просто как это звучит понравилось:" Группировать коллекцию по индефикатору документа"
Наверное он хотел сказать: "надо фильтровать по Objectid
Нуриддин
Наверное он хотел сказать: "надо фильтровать по Objectid
Возможно, надо потом уточнить
Нуриддин
Спасибо коллеги, выручили)
 Александр
Всем привет.
Подскажите как лучше решить эту задачу. Есть документ структуры:
{
categoryType: str,
...
indicator_values: [
{
value: str,
date: datetime,
description: str,
},
]
}
Я хочу сгруппировать его по categoryType и в indicator_values оставить при этом только поля объектов value и data.
Пытался сделать с помощью следующей группировки:
{
_id: "$categoryType",
indicator_values: {
$push: {
value: "$indicator_values.value",
date: "$indicator_values.date",
},
},
}
Но у меня получается структура следующая, к сожалению:
{
categoryType: str,
indicator_values: [
{
value: [...],
date: [...],
},
]
}
т.е. поля объекта indicator_value сейчас разделены по двум массивам одинакового размера. Возможно ли это решить задачу в этой же операции group?
Viktar
 yopp
yopp
если документов тысячи и элементов массива десятки-сотни, то это дешевле чем $unwind, так как количество документов в пайплайне не растёт, а только уменьшается,
если таких объёмов нет, то $unwind более читаемый вариант
Jk
Здравствуйте
Jk
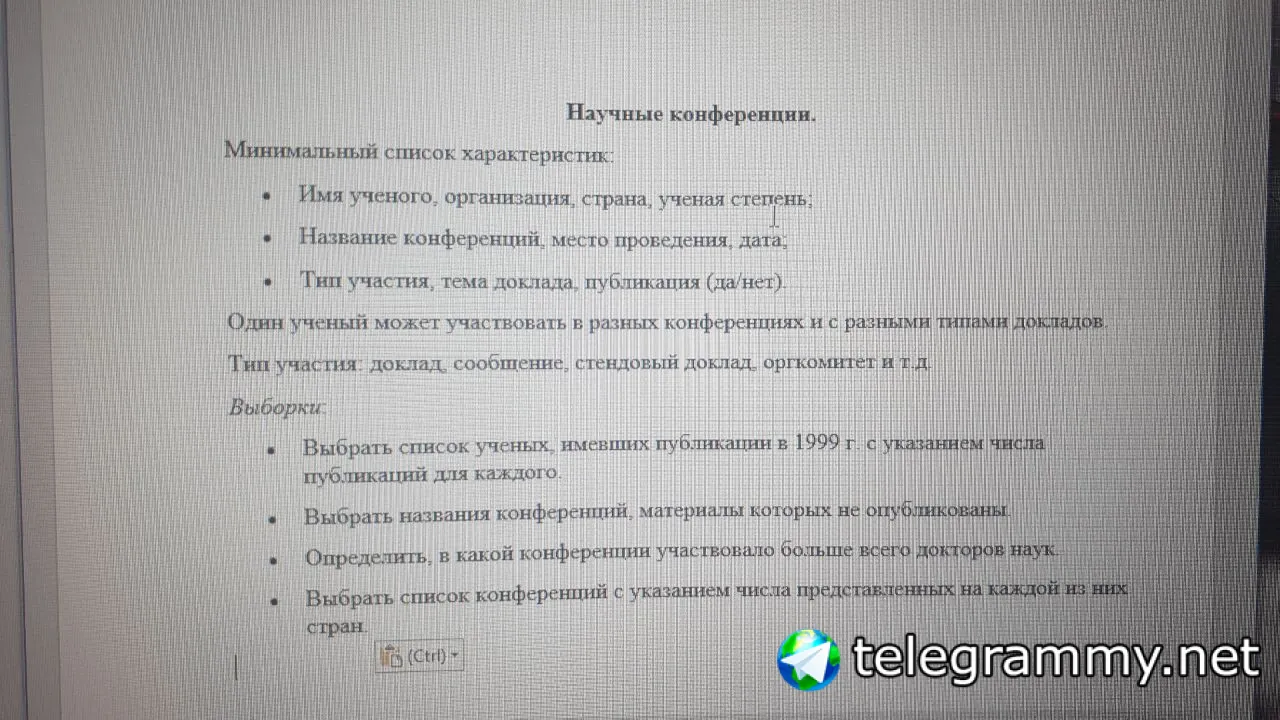
Тут нельзя получить готовую базу данных?
Jk
Просто в интернете по 300-600р
Jk
Бд научная конференция
Jk
 Nick
Jk
Ахах
Jk
Это отчёт
Jk
Я вообще хз просто
Jk
На практике не проходили бд
Jk
И нам сказали вставить в отчёт
Jk
Им говоришь не изучали, а им пох деньги нужны
Jk
Если не сложно помогите
 Makar M.
А ChatGPT не справляется?
Jk
Нет