а, если это только планы, то никаких проблем нет и монга покроет даже без навыков
Не, шардирование это не совсем то что мне нужно. Я бы хотел иметь что-то что item.date > today - 10days где-то на горяченьком ssd, а всё остальное в hdd где-то далеко
А под инкрементными бэкапами, я имею в виду те бэкапы, которые не перезаписывают целый файл с бэкапом с нуля, а лишь дописывают в файл то, что изменилось
 Lama

 Lama
Не, шардирование это не совсем то что мне нужно. Я бы хотел иметь что-то что item.date > today - 10days где-то на горяченьком ssd, а всё остальное в hdd где-то далеко
А под инкрементными бэкапами, я имею в виду те бэкапы, которые не перезаписывают целый файл с бэкапом с нуля, а лишь дописывают в файл то, что изменилось
Я, конечно, знаю про ZFS и btrfs, но вдруг монга умеет делать эти вещи сама
ЗЫ, на холодный бэкап, который будет изолирован от самой бд я вообще не рассчитываю, если что
 Nick
Не, шардирование это не совсем то что мне нужно. Я бы хотел иметь что-то что item.date > today - 10days где-то на горяченьком ssd, а всё остальное в hdd где-то далеко
А под инкрементными бэкапами, я имею в виду те бэкапы, которые не перезаписывают целый файл с бэкапом с нуля, а лишь дописывают в файл то, что изменилось
первое есть, нужно только настраивать зоны, ну и все остальные приколы с шардами остаются.
Таких инкрементов "удобных" не замечено, можно костылями както сделать, но проще на фс это делегировать
Lama
первое есть, нужно только настраивать зоны, ну и все остальные приколы с шардами остаются.
Таких инкрементов "удобных" не замечено, можно костылями както сделать, но проще на фс это делегировать
Понял, спасибо за инфу, пойду изучать коллекции и шардирование пока
 Eshu
Монга умеет строить индекс не блокируя доступ на чтение? Как с ней партиционировать данные? Может подскажешь статей, если знаешь
Вижу знакомые хотелки постгресовода))
В том виде в котором вы ожидаете - нет. Но можно использовать шардирование.
 Roman
Ребята, подскажите получаю такую ошибку в логах MongooseServerSelectionError: connect ECONNREFUSED 127.0.0.1:27017
Это моя часть кода где коннектит, но не получаеться.
mongoose.connect('mongodb://127.0.0.1:27017/list', {
useNewUrlParser: true
});
Локально через cli могу подключиться используя mongosh
Nick
Вижу знакомые хотелки постгресовода))
В том виде в котором вы ожидаете - нет. Но можно использовать шардирование.
Расскажите как у вас зашла монга или нет? И задача похожая была или только требования ?
Eshu
Расскажите как у вас зашла монга или нет? И задача похожая была или только требования ?
В целом - норм. У меня она идёт как вспомогательное хранилище слабо структурированной информации, куда лезть нужно либо по _id, либо по паре структурированных полей. Пока задача ограничивалась этим - все было отлично.
А потом у бизнеса возникли непростые статистические хотелки, и вот тут я пострадал с 10ти ступенчатыми аггрегациями. Неделя страданий и все снова норм.
Основное хранилище у меня тарантул, а туда статистические запросы приемлемой скорости не запихнуть.
 Mike
https://ru.stackoverflow.com/questions/1482853/%d0%92%d1%8b%d1%82%d0%b0%d1%89%d0%b8%d1%82%d1%8c-%d0%b2%d1%81%d0%b5-%d0%b4%d0%be%d0%ba%d1%83%d0%bc%d0%b5%d0%bd%d1%82%d1%8b-%d0%b8%d0%b7-%d0%ba%d0%be%d0%bb%d0%bb%d0%b5%d0%ba%d1%86%d0%b8%d0%b8-%d0%ba%d1%80%d0%be%d0%bc%d0%b5-%d0%be%d0%b4%d0%bd%d0%be%d0%b3%d0%be-%d0%ba%d0%be%d0%bd%d0%ba%d1%80%d0%b5%d1%82%d0%bd%d0%be%d0%b3%d0%be
 Dmitry
как конкретно запрос оформить в таком случае?
Но это не добавит скорости т.к. каждый элемент будет сравниваться, хотя мб получше станет, если есть индексация
Mike
Но это не добавит скорости т.к. каждый элемент будет сравниваться, хотя мб получше станет, если есть индексация
допустим - тело запроса к базе как должно быть оформлено в данном случае?
Dmitry
У вас слегка не понятный вопрос. Опишите его по другому либо больше инфы/примеров дайте
Mike
У вас слегка не понятный вопрос. Опишите его по другому либо больше инфы/примеров дайте
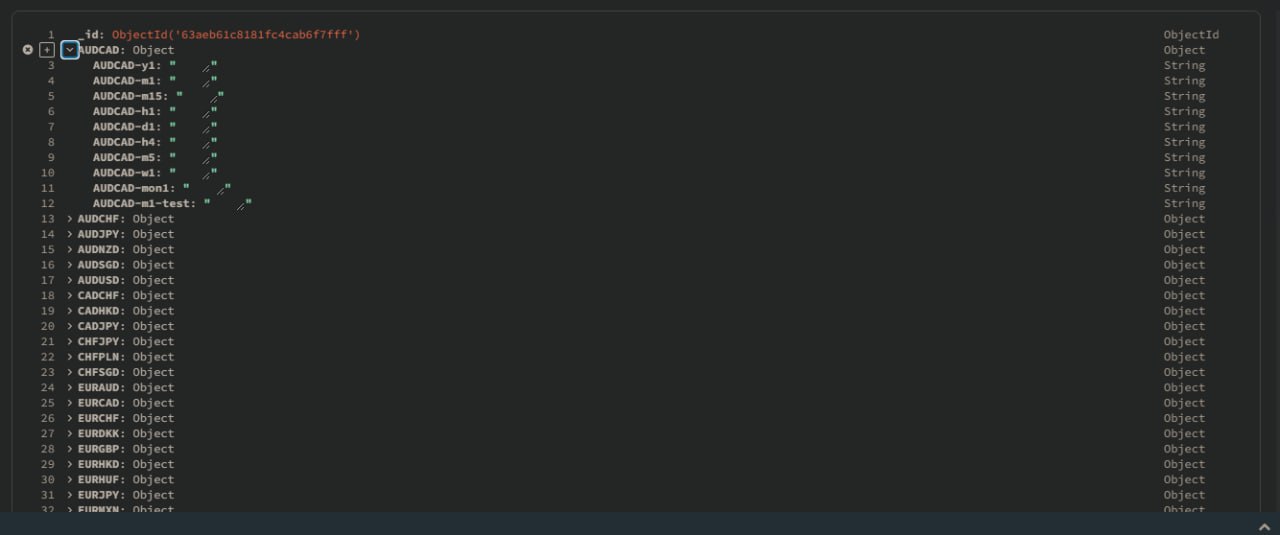
ну просто надо вытащить вообще все что лежит в коллекции
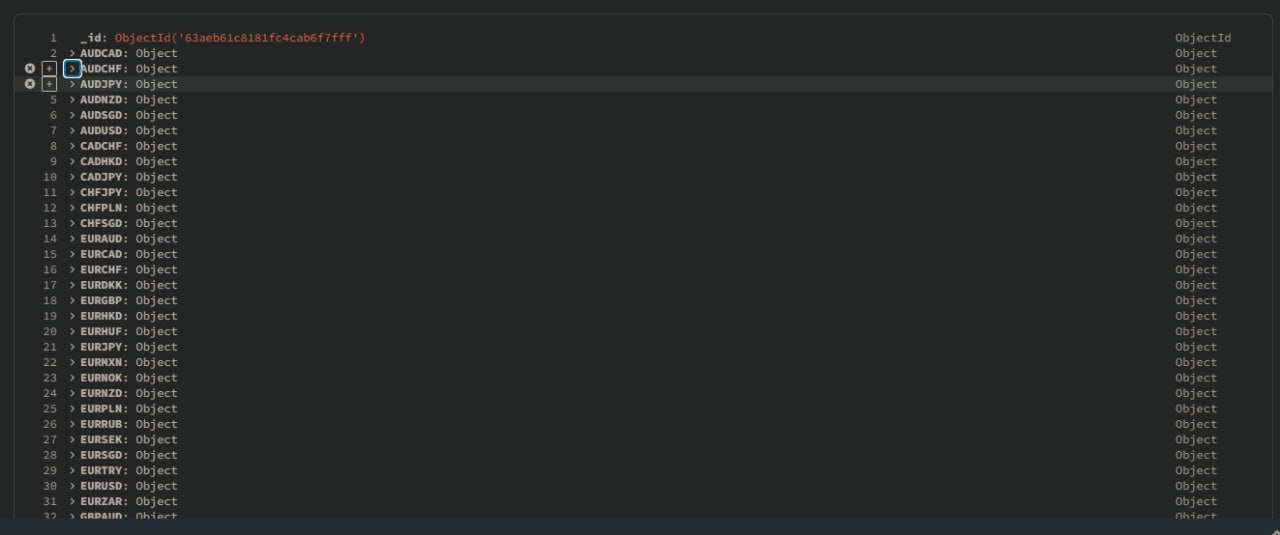
(кроме _id: '63aeb61c8181fc4cab6f7fff')
Dmitry
Mike
монга версии 6
Mike
.find().projection({_id: 0})
console.log(databasesAndCollections.find().projection({_id: 0}));
^
TypeError: databasesAndCollections.find(...).projection is not a function
at getDatabasesAndCollections (E:\Progi3\Trading-tester-vanilla-node\models\currencyModel.js:28:46)
at processTicksAndRejections (node:internal/process/task_queues:96:5)
Process finished with exit code 1
Dmitry
 Dmitry
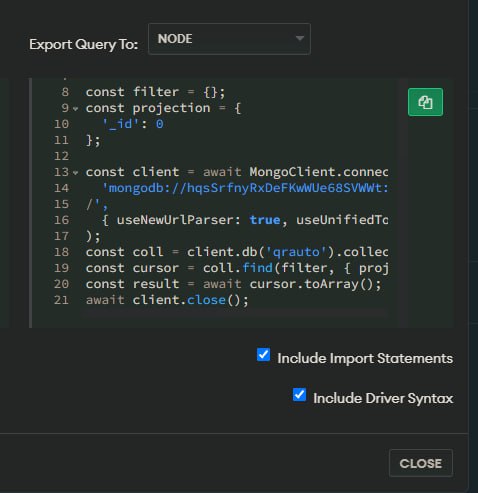
У них там генератор кода добавился
Dmitry
Dmitry
Мб пол года назад была перегрузка, что вторым параметром можно было прокидывать projection
Dmitry
Он же сказал всё должно быть, кроме _id
Mike
 Mike
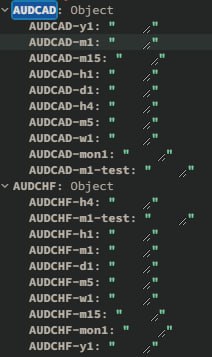
вот такого рода данные я хочу вытащить - только все до единого - не обращаясь к ним по каждому ключу
Mike
но айдишник мне не нужен это лишнее
Mike
 Mike
вот так они выглядят в свернутом виде
Dmitry
Как по мне, описание задачи сводится к тому, что нужен projection
Mike
 Mike
E:\Downloads\Node\proga\node.exe E:\Progi3\Trading-tester-vanilla-node\models\currencyModel.js
FindCursor {
_events: [Object: null prototype] {},
_eventsCount: 0,
_maxListeners: undefined,
[Symbol(kCapture)]: false,
[Symbol(topology)]: Topology {
_events: [Object: null prototype] {
open: [Function],
connectionPoolCreated: [Function (anonymous)],
connectionPoolClosed: [Function (anonymous)],
connectionCreated: [Function (anonymous)],
connectionReady: [Function (anonymous)],
connectionClosed: [Function (anonymous)],
connectionCheckOutStarted: [Function (anonymous)],
connectionCheckOutFailed: [Function (anonymous)],
connectionCheckedOut: [Function (anonymous)],
connectionCheckedIn: [Function (anonymous)],
connectionPoolCleared: [Function (anonymous)],
commandStarted: [Function (anonymous)],
commandSucceeded: [Function (anonymous)],
commandFailed: [Function (anonymous)],
serverOpening: [Function (anonymous)],
serverClosed: [Function (anonymous)],
serverDescriptionChanged: [Function (anonymous)],
topologyOpening: [Function (anonymous)],
topologyClosed: [Function (anonymous)],
topologyDescriptionChanged: [Function (anonymous)],
error: [Function (anonymous)],
timeout: [Function (anonymous)],
close: [Function (anonymous)],
serverHeartbeatStarted: [Function (anonymous)],
serverHeartbeatSucceeded: [Function (anonymous)],
serverHeartbeatFailed: [Function (anonymous)]
},
_eventsCount: 26,
_maxListeners: undefined,
bson: [Object: null prototype] {
serialize: [Function: serialize],
deserialize: [Function: deserialize]
},
s: {
id: 0,
options: [Object: null prototype],
seedlist: [Array],
state: 'connecting',
description: [TopologyDescription],
serverSelectionTimeoutMS: 30000,
heartbeatFrequencyMS: 10000,
minHeartbeatFrequencyMS: 500,
servers: [Map],
sessionPool: [ServerSessionPool],
sessions: Set(0) {},
credentials: undefined,
clusterTime: undefined,
connectionTimers: Set(0) {},
detectShardedTopology: [Function: detectShardedTopology],
detectSrvRecords: [Function: detectSrvRecords]
},
[Symbol(kCapture)]: false,
[Symbol(waitQueue)]: Denque {
_head: 1,
_tail: 2,
_capacity: undefined,
_capacityMask: 3,
_list: [Array]
}
},
[Symbol(namespace)]: MongoDBNamespace {
db: 'startInitialization',
collection: 'databases&Collections'
},
[Symbol(documents)]: [],
[Symbol(initialized)]: false,
[Symbol(closed)]: false,
[Symbol(killed)]: false,
[Symbol(options)]: {
readPreference: ReadPreference {
mode: 'primary',
tags: undefined,
hedge: undefined,
maxStalenessSeconds: undefined,
minWireVersion: undefined
},
fieldsAsRaw: {},
promoteValues: true,
promoteBuffers: false,
promoteLongs: true,
serializeFunctions: false,
ignoreUndefined: false,
bsonRegExp: false,
raw: false,
enableUtf8Validation: true
},
[Symbol(filter)]: {},
[Symbol(builtOptions)]: {
projection: { _id: 0 },
raw: false,
promoteLongs: true,
promoteValues: true,
promoteBuffers: false,
ignoreUndefined: false,
bsonRegExp: false,
serializeFunctions: false,
fieldsAsRaw: {},
enableUtf8Validation: true,
readPreference: ReadPreference {
mode: 'primary',
tags: undefined,
hedge: undefined,
maxStalenessSeconds: undefined,
minWireVersion: undefined
}
}
}
Mike
ну он мне не нужен в респонсе
Ярик
Думаю над тем, какой подход лучше выбрать для хранения данных
У меня есть поток поступающих данных (небольшие строки), которые сейчас я просто записываю в одномерный массив mongodb вместе с основной коллекцией
Есть второй вариант - разделить данные на 2 коллекции - в одной хранить основные данные - а во второй все поступающие с условным ключем (ссылкой) на первую коллекцию
Ярик
Меня бы полностью устроил первый вариант, но есть некоторые документы в основной коллекции, в которых придётся завязывать много (?) данных на один ключ (возможны ситуации, когда каждый день могу поступать данные в одномерный массив)
Dmitry
Ярик
 Dmitry
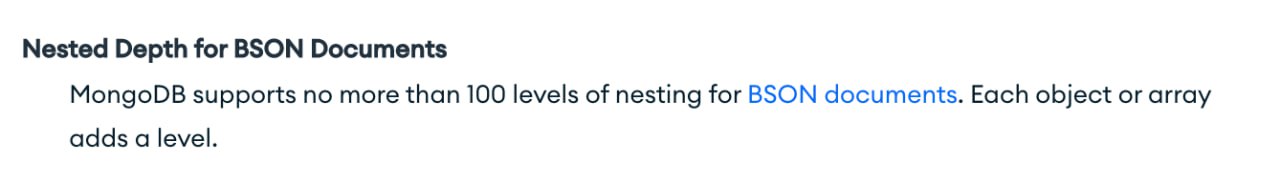
Вам стоит уделить внимание на ограничение размера документа т.к. оно состовляет 16 МБ и ни как нельзя его изменить, а также на вложенность, тут особых ограничений нет, есть только рекомендации, но в случае превышения лимита, то база хуже будет справляться с поиском документов
Ярик
Понял, всё-таки создам отдельную коллекцию и там буду хранить эти данные отдельно, всякие ситуации могут быть, хотя лимит 16 мб очень вряд ли превышу таким образом
 Alexander
Ярик
но если это обычные строки в массиве и их, условно, больше 100, это затупит производительность, если равнять с кейсом, когда я эти данные сохраню в отдельную таблицу?
Ярик
на практике, при поиске мне нужно будет всегда ссылаться на какой-то один элемент (строку) из массива для поиска всего документа
 Vladyslav
но если это обычные строки в массиве и их, условно, больше 100, это затупит производительность, если равнять с кейсом, когда я эти данные сохраню в отдельную таблицу?
100, nested elements имеется ввиду ключей.
Насчет массива с 100+ элементов - все нужно смотреть на реальных кейсах.
Может быть 100 интов, а может быть 100 строк и реджекс поиск - и будет вам разница в производительности
 Alexandrr
Понял, всё-таки создам отдельную коллекцию и там буду хранить эти данные отдельно, всякие ситуации могут быть, хотя лимит 16 мб очень вряд ли превышу таким образом
а в чём проблема сделать доп. идентификаторы с набором параметров?
некие условные сокращения
только эту таблицу нужно жёстко задокументировать и от неё отталкиваться как бэкендерам, так и фронтам
Alexander
но если это обычные строки в массиве и их, условно, больше 100, это затупит производительность, если равнять с кейсом, когда я эти данные сохраню в отдельную таблицу?
Зависит от реализации, в том числе бэка. Если хранить данные в отдельной коллекции, то lookup будет вынужден искать совпадение по ключу, что как раз снизит производительность. С другой стороны обновление и вставка, вероятно, будут быстрее.
Alexandrr
Зависит от реализации, в том числе бэка. Если хранить данные в отдельной коллекции, то lookup будет вынужден искать совпадение по ключу, что как раз снизит производительность. С другой стороны обновление и вставка, вероятно, будут быстрее.
смотря какой поиск, какой ключ и какой поисковой фрагмент данных.
но, априори - поиск по индексированному уникальному (ключу) полю, это самое быстрое, что существует
Ярик
Зависит от реализации, в том числе бэка. Если хранить данные в отдельной коллекции, то lookup будет вынужден искать совпадение по ключу, что как раз снизит производительность. С другой стороны обновление и вставка, вероятно, будут быстрее.
Обновление и вставка - не сильно страшно, там такие кейсы будут встречаться не чаще пары сотен (возможно тысяч) раз в день
Alexander
Однозначно покажет только нагрузочное тестирование 🤷♂
Alexandrr
Обновление и вставка - не сильно страшно, там такие кейсы будут встречаться не чаще пары сотен (возможно тысяч) раз в день
да вообще не парься тогда, я думал как у меня от 50кк до 150кк обновлений 1 раз в полдня
Ярик
Ярик
всем большое спасибо за советы и наводку )
Alexander
смотря какой поиск, какой ключ и какой поисковой фрагмент данных.
но, априори - поиск по индексированному уникальному (ключу) полю, это самое быстрое, что существует
Я про то, что если массив уже в документе, то уже как минимум не придётся искать, какие элементы другой коллекции к нему относятся, потому что они уже в нём.
Alexandrr
в принципе на стандартной тестовой тачке с:
- 250/500 мб подключением сети
- 4 гб озу
- 2 ядра 3.2 ГГц+
- луникс
монга держит без нареканий 1к-5к TPS при правильном распределении на коллекции, лёгких односложных запросах и ответах не более 100 кб данных (ну тут уже от диска зависит, но в основном с SSD проблем ни каких).
в других случаях, требуется апдейт либо тачки, либо архитектуры
п.с.
тестил на 7 разных хостингах, разброс был менее 10%
 Асаин
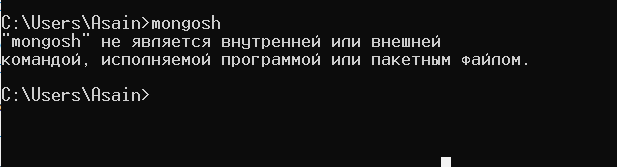
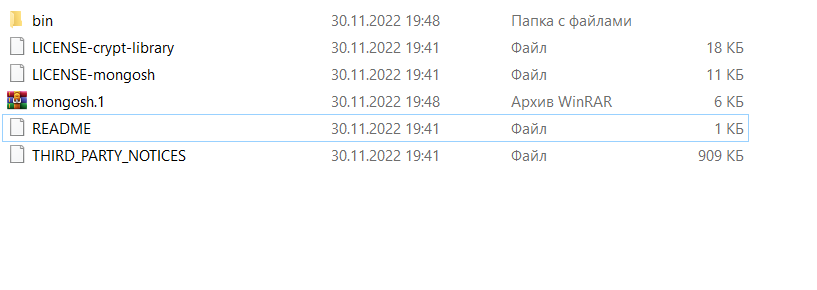
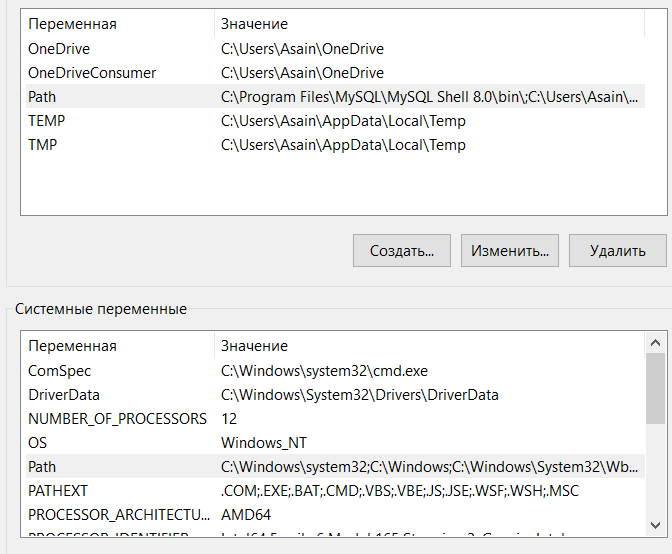
Всем привет. Народ, установил mongodb server, на компьютере установлен compass. Хочу установить Shell. В командной строке проверял mongosh - пишет что не обнаружено. Скачал с сайта zip архив с Shell - теперь не знаю как дальше быть
Асаин
распакованный архив
Асаин
 Асаин
 Nick
Асаин
спасибо, сейчас попробую
Асаин
 Асаин
 Dmitry
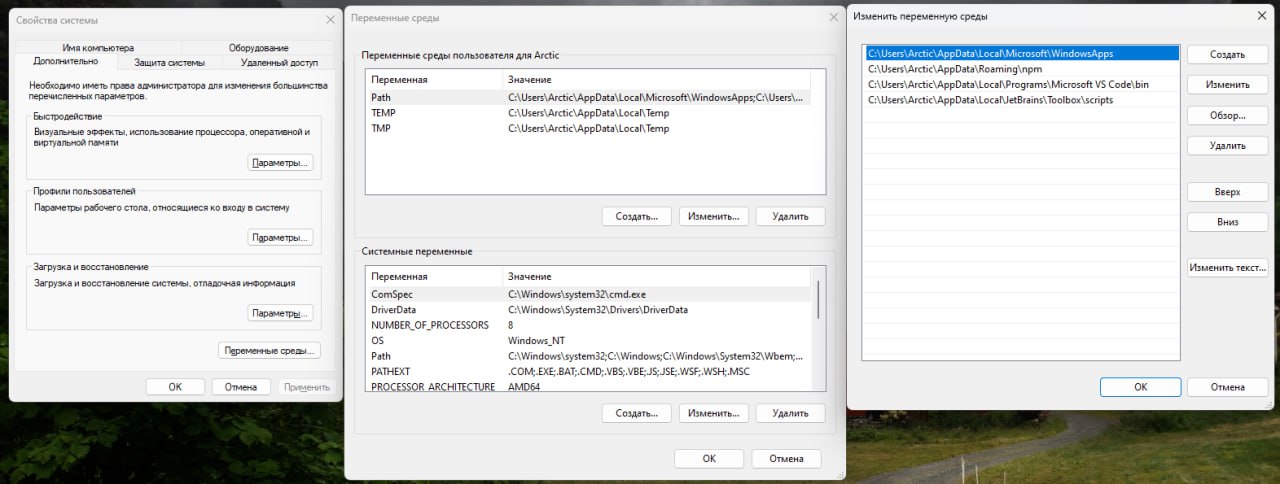
Тут конкретно ваш случай не рассмотрен, но мысль должна быть ясна
Dmitry
Нажимаете создать и вставляете путь до файла
C
 Dmitry
C
В вашем случае вы находите $$ROOT документ, а вам надо сначала найти $$ROOT, а потом уже в нем искать через $elementMatch нужный в массиве и уже туда делать push
Да вот хотелось бы без агрегации, иначе можно и прямо документ поковырять в жсе
Dmitry
Да вот хотелось бы без агрегации, иначе можно и прямо документ поковырять в жсе
А причем тут агрегация?
Dmitry
Это работает в обычном find
C
А причем тут агрегация?
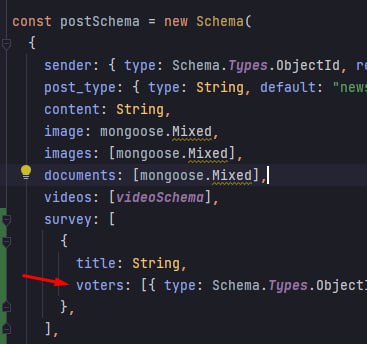
Тогда не понимаю, зачем нужен елемМатч, у меня есть айди документа, есть индекс конкретного элемента массива survey, но пуш туда не работает(вероятно я неправильный синтаксис использую)
C
Это работает в обычном find
await Post.findByIdAndUpdate(postId, {
$push: {
[`survey.${optionIndex}.voters`]: userId,
},
});
Нужно было заменить последовательность ключей, и всё завелось
Dmitry
Тогда не понимаю, зачем нужен елемМатч, у меня есть айди документа, есть индекс конкретного элемента массива survey, но пуш туда не работает(вероятно я неправильный синтаксис использую)
Если вы не хотите использовать $elementMatch, то вот решение .findOneAndUpdate({ _id: new ObjectId('63b42ade113ad025eceefdee')}, { $push: { [`survey.${id}.voters`]: 'c-7' } })
C
Если вы не хотите использовать $elementMatch, то вот решение .findOneAndUpdate({ _id: new ObjectId('63b42ade113ad025eceefdee')}, { $push: { [`survey.${id}.voters`]: 'c-7' } })
То я от Нг видимо ещё не отошел, начал сперва ключа название пихать, а внутри него пуш. Хоть мы и одновременно ответ написали, всё равно спасибо )
Mike
Такой вопрос:
Есть множество баз но в каждой присутствует допустим коллекция:
m1-test
и документ в ней: approximateDate
какой существует оптимальных подход в плане обойти все имеющиеся базы зайти в каждую коллекцию и в документ который указан + затем вытащить из этого документа данные
(и куда то там допустим положить)
как это реализовывать корректнее всего?