show dbs
как ее применить в проекте - к какому обьекту это св-во привязать?
(как только не пробовал - не получается)
 Mike


 Dmitry
это я понимаю - а у меня файл в ноде
https://www.mongodb.com/docs/manual/reference/command/listDatabases/#examples
Mike
https://www.mongodb.com/docs/manual/reference/command/listDatabases/#examples
пробовал - не работает:
http://joxi.ru/vAWWbPKIRBxOyA
Mike
в чем причина?
Mike
тогда надо все таки мне понять конечный вариант корректный
Mike
http://joxi.ru/p27ZKN9UZndnlm
Mike
пока что вот такой результат есть
Mike
не совсем понятно что это означает
Mike
короче не работает нифига пока что - из всего что пробовал
Mike
уже гуглил час
Mike
не
http://joxi.ru/82Qj0PQH4Va8aA
(если речь об этом конечно)
Mike
http://joxi.ru/RmzB1JxTVjLVVm
тоже самое
Dmitry
 Dmitry
Спасибо!
Заработало.
http://joxi.ru/KAxpx8oHwvGbQA
shift + win + s чтобы сделать скриншот на windows
Mike
иногда такое происходит не пойму по какой причине
Mike
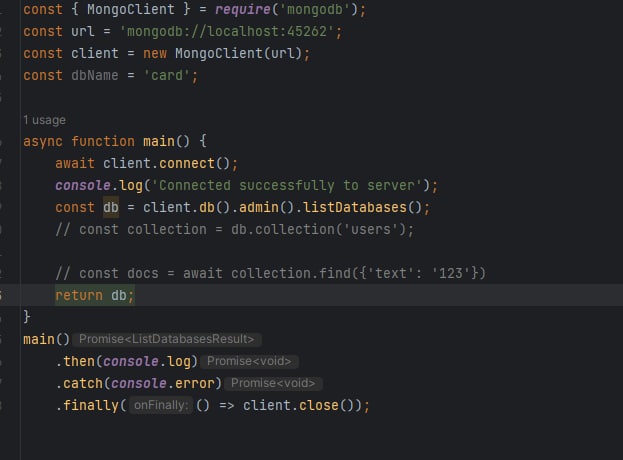
можно ли итерироватьcя по именам баз и вытаскивать значения имен всех коллекций - если да то как?
Mike
(как итерироваться по именам баз - это задача уже выполнена)
 yopp
Если у вас драйвер для nodejs 4.x+ то список коллекций можно получить вот таким образом:
https://mongodb.github.io/node-mongodb-native/4.13/classes/Admin.html
Mike
Если у вас драйвер для nodejs 4.x+ то список коллекций можно получить вот таким образом:
https://mongodb.github.io/node-mongodb-native/4.13/classes/Admin.html
Из того что увидел - по идее это вытаскивается спискок имен баз а НЕ коллекций - или я что то не правильно понял?
Mike
 Dmitry
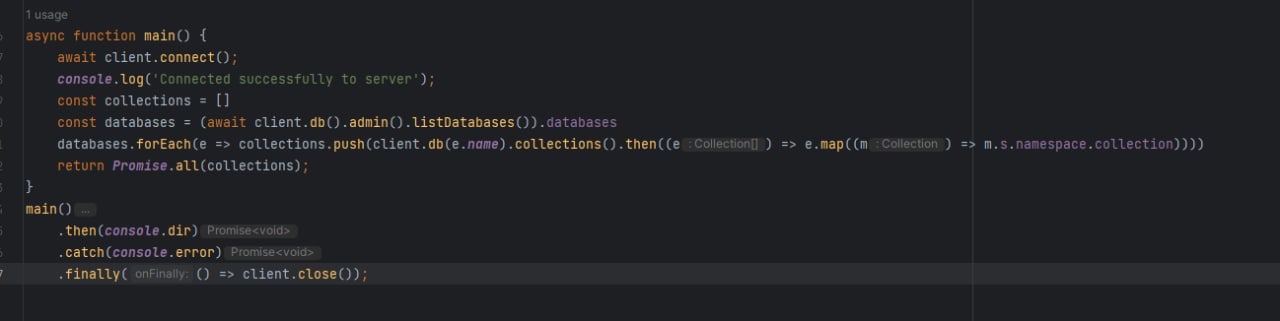
const collections = []
const databases = (await client.db().admin().listDatabases()).databases
databases.forEach(e => collections.push(client.db(e.name).collections().then((e) => e.map((m) => m.s.namespace.collection))))
return Promise.all(collections);
Mike
const collections = []
const databases = (await client.db().admin().listDatabases()).databases
databases.forEach(e => collections.push(client.db(e.name).collections().then((e) => e.map((m) => m.s.namespace.collection))))
return Promise.all(collections);
а если необходимо ключ вставить с именем базы перед всем этим результатом - то как это реализовать? )
попробовал нечто подобное:
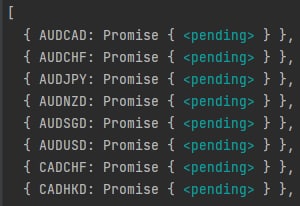
databases2.forEach(e => collections.push({ [e.name] : client.db(e.name).collections().then((e) => e.map((m) => m.s.namespace.collection))}))
но получил:
Mike
 Mike
как то эти промисы в правой части можно вычислить?
Dmitry
Dmitry
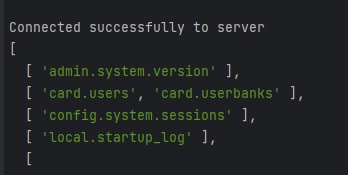 Dmitry
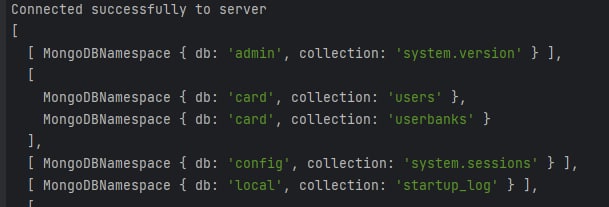 Dmitry
второй вариант
databases.forEach(e => collections.push(client.db(e.name).collections().then((e) => e.map((m) => m.s.namespace))))
yopp
Из того что увидел - по идее это вытаскивается спискок имен баз а НЕ коллекций - или я что то не правильно понял?
Неверно прочитал, в этом случае наверное что-то в духе
const db = client.db(<name>);
const collections = await db.listCollections();
console.log(collections.toArray());
Mike
databases.forEach(e => collections.push(client.db(e.name).collections().then((e) => e.map((m) => m.s.namespace))))
это тоже не совсем то:
если еще точнее то необходим 1 ключ в виде имени базы и куча значений в виде имен коллекций
+ без монго дб спейсов
Dmitry
это тоже не совсем то:
если еще точнее то необходим 1 ключ в виде имени базы и куча значений в виде имен коллекций
+ без монго дб спейсов
databases.forEach(e => collections.push(client.db(e.name).collections()
.then((e) => ({ db: e[0].s.namespace.db, collections: e.map((m) => m.s.namespace.collection) }))))
Mike
пример:
[{EURUSD: {имена коллекций}}]
Dmitry
пример:
[{EURUSD: {имена коллекций}}]
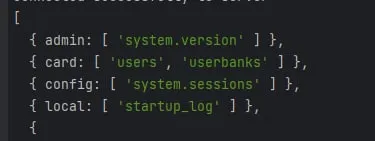
databases.forEach(e => collections.push(client.db(e.name).collections()
.then((e) => ({ [e[0].s.namespace.db]: e.map((m) => m.s.namespace.collection) }))))
 Иван
Добрый день!
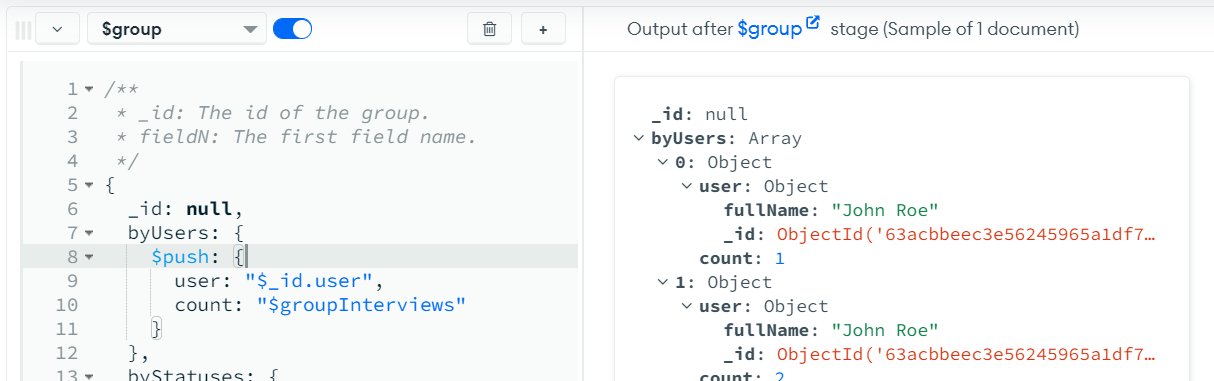
aggregate, match, lookup
На что работает match? Он работает на все lookup? Т.е. работает ли match на данные, которые были получены после lookup? Или он работает только на начальную коллекцию, т.е. ту к которой происходит агрегация
Если из аналогии из sql:
SELECT * FROM tbl1
LEFT JOIN tbl2 ON tbl2.tbl1_id = tbl1.id
LEFT JOIN tbl3 ON tbl3.tbl3_id = tbl1.id
WHERE tbl2.name LIKE %t%
Roman Khonichev
это как pipe, каждый шаг преобразует данные, которые в него прилетают
Roman Khonichev
match фильтрует набор данных который в него пришел, инструкции после него работают с тем, что он наыильтровал ниже
Иван
match фильтрует набор данных который в него пришел, инструкции после него работают с тем, что он наыильтровал ниже
т.е. положение match в aggregate имеет значение?
Roman Khonichev
да, работает ровно как конвеер
 Vova
 Yaroslav
 of Astora 𒉭
привет всем
findById быстрее чем findOne? и в каких случаях использовать тот или иной метод?
 Nick
привет всем
findById быстрее чем findOne? и в каких случаях использовать тот или иной метод?
в byId аргумент это id, в one - объект запроса для фильтрации
of Astora 𒉭
в byId аргумент это id, в one - объект запроса для фильтрации
а если велик соблазн использовать One, то что быстрее из них двоих?
Nick
а если велик соблазн использовать One, то что быстрее из них двоих?
без разницы, все они работают одинаково под капотом
of Astora 𒉭
оба одинаковы
Dmitry
привет всем
findById быстрее чем findOne? и в каких случаях использовать тот или иной метод?
findByid эквивалентен findOne(_id: 63318bdacf1fb4d94ddf6c3d)
 Eshu
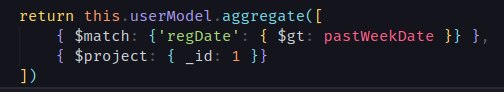
Товарищи, кто-нибудь игрался с монгой в режиме in-memory?

 Yury
Может кто знает, есть ли какой-то способ замены ID элементов из базы данных MySQL (они там как обычные числа 1 2 3 4...) на _id из базы MondoDB? Как это можно правильно сделать при миграции? Просто не хочется оставлять эти поля, так как Mongo свои уникальныe айдишники уже подставляет. (Если что я экспортировал SQL таблицы в JSON)
 Ilya
Eshu
Да
А можете поделиться опытом?
Какая примерная нагрузка?
Как оно использовалось - как отдельностоящий кэш или были несколько неголосующих реплик в репликасете?
Как впечатления по быстродействию? Сравнивали ли с другими in-memory решениями?
Извините за обилие вопросов:)
Dmitry
Может кто знает, есть ли какой-то способ замены ID элементов из базы данных MySQL (они там как обычные числа 1 2 3 4...) на _id из базы MondoDB? Как это можно правильно сделать при миграции? Просто не хочется оставлять эти поля, так как Mongo свои уникальныe айдишники уже подставляет. (Если что я экспортировал SQL таблицы в JSON)
Написал скрипт, проверил на небольшом количестве данных и потом прогнал полный цикл. Мб есть готовые решения
Yury
Написал скрипт, проверил на небольшом количестве данных и потом прогнал полный цикл. Мб есть готовые решения
вот так и думаю сделать, но как мне кажется кейс не редкий и явно много кто через это проходил и поэтому должны быть готовые решения
 Alexander
А можете поделиться опытом?
Какая примерная нагрузка?
Как оно использовалось - как отдельностоящий кэш или были несколько неголосующих реплик в репликасете?
Как впечатления по быстродействию? Сравнивали ли с другими in-memory решениями?
Извините за обилие вопросов:)
Да, в личку напишите, вечером напишу детали
 Lama
Привет, чатик, подскажите пожалуйста, подойдёт ли монга под мой юзкейс, может быть подскажете статей или даже накидаете план.
Делаю большой интернет магазин, у меня есть очень много товаров (примерно 1тб в csv). У этих товаров есть поля, которые встречаются у всех сущностей: название, категория, цена и т.д. Есть поля, которые встречаются у сущностей только определённых категорий (например, у отвёрток есть форма наконечника).
Я хочу иметь максимально гибкую систему и уметь создавать индексы по каким-то полям в рантайме. Я хочу уметь заливать данные большими пачками во время работы. Я хочу уметь партиционировать данные: иметь более быстрый доступ к недавним товарам, а старые товары класть куда-нибудь подальше (на соседний диск или даже сжимать). Плюс я хочу уметь делать инкрементивные бэкапы.
Монга такое умеет? Если нет, то какими хотелками можно пожертвовать, чтобы монга подошла?
ЗЫ, я про mongodb не знаю примерно ничего, так что может вообще не попадаю в юзкейсы, но с тех пор как данные о товарах ко мне попадают очень гетероморфные, я подумал что документная бд может подойти
Eshu
Привет, чатик, подскажите пожалуйста, подойдёт ли монга под мой юзкейс, может быть подскажете статей или даже накидаете план.
Делаю большой интернет магазин, у меня есть очень много товаров (примерно 1тб в csv). У этих товаров есть поля, которые встречаются у всех сущностей: название, категория, цена и т.д. Есть поля, которые встречаются у сущностей только определённых категорий (например, у отвёрток есть форма наконечника).
Я хочу иметь максимально гибкую систему и уметь создавать индексы по каким-то полям в рантайме. Я хочу уметь заливать данные большими пачками во время работы. Я хочу уметь партиционировать данные: иметь более быстрый доступ к недавним товарам, а старые товары класть куда-нибудь подальше (на соседний диск или даже сжимать). Плюс я хочу уметь делать инкрементивные бэкапы.
Монга такое умеет? Если нет, то какими хотелками можно пожертвовать, чтобы монга подошла?
ЗЫ, я про mongodb не знаю примерно ничего, так что может вообще не попадаю в юзкейсы, но с тех пор как данные о товарах ко мне попадают очень гетероморфные, я подумал что документная бд может подойти
Сложные статистические запросы с множественными джоинами таблиц планируются? Если нет - монга вроде бы подходит по всем вашим запросам, только я не в курсе, умеет ли она в инкрементный бэкап.
Lama
Сложные статистические запросы с множественными джоинами таблиц планируются? Если нет - монга вроде бы подходит по всем вашим запросам, только я не в курсе, умеет ли она в инкрементный бэкап.
Статистику решил что прикручу сбоку на кликхаусе
Lama
Тогда выглядит как кейс для монги, имхо.
Монга умеет строить индекс не блокируя доступ на чтение? Как с ней партиционировать данные? Может подскажешь статей, если знаешь
Nick
Монга умеет строить индекс не блокируя доступ на чтение? Как с ней партиционировать данные? Может подскажешь статей, если знаешь
1. в целом да
2. если под партицинированием по6нимается зонирование на горячие/холодные данные то почитайте в доке про шардирование и зоны
Lama
1. в целом да
2. если под партицинированием по6нимается зонирование на горячие/холодные данные то почитайте в доке про шардирование и зоны
Спасибо, почитаю и вернусь с вопросами после НГ :3
Nick
Привет, чатик, подскажите пожалуйста, подойдёт ли монга под мой юзкейс, может быть подскажете статей или даже накидаете план.
Делаю большой интернет магазин, у меня есть очень много товаров (примерно 1тб в csv). У этих товаров есть поля, которые встречаются у всех сущностей: название, категория, цена и т.д. Есть поля, которые встречаются у сущностей только определённых категорий (например, у отвёрток есть форма наконечника).
Я хочу иметь максимально гибкую систему и уметь создавать индексы по каким-то полям в рантайме. Я хочу уметь заливать данные большими пачками во время работы. Я хочу уметь партиционировать данные: иметь более быстрый доступ к недавним товарам, а старые товары класть куда-нибудь подальше (на соседний диск или даже сжимать). Плюс я хочу уметь делать инкрементивные бэкапы.
Монга такое умеет? Если нет, то какими хотелками можно пожертвовать, чтобы монга подошла?
ЗЫ, я про mongodb не знаю примерно ничего, так что может вообще не попадаю в юзкейсы, но с тех пор как данные о товарах ко мне попадают очень гетероморфные, я подумал что документная бд может подойти
не зная о монге ничего, врываться на 1тб будет весело) индексы в рантайме - не про монгу, очень дорого по ресурсам и есть лимиты и в целом есть вариант при таком подходе получить больше индексов по размеру чем самих данных.
Партиционирование как уже сказал выше это про шардирование, но требует серьезного погружения в работу кластера и соответствующим образом готовить структуру и изапросы.
Инкрементные бекапы - только если файловая система поддерживает (хотя может и есть чего, на самом деле хз что в это понятие вкладывается)
В целом закладывайте как минимум х2 по времени от того что вам кажется что вы сможете начать крутить монгу. Плюс сверху время на перестройку БД уже под потребности и производительность (не факт что на ваших кейсах не будет проще в тот же эластик уйти)
Lama
не зная о монге ничего, врываться на 1тб будет весело) индексы в рантайме - не про монгу, очень дорого по ресурсам и есть лимиты и в целом есть вариант при таком подходе получить больше индексов по размеру чем самих данных.
Партиционирование как уже сказал выше это про шардирование, но требует серьезного погружения в работу кластера и соответствующим образом готовить структуру и изапросы.
Инкрементные бекапы - только если файловая система поддерживает (хотя может и есть чего, на самом деле хз что в это понятие вкладывается)
В целом закладывайте как минимум х2 по времени от того что вам кажется что вы сможете начать крутить монгу. Плюс сверху время на перестройку БД уже под потребности и производительность (не факт что на ваших кейсах не будет проще в тот же эластик уйти)
Ну я вот тоже подумываю насчёт postgresql с jsonb и эластиком поверх. Но пока ещё всё не началось, хочу рассмотреть все варианты
1тб пока что нет, на первых итерациях будет дай бог 50гб, но 1тб рано или поздно точно случится, из 1тб где-то 100гб будет горячих данных
Nick
Ну я вот тоже подумываю насчёт postgresql с jsonb и эластиком поверх. Но пока ещё всё не началось, хочу рассмотреть все варианты
1тб пока что нет, на первых итерациях будет дай бог 50гб, но 1тб рано или поздно точно случится, из 1тб где-то 100гб будет горячих данных
а, если это только планы, то никаких проблем нет и монга покроет даже без навыков