1. Время так не засекается т.к. у вас посторонние операции присутствуют.
2. Если вы не планируете дальше данные на стороне БД обрабатывать, то измените на find.
3. Если у вас X данных, а вам надо до 5725858, то напишите {_id: {$lt:5725858}} иначе ничего или пустой объект (мне не известно, что вы хотите добиться и получать всё записи не всегда хорошо).
посторонних операций там нет - там одни инициализации очень низконагруженные
 Mike

 Mike
3) проверил данный вариант по времени тожесамое
Mike
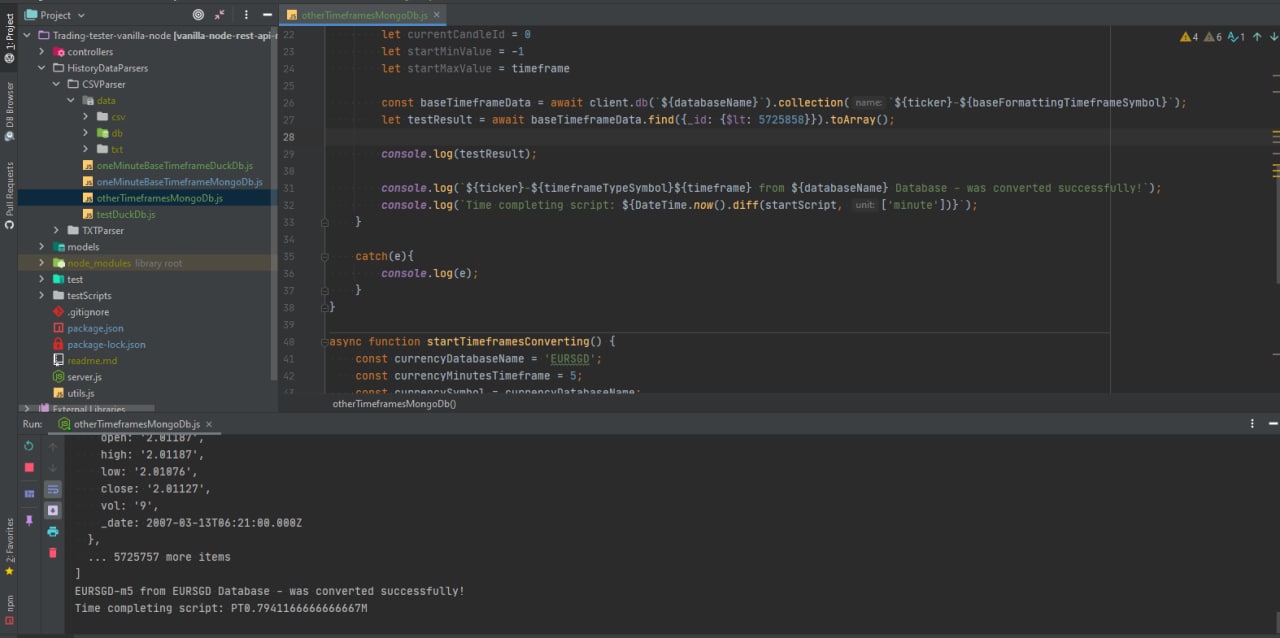 Mike
без консоли там будет на одну десятую долю минуты меньше
Mike
тоесть мы ничего не сократили в плане времени таким подходом
 Dmitry
посторонних операций там нет - там одни инициализации очень низконагруженные
Подключение БД это не посторонняя операция, ну ну
Mike
Подключение БД это не посторонняя операция, ну ну
так я же с бд беру данные - как без подключения то?
Mike
моя задача быстро брать данные с бд
Mike
само подключение там занимает одну сотую долю минуты или даже меньше
Mike
(тоесть практически ничего)
Dmitry
Когда приложение запускается, сразу устанавливается соединение и потом остальной функционал уже обращается к инстансу, в котором установлена связь
Mike
можем одну сотую в уме отнять - это роли не играет
Mike
Постоянно выполнять подключение к БД это тупо и не правильно
да это просто тестировочный код - суть же задачи не в подключени к бд
Mike
а понять насколько быстра монга и пригодна ли она для моих задачь
 Nick
Mike
по коду видно что в расчет время попадает вывод в консоль - это некорректно, т.к. вывод в консоль очень дорогая операция по времени
так же если вы хотите говорит про производительность запросов, то используйте explain(executionStats) (https://www.mongodb.com/docs/manual/reference/method/cursor.explain/) - это даст вам всю необходимую информацию для понимания скорости выполнения запроса, а не непонятно что намеренное у вас в коде
не дорогая операция - занимает 1 десятую долю минуты в данном случае
Mike
(максимум - иногда меньше)
Nick
не дорогая операция - занимает 1 десятую долю минуты в данном случае
это неважно что сколько занимает, методика измерения некорректна и говорить р результатах измерения в таких случаях бессмысленно и уж тем более принимать какието решения
Mike
это неважно что сколько занимает, методика измерения некорректна и говорить р результатах измерения в таких случаях бессмысленно и уж тем более принимать какието решения
на стаке оверфлов есть консоль или где она есть?
Mike
(в коде)
Mike
в моем примере вне стака она не отнимает почти ничего по времени
Mike
(в вашем кейсе имею ввиду)
Mike
поэтому с моей стороны и смысл есть и корректность - по скольку у меня есть понимание сколько эта консоль забирает
Mike
по коду видно что в расчет время попадает вывод в консоль - это некорректно, т.к. вывод в консоль очень дорогая операция по времени
так же если вы хотите говорит про производительность запросов, то используйте explain(executionStats) (https://www.mongodb.com/docs/manual/reference/method/cursor.explain/) - это даст вам всю необходимую информацию для понимания скорости выполнения запроса, а не непонятно что намеренное у вас в коде
так а что мне этот инструмент даст измерительный - если нельзя на факторы измерения повлиять никак будет
Mike
ну посмотрел и что дальше?
Mike
)
Nick
ну посмотрел и что дальше?
вот время которое там получаете и будет то что вы меряете, остальной код вам вообще не нужен был
Mike
вот время которое там получаете и будет то что вы меряете, остальной код вам вообще не нужен был
http://joxi.ru/VrwyX78colRVZ2
Mike
пока что если применять к find - происходит ошибка
Nick
пока что если применять к find - происходит ошибка
вы применили к toArray() а не к фаинду, повнимательнее
Viktar
пока что если применять к find - происходит ошибка
Експлейн показывает план запроса. Попробуйте без ту эррай
Mike
вы применили к toArray() а не к фаинду, повнимательнее
я придельно внимателен - мне не нужно к файнду
Mike
это совсем другая и мене затратная операция
Mike
которая ничего невыводит кроме обьекта
Mike
смысл ее мерять?
Nick
я придельно внимателен - мне не нужно к файнду
это неважно, так работает драйвер к монге - надо к файнду цеплять и убирать ту аррай
Mike
без аррай эта операция выполняется в 10 раз быстрее
Mike
зачем мне такое измерение
Mike
+
Mike
оно не работает и без него
Mike
http://joxi.ru/Q2KglPYhOVo902
Nick
без аррай эта операция выполняется в 10 раз быстрее
неважно сколько она выполняется, важно посмотреть в эксплейне сколько времени исполняется сам запрос. Дальше все упирается в ваши навыки программирования
Mike
никакой реакции
Nick
так содержимое эксплейна то смотрите
Viktar
смысл ее мерять?
Экспоейн не надо замерять. Экспоейн покажет как обрабатывает монга ваш запрос. Т.е будет видно слабые стороны запроса
Mike
подозреваю дело в следующем:
mongosh Method
This page documents a mongosh method. This is not the documentation for a language-specific driver, such as Node.js.
Nick
Экспоейн не надо замерять. Экспоейн покажет как обрабатывает монга ваш запрос. Т.е будет видно слабые стороны запроса
с executionStats покажет именно выполнение, так что это аналог запроса по факту по времени выполнения
Mike
с executionStats покажет именно выполнение, так что это аналог запроса по факту по времени выполнения
с ним пробовал тоже не работает
Mike
выведите в консоль testResult
{
explainVersion: '1',
queryPlanner: {
namespace: 'EURSGD.EURSGD-m1',
indexFilterSet: false,
parsedQuery: { _id: [Object] },
queryHash: '182073E3',
planCacheKey: '30F89A18',
maxIndexedOrSolutionsReached: false,
maxIndexedAndSolutionsReached: false,
maxScansToExplodeReached: false,
winningPlan: { stage: 'FETCH', inputStage: [Object] },
rejectedPlans: []
},
executionStats: {
executionSuccess: true,
nReturned: 5725857,
executionTimeMillis: 8990,
totalKeysExamined: 5725857,
totalDocsExamined: 5725857,
executionStages: {
stage: 'FETCH',
nReturned: 5725857,
executionTimeMillisEstimate: 796,
works: 5725858,
advanced: 5725857,
needTime: 0,
needYield: 0,
saveState: 5725,
restoreState: 5725,
isEOF: 1,
docsExamined: 5725857,
alreadyHasObj: 0,
inputStage: [Object]
}
},
command: { find: 'EURSGD-m1', filter: { _id: [Object] }, '$db': 'EURSGD' },
serverInfo: {
host: 'DESKTOP-O1H079M',
port: 27017,
version: '6.0.1',
gitVersion: '32f0f9c88dc44a2c8073a5bd47cf779d4bfdee6b'
},
serverParameters: {
internalQueryFacetBufferSizeBytes: 104857600,
internalQueryFacetMaxOutputDocSizeBytes: 104857600,
internalLookupStageIntermediateDocumentMaxSizeBytes: 104857600,
internalDocumentSourceGroupMaxMemoryBytes: 104857600,
internalQueryMaxBlockingSortMemoryUsageBytes: 104857600,
internalQueryProhibitBlockingMergeOnMongoS: 0,
internalQueryMaxAddToSetBytes: 104857600,
internalDocumentSourceSetWindowFieldsMaxMemoryBytes: 104857600
},
ok: 1
}
Mike
executionTimeMillisEstimate: 796,
Mike
я так понимаю это 0.8 минуты
Mike
тоже что и было ранее
Viktar
Первое что бросается в глаза, что нет индекса. И большое количество документов на выходе
Mike
nReturned: 5725857 - вы упираетесь в количество доков, вы действительно нужно 5.7млн доков из базы вытаскивать?
конечно - это даже разминка мне понадобиться куда большее количество в будущем
Viktar
Хотя индекс есть
Nick
конечно - это даже разминка мне понадобиться куда большее количество в будущем
ну чтож, тут вам никакая БД не поможет тогда с такими выборками
Viktar
конечно - это даже разминка мне понадобиться куда большее количество в будущем
А что вы делаете? Может вам надо использовать агрегации?
Mike
ну чтож, тут вам никакая БД не поможет тогда с такими выборками
я вам об этом и говорил что эта стата ниче не даст )
Mike
ну чтож, тут вам никакая БД не поможет тогда с такими выборками
ну почему возможно нужно что то типа клик хауса
Viktar
))) клик Хаус тоже будет долго обрабатывать такое количество
Mike
А что вы делаете? Может вам надо использовать агрегации?
я анализирую каждый документ на наличии определенных вещей
Nick
я вам об этом и говорил что эта стата ниче не даст )
эта стата дала то что можно было вообще это не обсуждать, т.е. если бы вы сразу привели пример эксплейна или сказали что тянете из базы 5+кк доков, то тут бы все и закончилось без трату времени. И да на таких объемах toArray и уж тем более вывод в консоль уже будут занимать далеко не нулевое время
Mike
))) клик Хаус тоже будет долго обрабатывать такое количество
вы случайно не знаете - дольше он будет это делать или нет?
Viktar
я анализирую каждый документ на наличии определенных вещей
Попробуйте анализировать агрегациями.
Nick
вы случайно не знаете - дольше он будет это делать или нет?
столько же, у вас проблема с количеством доков
Mike
эта стата дала то что можно было вообще это не обсуждать, т.е. если бы вы сразу привели пример эксплейна или сказали что тянете из базы 5+кк доков, то тут бы все и закончилось без трату времени. И да на таких объемах toArray и уж тем более вывод в консоль уже будут занимать далеко не нулевое время
об этом же сказано в статье на стаке оверфлов которую я скидывал
Viktar
вы случайно не знаете - дольше он будет это делать или нет?
Все будет примерно столько же выполняться. Это время прочитать данные с диска.
Viktar
Вы на любой СУБД уткнетест в игру оутпут
Mike
Вы на любой СУБД уткнетест в игру оутпут
ну это понятно просто вроде как писали что клик хаус в разы быстрее
Mike
(на чтение имею ввиду)
Viktar
ну это понятно просто вроде как писали что клик хаус в разы быстрее
Это физика. Вы не используете фишки СУБД, а просто забираете данные. Что бы у вас ваша аналитика работала быстро дайте СУБД хоть один шанс. Используйте аналитические запросы
Nick
ну это понятно просто вроде как писали что клик хаус в разы быстрее
если вы выполняете аналитические запросы, а не делаете выборку всех записей из БД
Mike
Это физика. Вы не используете фишки СУБД, а просто забираете данные. Что бы у вас ваша аналитика работала быстро дайте СУБД хоть один шанс. Используйте аналитические запросы
а всякие там сжатия данных могут роль играть?