 Артем

 Артем
 Артем
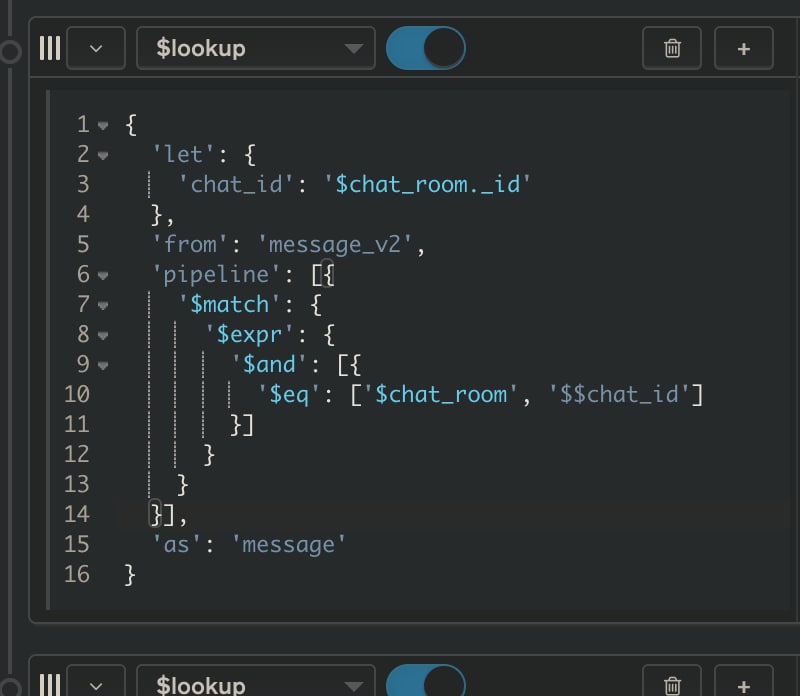
Но наверное более корректно сортировать по нужному атрибуту до вызова $lookup.
Отдельно отмечу что сортировка по _id зависит от того, на чьей стороне и как значение генерируется. Не все драйвера генерируют _id по спецификации и итоговый порядок может отличаться от ожидаемого
мне нужно отсортировать прилукапенные сообщения, вроде наоборот логичнее сначала сматчить и потом сортировать?
 Nick
Артем
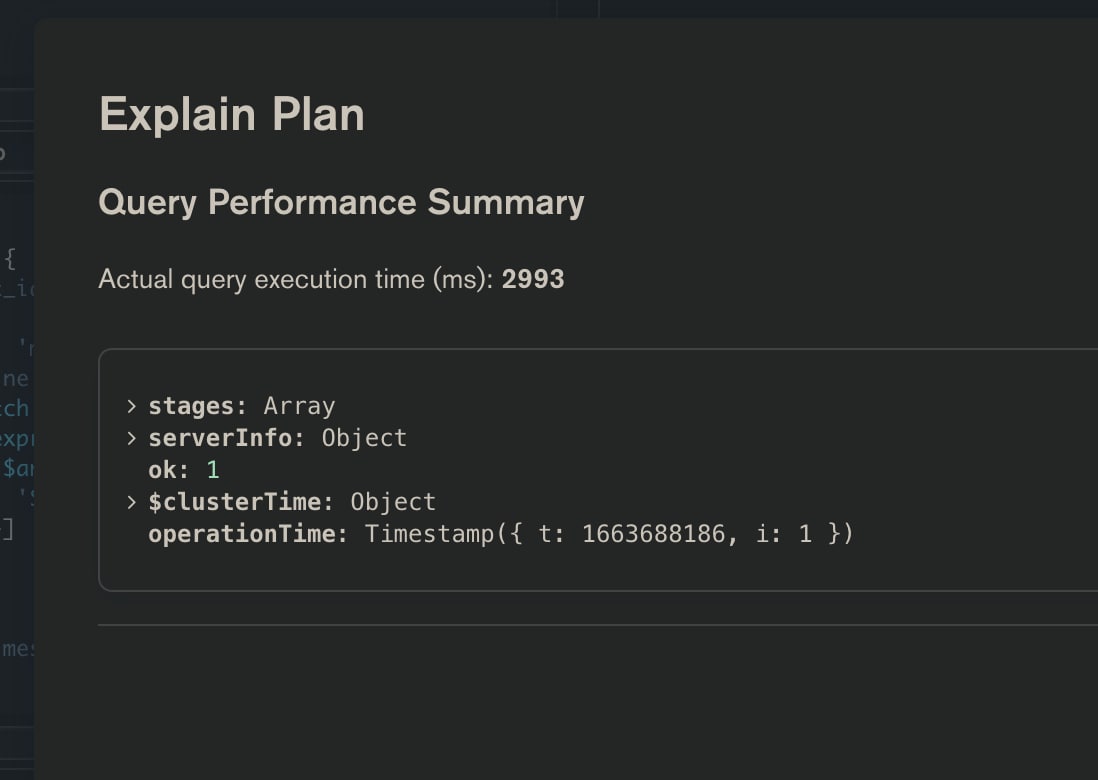
а сколько доков в результате? пока выглядит как то что накладные расходы на сортировку добавляют х2 времени от чтения с диска
в итоге приходит 12 чат комнат, внутри которых от 0 до 6 сообщений
Артем
говорю, копейки
Nick
ощущение что на калькуляторе запускаете или доки по нескольку мегов содержимым, что 3 секунды, что 9 ужасно много.
Артем
это не единственный стейдж
Артем
и база сама в облаке
Nick
в итоге приходит 12 чат комнат, внутри которых от 0 до 6 сообщений
лан, по сути, делайте индекс на два поля chat_room и _id. Но сделайте эксплейн и посмотрите что там происходит
Артем
лан, по сути, делайте индекс на два поля chat_room и _id. Но сделайте эксплейн и посмотрите что там происходит
Составной который? А как это поможет? В теории хотя бы.
Nick
Составной который? А как это поможет? В теории хотя бы.
в теории сортировка будет делаться за счет индекса
 Viktar
db.collection.find({"element.element3":{$ne: null}})
 Григорич
db.collection.find({"element.element3":{$ne: null}})
Похоже, это работает как мне нужно. Спасибо большое!
Григорич
db.collection.find({"element.element3":{$ne: null}})
К сожалению, поиск выполняется очень долго... поддаётся ли это индексированию?
Viktar
К сожалению, поиск выполняется очень долго... поддаётся ли это индексированию?
Да. db.collection.createIndex({"elements.element3":1})
Григорич
Да. db.collection.createIndex({"elements.element3":1})
проблема в том, что таких ключей может быть около миллиона. не буду же я каждый из них индексировать
Viktar
Не совсем понял. Индекс делается на коллекцию.
Viktar
Или вы про то, что у вас есть elements.element[1...n]
Viktar
И вам надо по всем искать?
Григорич
Или вы про то, что у вас есть elements.element[1...n]
Верно. и их может быть сотни тысяч, миллионы... и есть сотни миллионов записей. в каждой записи будет находиться несколько из этих ключей.
Вернёмся к структуре.
У меня сотни миллионов таких записей:
{
"_id": 1234,
"elements": {
"element1":
{
"create": "2020.12.12",
"update": "2020.12.12",
},
"element2":
{
"create": "2020.12.12",
"update": "2020.12.12",
},
"element3":
{
"create": "2020.12.12",
"update": "2020.12.12",
}
}
}
В каждой записи в elements у меня будет element[1...n]. Мне необходимо быстро искать, в каких именно записях будет один из elements[1...n]
Viktar
Тогда бы я вам посоветовал бы использовать массив объектов
{ num:1, create:xxx, update:xxx}
Viktar
Тогда вы сможете сделать один индекс и искать нужный вам элемент по номеру
Григорич
Тогда бы я вам посоветовал бы использовать массив объектов
{ num:1, create:xxx, update:xxx}
в моём случае это будет выглядеть так?
{
"_id": 1234,
"elements":
[
{"num": "element1", "create": "2020.12.12", "update": "2020.12.12"},
{"num": "element2", "create": "2020.12.12", "update": "2020.12.12"},
{"num": "element3", "create": "2020.12.12", "update": "2020.12.12"},
]
}
Viktar
Да
Григорич
Да
затем делаю индекс таким образом, верно?
db.collection.createIndex({"elements":1})
Viktar
Не совсем. "elements.num"
Григорич
Не совсем. "elements.num"
спасибо вам, Виктор. Дайте вам хоть пару сотен рублей закину на карту
 Mike
Такой вопрос:
А чтение из базы батчем вообще существует в природе как способ?
И ще вопрос:
Можно ли каким то образом увеличить скорость чтения данных из базы?
(например путем смены алгоритма сжатия данных или может смены драйвера и т.п. )
 Alena
Записываю документ в БД (с await-ом) и потом сразу пытаюсь его считать, в определенных процентах случаев, в засисимости от нагрузки мне возвращает null6 есть ли какой способ заставить mongoose делать ретраи в течении определенного времени пока не получит значение или таймаут выйдет?
 Vladyslav
Записываю документ в БД (с await-ом) и потом сразу пытаюсь его считать, в определенных процентах случаев, в засисимости от нагрузки мне возвращает null6 есть ли какой способ заставить mongoose делать ретраи в течении определенного времени пока не получит значение или таймаут выйдет?
Читаете чтобы быть увереным, что объект записался?
Nick
Такой вопрос:
А чтение из базы батчем вообще существует в природе как способ?
И ще вопрос:
Можно ли каким то образом увеличить скорость чтения данных из базы?
(например путем смены алгоритма сжатия данных или может смены драйвера и т.п. )
чтение из базы всегда батчем, вы можете только ограничить параметрами запроса и через лимит
Alena
Читаете чтобы быть увереным, что объект записался?
нет, в момент первого старта, в приложении создается тестовый пользователь, потом мы логинимся(в тесте) от имени этого пользователя, зачастую время между созданием юзера и логином очень маленькое
Alena
чтение из базы всегда батчем, вы можете только ограничить параметрами запроса и через лимит
может есть какой паттерн для моего случая, в смысле ожидания пользователя в БД?
Vladyslav
Nick
может есть какой паттерн для моего случая, в смысле ожидания пользователя в БД?
do{
user = getUser()
}
while(user == null)
или аналоги
Vladyslav
самый просто вариант решения:
перед запуском бека, запустить скрипт создания юзера
Vladyslav
если это тестово, то можно и не держать на беке данные
Anton
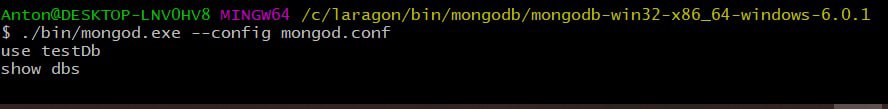
В конфиге указан путь dbPath: C:\laragon\data\mongodb, но при запуске ошибка: {"error":"NonExistentPath: Data directory C:\\data\\db\\ not found где же все таки указать путь?
Viktar
В конфиге. Может не ваш конфиг морга использует?
Anton
./bin/mongod.exe --config mongod.conf
не может открыть лог
Anton
 Anton
хрен с тем терминалом, в датаГрип подключилось. А существует ли нормальная документация, чтоб сделать авторизацию, с какой БД вообще работать, что за схемы админ, конфиг, локал? Запросы как писаьт или что там?
 Дима
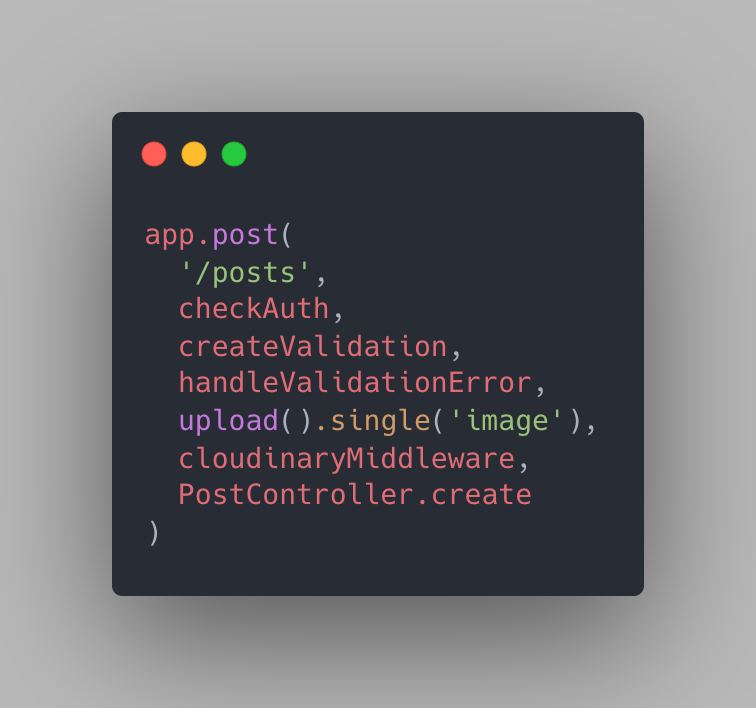
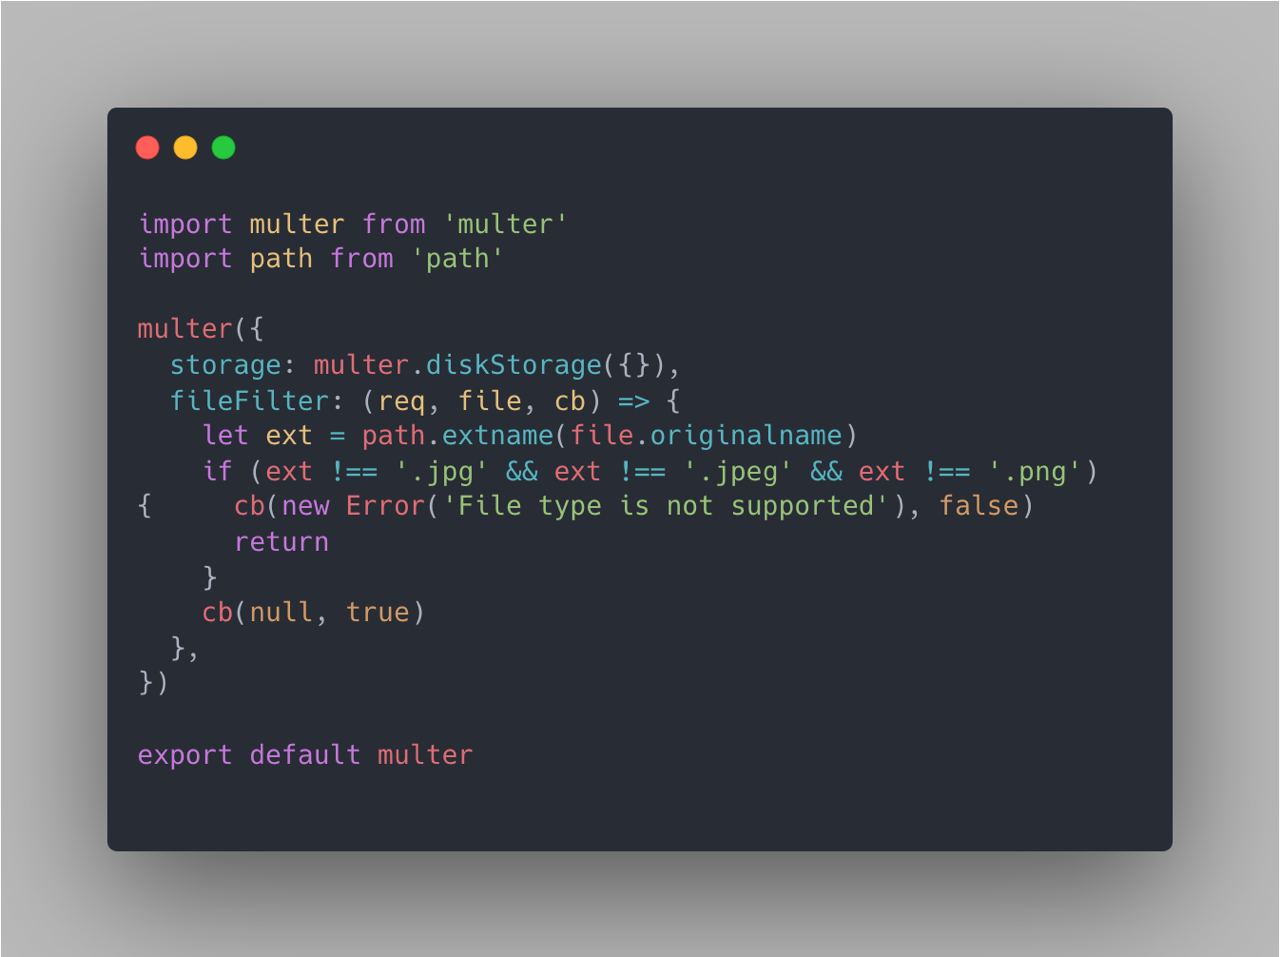
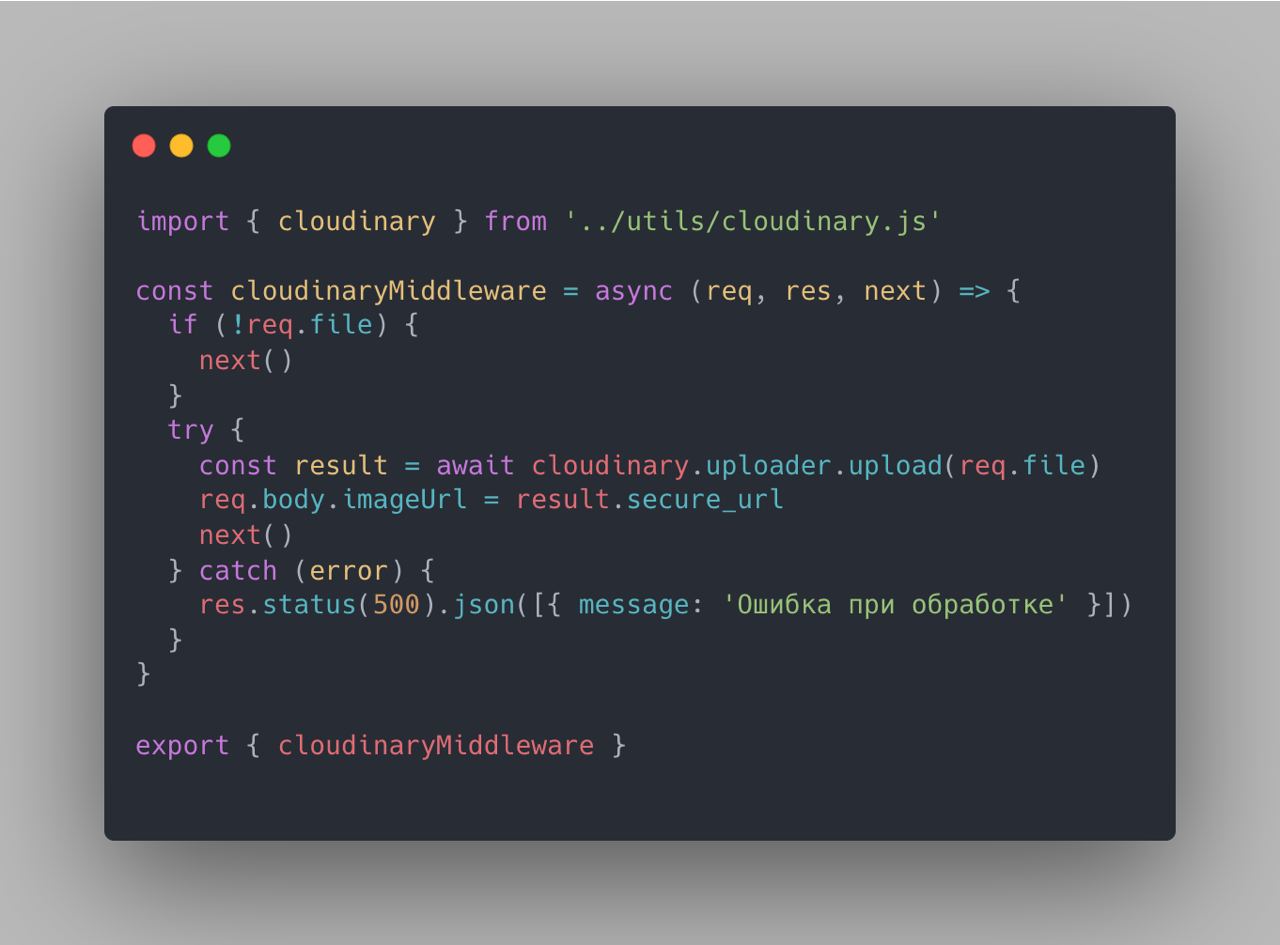
Недавно в бекенде, не могу понять почему не работает middleware, отправляю запросы через постман как form-data, а получаю ошибку, еще на стадии валидации полей, почему-то ругается на все поля, хотя они правильно заполнены.
Дима
 Дима
 Дима
 Viktar
 Mark
Ребята, а возможно коллекцию с одного проекта в монго дб атласс перенестив в другой проект того же атласа?
Mike
чтение из базы всегда батчем, вы можете только ограничить параметрами запроса и через лимит
эти параметры могут серьезно повлиять на производительность?
Nick
эти параметры могут серьезно повлиять на производительность?
они определяют "производительность" что бы вы под этим не подразумевали))
Mike
они определяют "производительность" что бы вы под этим не подразумевали))
я подразумевал допустим в 2 и больше раза
Nick
я подразумевал допустим в 2 и больше раза
уменьшите выборку в два и больше раза и получите в два и больше раза скорости
Mike
уменьшите выборку в два и больше раза и получите в два и больше раза скорости
А как этот параметр синтаксически выглядит?
Nick
А как этот параметр синтаксически выглядит?
параметры выборки - все то что указывается в query параметре в файнде/апдейте/делете и матч секциях в агрегациях
аналогично лимиты для файнда доп параметр, в агрегации стейдж limit
Mike
параметры выборки - все то что указывается в query параметре в файнде/апдейте/делете и матч секциях в агрегациях
аналогично лимиты для файнда доп параметр, в агрегации стейдж limit
А для записи батчем подобный лимит тоже существует как параметр?
Nick
А для записи батчем подобный лимит тоже существует как параметр?
тут надо осторожно, т.к. термина батч из SQL мира в монге не существует. Чтото похожее есть только для вставок (insertMany). а bulk в монге просто набор одиночных запросов и они в базе исполняются отдельно и эффекта батча как в SQL с помощью bulk не достигнуть
Mike
уменьшите выборку в два и больше раза и получите в два и больше раза скорости
мы видимо не правильно поняли друг друга.
потому что задавая лимит через стэйдж - время никак не экономиться в итоге
(сейчас проверил у себя) - разбивание на куски ничег не дает
Mike
(имею ввиду если потом в сумме эти куски собрать)
Mike
мой вопрос же был в том как время загрузки с экономить
Dmitry
Такой вопрос:
А чтение из базы батчем вообще существует в природе как способ?
И ще вопрос:
Можно ли каким то образом увеличить скорость чтения данных из базы?
(например путем смены алгоритма сжатия данных или может смены драйвера и т.п. )
Индексация помогает ускорить т.к. часть данных пропускается
Mike
Индексация помогает ускорить т.к. часть данных пропускается
индексация в моем случае уже присутствует
Dmitry
индексация в моем случае уже присутствует
Она не просто должна быть, а ещё правильная т.к. большое количество индексов только замедляют работу
Mike
Она не просто должна быть, а ещё правильная т.к. большое количество индексов только замедляют работу
https://ru.stackoverflow.com/questions/1449529/%d0%92%d0%be%d0%b7%d0%bc%d0%be%d0%b6%d0%bd%d0%be-%d0%bb%d0%b8-%d1%83%d1%81%d0%ba%d0%be%d1%80%d0%b8%d1%82%d1%8c-%d0%bf%d0%be%d0%bb%d1%83%d1%87%d0%b5%d0%bd%d0%b8%d0%b5-%d0%b4%d0%b0%d0%bd%d0%bd%d1%8b%d1%85-%d0%b8%d0%b7-%d0%b1%d0%b0%d0%b7%d1%8b-%d0%b2-10-%d0%b8-%d0%b1%d0%be%d0%bb%d0%b5%d0%b5-%d1%80%d0%b0%d0%b7
Mike
но вопрос допустим можно переименовать - в то - как вообще ускорить хоть как то )
Mike
(для начала)
Dmitry
но вопрос допустим можно переименовать - в то - как вообще ускорить хоть как то )
gt это же больше? В таком случае, у тебя, есть отрицательные id? Если нет, то не вижу смысла писать and и условие gt т.к. это не нужная доп проверка
Mike
gt это же больше? В таком случае, у тебя, есть отрицательные id? Если нет, то не вижу смысла писать and и условие gt т.к. это не нужная доп проверка
у меня нет отрицательного есть нулевой
Dmitry
У вас излишняя проверка и условия для выборки
Mike
как сделать по другому что бы протестить на скорость?
Dmitry
И зачем вы используете аггрегацию?
Dmitry
Она нужна, когда данные дальше модифицироваться на стороне БД будут
Mike
хорошо допустим.
какую пропиcать команду с вашей точки зрения - что бы работало быстрее?
Dmitry
1. Время так не засекается т.к. у вас посторонние операции присутствуют.
2. Если вы не планируете дальше данные на стороне БД обрабатывать, то измените на find.
3. Если у вас X данных, а вам надо до 5725858, то напишите {_id: {$lt:5725858}} иначе ничего или пустой объект (мне не известно, что вы хотите добиться и получать всё записи не всегда хорошо).