 Nikita


 Константин
environment:
- MONGO_INITDB_ROOT_USERNAME=rootuser
- MONGO_INITDB_ROOT_PASSWORD=rootpass
Константин
Nikita
environment:
- MONGO_INITDB_ROOT_USERNAME=rootuser
- MONGO_INITDB_ROOT_PASSWORD=rootpass
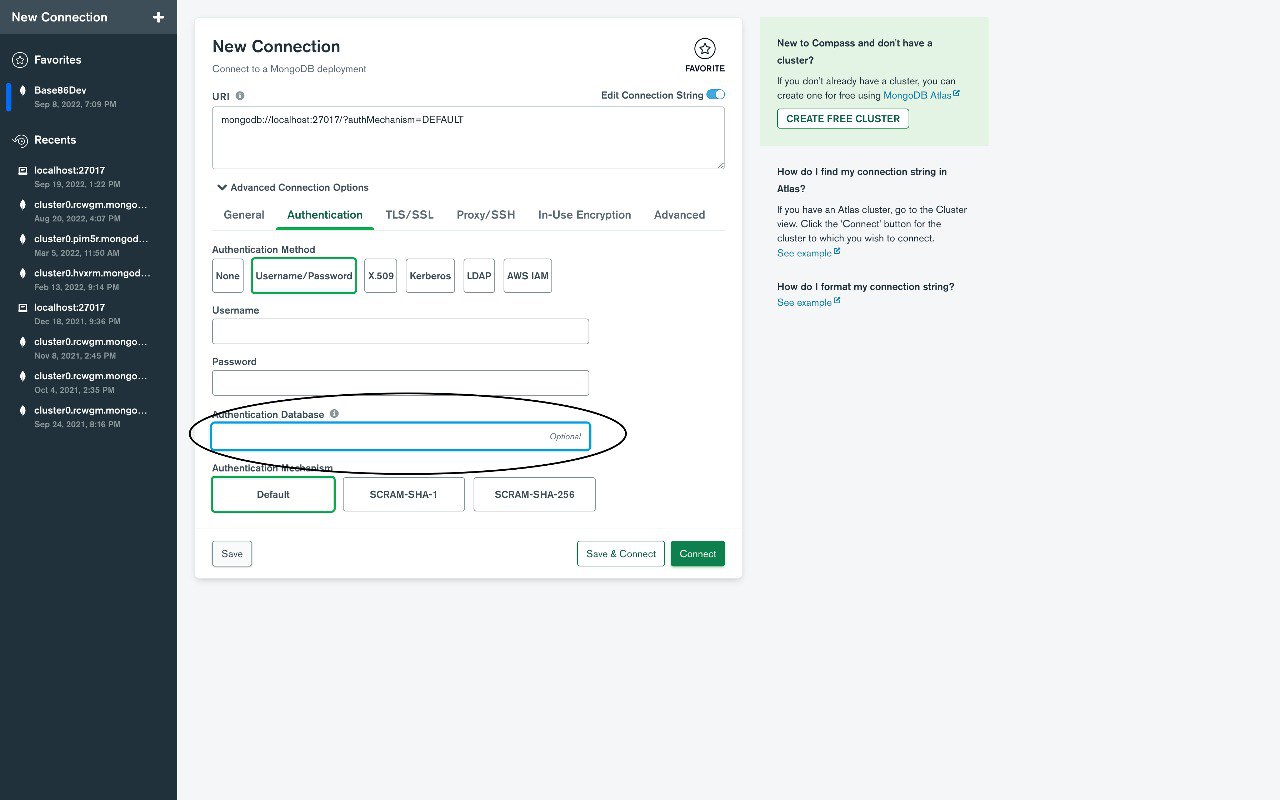
Эти две env variables я уже использую. Какие есть ещё? Я не нашёл полный список… мне нужна та которая отвечает за authSource?
Константин
MONGO_INITDB_ROOT_DATABASE=admin
Есть такая ссылка с неким описанием параметров https://github.com/docker-library/mongo/issues/329
Более ничего интересно пока не нашел
 Anton
Добрейшего времени суток!
Подскажите, плиз, если сможете.
Есть коллекция с полем order, у которого, конечно же, есть индекс уникальности.
И есть потребность менять этот порядок сразу у нескольких записей, сохраняя при этом неповторяемость величины order.
Пробовал через операцию bulk_write - но получаю по шапке ошибкой "duplicate key error collection" - Индекс бдит!
Очень не хочется городить огород с удалением-вставкой и прочей синтетикой, неужели нельзя как-то сразу поменять несколько записей не провоцируя проверку индекса?
Anton
А зачем это поле нужно? какой бизнес смысл
Например, приоритет в очереди. Очередность хостов внешних сервисов, etc.
 Nick
Например, приоритет в очереди. Очередность хостов внешних сервисов, etc.
тогда зачем менять? выбыл первый и ничего менять не нужно, порядок остальных остался
Anton
тогда зачем менять? выбыл первый и ничего менять не нужно, порядок остальных остался
Нет, не выбыл.
Это не очередь, а очерёдность. Никто ниоткуда не выбывает.
Просто какой-то документ надо "поднять повыше", смещая, разумеется, всех кто после него.
Nick
Nick
и сдвиги на каких диапазонах происходят и как часто
Anton
Документов немного, да.
Вряд ли более 10-15.
Можно всё на уровне приложения сделать.
Anton
Но если есть нативный индекс уникальности, если можно всё и сразу (или нельзя) - то why not?
Nick
Но если есть нативный индекс уникальности, если можно всё и сразу (или нельзя) - то why not?
у вас задача же не сделать уникальным какоето поле, а указать порядок документов - тут вам уникальный индекс не помощник.
Anton
у вас задача же не сделать уникальным какоето поле, а указать порядок документов - тут вам уникальный индекс не помощник.
Хорошо, а какими средствами в MongoDB я смогу этого достичь?
Anton
И как мне осуществлять смену порядка документов?
Nick
если документов немного, то заводите документ с массивом в котором держите идентификаторы документов, позиция в массиве - это ваш порядок
Nick
и атомарно его обновляйте при изменеии порядка
Anton
если документов немного, то заводите документ с массивом в котором держите идентификаторы документов, позиция в массиве - это ваш порядок
типа как один "метадокумент"?
Nick
да
Viktar
Тогда индекс уникальный не надо. А человеку это важно
Nick
Тогда индекс уникальный не надо. А человеку это важно
человеку важно организовать порядок, а не уникальность. Не путайте хотение применить чтото с реальными потребностями и докапывайтесь до того что реально требуется от функционала
Viktar
Я не вижу проблем организовать все это на текущей коллекции. Просто отключив индекс уникальности
Anton
А как проверять уникальность, как валидировать запросы с фронта?
Anton
да, я знаю как можно проверить уникальность самостоятельно, но мне кажется что это "колхоз", а тут всё же есть индекс.
Viktar
А как вы определяете порядок?
Viktar
Я не про это, а как вы решаете у какого документа 1, а у какого 5?
Anton
Я не про это, а как вы решаете у какого документа 1, а у какого 5?
Это же порядок, это приоритет, это может быть как скрытое от редактирования поле, так и явное.
Anton
Как это разрулить на уровне приложения я знаю.
Мне бы хотелось знать, могу ли я всё это сделать средствами MongoDB.
Viktar
Я если честно не совсем понимаю, что вы хотите средствами монги сделать. Проверить уникальность? Индекс проверяет. И не даёт появлению дубликатов.
Viktar
Как сделать дубликат на поле с индексом уникальности? Ответ никак. Как проапдейтить такое поле - записать значение которого нет
Anton
Я если честно не совсем понимаю, что вы хотите средствами монги сделать. Проверить уникальность? Индекс проверяет. И не даёт появлению дубликатов.
Я хочу одним действием поменять несколько записей с полями, по которым есть индекс уникальности.
Viktar
1. Записываете значения которых нет
2. Записываете нужные значения
Anton
например, есть такой набор:
{"name": "Аркадий", "order": 1 }
{"name": "Борис", "order": 2}
{"name": "Вячеслав", "order": 3}
Anton
А я такой одним апдейтом делаю так:
{"name": "Аркадий", "order": 1 }
{"name": "Борис", "order": 3}
{"name": "Вячеслав", "order": 2}
Viktar
Мое мнение вам там не нужен индекс уникальности
Anton
Да, видимо придётся городить колхоз на стороне сервера приложений.
Anton
раз уж в монге нет таких механизмов
Viktar
Индекс уникальности служит для того, что бы не было дубликатов. А вы как я понимаю хотите делать дубликаты.
Anton
Индекс уникальности служит для того, что бы не было дубликатов. А вы как я понимаю хотите делать дубликаты.
нет, не хочу дубликаты, порядок должен быть уникальным
Viktar
Ваш подход подразумевает в таком случае использовать в таком случае промежуточное значение
 Andrey
Делаю aggregate.$lookup как мне сделать выборку по as, что она пустая ?
Nick
Делаю aggregate.$lookup как мне сделать выборку по as, что она пустая ?
что вы имеет в виду под as?
Andrey
Уже сделал )
Andrey
вопрос на общее понимание, если есть 2 индекса:
index 1. Compound из 2 полей: a и b
index 2. и индекс по 3 полю: с
агрегация
match при поиске по a и b
match по полю c
Используется только индекс 1?
Вопрос в том, что искать по полю c на долгое время - не было нужды, тут вдруг захотели искать по 3 полям. Чтоб не перестраивать индекс 1 (да и по нему чаще будет поиск чем по 3 полям), добавили по полю c. В надежде что монга, найдет документы по a и b и в них с использованием индекса по c - быстро вернет. Но судя по explain - индекс по c - не используется
Nick
вопрос на общее понимание, если есть 2 индекса:
index 1. Compound из 2 полей: a и b
index 2. и индекс по 3 полю: с
агрегация
match при поиске по a и b
match по полю c
Используется только индекс 1?
Вопрос в том, что искать по полю c на долгое время - не было нужды, тут вдруг захотели искать по 3 полям. Чтоб не перестраивать индекс 1 (да и по нему чаще будет поиск чем по 3 полям), добавили по полю c. В надежде что монга, найдет документы по a и b и в них с использованием индекса по c - быстро вернет. Но судя по explain - индекс по c - не используется
скорее всего планировщик не видит смысла в использовании индекса 2, т.к. его селективность ниже уже использованного индекса 1, а делать кроссмерж выборку по двум индексам еще дороже по операциям и затратам на диски.
Ufo
Привет! Прошу извинить Сообщество за вопрос от неофита, но... как можно создать пользователя? Делаю db.createUser(
{
user: “User”,
pwd: “PassworD”,
roles: [ { role: “readWrite”, db: “User” }
}
) Но он не создаётся (судя по show users), хотя ошибки нет... пытаюсь понять где не прав я...
Ufo
Ждал, что ошибка будет при парсинге... Спасибо! Низкий поклон Вам!! (с)
Andrey
скорее всего планировщик не видит смысла в использовании индекса 2, т.к. его селективность ниже уже использованного индекса 1, а делать кроссмерж выборку по двум индексам еще дороже по операциям и затратам на диски.
А как себя будет вести планировщик, при наличии индекса по 3 полям и по 2 полям. То есть индекс 1 оставляем, и строим идекс по полям a b c. Если нужно будет искать по тройке значений. Будет ли в одних случаях использваоться индекс 1 а в других индекс 2
Nick
А как себя будет вести планировщик, при наличии индекса по 3 полям и по 2 полям. То есть индекс 1 оставляем, и строим идекс по полям a b c. Если нужно будет искать по тройке значений. Будет ли в одних случаях использваоться индекс 1 а в других индекс 2
выберет индекс с большей селективностью, т.е. тот в котором ест ьвсе три поля если указаны все три в запросе
Nick
и если указаны два, то тот что горячее (в кеше) и опять же селективнее, а то вы можете же сделать индексы a-b и b-a-c и какой из них будет выбран зависит от того что быстрее сузит область поиска
Andrey
и если указаны два, то тот что горячее (в кеше) и опять же селективнее, а то вы можете же сделать индексы a-b и b-a-c и какой из них будет выбран зависит от того что быстрее сузит область поиска
Я соблюдаю и там и там один порядок в индексе a - b - c. И ищу через агрегаци, только а,b; a,b,c
Nick
Я соблюдаю и там и там один порядок в индексе a - b - c. И ищу через агрегаци, только а,b; a,b,c
Тогда вам за глаза одного индекса тройного
Andrey
Тогда вам за глаза одного индекса тройного
Дожидаюсь когда достроиться, чтоб сравнить скорость.
Viktar
Тогда вам за глаза одного индекса тройного
У меня почему то при запросе по полям которые есть в индексе используется индекс с меньшим количеством полей. Я так и не разобрался почему.
Andrey
У меня не во всех документах есть поле c, может это как повлиять, если оставить только один индекс по 3 полям
Nick
У меня почему то при запросе по полям которые есть в индексе используется индекс с меньшим количеством полей. Я так и не разобрался почему.
если есть выбор то будет использован тот который дешевле по размеру, чтобы минимизировать работу с диском
Andrey
Не помню, можно ли принудительно указать какой индекс использовать
Viktar
Не тот кейс указал. Этот Я не понял, что за он
Viktar
Ну не понятно что за запрос
Nick
Добрый день, есть запрос
db.personCatalog.find({simpleFirstName:"daniel", simpleLastName:"garvey", isDisabled:null, nationwideOrder:{$gt:0, $lte:20}}).limit(20)
но он почему то игнорирует индекс
{
"v" : 2,
"key" : {
"simpleFirstName" : 1,
"simpleLastName" : 1,
"nationwideOrder" : 1,
"isDisabled" : 1
},
"name" : "simpleFirstName_1_simpleLastName_1_nationwideOrder_1_isDisabled_1",
"background" : true
}
использует индекс
{
"v" : 2,
"key" : {
"simpleFirstName" : 1,
"simpleLastName" : 1,
"state" : 1,
"stateOrder" : 1
},
"name" : "simpleFirstName_1_simpleLastName_1_state_1_stateOrder_1",
"background" : true
},
поля по которым делается выборка диапазоном должны идти в конце чтобы опять же селективность дала пользу а не доп выборки по IO. В вашем случае надо сделать индекс
"simpleFirstName" : 1,
"simpleLastName" : 1,
"isDisabled" : 1
"nationwideOrder" : 1,
Viktar
поля по которым делается выборка диапазоном должны идти в конце чтобы опять же селективность дала пользу а не доп выборки по IO. В вашем случае надо сделать индекс
"simpleFirstName" : 1,
"simpleLastName" : 1,
"isDisabled" : 1
"nationwideOrder" : 1,
Я тут запрос не совсем верно привел. Поля в запросе в той же последовательности, что и в индексе
Nick
Я тут запрос не совсем верно привел. Поля в запросе в той же последовательности, что и в индексе
последовательность полей в запросе никакого значения не имеет
Viktar
последовательность полей в запросе никакого значения не имеет
Тогда не совсем понял про селективность. IsDisabled самая низкая. Есть только у 1% записей
Nick
Тогда не совсем понял про селективность. IsDisabled самая низкая. Есть только у 1% записей
поэтому стоит перед полем по которому идет запрос диапазоном
Viktar
поэтому стоит перед полем по которому идет запрос диапазоном
Попробую сделать такой индекс. Спасибо.
Viktar
А по странному слоу квери может есть какие нибудь мысли?
 Артем
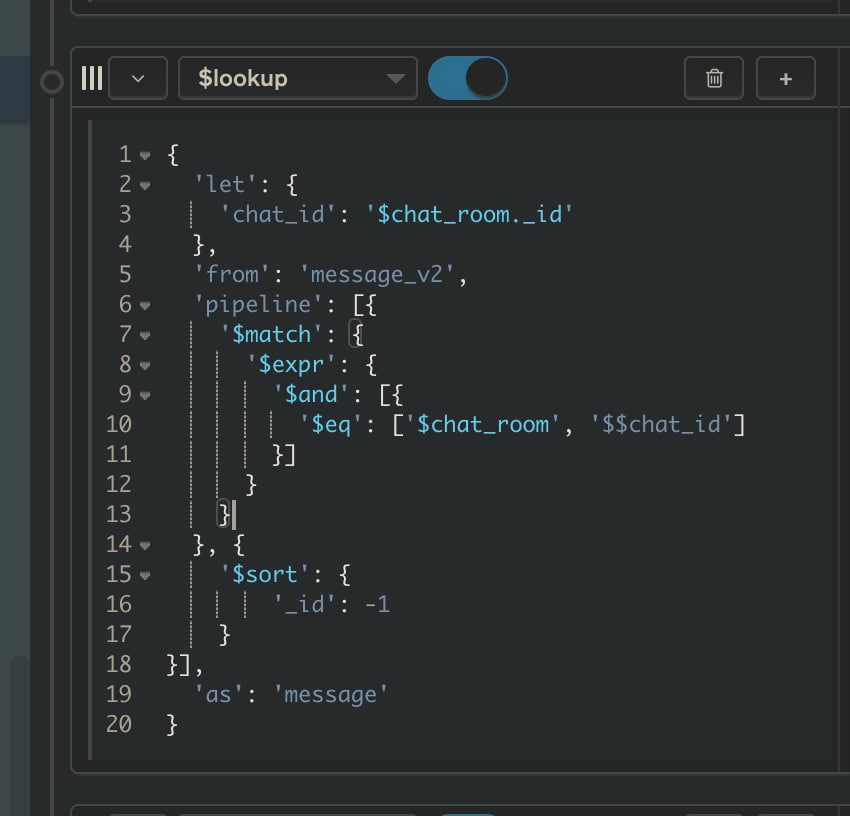
{
'from': 'message_v2',
'as': 'message',
'let': {
'chat_room_id': '$chat_room._id'
},
'pipeline': [{
'$match': {
'$expr': {
'$eq': ['$$chat_room_id', '$chat_room']
}
}
}, {
'$sort': {
'_id': 1
}
}]
}
гайз, как работает сорт в данном случае? я правильно понял что он отсортирует мне НАЙДЕННЫЕ (прилукапенные) значения? если да, то почему этот запрос выполняется в разы дольше чем этот?
{
'from': 'message_v2',
'as': 'message',
'let': {
'chat_room_id': '$chat_room._id'
},
'pipeline': [{
'$match': {
'$expr': {
'$eq': ['$$chat_room_id', '$chat_room']
}
}
}]
}
Индекс на chat_room стоит
 yopp
{
'from': 'message_v2',
'as': 'message',
'let': {
'chat_room_id': '$chat_room._id'
},
'pipeline': [{
'$match': {
'$expr': {
'$eq': ['$$chat_room_id', '$chat_room']
}
}
}, {
'$sort': {
'_id': 1
}
}]
}
гайз, как работает сорт в данном случае? я правильно понял что он отсортирует мне НАЙДЕННЫЕ (прилукапенные) значения? если да, то почему этот запрос выполняется в разы дольше чем этот?
{
'from': 'message_v2',
'as': 'message',
'let': {
'chat_room_id': '$chat_room._id'
},
'pipeline': [{
'$match': {
'$expr': {
'$eq': ['$$chat_room_id', '$chat_room']
}
}
}]
}
Индекс на chat_room стоит
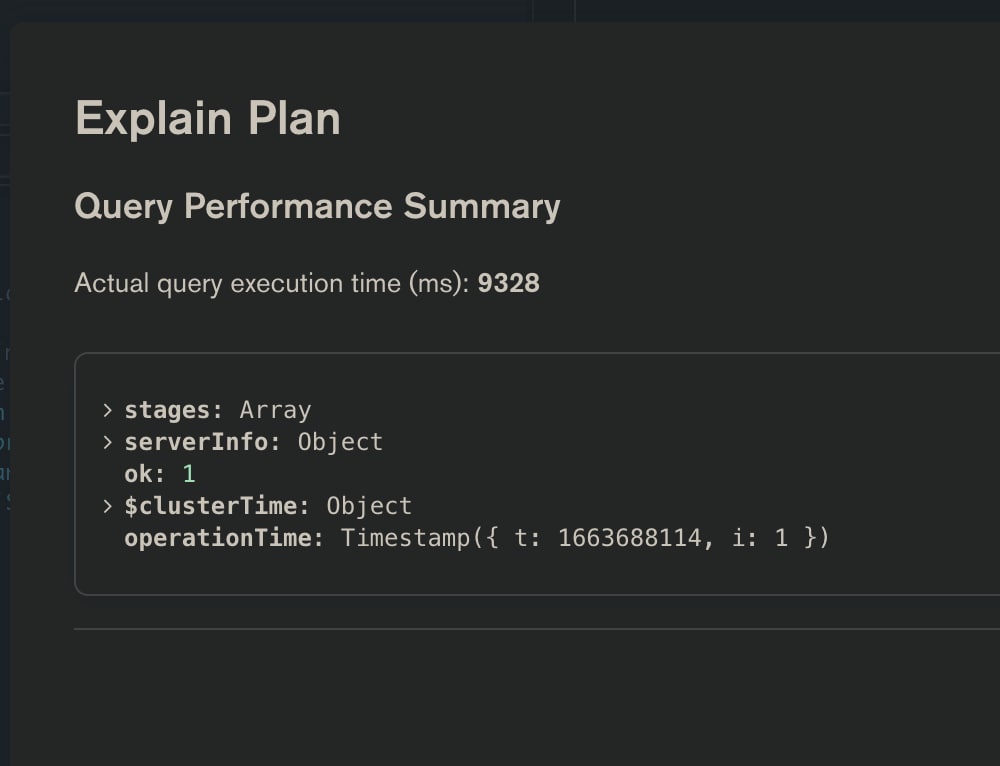
Посмотрите какой план запроса и его выполнение добавив explain({executionStats:1}) перед .aggregate. Возможно что планировщик выбирает какой-то неудачный план
yopp
Но наверное более корректно сортировать по нужному атрибуту до вызова $lookup.
Отдельно отмечу что сортировка по _id зависит от того, на чьей стороне и как значение генерируется. Не все драйвера генерируют _id по спецификации и итоговый порядок может отличаться от ожидаемого