 Mike


ясно
 Viktar
Вы сейчас работаете с СУБД как с текстовым файлом
Viktar
Поэтому все время тратится что бы прочитать все данные
Viktar
Использование более быстрых дисков ускорит вашу операцию. Но это путь в никуда
Mike
Поэтому все время тратится что бы прочитать все данные
получается от скорости винчестера зависит на прямую время или я ошибаюсь?
Mike
угу - понял
Viktar
Посмотрите в сторону aggregate вместо файнд. И переносите часть логики в него по анализу
Mike
Посмотрите в сторону aggregate вместо файнд. И переносите часть логики в него по анализу
как вариант в качестве языка подумываю взять раст и делать логику на нем - не знаю будет ли это быстрее - но вроде как должно
Mike
а в качестве базы наверное монгу оставлю
Viktar
))) будет тоже самое.
Mike
))
Mike
но просто раст еще нужен за тем что база не даст такие логические возможности как язык
Mike
тоесть ее все равно не хватит рано или поздно
Mike
скорее рано
Viktar
Вы пытаетесь загрузить тонну кирпичей и от того, что вы грузите их в КамАЗ или Мерседес скорость загрузки не поменяется
Mike
это я понимаю
Mike
я уже речь вел о других ситуациях
Mike
когда документы дергаться будут мелкими партиями и там дальше будет много анализа
Mike
но цепочка дерганий при этом будет бесконечно длинной
Viktar
Вы размажете просто время по мелким партиям. Используйте возможности СУБД для анализа. Их для этого и придумали
AcidMan
камрады! а расскажите, как так может быть. show dbs показывает объём 52Мб, mongodump делает бэкап 38Мб несжатых, а на диске всё провсё занимает 1.1Гб… чяднт?
AcidMan
и как мне сделать нормальный полный бэкап?
Mike
Вы размажете просто время по мелким партиям. Используйте возможности СУБД для анализа. Их для этого и придумали
на все случаи жизни(моего проекта) алгоритмов анализа субд в любом случае не хватит
 Александр
Посоны, помогите, пожалуйста, чем upsert, insert и update отличаются? Мне нужно валюты по апишке подтягивать и в бд сохранять, старые не затирать и не обновлять, добавлять только новые
 Albert
insert для добавления нового документа
Albert
update для изменения документа
Dmitry
Посоны, помогите, пожалуйста, чем upsert, insert и update отличаются? Мне нужно валюты по апишке подтягивать и в бд сохранять, старые не затирать и не обновлять, добавлять только новые
Upsert используется для создания нового документа, иначе обновить
Александр
если нету документа update не сработает?
Albert
если он не найдет документа который соответствует фильтру то не сработает
Александр
Так, ну я правильно понял, что работает так:
insert - добавляет новый документ, если существует такой, то не сработает
update - обновляет новый документ, если документа еще нет, то не сработает
upsert - имплементирует логику двух выше вместе и работает в любом случае
Александр
?
Dmitry
Почти. Insert не вставит новый документ, если есть индекс на уникальность поля
 fenogentov
чем всетаки отличается реплейс от апдейт?
 Алина
реплейс полностью один документ другим заменяет, плюс в нем можно использовать параметр upsert (найдено - обновлем, не найдено - добавляем)
апдейтом можно поменять часть документа, не затрагивая другие поля, и им никак не добавить новый документ
Viktar
реплейс полностью один документ другим заменяет, плюс в нем можно использовать параметр upsert (найдено - обновлем, не найдено - добавляем)
апдейтом можно поменять часть документа, не затрагивая другие поля, и им никак не добавить новый документ
Апдейт с параметром апсерт тру, тоже создаст новый документ
Алина
прикольно)) в краткой документашке про это не написано)
fenogentov
вот поэтому и вопросы
вреде все одинаково, какието нюанся, но в итоге все одинаково
fenogentov
вроде одинаково
Алина
ну все-таки остается отличие, что реплейс заменит док полностью, а апдейт поменяет только нужные поля
Алина
ну или допишет
Viktar
прикольно)) в краткой документашке про это не написано)
https://www.mongodb.com/docs/manual/reference/method/db.collection.update/#std-label-update-upsert
Алина
ага. я просто обычно такой пользуюсь https://metanit.com/nosql/mongodb/2.9.php для повседневной рутины хватет
 Арби
 Арби
 Арби
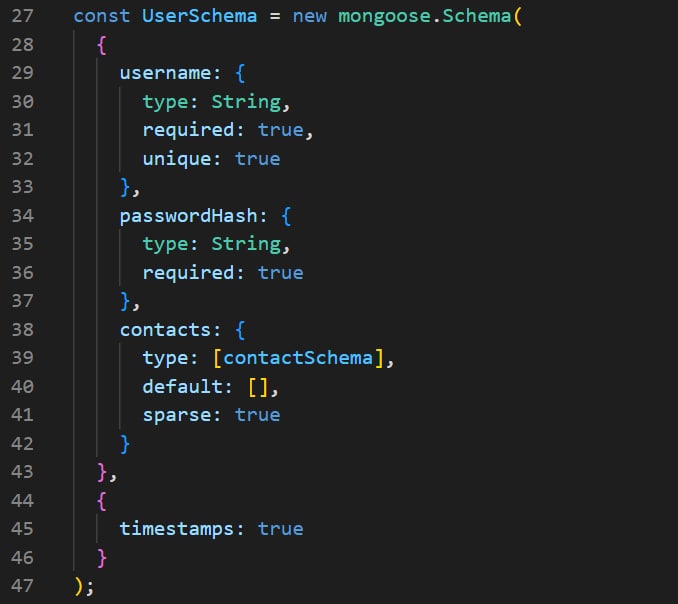 Dmitry
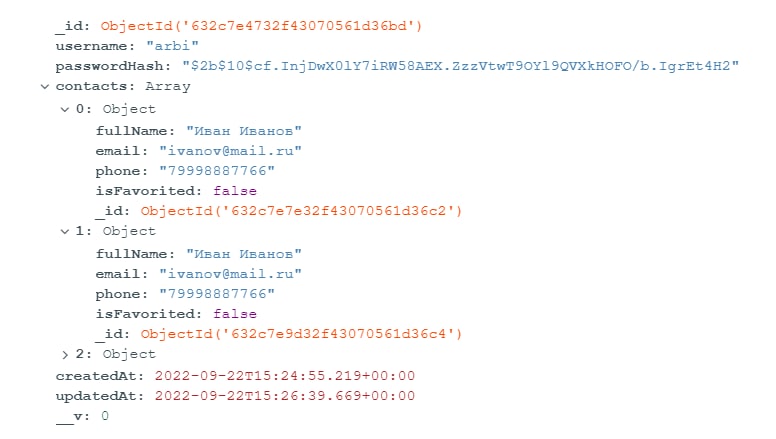
А вообще, ты можешь создать индекс по типу Schema.index({"contacts.email": 1}, {unique: true})
Арби
Так не правильно хранить т.к. есть лимит в 16 МБ на 1 документ
спасибо большое, не знал об этом ограничении
Арби
а как более правильно хранить контакты в таком случае?
Dmitry
Перенес в другую таблицу и добавил поле, кому это принадлежит, чтобы потом через тот же find найти кому это принадлежит.
Dmitry
Например у человека 4 контакта, вот 4 записи должно быть в таблице
Арби
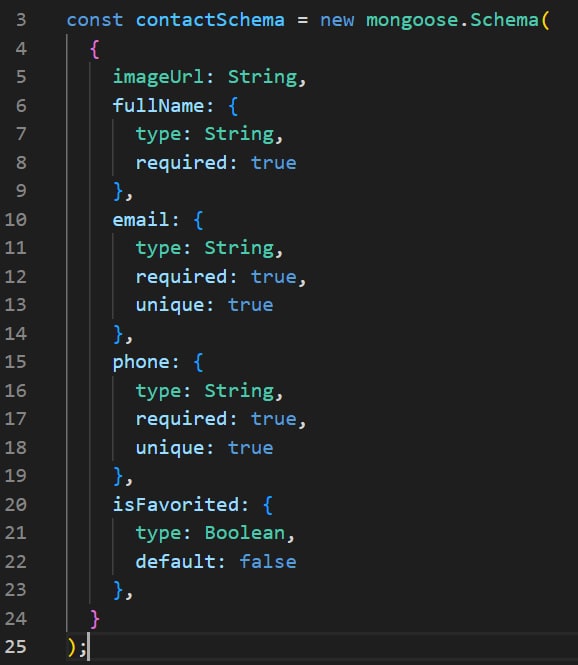
у меня отдельная таблица "контакты", каждый контакт имеет связь к одному пользователю
Арби
что-то такое?
Dmitry
А в качестве index, то Schema.index({email: 1, profile: 1}, {unique: true})
Арби
спасибо, попробую
Арби
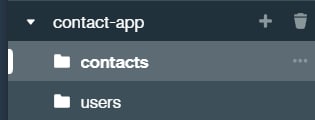 Арби
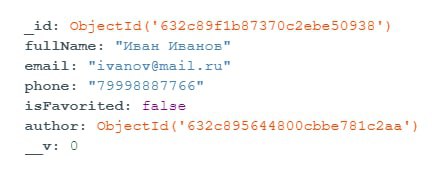 Арби
надеюсь, понятно объяснил
Арби
иными словами, мои контакты уникальны для всех пользователей, а я бы хотел, чтобы они были уникальны в пределах одного пользователя
 Vladyslav
Dmitry
иными словами, мои контакты уникальны для всех пользователей, а я бы хотел, чтобы они были уникальны в пределах одного пользователя
Тебе выше привёл пример, в чём проблема
Vladyslav
вам нужно использовать group
Vladyslav
https://stackoverflow.com/questions/35877145/mongo-distinct-query-with-full-row-object
как пример
 Nikita
Привет! Существуют ли какие-нибудь умный тулзы которые мониторят монго коллекцию с целью понять какие индексы избыточны а какие имеет смысл добавить?
lmn
профайлер? или типа кнопка “реши за меня как будет лучше” ?)
🐆
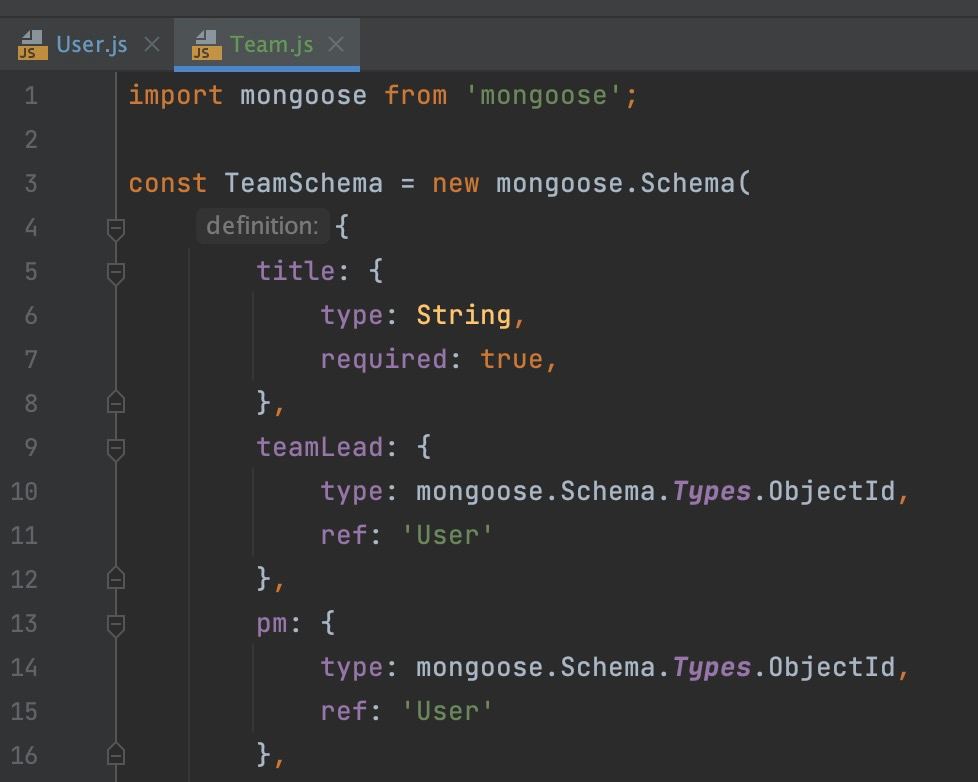
 Nick
Dmitry
🐆
А зачем ему знать, что он тимлид в какой-то команде? Он это должен знать, когда есть к этому специальное обращение
ну у меня будет 2 страницы
Юзер и Команда, если я открываю страницу Юзера, я хочу увидеть про него всю инфу, к какой команде от относится, кто у него тимлид
так же есть я открою страницу Команды, я хочу увидеть всех её членов, тимлида этой команды и тд.
тоесть схема которая у меня на скрине верная?
🐆
а как я буду получать инфу что он тимлид?
Dmitry
Ты получаешь пользователя, а потом делаешь запрос к team и вытаскиваешь всё документы, где есть его id
🐆
Ты получаешь пользователя, а потом делаешь запрос к team и вытаскиваешь всё документы, где есть его id
аааа, вроде понял, спасибо
Dmitry
аааа, вроде понял, спасибо
Это единственный верный вариант т.к. в остальных случаях тебе нужен массив, и тем самым ты быстро словишь ограничение в 16 МБ
pvlmrzv
Добрый день!
Подскажите пожалуйста!
Не могу реализовать нетривиальную сортировку(((
По одному параметру, и нужно что бы:
1. сначала были все записи со значением параметра != А,
2. далее шли все записи == А,
3. и после уже ~isNullOrEmpty
Можно ли вообще это сделать одной выборкой?
Что бы спокойно пагинацию делать.
Спасибо!
Dmitry
Добрый день!
Подскажите пожалуйста!
Не могу реализовать нетривиальную сортировку(((
По одному параметру, и нужно что бы:
1. сначала были все записи со значением параметра != А,
2. далее шли все записи == А,
3. и после уже ~isNullOrEmpty
Можно ли вообще это сделать одной выборкой?
Что бы спокойно пагинацию делать.
Спасибо!
Не знаю, что на счёт сортировки, но мне приходилось делать веса для документов и вот на основе весов потом делал сортировку по весу и id, чтобы при пагинации запись не проскочила снова.