 Andor


он может быть однопоточным, но асинхронным
 𝚔𝚟𝚊𝚙𝚜
а там мне darkhttpd очень нравится
 Vadim
ок, не 20 строк, а 40 - https://github.com/openshift/release/blob/e632edc6da1a72ec4d6883c314d737330816396d/ci-operator/templates/openshift/installer/cluster-launch-installer-upi-e2e.yaml#L113-L156
Vadim
конкурс "rate my http server" открыт, поехали
𝚔𝚟𝚊𝚙𝚜
du -hs darkhttpd
40K darkhttpd
 Eugene
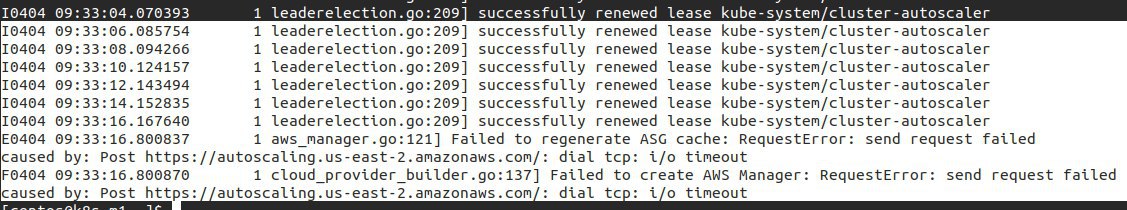 Eugene
Помогите пожалуйста, крыша едет, сижу третий день, не могу пофиксить это, в гугле все очень тухло насчет этой ошибки. либо я не там гуглю.
Andor
выглядит как будто сломался коннект до апи авс
Eugene
выглядит как будто сломался коннект до апи авс
чем чинить? адрес вроде пингуется но курл ничего не возвращает
Andor
i/o timeout?
Eugene
увеличить время таймаута?
Andor
не знаю
Andor
узнай у амазона
 Stefan
господа, поделитесь опытом бекапирования кубера в облаках? в частности амазоне
кто чем бекапит?
 Andrey
господа, поделитесь опытом бекапирования кубера в облаках? в частности амазоне
кто чем бекапит?
Снэпшотик блок девайса с etcd.
Andor
чем отличается бэкап волюмов в кубере от бэкапа волюмов без кубера?
 Rainbow
Люди с базов кубе должны страдать 😁🤗 я насколько понимаю хочется одной командой раскатать кластер с нуля, чтобы volumes стали, бекапы накатались и массаж devopsу сделали.
Stefan
Люди с базов кубе должны страдать 😁🤗 я насколько понимаю хочется одной командой раскатать кластер с нуля, чтобы volumes стали, бекапы накатались и массаж devopsу сделали.
с базами всё ок
просто узнать что помимо etcd еще бэкапят
Andor
бэкапить етцд это же мем
Andor
манифесты кубера (стейт) бэкапить куда-то - ок
Andor
сам етцд - зачем?
Andor
точнее: что ты с этим бэкапом будешь делать?
Andrey
Связь с cloud api объектами потеряется.
Andrey
Очень такое.
Andor
самые весёлые эффекты должны быть при восстановлении этого снапшота на живой кубер
Vadim
нормально он восстанавливается - скейлишь etcd до одного, восстанавливаешь из снапшота, скейлишь снова
Andor
а у шедулера крыша не поедет?
Vadim
очевидно шедулер и апи сервер остановлены до начала процедуры, даунтайм в любом случае будет
 Lucky SB
а шедулер выключен в это время
Andor
и при этом все поды надо приложить ещё?
Rainbow
как минимум вычищать ненайденые контейнеры будет долго. У меня на 200 контейнеров прилично времени занимает.
Lucky SB
это для случая поднимаем кластер с нуля
Rainbow
дольше, чем накатить с нуля манифесты
Andor
по-моему проще и удобнее манифесты бэкапить, а сам етцд оставить в покое
Lucky SB
из бекапа
Lucky SB
по-моему проще и удобнее манифесты бэкапить, а сам етцд оставить в покое
ну в принципе да.
еще проще задеплоится в новый кластер
Andor
ну вот "накатить манифесты из бэкапа" и есть деплой в новый кластер
Andor
причём этот кластер может быть и не новым, а старым
Andor
пофиг, одинаково работает
Andor
если они были в снапшоте зачем их вычищать?
ну с момента снятия снапшота же была наверное какая-то активность
Andor
а если не было, то зачем восстанавливаться из снапшота
Rainbow
по-моему проще и удобнее манифесты бэкапить, а сам етцд оставить в покое
я тут писал, что у меня была идея делать вместо apply git push (в ci/cd) в промежуточный репозиторий. А там уже другой pipeline делает apply. В случае факапа просто запускается pipeline этого репа. Принидутельный backup получается.
Rainbow
Там такое было?
Andor
да, очень похоже
𝚔𝚟𝚊𝚙𝚜
Rainbow
можно просто запретить пушить в мастер
не понял? Там манифесты же собираются из разных частей. Кейс в том, что в 100500 реп пойти руками и запустить pipeline сложно.
Andrey
Манифесты плохая идея бэкапить. Не учесть всего, что может случится в контроллерах, которые следят за новыми объектами. Бэкап etcd позволяет подложить всё так, как и было обратно.
Rainbow
𝚔𝚟𝚊𝚙𝚜
Сорри отходил, потерял нить разговора)
Rainbow
да
Rainbow
А в чем тогда проблема?
Andrey
cloud controller пойдёт и попытается создать новую LB.
Vadim
ну с момента снятия снапшота же была наверное какая-то активность
ну и пусть себе была. Под связан с контейнером, если он на месте то все будет. Если его нет, то создасться - или удалится если он не нужен во время GC
Andrey
А она уже есть. Зачем?
Andor
ну вот может поломаться интеграция с клаудом, но она так же поломается если ты будешь не в тот же самый кластер восстанавливать снапшот
Lucky SB
я тут писал, что у меня была идея делать вместо apply git push (в ci/cd) в промежуточный репозиторий. А там уже другой pipeline делает apply. В случае факапа просто запускается pipeline этого репа. Принидутельный backup получается.
идея плоха тем, что кроме ci/cd у тебя наверняка будет стоять доп. софт. cert-manager, memcache, redis И прочее, что ставится из helm
Andor
Rainbow
идея плоха тем, что кроме ci/cd у тебя наверняка будет стоять доп. софт. cert-manager, memcache, redis И прочее, что ставится из helm
вот это тоже в промежуточном сидеть должно
Vadim
если ты будешь восстанавливать снапшот одного кластера на другой, то у тебя побольше проблемы будут - например мешанина в сертификатах
Andor
там минут 10 всего
𝚔𝚟𝚊𝚙𝚜
идея плоха тем, что кроме ci/cd у тебя наверняка будет стоять доп. софт. cert-manager, memcache, redis И прочее, что ставится из helm
>И прочее, что ставится из helm
вот за это и не люблю helm, хотя его приложухи тоже декларативно описывать можно, см. ksonnet, Hemfile, kr8 и т.п.
Lucky SB
посмотри the easy way
А ссылку дашь ? а то гугля вываливает очень много всего. вижу запись в блоге куба от 2017 года - это оно ?
Andor
youtube://kubernetes+the+easy+way
Салтыдык
the easiest way, pls
Rainbow
секреты тоже ?
Ну да. Это не супер страшно в маленькой команде. Особенно с учетом, что ничего кроме 80/443/22 не торчит
Lucky SB
ну heptio ark ту же задачу решает. без промежуточной прослойки в виде репо.
Rainbow
ну heptio ark ту же задачу решает. без промежуточной прослойки в виде репо.
Это не шаг pipeline и делать каждые 10 минут наверное не будешь бекап. Но понятно. Просто альтернативный подход. Я не тестил, больше не скажу ничего
Lucky SB
аха. мне просто не совсем понятно каким образом деплоить доп. софт. вот щас я держу список чартов и их values в репо и хелмом ставлю.
Lucky SB
а тут как быть. делать helm template, и класть в репо ?
 Johan
привет, подскажите плиз, как по бест практис надо организовывать доступ к внутренним сервисам, типа бд, редис и тп, которые не смотрят наружу (у меня конкретно GKE, если это важно)? Не хочется делать лоад балансер на каждый сервис, и мне кажется это как-то криво. Возможно, есть какой-то вариант сделать впн внутри кластера и ходить через него на внутренние сервисы?