всё понятно, фича добавлена 7 ноября https://github.com/sorintlab/stolon/commit/979c44c1bfabea176683eeb79a42c89f13e6c890 В релиз пока не вошла
в 0.13 нет, а в 0.12 есть типо?
 Stefan

 Stefan
нет, должна появиться позже 0.13
блин))) а как тогда рестартиться?)) и почему у вас всё ок автоматом перезагружается?))
Stefan
киперов чтоль килять?))
Stefan
kubectl delete всё такое
 Maksim
блин))) а как тогда рестартиться?)) и почему у вас всё ок автоматом перезагружается?))
ручками, только надо соблюдать порядок рестарта мастера реплик. У меня собственноручная сборка)
Stefan
ручками, только надо соблюдать порядок рестарта мастера реплик. У меня собственноручная сборка)
хм
то есть начать имеет смысл рестарт с воркеров, а в последний момент уже мастера рестартить?
Stefan
ручками, только надо соблюдать порядок рестарта мастера реплик. У меня собственноручная сборка)
и ручками имеется ввиду через kubectl delete pod
или есть команда через stolonctl? в даном случае ничего такого не нашел
 Даня
Google certified associate cloud engineer course is free on udemy for the first 5,000 folks using promo code GCPFREEACE
https://www.udemy.com/google-certified-associate-cloud-engineer/
Maksim
и ручками имеется ввиду через kubectl delete pod
или есть команда через stolonctl? в даном случае ничего такого не нашел
первое, касательно порядка рестарта при смене shared_buffers это особо значения не имеет
Stefan
первое, касательно порядка рестарта при смене shared_buffers это особо значения не имеет
понял, спасибо за ответы
и как я понимаю при statefulset подах, он ведь не должен пересоздавать вольюм? а то попробовал удалить под который воркер и в амазоне нового вольюма не создалось, то есть по сути данные не должны затереться? бэкапы само собой сделал))) хочу просто понять как оно функционирует
Stefan
тут я не знаю)
ну вроде нормально всё
правда именно мастер надо прям ощутимо долго рестартилась и висела в статуск СontainerCreating, ожидал когда полечится ошибка:
Multi-Attach error for volume "pvc-b1cf0ebe-38da-11e9-9644-0252ffea31e4" Volume is already exclusively attached to one node and can't be attached to another
слава богам полечилось и запустилось
Maksim
ну вроде нормально всё
правда именно мастер надо прям ощутимо долго рестартилась и висела в статуск СontainerCreating, ожидал когда полечится ошибка:
Multi-Attach error for volume "pvc-b1cf0ebe-38da-11e9-9644-0252ffea31e4" Volume is already exclusively attached to one node and can't be attached to another
слава богам полечилось и запустилось
а порядок рестарта надо соблюдать при смене max_connections, чтобы на репликах не было меньше, чем на мастере
Stefan
а порядок рестарта надо соблюдать при смене max_connections, чтобы на репликах не было меньше, чем на мастере
разве хорошо сначала мастер рестартить?( пусть даже коннектов будет на мастере больше
Maksim
разве хорошо сначала мастер рестартить?( пусть даже коннектов будет на мастере больше
тогда реплики не запустяться, будет фатальная ошибка
Stefan
вот же блин, стремно конечно
 Incognito
Смотрите какая прелесть
https://www.cncf.io/the-childrens-illustrated-guide-to-kubernetes/
 Михаил
Смотрите какая прелесть
https://www.cncf.io/the-childrens-illustrated-guide-to-kubernetes/
Это с капитаном куб? Или что то новое
 Anton
его же уже спойлили на докладе в яндексе
 𝚔𝚟𝚊𝚙𝚜
Это с капитаном куб? Или что то новое
С капитаном видимо этот https://cloud.google.com/kubernetes-engine/kubernetes-comic/
 Andrey
https://web.archive.org/web/20171108051103im_/https://deis.com/images/blog-images/kubernetes-illustrated-guide-illustration-10.png
Andrey
Покажу девушке через час. Посмотрим, поймёт ли она Kubernetes.
Anton
нет конечно. Написано же — для детей.
 Rainbow
Покажу девушке через час. Посмотрим, поймёт ли она Kubernetes.
Как похвастаться что у тебя есть девушка 😂
 Vadim
https://www.operatorhub.io/
𝚔𝚟𝚊𝚙𝚜
Нашел https://github.com/operator-framework/operator-sdk/blob/master/doc/images/operator-maturity-model.png?raw=true
Vadim
а, ну prometheus operator вполне себе автоматический пилот
𝚔𝚟𝚊𝚙𝚜
а, ну prometheus operator вполне себе автоматический пилот
Хрен там https://www.operatorhub.io/operator/prometheusoperator-community.0.22.2
Vadim
ааа, ну да, оператор прометея не предоставляет метрики :)
 Aleksey
ну вроде нормально всё
правда именно мастер надо прям ощутимо долго рестартилась и висела в статуск СontainerCreating, ожидал когда полечится ошибка:
Multi-Attach error for volume "pvc-b1cf0ebe-38da-11e9-9644-0252ffea31e4" Volume is already exclusively attached to one node and can't be attached to another
слава богам полечилось и запустилось
А как ты так рестартил что лок с волюма не снялся?
Stefan
А как ты так рестартил что лок с волюма не снялся?
ну рестарт сделал по очереди
сначала первый воркер kubectl delete pod keeper-0
потом второй
оба быстренько обновились
а вот когда сделал тоже самое для мастера, то вот такая хрень была выше
Aleksey
ну рестарт сделал по очереди
сначала первый воркер kubectl delete pod keeper-0
потом второй
оба быстренько обновились
а вот когда сделал тоже самое для мастера, то вот такая хрень была выше
Оч странно, так как лок держит нода, если я не ошибаюсь, и при таком рестарте нода должна понять что лок снимается
Stefan
Оч странно, так как лок держит нода, если я не ошибаюсь, и при таком рестарте нода должна понять что лок снимается
ну вот странно что с двумя всё четко прошло
Aleksey
Обычно лок зависает если падает нода. И раньше решали это удалением ноды из кластера :)
Stefan
Stefan
Они может на тех же нодах остались
а мастера перевел на другую, отличную от той, на которой он был ранее?
Aleksey
а мастера перевел на другую, отличную от той, на которой он был ранее?
А как было то? Ты же рестартил:)
Stefan
А как было то? Ты же рестартил:)
ахах так я ж не смотрел на какой он ноде был до и на какой стал после)))
Stefan
я вообще не предполагал, что такая заминка будет при рестарте пода
Stefan
в следующий раз постараюсь не забыть и понаблюдать
Aleksey
в следующий раз постараюсь не забыть и понаблюдать
Как лучше от лока избавляться тебе расскажет @kvaps . Вроде у него в фенсинге это реализовано.
Stefan
Как лучше от лока избавляться тебе расскажет @kvaps . Вроде у него в фенсинге это реализовано.
ну он сам избавился
повисел контейнер минуты две в статусе ContainerCreating и всё
кстати он свой вольюм отцепил в этот момент и потом обратно приатачил его
𝚔𝚟𝚊𝚙𝚜
https://www.asykim.com/blog/deep-dive-into-kubernetes-external-traffic-policies
𝚔𝚟𝚊𝚙𝚜
наглядное объяснение разницы между
externalTrafficPolicy: Cluster и externalTrafficPolicy: Local
Sergio
Правильно ли я понимаю, что для пода интерфейс выделяет pause? Есть может дока, где описано, как происходит при hostNetwork: true? Тогда ведь процесс происходит по другому. Хотелось бы в картинках это понять
 Alex
https://www.asykim.com/blog/deep-dive-into-kubernetes-external-traffic-policies
А можно настроить metallb (например) в HA кластере на 3 ноды, чтобы при запросе на внешний ip кластера (который через haproxy кидает запрос на одну из нод) если под запущен на другой ноде запрос отправлялся на неё?
𝚔𝚟𝚊𝚙𝚜
Alex
под с чем, с haproxy?
Не, под просто через сервис и ингресс хочет наружу предоставить что-нибудь по http
Alex
Есть вариант ставить haproxy на каждую ноду, но тогда не очень понятно зачем нужен metallb
𝚔𝚟𝚊𝚙𝚜
Правильно ли я понимаю, что для пода интерфейс выделяет pause? Есть может дока, где описано, как происходит при hostNetwork: true? Тогда ведь процесс происходит по другому. Хотелось бы в картинках это понять
Все просто, pause запускается всегда, хоть с hostNetwork: true, хоть нет, все остальные контейнеры в поде запускаются с --network-from
𝚔𝚟𝚊𝚙𝚜
𝚔𝚟𝚊𝚙𝚜
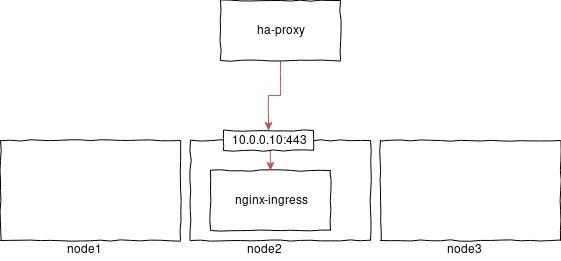
просто представь себе, что MetalLB - это что-то вроде keepalived, но IP на ноде появляется только тогда когда есть endpoint у сервиса
Alex
Ты сломал мой мозг
Ну типа есть под с nginx, есть сервис для него и ingress на этот сервис, я хочу, чтобы снаружи всё работало при 1 реплике в кластере с 3 нодами (ноды и мастера одновременно). Я ставлю metallb, настраиваю ingress при установке на использование load balancer, даю ему список ip из 3-х ip нод кластера (они в принципе внешние, но dns настроен на haproxy, который перекидывает запрос на один из них, наверное через round robin). Metallb выделяет для ingress один из внутренних ip, в итоге она нода отвечает на запросы и прекрасно работает, остальные две - нет. Хочется, чтобы остальные две тоже отвечали, но при этом не настраивать на них haproxy и т.п. штуки
𝚔𝚟𝚊𝚙𝚜
> даю ему список ip из 3-х ip нод кластера
IP-адреса которые ты выдешь MetalLB не должны существовать где либо
Alex
просто представь себе, что MetalLB - это что-то вроде keepalived, но IP на ноде появляется только тогда когда есть endpoint у сервиса
А, в этом контексте понятнее. То есть нужна ещё поддержка инфраструктуры для всяких vrrp и т.п.
𝚔𝚟𝚊𝚙𝚜
А, в этом контексте понятнее. То есть нужна ещё поддержка инфраструктуры для всяких vrrp и т.п.
vrrp не нужен, но с антиспуфингом скорее всего не заработает
Alex
Либо в моем кейсе можно сделать через vlan с каким-нибудь локальным плавающим ip и пробрасывать на него трафик через haproxy на каждой из нод
Alex
vrrp не нужен, но с антиспуфингом скорее всего не заработает
У хецнера пробовал - только через их апи если только перекидывать (
𝚔𝚟𝚊𝚙𝚜
Либо в моем кейсе можно сделать через vlan с каким-нибудь локальным плавающим ip и пробрасывать на него трафик через haproxy на каждой из нод
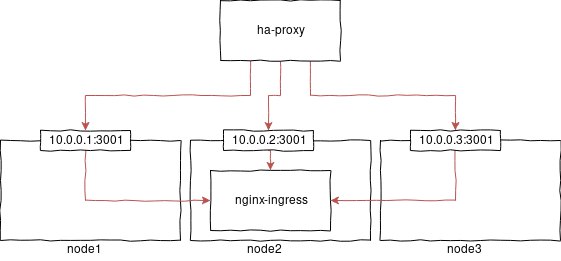
а зачем на плавающий IP, если через ha-proxy можно сразу на сервис роутить?
Alex
а зачем на плавающий IP, если через ha-proxy можно сразу на сервис роутить?
Хм, то есть у меня получится схема haproxy (внешний) - haproxy (на одной из нод) - ingress - service - pod?
𝚔𝚟𝚊𝚙𝚜
внешний - это где?
𝚔𝚟𝚊𝚙𝚜
если у тебя есть внешний haproxy и всего три ноды, то почему-бы тебе просто не вывесить твой сервис как nodePort?
Alex
если у тебя есть внешний haproxy и всего три ноды, то почему-бы тебе просто не вывесить твой сервис как nodePort?
Но тогда не будет же плюшек ингресс с роутами и сертификатами?
𝚔𝚟𝚊𝚙𝚜
Но тогда не будет же плюшек ингресс с роутами и сертификатами?
ну ты же ingress-controller вывешиваешь, так что будет все работать прекрасно
Alex
ну ты же ingress-controller вывешиваешь, так что будет все работать прекрасно
Хм, спасибо, покопаю в эту сторону, звучит логично 👍
𝚔𝚟𝚊𝚙𝚜
 𝚔𝚟𝚊𝚙𝚜
как-то так
𝚔𝚟𝚊𝚙𝚜
с metallb можно было бы сделать вот так:
𝚔𝚟𝚊𝚙𝚜
 𝚔𝚟𝚊𝚙𝚜
где 10.0.0.10 плавал бы за nginx-ingress
 Mark ☢️
Что лучше -- KVM или гитлер-гэ ?
 Александр