Промахнулся, сорри)
В общем apply отвалится только если апи не скушает json манифеста. Оно никак не следит за тем что что-то запустилось и работает как надо.
Причина: второй контейнер рестартится т.к. процесс внутри завершился. RestartPolicy - зашквар, нужно перенсти в init
чейта зашквар?
 Адаптивный Рекомбинатор


 Stefan
чисто теоретический вопрос
так уж сложилось, что однажды раз задеплоив аппликуху в кубер, техлид правил конфиги через дашборд куберовский
я с целью наконец всё это засинкать и апдейтить все изменения в репу, поделал kubectl get svc/deployment/cm -o yaml
вопрос вот какой интересует, если я для теста сделаю apply этих файлов, которые создал из выхлопа, то оно ведь не должно наново пересоздать поды и сервисы?
 Andrei
Промахнулся, сорри)
В общем apply отвалится только если апи не скушает json манифеста. Оно никак не следит за тем что что-то запустилось и работает как надо.
Причина: второй контейнер рестартится т.к. процесс внутри завершился. RestartPolicy - зашквар, нужно перенсти в init
apiVersion: apps/v1
kind: Deployment
metadata:
labels:
name: test
tier: backend
name: test
namespace: default
spec:
replicas: 1
selector:
matchLabels:
tier: backend
template:
metadata:
labels:
tier: backend
spec:
volumes:
- name: shared-data
emptyDir: {}
initContainers:
- name: debian-container
image: debian
volumeMounts:
- name: shared-data
mountPath: /pod-data
command: ["/bin/sh"]
args: ["-c", "echo Hello from the debian container in deployment > /pod-data/index.html"]
containers:
- name: nginx-container
image: nginx
volumeMounts:
- name: shared-data
mountPath: /usr/share/nginx/html
ports:
- containerPort: 80
Адаптивный Рекомбинатор
а 2 пида в контейнере не зашквар?
Andrei
где вы увидели два пида? sh -c ?
Адаптивный Рекомбинатор
а что это, можешь разъяснить немного?
dry-run - не применять apply, заценить что будет изменено
diff - это про разницу yaml и реального мира
Andrei
Это разные контейнеры в рамках одного пода. Вы путаете теплое с мягким
Stefan
dry-run - не применять apply, заценить что будет изменено
diff - это про разницу yaml и реального мира
а, супер
попробую, спасибо
Stefan
Адаптивный Рекомбинатор
Это разные контейнеры в рамках одного пода. Вы путаете теплое с мягким
окок, init’ы бывают разными
Дмитрий
apiVersion: apps/v1
kind: Deployment
metadata:
labels:
name: test
tier: backend
name: test
namespace: default
spec:
replicas: 1
selector:
matchLabels:
tier: backend
template:
metadata:
labels:
tier: backend
spec:
containers:
- name: nginx-container
image: nginx
ports:
- containerPort: 80
- name: debian-container
image: debian
Ошибка CrashLoopBackOff при таком создании Deployment, внутри которого несколько контейнеров
 Artem
чисто теоретический вопрос
так уж сложилось, что однажды раз задеплоив аппликуху в кубер, техлид правил конфиги через дашборд куберовский
я с целью наконец всё это засинкать и апдейтить все изменения в репу, поделал kubectl get svc/deployment/cm -o yaml
вопрос вот какой интересует, если я для теста сделаю apply этих файлов, которые создал из выхлопа, то оно ведь не должно наново пересоздать поды и сервисы?
При изменении конфиг мапов, связянные с ним поды тронуты не будут. При изменении деплойментов будет запущен роллин апдейт, при измении сервисов сервис будет изменен. Это при условии, если манифесты будут отличаться от того, что в апи сервере
Stefan
При изменении конфиг мапов, связянные с ним поды тронуты не будут. При изменении деплойментов будет запущен роллин апдейт, при измении сервисов сервис будет изменен. Это при условии, если манифесты будут отличаться от того, что в апи сервере
спасибо за разъяснение, уже прошелся с dry-run
изменений не должно быть) одинаково всё
 Nik
Посоветуйте здоровый kafka оператор плиз.
 Artem
Ребят, подскажите пожалуйста, чем вы автоматизируете настройку кластера куба на gke?
Например, есть у меня чистый кластер. Чем настроить helm, RBAC, неймспейсы, security, и т.п.
Artem
можно в принципе ансиблом, но не уверен что это будет правильно, интересно услышать мнения других
Anonymous
кто-нибудь юзает mongodb replicaset?
как вы делаете kubectl port-forward? я пробразываю порты до подов но у меня все равно коннект не идет к кластеру, хотя если напрямую к каждому поду подключаться то все ок..
 Denis
но terraform же по идее за инфраструктуру должен отвечать (диски, инстансы)
А кубернетес разве не инфраструктура?
https://www.terraform.io/docs/providers/google/r/container_cluster.html
 Rainbow
Ребят, подскажите пожалуйста, чем вы автоматизируете настройку кластера куба на gke?
Например, есть у меня чистый кластер. Чем настроить helm, RBAC, неймспейсы, security, и т.п.
Если не использовать helm, то все сводится к kubectl apply -f manifests/
Artem
А кубернетес разве не инфраструктура?
https://www.terraform.io/docs/providers/google/r/container_cluster.html
инфраструктура, но на мой взгляд не того уровня, каким должен terraform заниматься, да и + если поднимается вопрос reusable настройки, то те ресурсы что есть в терраформе относятся исключительно к gke. Если я допустим на AWS захочу такой кластер поднять, мне нужно будет переписывать часть, которая занимается настройкой куба
Artem
Если не использовать helm, то все сводится к kubectl apply -f manifests/
та даже если хелмом... саму команду чисто в баше запускать?)
Rainbow
та даже если хелмом... саму команду чисто в баше запускать?)
А как вы кластер делали? Так и это
Denis
инфраструктура, но на мой взгляд не того уровня, каким должен terraform заниматься, да и + если поднимается вопрос reusable настройки, то те ресурсы что есть в терраформе относятся исключительно к gke. Если я допустим на AWS захочу такой кластер поднять, мне нужно будет переписывать часть, которая занимается настройкой куба
А вы до конца понимаете как выглядит k8s с точки инфраструктуры gke? У вас на каждого клауд-провайдера свои инструмент для деплоя?))
Artem
@alexesDev кластер поднимается через терраформ. Ладно, думаю самый оптимальный вариант делать это через ансибл
Denis
@alexesDev кластер поднимается через терраформ. Ладно, думаю самый оптимальный вариант делать это через ансибл
Да. Там есть модуль k8s. Им можно провижинить ресурсы k8s. В terraform тоже есть свой модуль для этого, но он как по мне скудный по функционалу.
Artem
А вы до конца понимаете как выглядит k8s с точки инфраструктуры gke? У вас на каждого клауд-провайдера свои инструмент для деплоя?))
Так мне и не обязательно
понимать как оно там под капотом выглядит. Сама суть что та часть, которая создаёт мне чистый кластер может быть для каждого клауд провайдера разной. А его настройка одна и та же для всех)
Artem
В любом случае всем спасибо за ответы
 Vadim
можно в принципе ансиблом, но не уверен что это будет правильно, интересно услышать мнения других
старый способ - ансиблом
новый моднейший - оператором, который донастраивает и слушает CRD для конфигурации
Denis
Так мне и не обязательно
понимать как оно там под капотом выглядит. Сама суть что та часть, которая создаёт мне чистый кластер может быть для каждого клауд провайдера разной. А его настройка одна и та же для всех)
В Terraform для каждого клауд-провайдера свой модуль если не ошибаюсь) В любом случае придется будет переписывать всю инфраструктуру.
Andrey
Ребят, подскажите пожалуйста, чем вы автоматизируете настройку кластера куба на gke?
Например, есть у меня чистый кластер. Чем настроить helm, RBAC, неймспейсы, security, и т.п.
терраформом через helm provider с install_tiller=true. Кубовые ресурсы (rbac, ns, и тд) запихиваете в свой кастомный чарт и деплоите его через терраформ
Andrey
если gke деплоился через TF, то helm provider настраивается через его output
Stefan
очень нужна помощь с stolon
есть такой параметр глобальный
stolonctl init '{ "initMode": "existing", "existingConfig": { "keeperUID": "" } }'
в keeperUID нужно прописывать название stateful пода??
Artem
Stefan
когда прописываю то в сентинеле ошибка
failed to update cluster data {"error": "keeper \"rm-stolon-keeper-0\" state not available"}
Stefan
и к кластеру нельзя подключиться
 German
А кто сталкивался ставлю последний kubelet kubeadm kubectl на одной ноде(с антейном мастера), до этого было все ок, теперь поды перестали достукиваться до внешних адресов
German
Kubelet Version:
v1.13.3
 Maksim
очень нужна помощь с stolon
есть такой параметр глобальный
stolonctl init '{ "initMode": "existing", "existingConfig": { "keeperUID": "" } }'
в keeperUID нужно прописывать название stateful пода??
uid кипера, который был указан при начальном запуске, либо сгенерирован по умолчанию
Stefan
uid кипера, который был указан при начальном запуске, либо сгенерирован по умолчанию
а, значит мне такое не нужно
Stefan
я так понял чтоб обновлять какие-либо конфигурации то это нужно было делать
stolonctl update?))))))
 𝚔𝚟𝚊𝚙𝚜
Maksim
я так понял чтоб обновлять какие-либо конфигурации то это нужно было делать
stolonctl update?))))))
там обновляют спеку, uid кипера, к сожалению, так просто не обновить, с начальным значением надо "жить" до конца
Stefan
там обновляют спеку, uid кипера, к сожалению, так просто не обновить, с начальным значением надо "жить" до конца
ну я теперь чтоб перезагрузить кластер, для применения настроек, буду делать так
args:
- update
- --cluster-name=rm-stolon
- --store-backend=kubernetes
- --kube-resource-kind=configmap
- --yes
- '{ "failInterval": "10s", "automaticPgRestart": true, "synchronousReplication": true }'
Stefan
это ведь норм?
Stefan
а то когда добавляю новые параметры в posgresql.conf, то требует перезагрузки
Maksim
это ведь норм?
если вы хотите добавить опции к уже существующим, то используйте ещё опцию --patch. Но automaticPgRestart я бы осторожно использовал, его недавно вмержили и не уверен что рестарт кластера в целом сделали правильно
Stefan
если вы хотите добавить опции к уже существующим, то используйте ещё опцию --patch. Но automaticPgRestart я бы осторожно использовал, его недавно вмержили и не уверен что рестарт кластера в целом сделали правильно
так а с ключем —patch оно применяет без перезагрузки?
German
обновил версиб калисо до 3.5, стал виден интернет, и пингуется IP сервера на котором раскатан kube, но не пингуется домашняя подсеть этого сервера из пода (а с самого серверра норм пингуется)
Maksim
так а с ключем —patch оно применяет без перезагрузки?
перезагрузки постгреса? Если без —patch, тогда надо сразу все параметры указывать - они перезапишут спеку
Artem
обновил версиб калисо до 3.5, стал виден интернет, и пингуется IP сервера на котором раскатан kube, но не пингуется домашняя подсеть этого сервера из пода (а с самого серверра норм пингуется)
эт норм. Другие домашние хосты вероятно ничего не знают про POD_CIDR
German
эт норм. Другие домашние хосты вероятно ничего не знают про POD_CIDR
но раньше все из коробки работало
Artem
¯\_(ツ)_/¯
Stefan
перезагрузки постгреса? Если без —patch, тогда надо сразу все параметры указывать - они перезапишут спеку
ну я сразу и указываю
а если их удалю, то они всё равно сохраняются в конфиге, старые параметры, так что в принципе для меня это не критично
просто хочу понять как правильно применять настройки постгресу, с перезагрузкой
он от меня требует её, когда я вношу параметры в конфиг постгреса, требующие перезагрузки
German
¯\_(ツ)_/¯
я просто к тому что не понимаю в чем тут разница, почему первое работает а второе через тот же хоп нет
German
root@bu-busybox-57bff8ff6c-d74ht:/# traceroute 192.168.1.200
traceroute to 192.168.1.200 (192.168.1.200), 30 hops max, 60 byte packets
1 192-168-1-140.kubernetes.default.svc.cluster.local (192.168.1.140) 0.056 ms 0.028 ms 0.036 ms
2 * * *
3 * * *
4 * * *
5 * * *
6 * * *
7 *^C
root@bu-busybox-57bff8ff6c-d74ht:/# traceroute 8.8.8.8
traceroute to 8.8.8.8 (8.8.8.8), 30 hops max, 60 byte packets
1 192-168-1-140.kubernetes.default.svc.cluster.local (192.168.1.140) 0.090 ms 0.040 ms 0.039 ms
2 192.168.1.1 (192.168.1.1) 1.644 ms 0.376 ms 0.269 ms
Andrey
#gke #cluster-autoscaler #istio
Кому-то может быть это интересно.
Сегодня столкнулся с проблемой что GKE кластер перестал downscale'иться. Поскольку cluster autoscaler работает на мастере, его логи посмотреть не получится, выкрутился попробовав сам сделать drain ноды, которую по идее надо выкинуть из кластера (загрузка меньше 50%).
Как оказалось, проблема в подах, в которые внедряется сайдкар от istio, который использует emtpyDir volume - из за него drain падает с ошибкой.
 Dmitrii
Господа, а MetalLB в продакшене кто-нибудь юзает? Интересно, достаточно ли он стабилен для этого.
Maksim
ну я сразу и указываю
а если их удалю, то они всё равно сохраняются в конфиге, старые параметры, так что в принципе для меня это не критично
просто хочу понять как правильно применять настройки постгресу, с перезагрузкой
он от меня требует её, когда я вношу параметры в конфиг постгреса, требующие перезагрузки
после установки automaticPgRestart столон должен уже сам подхватывать запросы на рестарт. А настройки пг передавайте в pgParameters
Stefan
Aleksandr
Oleg
Ребят, привет.
Вопрос такой, кто - нибудь держит один отдельный кластер Etcd на несколько кластеров k8s?)
Andrei
Ого, смело
Stefan
после установки automaticPgRestart столон должен уже сам подхватывать запросы на рестарт. А настройки пг передавайте в pgParameters
ну вот я снова и столкнулся с этой проблемой
оно то в логах мне пишет
2019-02-28 14:55:58.415 UTC [15285] LOG: received SIGHUP, reloading configuration files
2019-02-28 14:55:58.416 UTC [15285] LOG: parameter "shared_buffers" cannot be changed without restarting the server
2019-02-28 14:55:58.416 UTC [15285] LOG: configuration file "/stolon-data/postgres/postgresql.conf" contains errors; unaffected changes were applied
но сам сигнал на рестарт не приходит
 Evgeny
 Evgeny
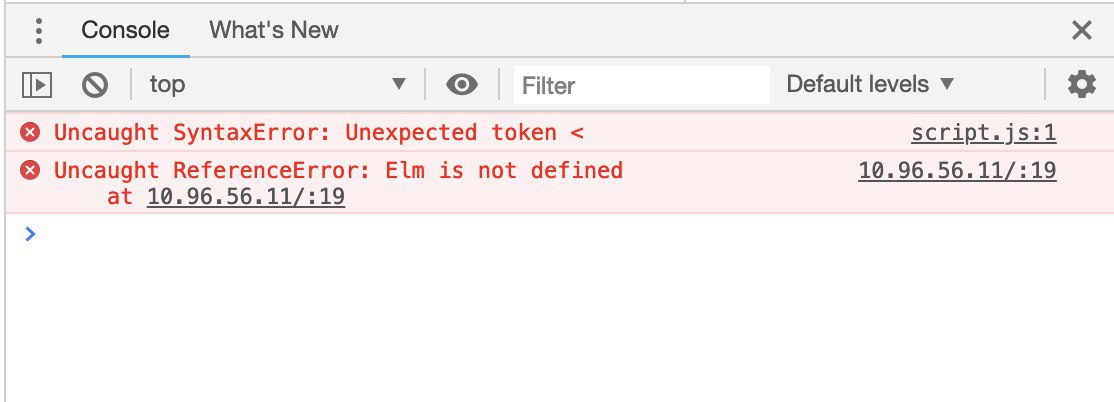
кто-то сталкивался с такой проблемой?
Artem
На моей памяти роутинг по пути в ингрессе может ломать веб приложения, которые сами любят делать редиректы
Maksim
ну вот я снова и столкнулся с этой проблемой
оно то в логах мне пишет
2019-02-28 14:55:58.415 UTC [15285] LOG: received SIGHUP, reloading configuration files
2019-02-28 14:55:58.416 UTC [15285] LOG: parameter "shared_buffers" cannot be changed without restarting the server
2019-02-28 14:55:58.416 UTC [15285] LOG: configuration file "/stolon-data/postgres/postgresql.conf" contains errors; unaffected changes were applied
но сам сигнал на рестарт не приходит
у меня всё проходит, такой лог:
INFO postgresql/postgresql.go:409 reloading database configuration
server signaled
LOG: received SIGHUP, reloading configuration files
LOG: parameter "shared_buffers" cannot be changed without restarting the server
LOG: configuration file "/opt/stolon/postgres/postgresql.conf" contains errors; unaffected changes were applied
INFO cmd/keeper.go:1603 Restarting postgres
INFO postgresql/postgresql.go:464 restarting database
INFO postgresql/postgresql.go:372 stopping database
Покажите значение automaticPgRestart: stolonctl spec ... | jq .automaticPgRestart
Stefan
у меня всё проходит, такой лог:
INFO postgresql/postgresql.go:409 reloading database configuration
server signaled
LOG: received SIGHUP, reloading configuration files
LOG: parameter "shared_buffers" cannot be changed without restarting the server
LOG: configuration file "/opt/stolon/postgres/postgresql.conf" contains errors; unaffected changes were applied
INFO cmd/keeper.go:1603 Restarting postgres
INFO postgresql/postgresql.go:464 restarting database
INFO postgresql/postgresql.go:372 stopping database
Покажите значение automaticPgRestart: stolonctl spec ... | jq .automaticPgRestart
хм, а ведь отсутсвует значение....
https://pastebin.com/KB7A3WvH
такая вот джоба была:
https://pastebin.com/Rf3mYhfQ
при этом из этих трех параметров не применился только автоматический рестарт, странно
Maksim
хм, а ведь отсутсвует значение....
https://pastebin.com/KB7A3WvH
такая вот джоба была:
https://pastebin.com/Rf3mYhfQ
при этом из этих трех параметров не применился только автоматический рестарт, странно
а какая вас версия столона? Фичу авторестарта вкоммитили только недавно
Stefan
а какая вас версия столона? Фичу авторестарта вкоммитили только недавно
image: "sorintlab/stolon:v0.13.0-pg10"
Maksim
image: "sorintlab/stolon:v0.13.0-pg10"
всё понятно, фича добавлена 7 ноября https://github.com/sorintlab/stolon/commit/979c44c1bfabea176683eeb79a42c89f13e6c890 В релиз пока не вошла