Еще приколюху вспомнил - как-то собеседовался в одну фирму которая писала что-то вроде ЦРМ для ЖКХ служб. Учет платежей, расходы и пр. Мне их лид рассказал что монга у них основная БД. "Вроде работает, но вот джоины делать трудно" XD
Как только хочется JOIN-ы и транзакции - монгу сразу надо вычёркивать из списка кандидатов.
 Kirill


 Tishka17
то есть примерно всегда
 Andrey
ребят, подскажите плиз куда копать?
на проекте используется commonmark
надо внедрить туда виджеты, например этот, https://facelessuser.github.io/pymdown-extensions/extensions/details/ ...
пытался найти как расширить всё это дело, возможно не там искал....
 Alex
Как только хочется JOIN-ы и транзакции - монгу сразу надо вычёркивать из списка кандидатов.
Да я знаю. Сам таким дураком был. На проекте одном втыкали эластиксерч для полнотекстного поиска и потом банда "сениоров" которая это делала съебала в закат. И я остался один на один с этой хреновиной и решил для "ускорения" тоже сделать эластик чем-то вроде основной БД. Сейчас понимаю каким я был идиотом.
Kirill
то есть примерно всегда
Я вот удачное (наверное) нашёл применение для монги. В ней ведь можно хранить файлы (GridFS называется). А у меня сервис один есть, асинхронный. Ему надо было много работать с файлами, но в asyncio это попа-боль, т.к. файлы синхронные. Так я просто поставил рядом монгу, через motor запилил свою версию GgridFS и всем этим сэкономил кучу времени на написание своего "чудо-менеджера" для работы со 100500 файлами из асинхронного приложения. Заодно могу быстро получать всякие аггрегации по списку этих файлов: сколько места занято, количество. Удалять старые файлы парой запросов.
Tishka17
хз что за гридфс =) юзаю s3
Kirill
Файлы надо локально хранить, т.к. это как раз временный кеш перед заливкой их в S3
Kirill
GridFS - это такая програмная херня, которая хранит файлы в виде кусочков по 250кб в коллекции монги
Tishka17
Это и есть s3 фактически
Tishka17
Файлы надо локально хранить, т.к. это как раз временный кеш перед заливкой их в S3
Хз, мы чанки в s3 вроде льем, потом собираем и заливаем целиком. Но не уверен
Kirill
Мне надо не супер-пупер решение на 10 серверов. А просто "менеджер" для работы со 100500 локальными файлами без гемороя с асинхронкой и без попа-боли насчёт того что несколько тысяч файловых дескрипторов открытых одновременно - это очень хреново.
 Ivan
пиши в файлы через отдельный тред, завязываться на монгу для темпа такое себе ИМХО
Tishka17
Тредпул и вперёд
Kirill
пиши в файлы через отдельный тред, завязываться на монгу для темпа такое себе ИМХО
Ещё раз повторю - несколько тысяч файлов открытых одновременно. Вы о каком тред-пуле тут говорите? Не помните историю (кажется это было во Вконтакте), что они вместо хранения и работы с кучей файлов, сделали один "супер-файл", внутри которого хранили данные других файлов. И в приложении был только один открытый файл.
Kirill
Вот примерно тоже самое мне и даёт монга. Плюс нормальная асинхронность, без запуска десятка тредов.
Ivan
прям тысячи файлов из одного процесса?
Kirill
Ну вот прибежит 1000 юзеров что бы заливать свои файлики - придётся работать с 1000 файлами
Kirill
Да даже если их 100 или 200 - это в любом случае геморой в asyncio. Плюс что бы посчитать занятое место, удалить старые файлы - это же очень медленно будет в FS делать по одному файлику. А в монге всё это делается очень легко.
Tishka17
Ну вот прибежит 1000 юзеров что бы заливать свои файлики - придётся работать с 1000 файлами
делаешь пул на 100 потоков и загружаешь всего сотню файлов. Все равно io больше вряд ли позволит
Tishka17
не, имеет смысл наверно
Kirill
Это же питон - 100 дополнительных потоков убъёт нахрен всю скорость основоного потока. Они же все по очереди будут работать.
Tishka17
ну не знаю, 10 процессов по 10 потоков
Tishka17
Это же питон - 100 дополнительных потоков убъёт нахрен всю скорость основоного потока. Они же все по очереди будут работать.
а asyncio не по очереди работает?
Ivan
файловое IO не берёт GIL
Kirill
А что делать с проблемой кучи открытых файлов? Это нагрузка на систему, открывать-закрывать файлы - это медленно. Вот мне очень не хотелось со всем этим разбираться, и ещё иметь кучу потоков в которых выполняется не понятно что и не очень понятно как их планировать для нормальной утилизации CPU.
Tishka17
открывать-закрывать медленно?
Kirill
Да, это-же сискол в ядро
Tishka17
куча открытых файлов конечно нагрузка, но не больше чем нагрузка от количества открытых сокетов
Tishka17
я бы в целом проверил сколько одновременных загрузок файлов тянет сервер без деградации производительности
Tishka17
мне кажется и с gridfs магии не случится
Tishka17
диск не резиновый
Tishka17
даже ssd
Kirill
Ну я просто поделился решением. Будете сами когда-то в asyncio работать с кучей файлов, попробуете тред-пулы и если не понравится - может вспомните мой вариант 😊
Tishka17
а у тебя что, чанковая загрузка или просто юзеры файлы грузят?
Tishka17
Ну я просто поделился решением. Будете сами когда-то в asyncio работать с кучей файлов, попробуете тред-пулы и если не понравится - может вспомните мой вариант 😊
да вариант интересный, тут скорее интересно было обсудить что уже замерял и как пришел к этому решению
Kirill
мне кажется и с gridfs магии не случится
Это уже не моя попа-боль 😊 Приложение отправило команду в монгу, монга её приняла - приложение пошло заниматься другими делами, пока монга не вернёт ответ.
Tishka17
о че нашел, https://medium.com/@ashan.fernando/upload-files-to-aws-s3-using-signed-urls-fa0a0cf489db
Tishka17
Kirill
о че нашел, https://medium.com/@ashan.fernando/upload-files-to-aws-s3-using-signed-urls-fa0a0cf489db
Я уже 8 лет варюсь в этой каше и хорошо знаю все узкие места при работе с S3 (у нас кстати не только Amazon). И у нас с самого начала было всё сделано не pre-signed URL-ах, клиенты сами грузили в S3 данные.
Но всё равно мы пришли у решению, что нужна своя прокся, которая будет делать заливку файлов проще для клиентов, и удобнее для бекенда ( не придётся бекенду потом скачивать файл из S3, что бы извлечь из него метаданные, посчитать нормальную чексумму и др.).
Tishka17
хм
Tishka17
окей
Tishka17
интересно
Kirill
а у тебя что, чанковая загрузка или просто юзеры файлы грузят?
В S3 заливаем кусками по 5Мб. Клиенты (через новую проксю) в идеале шлют только один PUT запрос со всем файлом. В случае обрыва они просто узнают у прокси где всё остановилось, и делают PATCH запрос с оставшимся куском файла.
Tishka17
но раве не проще из s3 скачать с понятной скоростью, чем медленно от клиента?
Tishka17
Tishka17
если чанки - другое дело
Tishka17
Tishka17
а, не
Tishka17
у нас наоборот клиенты льют чанки
Tishka17
а мы потом в s3 целиком загружаем
Kirill
у нас наоборот клиенты льют чанки
Что бы клиенту залить чанк в S3 напрямую - надо у бекенда спросить pre-signed url. Т.е. уже два запроса на заливку одного чанка. А перед этим надо сказать бекенду что бы он создал в S3 мультипарт, и потом, когда все чанки залиты - дёрнуть бекенд что бы он узнал об этом и сделал complete для мультипартра. И того минимум надо 6 запросов что бы залить файл из двух кусков. Если кусков только 1, то 3 запроса. На мобилках, которые очень ограничены операционкой во времени фоновой работы, все эти куча HTTP запросов - это проклятье. Их быстрее OS задушит, прежде чем они доберутся до передачи данных самого файла.
Tishka17
Ну у нас как раз клиенты льют на нашу проксю, а она собирает и в с3
Tishka17
Хотя хз, детали не знаю
 Maxim
Оказывается сама монга выпустила что-то очень похожее на MongoEngine:
https://github.com/mongodb/pymodm, попробую это
Да, мне FastAPI только в синхроне и надо.
В моих проектах у монги есть преимущество:
1) Мне не нужны транзакции. А в PostgreSQL иногда я натываюсь на проблемы с транзакциями, когда при попытке что-то записать получается ошибка, что сессия с ошибкой нужно делать роллбек.
2) Все мои данные они реально лучше ложатся в концепцию коллекций. Когда есть документы с вложенными документами. Понятно что и в постгресе можно забабахать все на JSONB, но нормализацию таблиц уже из головы мне не вытащить, и в результате когда я с посгрисом работаю, у меня много таблиц и запросы потом получаются сложные.
3) Мне в моих проектах очень важна скорость разработки. Я понимаю, что с всякими alembic миграции для постгриса можно генерить автоматом. Но все равно какие-то мелочи есть, которые руками приходитсяс прописывать. Например алембик сам не удаляет в миграциях автоматом созданные типы, надо руками прописать.
И да, я согласен что Schemaless это нифига не плюс. Все равно у меня есть модели. И как раз эти schemaless это и есть причина, почему я иногда возвращаюсь к постгресу. Боюсь на монге данные потерять. Но по факту, за много лет у меня в проекте на монге я ни разу не накосячил и данные не потерял.
А не появилась ли в монге система человеческих ошибок на схемы? Там уже давно есть возможность, для коллекций задавать жесткую схему. Вот только проблема в том, что ошибки там бесполезные. Т.е. при попытки записать невалидный документ, монга кидала ошибку без деталей в чем именно проблема. Может в новой 4.4 версии сделали нормаьные сообщения об ошибках?
Я вот в постгресе стал активно юзать JSONB поля. Сложных запросов по ним не делаю. В основном там какие-то цельные куски, которые укладывать в нормализованную базу и доставать через пять джоинов было бы больно. Пока нравится.
Tishka17
И у нас файлы не из 2х кусков обычно, а из десятков - сотен :)
Tishka17
Юзер обычно льет ну хотя бы сотни две метро
Tishka17
А то и пару гигов
 Михаил
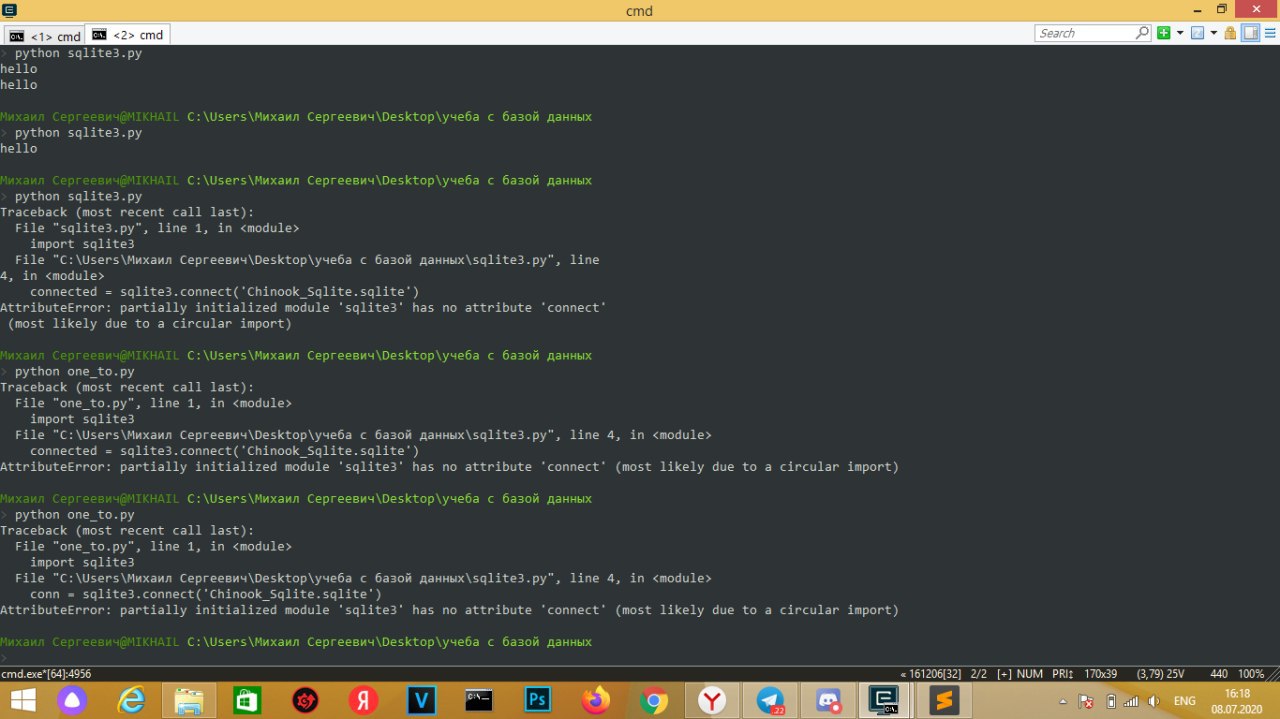 Kirill
Ну у нас как раз клиенты льют на нашу проксю, а она собирает и в с3
Ну вот у вас наверное сначала клиент зальёт всё в проксю, и только потом она в S3 заливает. У нас это не прокатит - слишком большая задержка будет, прежде чем мы сможем сказать клиенту, что файл находится в надёжном месте (прокся это ведь не S3, надёжность там почти ни какая).
Поэтому в нас файл одновременно заливается в S3 и дополнительно последний кусок размером до 5Мб сохраняется в GridFS, на случай обрыва.
Tishka17
Ну вот у вас наверное сначала клиент зальёт всё в проксю, и только потом она в S3 заливает. У нас это не прокатит - слишком большая задержка будет, прежде чем мы сможем сказать клиенту, что файл находится в надёжном месте (прокся это ведь не S3, надёжность там почти ни какая).
Поэтому в нас файл одновременно заливается в S3 и дополнительно последний кусок размером до 5Мб сохраняется в GridFS, на случай обрыва.
Ну прокся тоже куда-то льет. Мне казалось - тоже в с3 в отдельный бакет
Tishka17
А потом из с3 выгружает и собирает целиком
Tishka17
Но тут могу врать
Kirill
А потом из с3 выгружает и собирает целиком
Выгружать то зачем? Просто завершаешь мультипарт и S3 сама "склеит" куски
Tishka17
эм, не мульти парт же
Tishka17
отдельные запросы
 Denis
Михаил
переименовал
Михаил
все равно та же проблема
Tishka17
покажи
Kirill
эм, не мульти парт же
Может мы про разное? Мультипартом я называю то что в S3, а не то что multipart/form-data
Tishka17
Может мы про разное? Мультипартом я называю то что в S3, а не то что multipart/form-data
а, вот тут моя зона компетенции кончается
Михаил
Я там затупил немного. Спасибо)
Михаил
Переименовал сначала файл .py, а потом уже файл базы данных
 Dogma
Переименовал сначала файл .py, а потом уже файл базы данных
У тебя на скрине два файла. Хоть первый переименовал?
Потому что тем названием которое было у тебя ты перекрыл стандартную либу sqlite3 (которую не нужно устанавливать так как она есть уже в питоне)
Михаил
Буду знать, спасибо
 AlexS
Добрый день, подскажите, пожалуйста:
В си dll прокинут колбэк из Питона. Этот колбэк вызывается с аргументом - массивом байтов, т.е. массив байтов уходит в питон. Но на стороне питона что-то не то происходит, и часть данных будто теряется.
Сигнатура колбэка такая:
EventsHandler = ctypes.CFUNCTYPE(None, ctypes.c_char_p, ctypes.c_int)
В Си создается массив чаров, заполняется и передаётся в колбэк.
Если же создать буффер через create_string_buffer в питоне, и через него получить данные - то всё правильно приходит.
Anonymous
2
 Alex
Добрый день, подскажите, пожалуйста:
В си dll прокинут колбэк из Питона. Этот колбэк вызывается с аргументом - массивом байтов, т.е. массив байтов уходит в питон. Но на стороне питона что-то не то происходит, и часть данных будто теряется.
Сигнатура колбэка такая:
EventsHandler = ctypes.CFUNCTYPE(None, ctypes.c_char_p, ctypes.c_int)
В Си создается массив чаров, заполняется и передаётся в колбэк.
Если же создать буффер через create_string_buffer в питоне, и через него получить данные - то всё правильно приходит.
как ты этот "масив чаров" создаешь. покажи код.
 Mike_Went
массив чаров и магов