а, я ж переспросил =)
Ну сорян)))
 Ruslan


 Tishka17
первый раз слышу про такой
Ruslan
Та я вот тоже не слышал вот и прошу больше ресурсов по теме
 slair
pyqt же
точнее PyQt
Tishka17
you can call a Python function from C++ or call a C++ function from Python
Tishka17
прикольно
Ruslan
Согласен
slair
да пофиг, я ушёл с него
для питона tk из коробки есть, его и надо юзать
 ăŵſmçøŗvæx
https://doc.qt.io/archives/qq/qq23-pythonqt.html
Tishka17
вроде даже пилится потихоньку
slair
да пофиг, я ушёл с него
для питона tk из коробки есть, его и надо юзать
интерфейс ещё тот
но можно допилить под почти нативный, в линуксе и в винде
slair
 Tishka17
slair
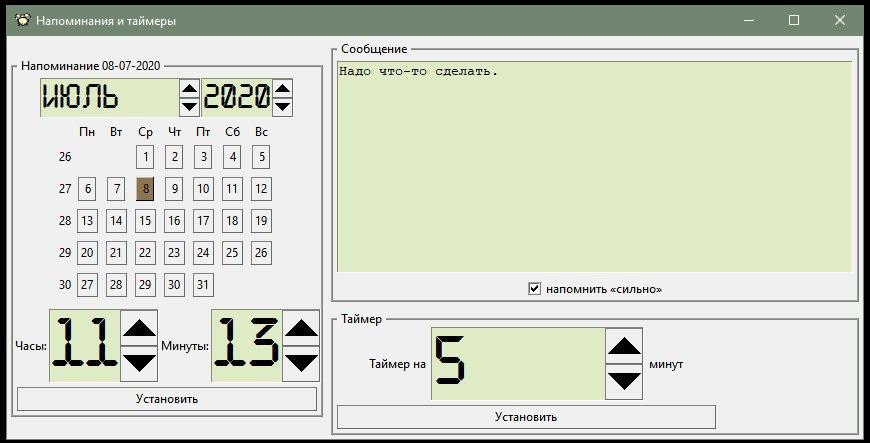
вот в винде кнопки съезжают почему то, в линуксе норм
Tishka17
трешовенько как обычно с tk
Tishka17
чем там шустрее - хз
slair
ну питон я собираю сам и tcl/tk биндинги там есть
Tishka17
ну если сам собираешь, конечно
 Alex
трешовенько как обычно с tk
для интерфейса в виде пары кнопок и пары полей ввода сойдет. для чего-то сложнее ну такоооое.
Alex
но что-то сложнее и на питоне писать уже сомнительное удовольствие.
Tishka17
Alex
хотя быть может и всяко приятней чем на плюсах.
Ruslan
но из коробки же, и шустрее qt всяких
Тесты проводил?) Я пробовал все основные гуи и qt выглядит посерьёзнее. Если мне нужно окно с двумя полями и одной кнопкой то да, возьму tk
Ruslan
slair
просто хотелось что-то на tk написать, он шедулит сообщения через at в линуксе, под винду всё руки допилить не доходят
Tishka17
Хз, меня устраивает at
slair
D:\slair\bin>at
Команда AT признана нерекомендуемой. Используйте вместо нее schtasks.exe.
да и синтаксис вероятно отличается от линуксового
 Vovan
Привет всем!
Есть сервис написанный при помощи flask. (Linux, Docker) 20 - RPS
Разворачиваю в docker при помощи gunicorn CMD ["gunicorn", "--workers=9", "-b", "0.0.0.0:5000", "web_server:app"]
Проблема:
Затупила одная функция (выдает результат за 20 сек), как следствие затупил весь сервис.
Что мне нужно узнать (из технологий, настроек) для избежания данных проблем?
 Maxim
В частности celery. Но на нём свет клином не сошёлся.
Tishka17
любая технология на очередях, да
Vovan
Спасибо!
 Kirill
У меня задачи специфические. Мне скорость разработки важнее, чем консистентность данных, которые обеспечивает постгрис.
Все ж реально на монге сильно быстрее прототипы делать. А ME пробовали? Документацию его смотрю, выглядит вроде нормально. Но в нескольких темах на реддите видел, что народ ругает сильно его.
Ты FastAPI только в синхронном режиме будешь использовать? Т.к. MongoEngine только синхронная. Если же тебе нужен asyncio, то тебе только motor (по сути асинхронная обёртка поверх pymongo).
А в MongoEngine реально есть косяки, и довольно серьёзные. Если для одного из них не сделать workaround то рискуешь терять данные из-за конкуретного обновления документов.
Я уже 8 лет на проекте с монгой и скажу что у неё только один весомый плюс перед другими DB - это очень простое шардирование из коробки. И всё, больше весомых плюсов нет. Schemaless - это не плюс, это просто особенность, которая чаще всего будет только мешать и требовать лишних телодвижений и кода.
 Юра
Как узнать id телеграмм чата?
Пишу сообщение в общий чат, бот мне в лс, кто знает как исправить?
 c
Как узнать id телеграмм чата?
Пишу сообщение в общий чат, бот мне в лс, кто знает как исправить?
отвечать не юзеру, а в чат
Юра
так и делаю в чат приходит это 778857928 вместо сообщения
 Андрей
у чатов ид отрицательный же
 Max
Ты FastAPI только в синхронном режиме будешь использовать? Т.к. MongoEngine только синхронная. Если же тебе нужен asyncio, то тебе только motor (по сути асинхронная обёртка поверх pymongo).
А в MongoEngine реально есть косяки, и довольно серьёзные. Если для одного из них не сделать workaround то рискуешь терять данные из-за конкуретного обновления документов.
Я уже 8 лет на проекте с монгой и скажу что у неё только один весомый плюс перед другими DB - это очень простое шардирование из коробки. И всё, больше весомых плюсов нет. Schemaless - это не плюс, это просто особенность, которая чаще всего будет только мешать и требовать лишних телодвижений и кода.
Оказывается сама монга выпустила что-то очень похожее на MongoEngine:
https://github.com/mongodb/pymodm, попробую это
Да, мне FastAPI только в синхроне и надо.
В моих проектах у монги есть преимущество:
1) Мне не нужны транзакции. А в PostgreSQL иногда я натываюсь на проблемы с транзакциями, когда при попытке что-то записать получается ошибка, что сессия с ошибкой нужно делать роллбек.
2) Все мои данные они реально лучше ложатся в концепцию коллекций. Когда есть документы с вложенными документами. Понятно что и в постгресе можно забабахать все на JSONB, но нормализацию таблиц уже из головы мне не вытащить, и в результате когда я с посгрисом работаю, у меня много таблиц и запросы потом получаются сложные.
3) Мне в моих проектах очень важна скорость разработки. Я понимаю, что с всякими alembic миграции для постгриса можно генерить автоматом. Но все равно какие-то мелочи есть, которые руками приходитсяс прописывать. Например алембик сам не удаляет в миграциях автоматом созданные типы, надо руками прописать.
И да, я согласен что Schemaless это нифига не плюс. Все равно у меня есть модели. И как раз эти schemaless это и есть причина, почему я иногда возвращаюсь к постгресу. Боюсь на монге данные потерять. Но по факту, за много лет у меня в проекте на монге я ни разу не накосячил и данные не потерял.
А не появилась ли в монге система человеческих ошибок на схемы? Там уже давно есть возможность, для коллекций задавать жесткую схему. Вот только проблема в том, что ошибки там бесполезные. Т.е. при попытки записать невалидный документ, монга кидала ошибку без деталей в чем именно проблема. Может в новой 4.4 версии сделали нормаьные сообщения об ошибках?
Юра
bot.send_message(message.chat.id, message.from_user.id,...
Tishka17
"иногда я натываюсь на проблемы с транзакциями"
не транзакция, нет проблем? серьезно?
если у тебя конфликт транзакций, это может быть вполне нормальной ситуацией. В любом случае есть же всякие on conflict do...
Андрей
Kirill
Оказывается сама монга выпустила что-то очень похожее на MongoEngine:
https://github.com/mongodb/pymodm, попробую это
Да, мне FastAPI только в синхроне и надо.
В моих проектах у монги есть преимущество:
1) Мне не нужны транзакции. А в PostgreSQL иногда я натываюсь на проблемы с транзакциями, когда при попытке что-то записать получается ошибка, что сессия с ошибкой нужно делать роллбек.
2) Все мои данные они реально лучше ложатся в концепцию коллекций. Когда есть документы с вложенными документами. Понятно что и в постгресе можно забабахать все на JSONB, но нормализацию таблиц уже из головы мне не вытащить, и в результате когда я с посгрисом работаю, у меня много таблиц и запросы потом получаются сложные.
3) Мне в моих проектах очень важна скорость разработки. Я понимаю, что с всякими alembic миграции для постгриса можно генерить автоматом. Но все равно какие-то мелочи есть, которые руками приходитсяс прописывать. Например алембик сам не удаляет в миграциях автоматом созданные типы, надо руками прописать.
И да, я согласен что Schemaless это нифига не плюс. Все равно у меня есть модели. И как раз эти schemaless это и есть причина, почему я иногда возвращаюсь к постгресу. Боюсь на монге данные потерять. Но по факту, за много лет у меня в проекте на монге я ни разу не накосячил и данные не потерял.
А не появилась ли в монге система человеческих ошибок на схемы? Там уже давно есть возможность, для коллекций задавать жесткую схему. Вот только проблема в том, что ошибки там бесполезные. Т.е. при попытки записать невалидный документ, монга кидала ошибку без деталей в чем именно проблема. Может в новой 4.4 версии сделали нормаьные сообщения об ошибках?
Ну смотри сам, я за 8 лет много раз плевался на эту многу и хотелось перейти на Postgres. Но поскольку было уже несколько продакшен стендов, то не было особо времени изучить этот вопрос, понять какие реально плюсы будут, которые смогут перевесить возможность шардирования.
За это время у меня уже "стокгольмский синдром" выработался. Я просто уже привык к этой монге и к тому, что надо постоянно ожидать от неё подвоха и подкладывать везде соломку.
Tishka17
я так и не придумал зачем мне монга
Tishka17
вот еластик и кликхаус я понимаю зачем
Tishka17
и редис понятно зачем
Tishka17
а зачем монга - хз
Max
"иногда я натываюсь на проблемы с транзакциями"
не транзакция, нет проблем? серьезно?
если у тебя конфликт транзакций, это может быть вполне нормальной ситуацией. В любом случае есть же всякие on conflict do...
Понятно что есть всякие on conflict и все можно решить. Но по факту я имею следующее:
1) Иногда мой проект на PostgreSQL может оказаться неработающим. Что где-то я накосячил с сессиями и из-за того что случилась ошибка и не было rollback-а, все перестает работать.
2) А монга она простая и ей все пофигу. Если где-то в одном потоке была проблема, то в другом потоке если запрос валидный, то все выполнится полюбому.
Tishka17
хз что там косячить с сессиями. вылез конфликт там,где не ожидался - вывалился из текущего таска, при выходе откатил всё
Kirill
Оказывается сама монга выпустила что-то очень похожее на MongoEngine:
https://github.com/mongodb/pymodm, попробую это
Да, мне FastAPI только в синхроне и надо.
В моих проектах у монги есть преимущество:
1) Мне не нужны транзакции. А в PostgreSQL иногда я натываюсь на проблемы с транзакциями, когда при попытке что-то записать получается ошибка, что сессия с ошибкой нужно делать роллбек.
2) Все мои данные они реально лучше ложатся в концепцию коллекций. Когда есть документы с вложенными документами. Понятно что и в постгресе можно забабахать все на JSONB, но нормализацию таблиц уже из головы мне не вытащить, и в результате когда я с посгрисом работаю, у меня много таблиц и запросы потом получаются сложные.
3) Мне в моих проектах очень важна скорость разработки. Я понимаю, что с всякими alembic миграции для постгриса можно генерить автоматом. Но все равно какие-то мелочи есть, которые руками приходитсяс прописывать. Например алембик сам не удаляет в миграциях автоматом созданные типы, надо руками прописать.
И да, я согласен что Schemaless это нифига не плюс. Все равно у меня есть модели. И как раз эти schemaless это и есть причина, почему я иногда возвращаюсь к постгресу. Боюсь на монге данные потерять. Но по факту, за много лет у меня в проекте на монге я ни разу не накосячил и данные не потерял.
А не появилась ли в монге система человеческих ошибок на схемы? Там уже давно есть возможность, для коллекций задавать жесткую схему. Вот только проблема в том, что ошибки там бесполезные. Т.е. при попытки записать невалидный документ, монга кидала ошибку без деталей в чем именно проблема. Может в новой 4.4 версии сделали нормаьные сообщения об ошибках?
С таблицами и JSONB в простгресе очень удобное приавло можно взять на вооружение, что бы решить, что надо в колонки, а что в JSONB. Если поле есть не во всех документах, его не нужно индексировать, не надо по нему какие-то сложные запросы с условиями - то это кандидат на запихивание в JSONB. Хотя даже если надо индесировать - в постгре гораздо больше возможностей сделать это с JSONB, чем в монге.
A
можно fsync отключить и будет как в mongodb
A
быстро, но ненадежно
Max
Ну смотри сам, я за 8 лет много раз плевался на эту многу и хотелось перейти на Postgres. Но поскольку было уже несколько продакшен стендов, то не было особо времени изучить этот вопрос, понять какие реально плюсы будут, которые смогут перевесить возможность шардирования.
За это время у меня уже "стокгольмский синдром" выработался. Я просто уже привык к этой монге и к тому, что надо постоянно ожидать от неё подвоха и подкладывать везде соломку.
У меня проекты все считай они как MVP. Т.е. раз в неделю делается новый проект, тестируется идея, и в 99% случаев проект выкидывается в помойку.
В 1% проект работает пару недель. Я всегда на монге такие проекты делал, и горя не знал.
Но тут не было никаких важных работ и я от скуки начал все на постгрисе делать.
Я считаю что постгря подходит когда:
- проект будет жить больше года
- проект разрабатывает больше 1 челоека
- данные важны
А вот монга она лучше подходит когда:
- проект будет жить очень мало
- только один разработчик
- скорость разработки важнее надежности данных
Kirill
а зачем монга - хз
Для шардирования. 😊
Это просто красота какая-то. Вот прибежало в сервис куча нового народа, всё тормозит, база не вытягивает. А ты за пару часов поднял рядом новую шарду монги, данные по ней автоматом растеклись и у тебя всё работает отлично, на каждой шарде нагрузка в 2 раза меньше, чем была на одной.
Tishka17
Для шардирования. 😊
Это просто красота какая-то. Вот прибежало в сервис куча нового народа, всё тормозит, база не вытягивает. А ты за пару часов поднял рядом новую шарду монги, данные по ней автоматом растеклись и у тебя всё работает отлично, на каждой шарде нагрузка в 2 раза меньше, чем была на одной.
ага, без отношений конечно легко шардировать
Tishka17
вот только я не уверен что могу без отношений базу спроектировать
Kirill
ага, без отношений конечно легко шардировать
Ну само собой, там не только это "между строк" спрятано. 😊
Надо изначально код писать с учётом шардирования данных. Просто так, любое приложение в шарды не запихаешь.
Tishka17
Для шардирования. 😊
Это просто красота какая-то. Вот прибежало в сервис куча нового народа, всё тормозит, база не вытягивает. А ты за пару часов поднял рядом новую шарду монги, данные по ней автоматом растеклись и у тебя всё работает отлично, на каждой шарде нагрузка в 2 раза меньше, чем была на одной.
скорее всего при шардировани нагрузка будет на каждый шард такая же же как на один, так как выборки будут не только по ключу
 Alex
ага, без отношений конечно легко шардировать
На другом форуме как-то видел чудика который утверждал что отношения не нужны и вообще это главная проблема при проектировании и работе с БД и nosql БД это отличное решение проблемы. Я хз если он это говорил на полном серьезе или троллил.
Kirill
скорее всего при шардировани нагрузка будет на каждый шард такая же же как на один, так как выборки будут не только по ключу
Там офигенный выигрыш за счёт размера данных и индексов. На одной шарде просто всё это не влезет в достаточном объёме в кеш в оперативе . А на двух шардах будет в два раза меньше данных и индексы будут меньше. Это даёт большой прирост скорости.
Kirill
"Не ссы, я уже так делал" - на одном продакшене как раз была такая ситуация с кучей новых юзеров и не влезанием индексов одной шарды в оперативу.
Kirill
На другом форуме как-то видел чудика который утверждал что отношения не нужны и вообще это главная проблема при проектировании и работе с БД и nosql БД это отличное решение проблемы. Я хз если он это говорил на полном серьезе или троллил.
Всяко троллил. Или наивно заблуждался в своём неведении. Наверное не писал сложных билинговых штук, которые с деньгами работают. Там бы быстро ему сделали строгий выговор в грудную клетку, за потерю данных или их консистентности.
Tishka17
мы это решали вынесением в эластик части данных
Tishka17
работает поиск круче, возможностей больше
Tishka17
а в постгресе только работа по PK
A
zombodb никто еще не пробовал?
Tishka17
Это была отдельная база товаров для сайта, слабо связанная с тем, что происходит на складе
Anonymous
Есть файл на сервере, который работает на Flask. Как можно получить путь к этому файлу с сервера для передачи его в печать? Его нужно загружать?
Tishka17
эм
Tishka17
как синхронизировали?
по сути схема была такая:
1. отдеьный сервис работающий со складом со своей базой. Все изменения оттуда прилетали через очередь
2. отдельный сервис работающий с заказами со своей базой, мы ему отсылали данные, он потом как-то связан был со складом и занимался платежами и возвратами всякими
3. отдельный бэк сайта умеющий поиски, хитрую навигацию, работающий с сервисом заказов, корзиной и т.п.
Alex
Всяко троллил. Или наивно заблуждался в своём неведении. Наверное не писал сложных билинговых штук, которые с деньгами работают. Там бы быстро ему сделали строгий выговор в грудную клетку, за потерю данных или их консистентности.
Еще приколюху вспомнил - как-то собеседовался в одну фирму которая писала что-то вроде ЦРМ для ЖКХ служб. Учет платежей, расходы и пр. Мне их лид рассказал что монга у них основная БД. "Вроде работает, но вот джоины делать трудно" XD
Tishka17
по сути у склада куча свой логики связанной с обслуживанием товаров там, которая сайту не нужна и не интересна.