выглядит так что нат хреново настроен в облаке, когда ты из внути периметра ломишься на свойже внешний адрес оно не понимает куда тебя роутить
я тоже об этом думаю, пытаюсь понять, что докинуть
 Kirill


 Grek 🇺🇦
Hairpin NAT
 Alexander
traceroute to dev..ru (185.247.194.164), 30 hops max, 60 byte packets
1 185.247.194.164 (185.247.194.164) 0.191 ms 0.164 ms 0.172 ms
У тебя на этом же хосте, случайно, NAT не настроен?
Grek 🇺🇦
https://lantorg.com/article/kak-zajti-po-vneshnemu-ip-adresu-iz-lokalnoj-seti-dlya-mikrotik
вот что-то типа такого сделать надо
 Vladimir
Это весь?
некоторые провайдеры скрывают инфраструктуру свою) особенно если там что-то сложное, чтоб людей не беспокоить. Поэтому бывает совсем весело в виде абсолютно пустых трейсраутов
Vladimir
но надо по хорошему знать что конкретное облако делает чтобы понять что не так пошло и где
Alexander
некоторые провайдеры скрывают инфраструктуру свою) особенно если там что-то сложное, чтоб людей не беспокоить. Поэтому бывает совсем весело в виде абсолютно пустых трейсраутов
Там один хоп, а значит сайт на defgw висит. Что там по L2 наверчено в промежутке, уже неважно.
Kirill
мне отдали проект такой
Kirill
сейчас поищу, что сделать можно с Hairpin
Alexander
тут уже был днат
Проверь правила файрвола и удостоверься, что DNAT настроен на работу также изнутри, а не только для трафика, приходящего снаружи.
Kirill
ок, спасибо
Kirill
всем спасибо)
Vladimir
Там один хоп, а значит сайт на defgw висит. Что там по L2 наверчено в промежутке, уже неважно.
в зависимости от хостера может быть и не так
Vladimir
но если был nat, то смотреть действительно на нем правильно
Kirill
кажется заработало, сейчас погляжу еще
Kirill
да, божечки, да. Оно заработало
Kirill
спасибо большое я вас люблю. Пусть у вас всех все будет хорошо
Kirill
 #Rλatan
не вижу варианта "всегда светлая"
Вопрос конечно так себе, но светлая тема в солнечный единственный верный шаг хоть что то увидеть
 Andrey
Привет всем! Здесь ведь можно будет задать вопрос не совсем про девопс? (замечал, что здесь могут обсуждать просто вопросы ОС и железа)
Если ближе к делу: есть железный сервер с ОС debian jessie 8.2
uname -a
Linux 3.16.0-4-amd64 #1 SMP Debian 3.16.7-ckt20-1+deb8u1 (2015-12-14) x86_64 GNU/Linux
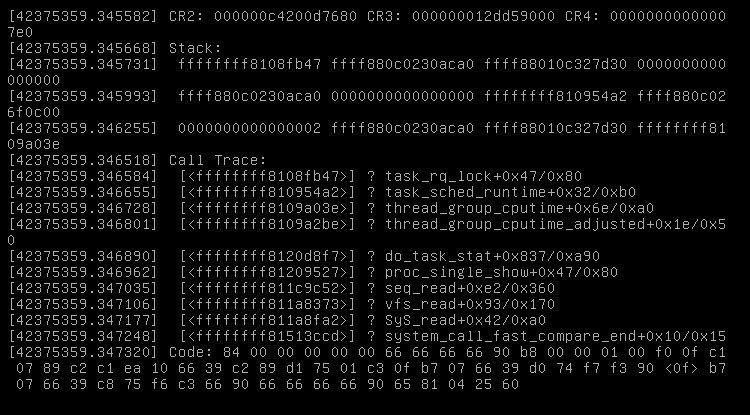
На сервере запущено довольно много сервисов (Elasticsearch, впн, докер (storage driver - aufs) контейнеры с сервисами). Сервер жил не тужил до недавнего времени. Периодически (за 2 недели это второе падение) он стопается наглухо. Есть скриншот call trace при первом падении .
Начал разбираться, при втором падении были следующая ситуация:
- в 22:20 сервер упал (отрапортовала система мониторинга + плюс отсутствие метрик с этого периода)
- по логам сервера (syslog, kern.log) сервер еще жил до 22:32 (писались логи докера, типа kernel: docker0: port 15(veth63b10e9) entered disabled state)
- в atop последние данные только за 22:20
- по метрикам никаких аномалий нету (метрики хоста, контейнеров, эластика). Сервер выполняет чисто служебные роли (на sata-диски конечно идет высокая нагрузка на запись из-за эластика, но так уже живем несколько лет (это только при мне, а так мб и дольше))
У нас как-то относительно была похожая ситуация с другим сервером (но там вроде в консоли были другие ошибки). Обновились до stretch и уже больше месяца, тьфу-тьфу, проблем нет. Чем руководствовались, что обновление может помочь? На сервере стоял докер c aufs, хотели посмотреть что будет когда станет overlay2))
Память на том другом сервере тестили только из под ОС (но старались в момент тестов все сервисы тушить, чтобы проверить максимальное кол-во памяти) - всё было OK.
Также все сервера в md-рэйде (1), смарты дисков конечно проверяли.
Следовательно есть несколько вопросов:
- как бы далее пытались понять, что с сервером мб не так? (снять дамп ядра - у меня не хватит навыков его прочитать и понять).
Обновить-то обновим, проблема может быть уйдет, но причина так и останется неясной. Сервер длительное время работал без проблем.
- ниже есть скриншот консоли в момент ошибки. Для меня малоинформативно. Есть подозрение, что когда смотрим в консоль через ipmi, мы просто не видим части информации (экран и так маленький, и всю важная инфа вполне могла быть просто промотана). Возможно ли вывод экрана физической консоли перенаправлять куда-либо? Погуглил обзорно, но что-то ничего не нашел. Если бы было это возможно, вполне вероятно, ошибка была до этого call trace с более ясным описанием.
Andrey
 Vladimir
но если "работало-работало и вдруг само сломалось" и никаких изменения нет - то с хорошей вероятностью железная проблема будет (например ошибки памяти, если память ECC и процессор умеет в edac, послидет за ce и ue каунтерами в /sys, нужный путь ищется по `find /sys -name '*edac'`)
Vladimir
либо что-то начало триггерить баг в ядре, потому что 3.16 это прям очень древнее
Vladimir
собственно если баг в ядре - трейсы скорее всего будут одинаковыми, если память - трейсы при панике будут разные, а также можно потенциально будет (если очень повезет или наоборот, неповезет) видеть бит-флипы в записях в базу или в файлы
Vladimir
но последнее уже как повезет
Andrey
ага, спс. Про netconsole посмотрим. Edac у нас мониторится (но поэтому серверу, да, походу упустили эту проверку)
Vladimir
ага, спс. Про netconsole посмотрим. Edac у нас мониторится (но поэтому серверу, да, походу упустили эту проверку)
можно ручками посмотреть после энного времени аптайма, ну так чисто чтоб понять что и как там
Andrey
ls -1 /sys/devices/system/edac/mc/mc0/csrow1/
ce_count
ch0_ce_count
ch0_dimm_label
ch1_ce_count
ch1_dimm_label
ch2_ce_count
ch2_dimm_label
ch3_ce_count
ch3_dimm_label
dev_type
edac_mode
mem_type
power
size_mb
subsystem
ue_count
uevent
вы прямо смотрите счетчики ue_count и ce_count? Я просто когда-то при добавлении проверки делал так: grep "[0-9]" /sys/devices/system/edac/mc/mc*/csrow*/ch*_ce_count, т.е. смотрел чуть другое. Или это в принципе одно и тоже?
Vladimir
ls -1 /sys/devices/system/edac/mc/mc0/csrow1/
ce_count
ch0_ce_count
ch0_dimm_label
ch1_ce_count
ch1_dimm_label
ch2_ce_count
ch2_dimm_label
ch3_ce_count
ch3_dimm_label
dev_type
edac_mode
mem_type
power
size_mb
subsystem
ue_count
uevent
вы прямо смотрите счетчики ue_count и ce_count? Я просто когда-то при добавлении проверки делал так: grep "[0-9]" /sys/devices/system/edac/mc/mc*/csrow*/ch*_ce_count, т.е. смотрел чуть другое. Или это в принципе одно и тоже?
я последний раз скрипты на edac писал лет 6 назад ) тогда я смотрел прямо по ch'ам и mc и даже заморочился для того железа которого было много сделать соответствие dimm_label -> маркировка на материнке
Vladimir
но как самое базовое можно смотреть на ce_count и ue_count, там вроде бы всегда сумма для этого контроллера
 Vlad
Привет коллегам! Сегодня столкнулся с проблемой установки prometheus в docker на Ubuntu Server 18.04
Vlad
Контейнер успешно создался но не запустился. Чекнул внутри контейнера логи. Ошибка msg="Error opening query log file" file=/data/prometheus/queries active err="open /data/prometheus/queries.active: permission denied"
panic: Unable to create mmap-ed active query log
Vlad
Может кто сталкивался и сможет помочь?
 Roman
[XFS SUMMIT] Deprecating V4 on-disk format
 Dmitriy 🇷🇺🇬🇪🇪🇸
пермишны проверил?
 George
Контейнер успешно создался но не запустился. Чекнул внутри контейнера логи. Ошибка msg="Error opening query log file" file=/data/prometheus/queries active err="open /data/prometheus/queries.active: permission denied"
panic: Unable to create mmap-ed active query log
у тебя озу часом не 512 мб на сервере?
Anonymous
Шутки шутками, а у меня фронтенд на реакте один случай из десяти не билдится, потому что 4 Гб ОЗУ мало
Yuriy
Шутки шутками, а у меня фронтенд на реакте один случай из десяти не билдится, потому что 4 Гб ОЗУ мало
Ахахах...это ты ещё Ангуляр 9 не билдил...ему и 6Гб иногда бывает мало🤣
 Dmitry
Ахахах...это ты ещё Ангуляр 9 не билдил...ему и 6Гб иногда бывает мало🤣
а если Dockerfile написал фронтендер то и образ так будет весить =)
 DjinN
Шутки шутками, а у меня фронтенд на реакте один случай из десяти не билдится, потому что 4 Гб ОЗУ мало
Полюсую всеми ногами. Я офигел когда 8гб рамы не хватало чтобы 2 сборки паралельно сделать
Anonymous
а если Dockerfile написал фронтендер то и образ так будет весить =)
Посоветуйте как написать лучше)
Dmitry
Посоветуйте как написать лучше)
копировать в итоговый образ только собранное приложение. А не node_modules и всякие временные файлы сборки
Anonymous
копировать в итоговый образ только собранное приложение. А не node_modules и всякие временные файлы сборки
Ну это никак не влияет на потребляемую ОЗУ во время сборки, а вообще у меня мультистейдж билд, в последнюю стадию копируется только артефакт, правда я не знаю где при этом остаётся node_modules O_o
Dmitry
Ну это никак не влияет на потребляемую ОЗУ во время сборки, а вообще у меня мультистейдж билд, в последнюю стадию копируется только артефакт, правда я не знаю где при этом остаётся node_modules O_o
ну я про ОЗУ и не говорил. только про объем образа. А что там с ОЗУ это к webpack вопросы и его плагинам
Anonymous
ну я про ОЗУ и не говорил. только про объем образа. А что там с ОЗУ это к webpack вопросы и его плагинам
Фронтендер захотел CRA, а не webpack
Dmitry
Фронтендер захотел CRA, а не webpack
точнее не осилил webpack, а заюзал create-react-app ? Но в итоге там один фиг webpack. Просто готовые конфиги генерит, но если, потребуется кастомизировать, все равно придется допиливать
Kirill
всем привет, кто сталкивался с `ERROR: tuple concurrently updated`` в постгре? достался мне джаббер сервер с постгрей и сегодня он выпал в осадок с такими сообщениями в постгре
Andrii
всем привет, есть docker-compose.yml в каталог подкладывается дамп бд который разворачивается, после этого контейнер останавливается и делается архив файлов, как дождаться готовности контейнера, что дамп залился и можно останавливать контейнер, сейчас делаю в bash через sleep какое-то время, но это костыль, может быть есть какое-то лучшее решение?
 Aleksey
Коллеги вы используете keepass ? а где храните файл с данными ?
Я сейчас использую dropbox но он чот начал меня ограничивать по колву устройств и я задумался выбросить его. От дропбокса мне нужно только хранить файл на ~1 мегабайт.
К файлу хочу иметь доступ с андройда, линукса и форточки.
M
используй некстклауд))) он какашка
M
а шо гугл диск или яндекс диск уже не чишо
 Aragaer
я использую pass, а в нем встроенная работа с гитом. И на битбакете приватный репозиторий
Aleksey
я использую pass, а в нем встроенная работа с гитом. И на битбакете приватный репозиторий
окей спасибо что поделились
Aragaer
всегда пожалуйста
Aleksey
@pro_git
Alexander
Но, вообще, я бы посоветовал переехать на pass :)
Aleksey
Попробуй syncthing
селфхостед весь я отметаю ибо эта та часть инфры которая должна быть мне не подконтрольна.
Andrii
Хелсчек ?
всем привет, можно как-то, что бы после разворачивания бд дампа через docker-compose или docker, останавливался контейнер?
т.е. мне надо развернуть дамп в контейнере и потом его остановить и файлы заархивировать
пытался вот так сделать через docker-compose
version: '2.1'
services:
db:
image: postgres:9.6-alpine
healthcheck:
test: nc localhost 5532 || exit 1
container_name: postgres
restart: always
ports:
- '127.0.0.1:5532:5432'
environment:
POSTGRES_USER: ${POSTGRESQL_USER}
POSTGRES_PASSWORD: ${POSTGRESQL_PASSWORD}
POSTGRES_DB: ${POSTGRESQL_DATABASE}
volumes:
- "/opt/dump/postgres:/docker-entrypoint-initdb.d"
- "pg_data:/var/lib/postgresql/data"
volumes:
pg_data:
driver: local
не останавливается, а с
test: netstat -an | grep :5532 > /dev/null; if [ 0 != $? ]; then exit 1; fi;
вообще не запускается
ERROR: Invalid interpolation format for "healthcheck" option in service "db": "netstat -an | grep :5532 > /dev/null && if [ 0 != $? ]; then exit 1; fi;"
George
он тебе написал
George
слишком сложно сделал и неправильно
George
во-первых, не 5532, а 5432
George
во-вторых, доку посмотри - там проще делают
Andrii
test: [“CMD-SHELL”, “pg_isready -U postgres”]
?
Aleksey
Коллеги вы используете keepass ? а где храните файл с данными ?
Я сейчас использую dropbox но он чот начал меня ограничивать по колву устройств и я задумался выбросить его. От дропбокса мне нужно только хранить файл на ~1 мегабайт.
К файлу хочу иметь доступ с андройда, линукса и форточки.
я открыл для себя rclone. видимо дропбокс пока пока
Aleksey
на gdrive
Aleksey
не вижу лучшего общего знаменетеля между системами