Всем привет. ребят как вы делаете бэкап?
mongodump
 Denis


 Arystan
в ручную? или крон?
 Aleksey
не ну если не лень то можно и в ручную. главное будильник завести
Aleksey
а по существу - если боргом бекапать - то лучше без -gzip дампить, больше места занимает бекап, но дедупликация помогает. если просто кудато синкать бекапы - то -gzip хорошо их жмет
 Alexandr
Доброго дня, уважаемые. ПОдскажите пожалуйста, как проверить, работает ли шардинг? На данный момент имеется 3 сервера. sh.status() выдает { "_id" : "z3x", "primary" : "repl2", "partitioned" : true, "version" : { "uuid" : UUID("235518db-40d3-44ad-a809-e1e0bff06105"), "lastMod" : 1 } }
z3x.files.chunks
shard key: { "files_id" : 1, "n" : 1 }
unique: false
balancing: true
chunks:
repl2 1
{ "files_id" : { "$minKey" : 1 }, "n" : { "$minKey" : 1 } } -->> { "files_id" : { "$maxKey" : 1 }, "n" : { "$maxKey" : 1 } } on : repl2 Timestamp(1, 0)
Alexandr
На пробу залили 60 гигов данных собранных mongodump'ом. Только на самом repl2 ничего не поменялось
Aleksey
db.tablename.getShardDistribution()
Aleksey
что показывает для нужной коллекции?
Alexandr
таблица - это коллекция?
Aleksey
ой) извините, да, конечно коллекция
Alexandr
я кажется что-то таки сделал и теперь картина выглядит так: { "_id" : "z3x", "primary" : "repl2", "partitioned" : true, "version" : { "uuid" : UUID("235518db-40d3-44ad-a809-e1e0bff06105"), "lastMod" : 1 } }
z3x.files.chunks
shard key: { "files_id" : 1 }
unique: false
balancing: true
chunks:
repl1 1
repl2 3
repl3 1
{ "files_id" : { "$minKey" : 1 } } -->> { "files_id" : ObjectId("5ef5af4b8dc9d6217ca6b85f") } on : repl1 Timestamp(2, 0)
{ "files_id" : ObjectId("5ef5af4b8dc9d6217ca6b85f") } -->> { "files_id" : ObjectId("5efef84b9724894078cee6c2") } on : repl3 Timestamp(3, 0)
{ "files_id" : ObjectId("5efef84b9724894078cee6c2") } -->> { "files_id" : ObjectId("5efeffb49724894078cee6d6") } on : repl2 Timestamp(3, 2)
{ "files_id" : ObjectId("5efeffb49724894078cee6d6") } -->> { "files_id" : ObjectId("5f035b029724894078cee6f5") } on : repl2 Timestamp(3, 3)
{ "files_id" : ObjectId("5f035b029724894078cee6f5") } -->> { "files_id" : { "$maxKey" : 1 } } on : repl2 Timestamp(3, 4)
Alexandr
db.files.chunks.getShardDistribution()
Shard repl3 at repl3/mw3.whoiszed.tv:27000
data : 84KiB docs : 6 chunks : 1
estimated data per chunk : 84KiB
estimated docs per chunk : 6
Shard repl2 at repl2/mw2.whoiszed.tv:27000
data : 2.9GiB docs : 416 chunks : 3
estimated data per chunk : 993.17MiB
estimated docs per chunk : 138
Shard repl1 at repl1/mw1.whoiszed.tv:27000
data : 1.69GiB docs : 253 chunks : 1
estimated data per chunk : 1.69GiB
estimated docs per chunk : 253
Totals
data : 4.6GiB docs : 675 chunks : 5
Shard repl3 contains 0% data, 0.88% docs in cluster, avg obj size on shard : 14KiB
Shard repl2 contains 63.2% data, 61.62% docs in cluster, avg obj size on shard : 7.16MiB
Shard repl1 contains 36.79% data, 37.48% docs in cluster, avg obj size on shard : 6.85MiB
Alexandr
Значит всетаки получилось?
Aleksey
да, но чтото не похоже это на 60 гигов данных
Aleksey
675 документов всего
Aleksey
1.69GiB очень жирные чанки - они мигрировать не смогут
Aleksey
sh.status(true) покажите
Aleksey
там jumbo наверное стоит у всех чанков
Alexandr
так я заново mongorestore запустил
Alexandr
причем после запуска мне удалось выполнить sh.shardCollection("z3x.files.chunks", { files_id : 1} )
Aleksey
причем после запуска мне удалось выполнить sh.shardCollection("z3x.files.chunks", { files_id : 1} )
ну без этого шардирование бы и не началось)
Alexandr
т.е. я до первой попытки развернуть дамп выолнял sh.shardCollection("z3x.files.chunks", { files_id : 1, n : 1 } ) и у меня как раз была та картина как писал в начале
Alexandr
потом решил сделать sh.shardCollection("z3x.files.chunks", { files_id : 1} ), на что увидел ошибку, что шардинг уже инициализирован и делать ничего не будем.
Alexandr
Остановил заливку данных, подождал (в надежде на то, что может данные как-то распределятся. Но нет. Тогда снова запустил и выполнил sh.shardCollection("z3x.files.chunks", { files_id : 1} ) - ошибки небыло и пошел шардинг.
Alexandr
Может есть где нормально почитать про монгу?
Aleksey
Может есть где нормально почитать про монгу?
про шардирование довольно много статей
http://linux-notes.org/replikatsiya-v-mongodb/
https://habr.com/ru/post/335698/
Aleksey
потом решил сделать sh.shardCollection("z3x.files.chunks", { files_id : 1} ), на что увидел ошибку, что шардинг уже инициализирован и делать ничего не будем.
сменить кортеж ключа шардирования можно только в 4.4+ версии и только добавляя в кортеж ключи
Aleksey
т.е. я до первой попытки развернуть дамп выолнял sh.shardCollection("z3x.files.chunks", { files_id : 1, n : 1 } ) и у меня как раз была та картина как писал в начале
наверное просто не успел балансер насоздавать чанков. он не сразу начинает нарезку. кроме того если я правильно понял у вас довольно крупного размера документы
Aleksey
вот такой командой можно менять размер чанка
db.settings.save( { _id:"chunksize", value: 64 } )
Aleksey
ну и надо подбирать ключ шардирования таким образом чтобы обеспечить высокую гранулированость чанков.
Alexandr
ну и надо подбирать ключ шардирования таким образом чтобы обеспечить высокую гранулированость чанков.
что есть "гранулированность"?
Alexandr
в базе лежат фильмы. Всего на данный момент более 600 гигов.
Alexandr
вот взяли 3 сервера по 2 терабайта и пытаемся туда перетащить всё хозяйство. Потом добавим еще 3 для репликации
Alexandr
сейчас идея такая: сделали дамп (перед выходными), разворачиваем с mongorestore. Далее хотим запустить на одной из новых машин mongodump —host —port | mongorestore чтобы дотянуть, чего там на выходных наплодили.
Alexandr
про шардирование довольно много статей
http://linux-notes.org/replikatsiya-v-mongodb/
https://habr.com/ru/post/335698/
С той статьи на хабре я начал. Даже с автором пообщался немного. Автору кстати огромное спасибо, подтолкнул в правильном направлении. Но надо будет теперь еще мои грабли описать ибо ни у автора ни в доках некторые моменты не освещены
Alexandr
а они оказались ой какими важными...
Aleksey
что есть "гранулированность"?
разряженность для ключа шардирования… не знаю как обьяснить. ну например у вас есть юзер_ид причем 90% данных заливает 2 человека - значит юзер_ид плохой ключ шардирования)
Alexandr
Aleksey
в базе лежат фильмы. Всего на данный момент более 600 гигов.
это gridfs? там один документ один фильм?
Alexandr
угу
Aleksey
а размер этого фильма?
Aleksey
ну максимальный
Alexandr
Не знаю... гига 2,5 будет наверное
Aleksey
ух. ну балансер не сможет такое смигрировать
Aleksey
те надо создать ключ шардирования, руками настроить чанки и только потом запустить рестор
Aleksey
Тогда всё размажется. Но такие фичи как добавление новых серваков с автоматическим перераспределением данных уже не заработают. ну или я не умею готовить шардирование в гридфс)
Aleksey
ну и например вывести сервер из эксплуатации тоже будет проблематично
Aleksey
возможно проще вам будет решить это шардирование на уровне приложения. ну типа за такими то фильмами на этот сервер, за такими то - на этот… миграции дампресторами
Aleksey
Не знаю... гига 2,5 будет наверное
и вообще возможно вам стоит посмотреть в сторону какого нить s3 совместимого хранилища вроде https://github.com/minio/minio
 Yerkebulan
Всем привет, как сделать фильтр массива в объекте, с условием удалить те элементы, которые равны полю каждого элемента из массива лукапа?
Андрей
Товарищи, кто-нибудь дружил удачно перконовскую монгу с лдапом? Какая-то кривизна саслауса пока непобедимая у меня.
Viktar
Господа подскажите, насколько длянна названия поля влияет на размер базы? у меня 300 млн документов. имеет ли смысл делать котроткие названия полей, что бы выйграть на размере базы?
 Nick
Господа подскажите, насколько длянна названия поля влияет на размер базы? у меня 300 млн документов. имеет ли смысл делать котроткие названия полей, что бы выйграть на размере базы?
ох, зависит от данных и соотношения размер полей/размер данных в полях. Был както давно человек, который заморочился и получил экономию в 10 или 15 процентов, точно не помню. Но глобально это повлияло лишь на общее занимаемое место, которое итак было сэкономлено за счет включенного по умолчанию сжатия на уровне БД. Данные по скорости доступов и т.п. для 10% объема считать смысла особого нет, тк всеравно все упирается операции ввода вывода
короче попробуйте, лично я не вижу в этом смысла, т.к. при любой проблеме вам нужно будет вспоминать а что за поле 'b' а что в поле 'e'
Viktar
ох, зависит от данных и соотношения размер полей/размер данных в полях. Был както давно человек, который заморочился и получил экономию в 10 или 15 процентов, точно не помню. Но глобально это повлияло лишь на общее занимаемое место, которое итак было сэкономлено за счет включенного по умолчанию сжатия на уровне БД. Данные по скорости доступов и т.п. для 10% объема считать смысла особого нет, тк всеравно все упирается операции ввода вывода
короче попробуйте, лично я не вижу в этом смысла, т.к. при любой проблеме вам нужно будет вспоминать а что за поле 'b' а что в поле 'e'
Провел эксперимент. Получилось сократить размер сжатой базы на 3%. В принципе если транслировать это на продакшн то получится экономия в 30гб. Из минусов вижу, что надо держать где то мапинг
Nick
3% это чет очень смешно, банальная фрагментация на диске сожрет больше места на накладных расходах - нет смысла думать
 Lev
Мы читали 1000 (или 10к) сущностей с монги. Оба теста на одном компе. В первом случае была просто одна нода - прочитали за 5.5 сек. Во втором - репликасет из трех нод (на том же компе, на том же диске) А проситали за 3.4. Эта как эта?
Nick
составьте нормальный план тестирования, погоняйте его хотя бы час в изолированном пространстве, потом все на графики и потом анализировать где можно улучшиться
Lev
Ну вообще чтение с нескольких нод вроде бы не должно ускоряться, я ведь верно понимаю?
Андрей
Ну вообще чтение с нескольких нод вроде бы не должно ускоряться, я ведь верно понимаю?
А у вас чтение с нескольких нод что ли?)
Nick
нет, зависит от того как именно происходит чтение, состояние сети между клиентом и репликой и самими нодами реплики, нагрузка на диски, кеширование и т.п. короче только нормальное полноценно НТ в вашем окружении на ваших данных с вашим профилем запросов ответи на вопрос как быстрее
Nick
а еще есть "шумные соседи", по типу системных прцоессов, которым захотелось чет в фоне посчитать и вся картина начинает ехать
Alexandr
Господа, а один файл на несколько гигабайт может разделиться на несколько чанков?
Alexandr
И ещё вопрос: когда настроено шардирование, имеет значение, куда я натравливаю mongorestore на mongodb или на mongos?
 Влад
Здравствуйте, подскажите пожалуйста, каким образом можно через mongoose создать запись которая удалится через заданное время? Нужно реализовать коллекцию в которой будут содержаться айдишники юзеров и время бана.
Viktar
3% это чет очень смешно, банальная фрагментация на диске сожрет больше места на накладных расходах - нет смысла думать
В моем случае есть. У меня массовый апдейт раз в три месяца. Потом только чтение. И чем больше размер базы тем больше стоимость владения. Через год по моим подсчётам будет 2 Тб база. Так что я бьюсь за каждый гигабайт
WolderVsrat
Здравствуйте, подскажите пожалуйста, каким образом можно через mongoose создать запись которая удалится через заданное время? Нужно реализовать коллекцию в которой будут содержаться айдишники юзеров и время бана.
Ищи ttl,
Вроде у монгуса параметр expire называется в индексе при создании модели, но могу ошибаться
А вообще такое на уровне самой базы настраивается в индексах, можно даже, по идее, не заморачиваться с монгусом.
Aleksey
И ещё вопрос: когда настроено шардирование, имеет значение, куда я натравливаю mongorestore на mongodb или на mongos?
Если речь о ресторе на шардируемую бд - то только монгос. Иначе можно, но сложно
Alexandr
Господа, а один файл на несколько гигабайт может разделиться на несколько чанков?
А по этому кто, что знает?..
 yopp
И ещё вопрос: когда настроено шардирование, имеет значение, куда я натравливаю mongorestore на mongodb или на mongos?
В шард все запросы происходят только через mongos, за исключением случаев когда вы обслуживаете ноды в кластере
yopp
Господа, а один файл на несколько гигабайт может разделиться на несколько чанков?
Если речь про GridFS то файлы и так делятся на чанки
Alexandr
спасибо
D
Здравствуйте, делаю distinct запроса, по полю объекта но получаю ошибку.
Distinct too big, 16mb cap
Как решить данную проблему?
 Susa
 CrusaderX
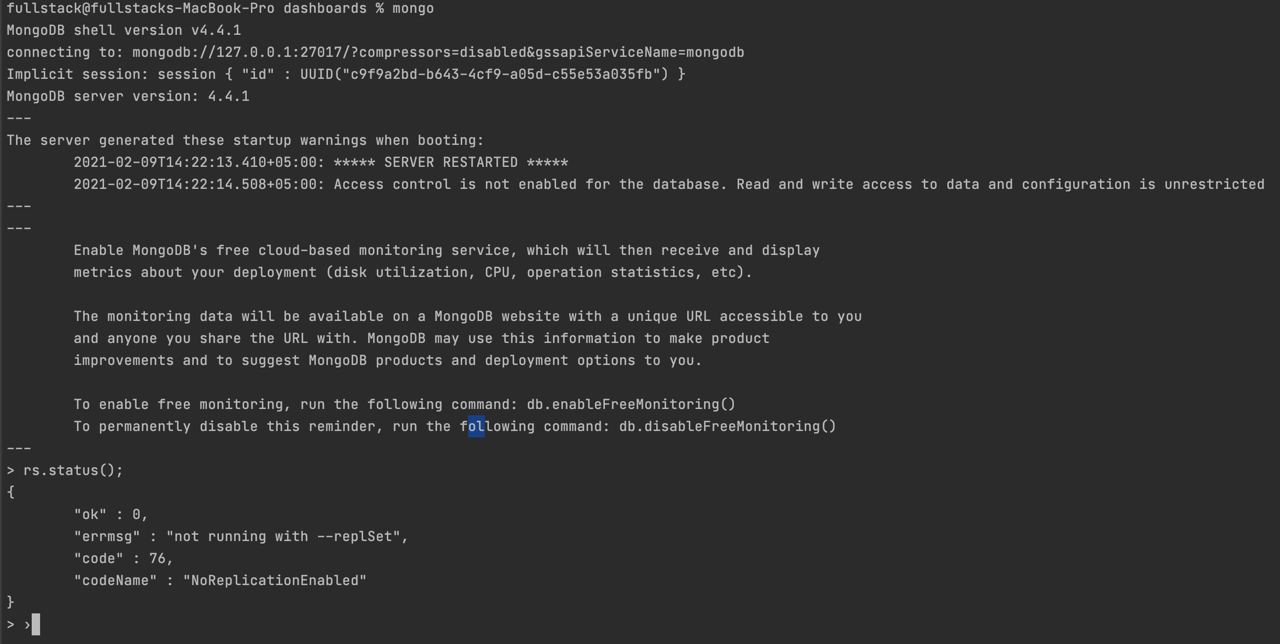
так запущена ж не в режиме реплики, а стендэлоун
 Антон
Здравствуйте, создаю индексы на массиве, при этом знаю что будет много пустых массивов при этом по ним поиска не будет, как правильно создать частичный индекс?
пробовол создать так
db.collection.createIndex({"executed_rules": 1}, {"partialFilterExpression": { "executed_rules": { "$gt": [] }}})
но планировщик не учитывает индексы и делает сканирование коллекции