 Slava


Если в монге есть коллекция, у которйо отличаются 3 поля ID, RequestID и время создания записи Created
Collection responses
```
ID primitive.ObjectID xml:"-" bson:"_id,omitempty"
RequestID primitive.ObjectID xml:"-" bson:"request_id,omitempty"
Token string xml:"-" bson:"token"
TXnID string xml:"-" bson:"TXnID"
TxnGPSDate string xml:"-" bson:"Txn_GPS_Date"
MTID string xml:"-" bson:"MTID"
TxnType string xml:"-" bson:"Txn_Type"
Created time.Time xml:"-" bson:"created"
CreatedDate string xml:"-" bson:"created_date"
CreatedString string xml:"-" bson:"created_string"
```
вопрос: можно ли написта ьзапрос который выгрузи тзапись последнюю которая была записана, при условии чт оу меня нет аргумента на руках последнее время, тогд абыло бы просто FindOne
Slava
Мне надо выгрузить респонс по 4 полям
"request_id": req.ID,
"TXnID": req.TXnID,
"token": req.Token,
"Txn_GPS_Date": req.TxnGPSDate,
плюс по полю Created он дложен быть самым свежим.
 SuleYman
а в чём разница? в теории тут курсор преобразуется в массив.
значит драйвер монго на php косячит
Тоесть когда указываю в php запросе skip(0) и limit(30) монго возвращает не все, даже не то что заявлено, через консоль отрабатывает
Slava
значит драйвер монго на php косячит
Тоесть когда указываю в php запросе skip(0) и limit(30) монго возвращает не все, даже не то что заявлено, через консоль отрабатывает
Я за это монг уи нелюблю, постгря или MySQL огонь
надо доьавлять пле времени и выгрудать последнее свежее
Он вообще зх как выгрузит 30... может с и по какую дату сработает... чтобы не было разнобоя
Slava
Мне надо выгрузить респонс по 4 полям
"request_id": req.ID,
"TXnID": req.TXnID,
"token": req.Token,
"Txn_GPS_Date": req.TxnGPSDate,
плюс по полю Created он дложен быть самым свежим.
db.collection.find( мои 4 поля ).sort({'Created':-1}).limit(1)
Мне надо самое последнее значение по полю Created, которое есть time.Time
Slava
SuleYman
как найти документ в коллекции у которого нет поля user_id? такой запрос возможен?
Slava
как найти документ в коллекции у которого нет поля user_id? такой запрос возможен?
по любых других полях
Slava
FindOne найдёт одно знаечние
Find все коу которых поле имеет значение которое укажите
Slava
и не может быть что у коллекции нет бполя ID
Это противоречит самой монге
Slava
И запрос
Slava
ибо вопрс очен абстрактный у тебя
 Sergey Bedritsky
скажите а можно ли с помощью аггрегации получить из таких документов
{
createdAt: "2020-09-01T15:48:52.390+00:00",
command: "start" // also could be "dev", "build", "generate"
}
такое
{
day: "2021-20-01",
commands: {
dev: 24512,
build: 4551,
start: 4444,
generate: 5555
}
}
Sergey Bedritsky
т/е/ чтоб сгруппировал по дням и посчитал кол-во документов с каждой command
 Nick
скажите а можно ли с помощью аггрегации получить из таких документов
{
createdAt: "2020-09-01T15:48:52.390+00:00",
command: "start" // also could be "dev", "build", "generate"
}
такое
{
day: "2021-20-01",
commands: {
dev: 24512,
build: 4551,
start: 4444,
generate: 5555
}
}
да можно, берете группировку по дате, потом $sum по $cond условиям где если правильный тип то +1
Sergey Bedritsky
Nick
dev: {$sum: {$cond: {$eq: ["$command", "dev"]}, 1, 0 }}
Nick
вроде так работало
Sergey Bedritsky
ух. пошел читать благодарю
Nick
писал по памяти, скобки точно надо проверить
Sergey Bedritsky
ругается что commands не объект аккумулятор
{
_id: '$date',
commands: {
dev: {
$sum: {
$cond: {
if: {$eq: ["$command", "dev"]},
then: 1
}
}
}
}
}
Sergey Bedritsky
оно должно быть плоско обязательно я так понимаю?
Sergey Bedritsky
так работает
{
_id: '$date',
dev: {
$sum: {
$cond: {
if: {$eq: ["$command", "dev"]},
then: 1,
else: 0
}
}
}
}
благодарю 👍
 Pan
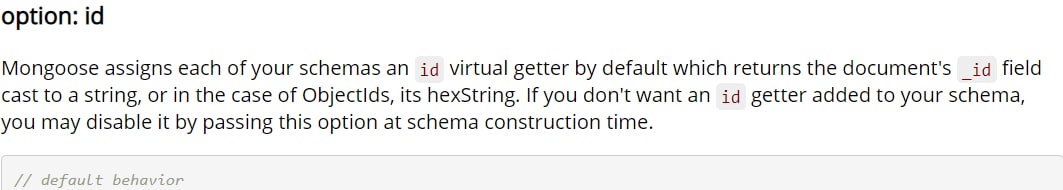
как я могу заменить _id на id в mongoose?
Pan
 Artyom
Ребят, всем привет, ошибка при дампе
Artyom
Mux ending but selectCases still open 4
Artyom
версии 4.4.2
Artyom
Может кто знает в чем проблема?
Андрей
Кто знает насколько сильно просаживает производительность auditAuthorizationSuccess: true?
 Nikolai
Mux ending but selectCases still open 4
So as I exposed the other day I have found the solution. Because I was using a kubernetes service to access my replicaset, mongodump requests were being redirected to all the members of the replicaset and not only the master one.
All I did was point mongodump directly to the master and since then all the backups have been working fine.
Hope it helps you
 AI
Народ, привет. Помогите решить сложную задачу
Есть коллекция сущностей
У каждой сущности есть рейтинг, от 1го до 10ти
Есть коллекция пользователей
Каждый пользователь может оценить сущность
Для связки есть третья коллекция с тремя полями в документе (ид пользователя, ид сущности, оценка)
Нужна выборка, предполагаю что с агрегацией
Выбрать все сущности, заджойнить таблицу связи, подсчитать среднее значения рейтинга по каждой сущности, общее количество проголосовавших, и свою оценку, если таковая уже есть..
Третий день не могу ничего путного сделать, уже глаза замылились
AI
$lookup: {
from: 'gameratings',
pipeline: [
{
$group: { _id: null, totalRated: { $sum: 1 } }
}
],
as: 'totalRated'
}Ну вот первое что я не могу понять как сделать, когда группирую общее количество проголосовавших, totalRated получа вложенным... Как его подсчитать в одно поле в корне документа?
Nick
потом сделать $project и вытащить на уровень выше
AI
Хм, попробую...
AI
А если в конвеере я хочу использовать условие выборки, где фигурирует поле из родительской и заджойненой коллекции?
{
$match: { 'коллекция2.gameId': 'коллекция1._id' }
}
D
ребят, всем привет, а как-то можно сделать выборку с null и с lte / gte? к примеру:
year: { $or: [null, { $gte: 1981 }]
 Denis
Народ, привет. Помогите решить сложную задачу
Есть коллекция сущностей
У каждой сущности есть рейтинг, от 1го до 10ти
Есть коллекция пользователей
Каждый пользователь может оценить сущность
Для связки есть третья коллекция с тремя полями в документе (ид пользователя, ид сущности, оценка)
Нужна выборка, предполагаю что с агрегацией
Выбрать все сущности, заджойнить таблицу связи, подсчитать среднее значения рейтинга по каждой сущности, общее количество проголосовавших, и свою оценку, если таковая уже есть..
Третий день не могу ничего путного сделать, уже глаза замылились
Можно и нужно обойтись без аггрегации. Просто явно «чтений» оценок будет больше чем «записей». Поэтому на каждой сущности отдельным полем висит его средний рейтинг, и кол-во проголосовавших. Пересчитывается средний рейтинг сущности при добавлении/удалении оценки
Таким образом чтобы нарисовать список, отсортировать по рейтингу и тд, агрегации не нужны будут
WolderVsrat
Можно и нужно обойтись без аггрегации. Просто явно «чтений» оценок будет больше чем «записей». Поэтому на каждой сущности отдельным полем висит его средний рейтинг, и кол-во проголосовавших. Пересчитывается средний рейтинг сущности при добавлении/удалении оценки
Таким образом чтобы нарисовать список, отсортировать по рейтингу и тд, агрегации не нужны будут
О, кстати
Раз такая пьянка, как лучше такое реализовать, чтобы по изменению тригерить перерасчёт где-либо?
У меня на ум приходит только чанж стрим приходит, может есть способ одним зайцем двух выстрелов
Denis
Denis
Чендж стрим полезен для сложных кейсов где тебе нужна подписка на query. Для такого его юзать оверхед
WolderVsrat
В твоем эндпоинте где добавляется/удаляется отзыв
А, ну прямо в лоб.
Я думал есть элегантные способы одним запросом )
WolderVsrat
Значит все вполне нормально, и я не наркоман)
Denis
А, ну прямо в лоб.
Я думал есть элегантные способы одним запросом )
Есть aggregation update чтобы одним запросом. Я например сделал computed поля с помощью него. Типа
name: vasya
hasName: true
Флаг ставится атомарно на стороне монги. Советую почитать, штука клевая
Denis
Например в кейсе выше можно пересчеты рейтинга сделать атомарными через aggregation update, или в тупую через чтение+запись в транзакции
WolderVsrat
Ага, нашел в доке, спасибо!
Как-то не догадывался, что у агрегейшна можно с апдейтом делать
WolderVsrat
А то я все мёрж да аут юзал для матер. таблиц в пайплайне, а оказывается все проще)
Denis
ребят, всем привет, а как-то можно сделать выборку с null и с lte / gte? к примеру:
year: { $or: [null, { $gte: 1981 }]
{
$or: [{ year: null }, { year: { $gte: 1981 } }]
}
Вроде так, попробуй
D
{
$or: [{ year: null }, { year: { $gte: 1981 } }]
}
Вроде так, попробуй
Привет! Спасибо большое, так и делаю, но хочется вложенности, возможно ли внутрь year объектом?
Denis
Привет! Спасибо большое, так и делаю, но хочется вложенности, возможно ли внутрь year объектом?
Если у тебя вложенность используй dot notation - “dates.year”
D
Если у тебя вложенность используй dot notation - “dates.year”
Не, в плане $or где-то внутри year, чтобы не выносить в сложном запросе в самый корень
 Speedy
Да шо это свисает такое
Speedy
Denis
Не, в плане $or где-то внутри year, чтобы не выносить в сложном запросе в самый корень
С gte никак. Если точное совпадение нужно было бы то $in просто
D
С gte никак. Если точное совпадение нужно было бы то $in просто
Понял, благодарю за информацию! К сожалению нужен диапазон плюс захватить null
 MDWIT
Ребят, случайно установил 3.6.3 версию монги. Если ее удалить и поставить 4.4. Я данные потеряю?
 LUVERISE
Парни подскажите что это такое
LUVERISE
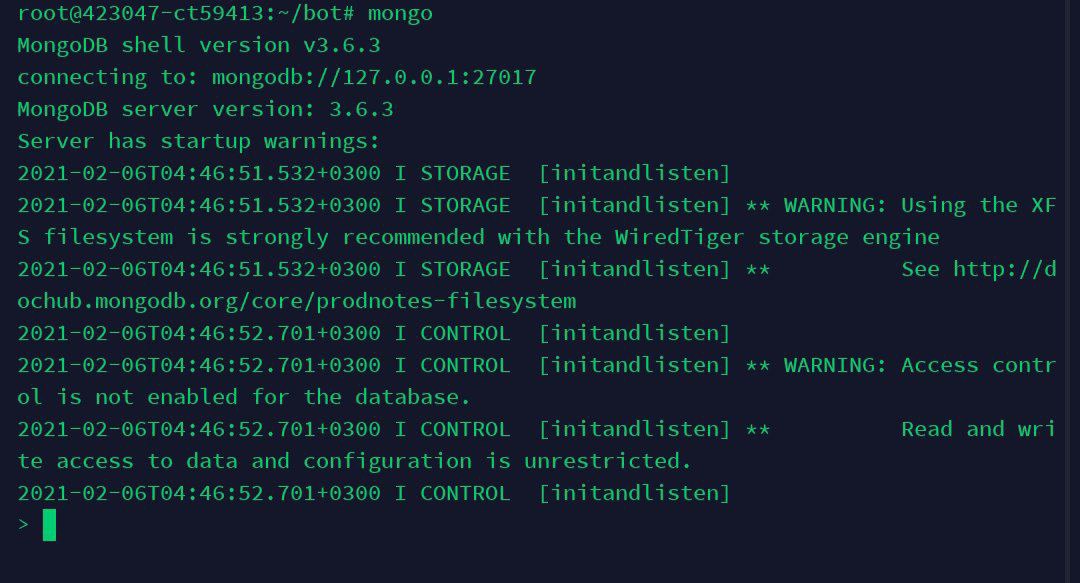
 Aleksey
LUVERISE
Щас покажу
LUVERISE
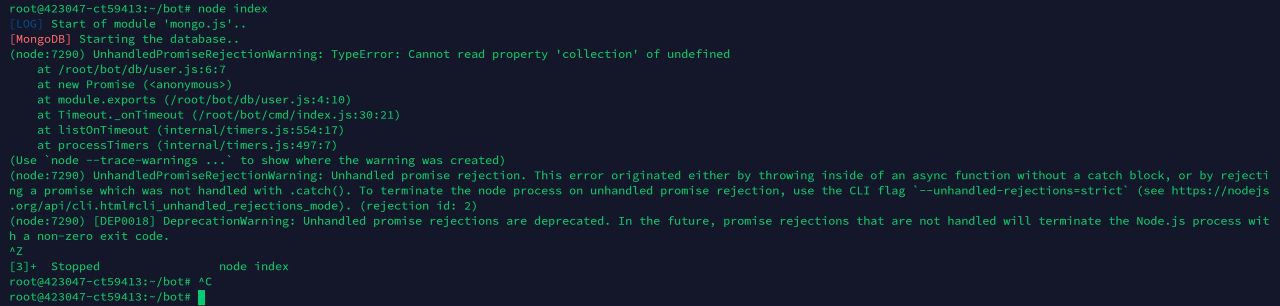 LUVERISE
Что здесь не так?
LUVERISE
Anonymous
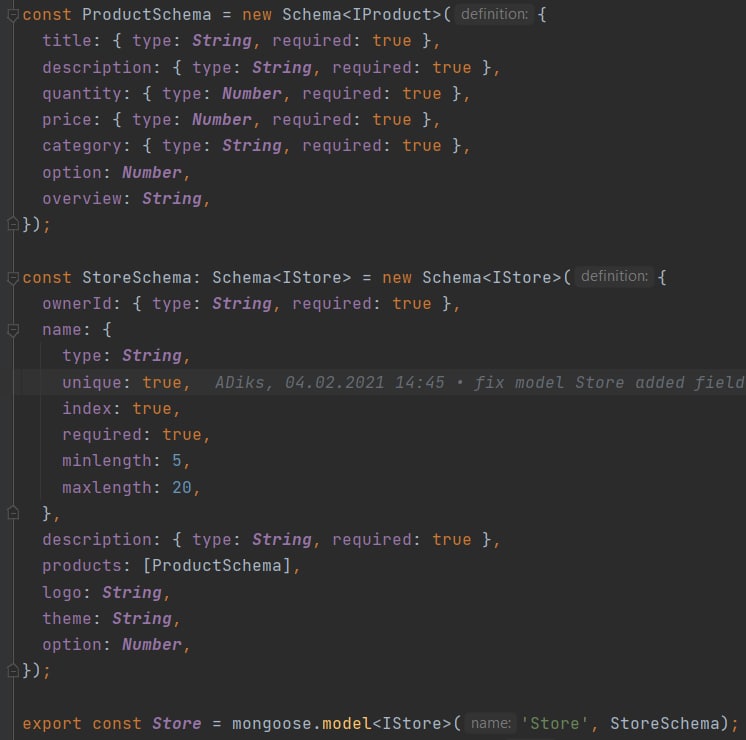
 Artem
как корректно писать запросы
чтоб в случае отсутствия результатов поиска
упрощались/менялись фильтры?
это реализуемо со стороны монги/монгуса или надо самому реализовывать повторно кидая запросы?
Denis
как корректно писать запросы
чтоб в случае отсутствия результатов поиска
упрощались/менялись фильтры?
это реализуемо со стороны монги/монгуса или надо самому реализовывать повторно кидая запросы?
Через агрегацию можно, match потом смотрим сколько получилось, потом еще один match, но смотря сколько этапов упрощений, если 1 то норм вроде, если более я бы лучше сделал разными запросами
AI
Имею коллекцию к примеру
name: String,
ex: Number,
rating: Number,Мне нужно сделать выборку, сортируя её результату умножения ex на rating. не могу понять как
AI
То есть агрегацией вытащить поле результирующее и по нему сортировать? Больше никак ?
Denis
То есть агрегацией вытащить поле результирующее и по нему сортировать? Больше никак ?
Никак. Лучше конечно хранить этот результат умножения рядом. А для старых доков написать миграшку
AI
Тоже думаю про это. Спасибо
Cavidan
Как взять документ из другой коллекции по id?Допустим есть у меня коллекции user и cart.Надо в user создать документ и указать cart из другой коллекции.Как это возможно сделать?
Cavidan
 Oleg
подскажите почему такой простой запрос так долго выполнялся:
2021-02-08T10:27:24.254+0200 I WRITE [conn23] update Auth.Token command: { q: { username: "login@hostname", status: "ACTIVE", _id: { $ne: "a9468d94-649b-46f6-a8c5-af3978440c0c" }, clientId: "sometext" }, u: { $set: { status: "CLOSED", expiredAt: new Date(1612772843124) } }, multi: true, upsert: false } planSummary: IXSCAN { _id: 1 } keysExamined:131626 docsExamined:131625 nMatched:1 nModified:1 numYields:1030 locks:{ Global: { acquireCount: { r: 1031, w: 1031 } }, Database: { acquireCount: { w: 1031 } }, Collection: { acquireCount: { w: 1031 } } } 1129ms
2021-02-08T10:27:24.254+0200 I COMMAND [conn23] command Auth.$cmd command: update { update: "Token", ordered: true, $db: "Auth", $clusterTime: { clusterTime: Timestamp(1612772843, 1), signature: { hash: BinData(0, 696358B5972D5117E9D6FEAD9CF1FFE3B8664101), keyId: 6905827268984045569 } }, lsid: { id: UUID("aea3d9f3-2615-4de5-ab48-dc27ac676bd5") } } numYields:0 reslen:245 locks:{ Global: { acquireCount: { r: 1031, w: 1031 } }, Database: { acquireCount: { w: 1031 } }, Collection: { acquireCount: { w: 1031 } } } protocol:op_msg 1129ms
 yopp
Oleg
$ne требует сканирования всей коллекции
спасибо, начал догадываться. у меня пока нулевой опыт в монго-запросах и их оптимизации
 Arystan
Всем привет. ребят как вы делаете бэкап?