 yopp


Единственное исключение covered query, но у вас судя по всему не тот случай
 Viktar
Не повлияет. Но и прироста не даст. Следовательно так себе перформанс импрувмент)
yopp
Да, в случае если ботлнек диски это не поможет. А вот если это сеть, может помочь :)
Viktar
Единственное исключение covered query, но у вас судя по всему не тот случай
Каверед квери это когда нужные поля в индексе?
yopp
В этом случае нет fetch стадии, а значит можно использовать совпадение сразу из памяти
Viktar
Хм. Тут можно подумать. Если добавить _id, lastName и firstName в индекс. Может получится улучшить перформанс
yopp
вам ещё куда-то надо будет weight в индексе положить
yopp
но вообще странно что при _id вам требуются ещё какие-то поля
yopp
_id же уникальный
yopp
а, у вас просто id
yopp
Учитывайте, что добавив индексы есть шанс ситуацию сделать ещё хуже: больше индексов, больше записи, больше борьба за кэш
Viktar
в данном случае id не _id
Viktar
записи у меня на проде нет. Только чтение
Savа
Кто-нибудь может простыми словами сказать,что такое хук и пре-хук?
Savа
а можно больше контекста
Дали задачку запретить запись через хук или пре-хук,я хочу разобраться с тем,что это вообще такое
 Denis
Опять монгус
Sergey Melchukov
нет, не решить
спасибо, с ipsec стало вроде лучше, но точно гораздо быстрее и есть надежда что все получится
Евгений
Всем привет. Сколько в среднем тратиться времени что бы получить данные из бд?
 Nick
Евгений
Ну....
Евгений
Что нужно учитывать?
Nick
все
Евгений
А на запись
Nick
на запись - вообще все
Nick
начиная от вашего железа в распоряжении, его овзможностей, до интенсивности потока запросов
Nick
и там еще здоровенный пул вопросов о структуре БД и тому как именно вы делаете запросы
Viktar
Всем привет. Сколько в среднем тратиться времени что бы получить данные из бд?
Очень размытый вопрос. Время тратится на установку конекта, доставку запроса к базе, обработку запроса и доставку ответа к клиенту. И каждый шаг имеет кучу параметров.
 MDWIT
Ребята всем привет. Как можно организовать поиск по частичному вхождению?
Сейчас сделан через регулярку. Но это очень медленно(
Евгений
Сколько времени занимает?
Евгений
Ребята всем привет. Как можно организовать поиск по частичному вхождению?
Сейчас сделан через регулярку. Но это очень медленно(
Евгений
Сколько объектов?
Евгений
Мм
yopp
Ребята всем привет. Как можно организовать поиск по частичному вхождению?
Сейчас сделан через регулярку. Но это очень медленно(
А по какому типу строки вы ищите? Это слово или набор слов?
yopp
Вы хотите найти слово в тексте?
MDWIT
Там название продукта
yopp
Одно или несколько слов можно искать через текстовый индекс. А вот часть слова или букву уже нет
MDWIT
Одно или несколько слов можно искать через текстовый индекс. А вот часть слова или букву уже нет
Понял, подскажите можно ли сделать поиск по текстовому индексу но без учета регистра?
Anonymous
здраствуйте господа. Можете помочь с дизайном схемы для базы данных. есть несколько вопросов. мне нужно создать схему постов написанных в формате markdown
 Aleksey
а что именно смущает в datetime?
добавил дататайм в кортеж ключа шардирования, jumbo нет, всё нормально распределяется. Дальше будем тестировать запросы, но выборочно полет нормальный, спасибо еще раз.
yopp
Понял, подскажите можно ли сделать поиск по текстовому индексу но без учета регистра?
Он по-умолчанию без учета регистра : https://docs.mongodb.com/manual/reference/operator/query/text/#text-operator-case-sensitivity
MDWIT
yopp
 Сергей
Никто не сталкивался, если надо построить минимальную реляционность какую-то в монге, на которую она сейчас неплохо претендует, согласно их предложенным моделям в цикле статей про имплементацию one to many, many to many через массивы _id. Что если надо хоть какую-то мало мальскую агрегацию с калькуляцией каких-то значений, то все тупо превращается в кучи lookup и unwind, и много случаев где предложенная денормализация не спасает. Все превращается в боль
Сергей
Нигде не нашел про так называемые join collection, хотя они же работают, не так ли?
yopp
One to many можно и без массива, через внешний ключ в many стороне отношения
yopp
И даже лукап не обязателен, можно через find выбирать
yopp
Many to many сложный вопрос. Так-же как и с табличными хранилищами можно сделать чрез промежуточную связь
yopp
Если количество связей на один документ небольшое, то можно и массивом
yopp
Если много, то отдельная коллекция. Можно просто 1 документ на связь, а можно и массивом
yopp
В зависимости от задачи, $unwind можно избежать
Сергей
Many to many сложный вопрос. Так-же как и с табличными хранилищами можно сделать чрез промежуточную связь
Промежуточная коллекция, есть такая практика?
yopp
Да, почему бы и нет :)
MDWIT
Ребята, подскажите. Есть ли смысл для api ставить редис над монго в качестве кеша? Или тут нужен другой инструмент для кеша?
Диск очень медленный на серваке(
 maxsimych
Ребята, подскажите. Есть ли смысл для api ставить редис над монго в качестве кеша? Или тут нужен другой инструмент для кеша?
Диск очень медленный на серваке(
Редис норм, можно и вместе с монгой, про диск, в любом случае лучше взять ssd
MDWIT
Редис норм, можно и вместе с монгой, про диск, в любом случае лучше взять ssd
😄 жалкие 50мб/сек на оракл не прокатят, да?)
 Alex
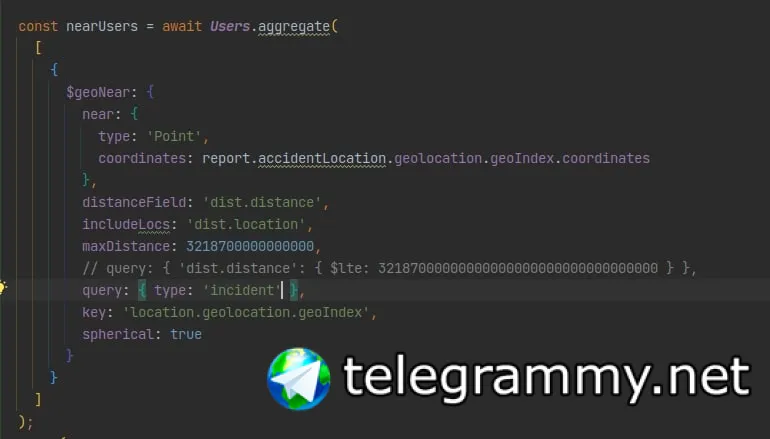
Всем привет, срочно нужна помощь
Alex
 Dezmunt
Юзаю монгус, под конец фунции сохраняю через метод save, а он пишет что он не является функцией! Что это может быть?
Daniil
Юзаю монгус, под конец фунции сохраняю через метод save, а он пишет что он не является функцией! Что это может быть?
Нужен код, ошибка в нем скорее всего
Alex
 Alex
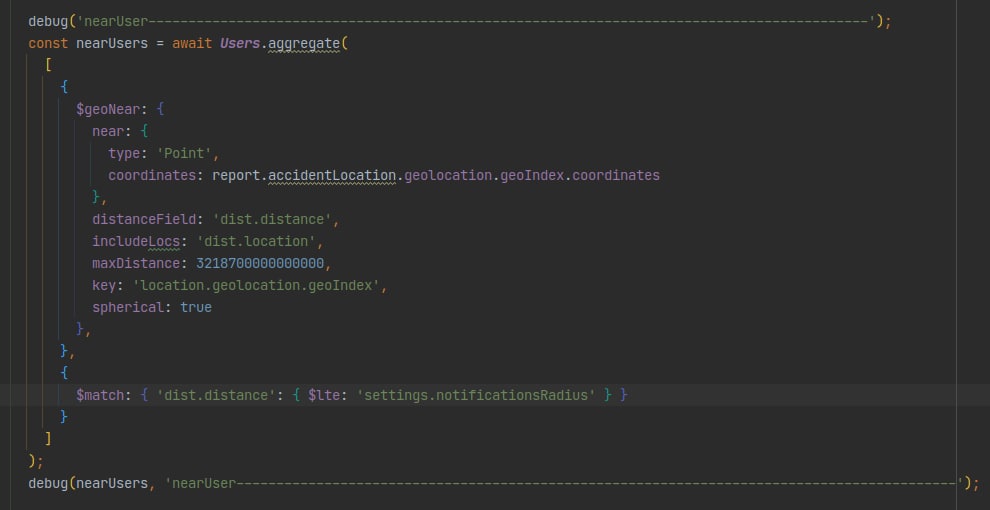
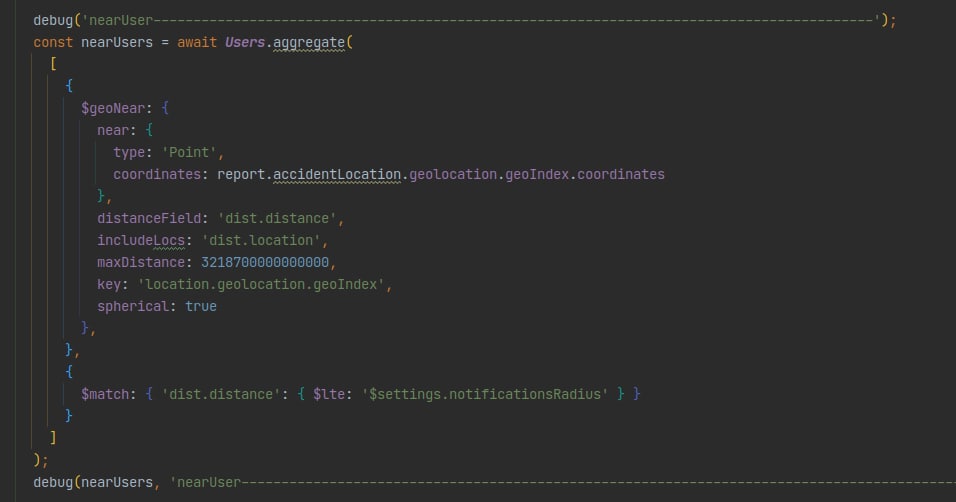
это поле есть у каждой записи user, без кавычек не работает
Alex
это поле есть у каждой записи user, без кавычек не работает
очень срочно нужна помощь помогите пожалуйста
Alex
и будет рабоать? кавычки нужно всё равно оставить?
Alex
 Alex
не работает так, как только я вставляю туда число, то всё ок
Ardak Rakhmetov
вау не думал что здесь будет политика
MDWIT
спасибо
MDWIT
 Aleksey
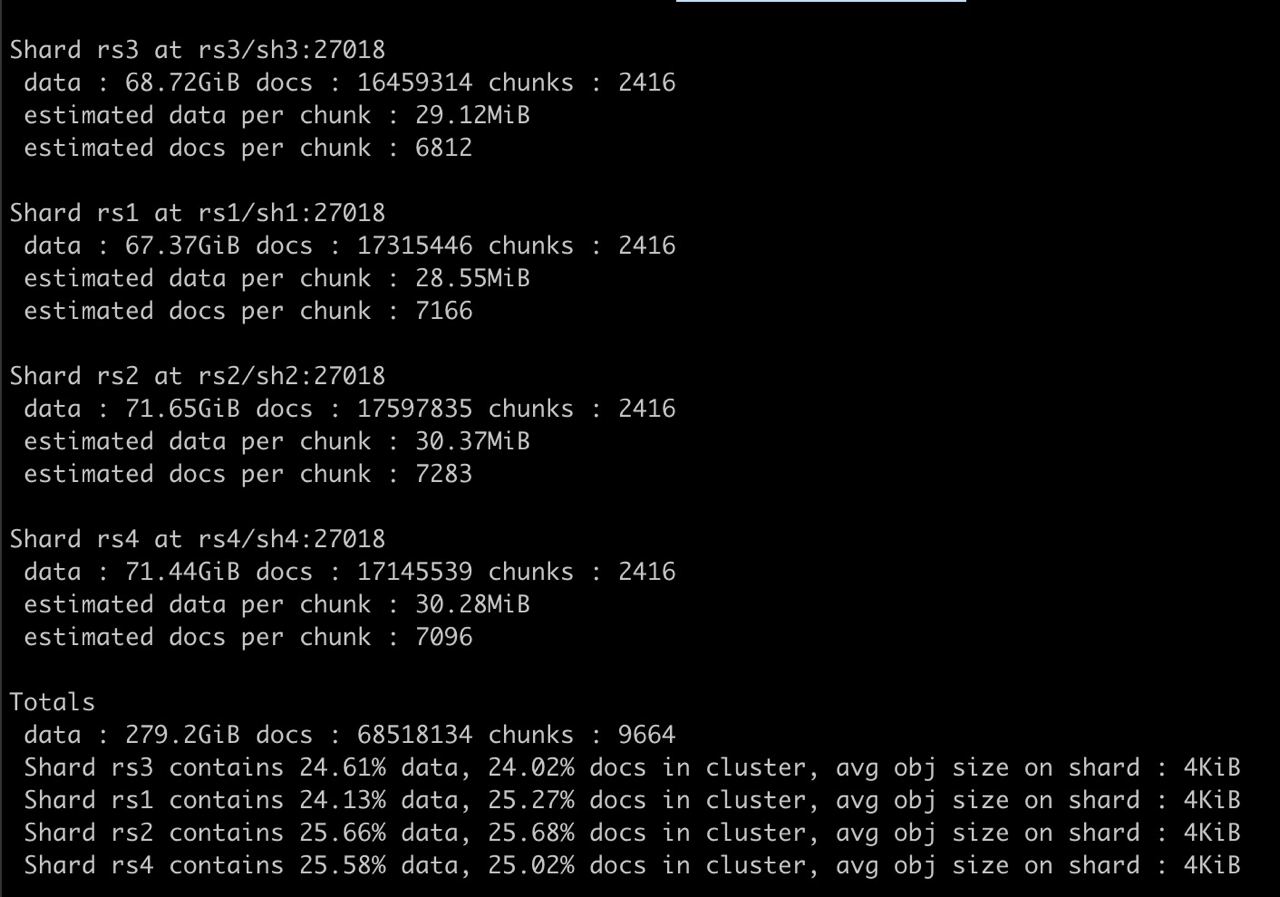
единственный минус который я вижу, это что у тех, у кого много данных, вставка будет всегда ехать на один шард
 Aleksey
но если зайти на монгоды размер баз сильно разнится.
show dbs показывает размеры у этой бд
rs1 72.612GB
rs2 19.079GB
rs3 18.754GB
rs4 18.855GB
rs1 - практически весь рестор изначально валился на него, потом уже создавались новые чанки и расползались по остальным шардам. есть подозрение что это чанки которые были перенесены но не были удалены. пробовал запускать cleanupOrphaned для этой коллекции, но ничего не изменилось.
куда копать?