 Vladimir


Народ, есть ли у кого нибудь в зоне внимания нормальный тренажер mongodb, чтобы отточить запросы ?
Ну типа как sqlex.
 Влад
 Y
Подскажите, какое максимальное значение у $limit есть какие-то ограничения?
Y
Просто у меня по стейджам как-будто возвращает одно количество документов, а если по тем же самым стейджам бежать по курсору в питоне, то меньше
Y
При этом если считать каунт по стеджам и там и там результат одинаковый, но вот именно, когда бегу по курсору, то записей меньше
Y
Подобная штука актуальная для больших объемов, т.е. в коллекции около миллиона документов
 Юлиан🦉
Просто у меня по стейджам как-будто возвращает одно количество документов, а если по тем же самым стейджам бежать по курсору в питоне, то меньше
Что значит "по стейджам"?
Y
Что значит "по стейджам"?
Значит, что если написать пайплайн и выполнить стейджи в mongo_compas
Сергей
Мужики всем привет! А поддерживает ли mongosh версии 2.3.4 монгу 8 версии ?
 Артем
Всем привет! А кто нибудь mongo версии выше 6 подключал к redash? Что-то не взлетает(
 Alex
Доброго времени суток!
Подскажите, пжл, что используется в качестве балансировщика для кластера монгодб?
 Nick
Доброго времени суток!
Подскажите, пжл, что используется в качестве балансировщика для кластера монгодб?
зачем балансировщик? в монге только одна нода мастер для записи, а реплики могут читаться и драйвером прекрасно с использованием secondaryPreffered
Alex
Доброго времени суток!
Подскажите, пжл, что используется в качестве балансировщика для кластера монгодб?
Добрый день, Nick!
Мы просто хотим сделать много нодовый вариант, а я поднимал только одноноловый в режиме реплика сет вот и решил у знающих людей спросить.
Нашел схему, где реплика как бы распределена по ВМ: 1- праймериз + сеондари + бэкап2: только сеондари 3: арбитр + секондари
Alex
Доброго времени суток!
Подскажите, пжл, что используется в качестве балансировщика для кластера монгодб?
Просто как это физически реализовать не понятно:(((
Nick
Добрый день, Nick!
Мы просто хотим сделать много нодовый вариант, а я поднимал только одноноловый в режиме реплика сет вот и решил у знающих людей спросить.
Нашел схему, где реплика как бы распределена по ВМ: 1- праймериз + сеондари + бэкап2: только сеондари 3: арбитр + секондари
Как я и написал на репликасете балансер не нужен, его функция на стороне драйвера
Alex
Как я и написал на репликасете балансер не нужен, его функция на стороне драйвера
Спасибо большое, Nick, будем пробовать!
Всем хорошего дня
 deni
всем привет! насколько часто вообще используют возможности полнотекстового поиска в монго?
 Tony
всем привет! насколько часто вообще используют возможности полнотекстового поиска в монго?
Сомневаюсь что на этот вопрос можно ответить)
Tony
Когда нужно тогда и используют, так часто, как необходимо в каждом конкретном случае)
Nick
всем привет! насколько часто вообще используют возможности полнотекстового поиска в монго?
используют часто и после этого разочаровываются в малом функционале и ставят чтото сбоку или уходят на регулярки и мирятся со скоростью) Полнотекст в монге это не тот полнотекст которого обычно ожидают и он крайне кастрирован. В клауде есть возможность заюзать atlas search который уже про взрослый фултекст.
Так что обязательно вам надо пробовать хватит ли под ваши задачи того что имеется.
deni
используют часто и после этого разочаровываются в малом функционале и ставят чтото сбоку или уходят на регулярки и мирятся со скоростью) Полнотекст в монге это не тот полнотекст которого обычно ожидают и он крайне кастрирован. В клауде есть возможность заюзать atlas search который уже про взрослый фултекст.
Так что обязательно вам надо пробовать хватит ли под ваши задачи того что имеется.
спасибо за подробный ответ! Просто хотел у слышать про чей-то опыт с этим всем
Один вопрос остался: а в чем минус атласа?
Nick
спасибо за подробный ответ! Просто хотел у слышать про чей-то опыт с этим всем
Один вопрос остался: а в чем минус атласа?
облако не в юрисдикции РФ и необходимость компании монго с тем что надо накручивать санкции, как результат в веб только по впн с РФ и выдумывать как оплачивать. В целом сами серваки бд доступны, но тут как говорится пока доступны и вздумает ли их контора прикрыть когданить доступ
Luxury
Ребята привет, подскажите кто знает: есть 1 база. В ней есть 3 документа. Мне нужно найти пересечение и если оно есть забрать необходимые значения с трех документов. Чтоб вернул массив с значениями. Мне нужно просто пример. Если это можно сделать, без обхода циклами.
 Kvhqm
Vladimir
Ребята привет, подскажите кто знает: есть 1 база. В ней есть 3 документа. Мне нужно найти пересечение и если оно есть забрать необходимые значения с трех документов. Чтоб вернул массив с значениями. Мне нужно просто пример. Если это можно сделать, без обхода циклами.
Смотри в сторону группировки $group
Luxury
Что такое пересечение?
Это когда есть значение, скажем название улицы в трех документах. Значит эта пара ключ:значение пересекаются. Ключ может и не пересекатся, но значение должно быть одинаковым это есть пересечение.
 Evgeniy
Не могу найти чат с чатами 😅 или может у кого есть ссылка на чат Redis
 andreyvsc
Не могу найти чат с чатами 😅 или может у кого есть ссылка на чат Redis
https://t.me/redis_ru
Но там тухлее тухлого. Найдете живой чат - поделитесь плтз.
Evgeniy
да, там совсем все плохо, ну может кто подключал redis c помощью ioredis и tls отпишите в лс плиз
 Kirilll
https://t.me/redis_ru
Но там тухлее тухлого. Найдете живой чат - поделитесь плтз.
в целом я тебе ответил там, но после попытки прислать ссылки меня забанили)
El
Приветствую
Как увидеть в консоли результат стадии aggregate()? Есть pipeline, в ней есть стадия $project, как залогировать результат её работы?
El
Explain?
Для всего aggregate да, для стадии в нём нет. Возможно, у меня id объектов не подаются или они не те, нужно проверять результаты стадий.
Nick
El
Выполнить и вычитать результат
"Вычитать" это что?
Амир
Для всего aggregate да, для стадии в нём нет. Возможно, у меня id объектов не подаются или они не те, нужно проверять результаты стадий.
Запускать каждый стейдж отдельно и смотреть результат тогда. Монгодб компасс в помощь
Nick
"Вычитать" это что?
Откройте доку к вашему драйверу, найдите там пример, так проще. И дальше средствами языка залогировать
 Родион
Для всего aggregate да, для стадии в нём нет. Возможно, у меня id объектов не подаются или они не те, нужно проверять результаты стадий.
так сделайте запрос сначала с первой стадией и посмотрите результат. потом добвьте вторую стадию. если такие вопросы прям..
 yopp
Приветствую
Как увидеть в консоли результат стадии aggregate()? Есть pipeline, в ней есть стадия $project, как залогировать результат её работы?
Здравствуйте!
В нашей песочнице можно: справа будут результаты для каждой стадии в пайплайне
https://play.db-ai.dev
Alexey
Здравствуйте!
В нашей песочнице можно: справа будут результаты для каждой стадии в пайплайне
https://play.db-ai.dev
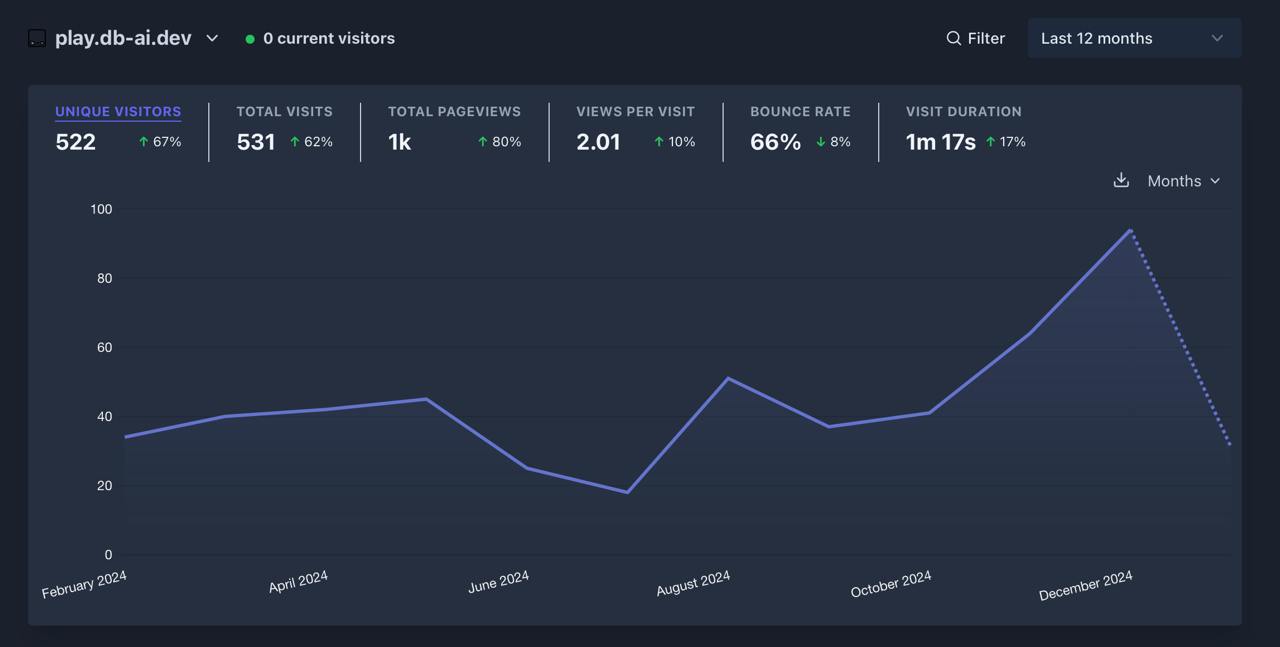
А исходники песочницы планируется заопенсорсить?
 Артем
yopp
А исходники песочницы планируется заопенсорсить?
 Alexey
 Богдан
Ну тут на вкус и цвет. Но перед тем как решать как хранить данные задайте себе вопрос об том как много данных к вам придёт, и какие данные от вас будут требовать сайты. Если держать ответы на эти вопросы в уме, возможно вы естественным образом придёте к структуре данных которую хотите хранить. А дальше уже разграничиваете структуры опираясь на бизнес логику
Всем привет!
Подскажите, как правильно сделать индексы и делать запрос для быстрого поиска по ФИО. У меня сейчас в базе 26 млн. документов. Будет ещё до 100 млн. Поиск происходит за 1-3 минуты, что долго.
Структура:
{
"first_name": "ВАСИЛИЙ",
"last_name": "КАРПУКОВСКИЙ",
"middle_name": "ИЛЬИЧ"
}
Каждое поле может иметь одно слово, к примеру "Котельниченко" или несколько "Котельниченко (Котельник)"
Богдан
Ну видимо индекс на эти три поля. Плюс с префиксом определитесь
Я делал текстовый индекс на три поля. При поиске выдаёт документ где есть хотя-бы одно совпадение (фамилия или имя или отчество). Может я неправильно настроил индекс.
Делал обычный индекс. При запросе по непопулярным фамилиям ищет быстро (секунд 15), при поиске "Иванов" - минуты 3.
Богдан
Шардирование рассматривал?
Нет. Думаю для меня это слишком сложная задача. Я пока хотел запустить MVP тереграм приложение по поиску информации о предках (по базам)
Амир
Я делал текстовый индекс на три поля. При поиске выдаёт документ где есть хотя-бы одно совпадение (фамилия или имя или отчество). Может я неправильно настроил индекс.
Делал обычный индекс. При запросе по непопулярным фамилиям ищет быстро (секунд 15), при поиске "Иванов" - минуты 3.
Если вы введете "Иванов Иван Иванович" то запрос пойдет в индекс. Если просто "Иванов", то зависит от префикса
Богдан
а вам какой поиск нужен?
Вот нужен по полному ФИО или по части (только фамилия или имя, или Имя отчество...)
Богдан
Если вы введете "Иванов Иван Иванович" то запрос пойдет в индекс. Если просто "Иванов", то зависит от префикса
Правильно я понял ,что тогда надо сделать индексы на каждое поле отдельно, а так же вместе на "ФИО"?
Амир
Вот нужен по полному ФИО или по части (только фамилия или имя, или Имя отчество...)
https://www.mongodb.com/docs/manual/core/indexes/index-types/index-compound/
Амир
Правильно я понял ,что тогда надо сделать индексы на каждое поле отдельно, а так же вместе на "ФИО"?
А какой запрос чаще будет? Можно бахнуть имя1_фамилия1_отчество1 и допом имя1_отчество1
Богдан
А какой запрос чаще будет? Можно бахнуть имя1_фамилия1_отчество1 и допом имя1_отчество1
да, именно эти чаще всего + фамилия и имя.
Сейчас сделай и проверю
Амир
фамилия и имя тоже самое что имя и фамилия
Богдан
фамилия и имя тоже самое что имя и фамилия
Короче делаю составной индекс "ФИО". Его размер доходит до 500мб и после пропадает (удаляется). Вообще не понятно в чём дело
Богдан
Монго мб
Много?
Я сейчас хочу попробовать разбить большую коллекцию на 5 частей. В каждой части будут фамилии на некоторые первые буквы (часть 1: А, Б, В, Г; часть 2: Д...)
При запросе буду обращаться только к той коллекции, где должна быть искомая фамилия.
Если сработает, то на первое время пусть так работает
 A
blocks: {
type: [Schema.Types.Mixed],
strict: false
},
Есть сложные данные массивы в массивах
[
{
type: 'table',
data: {
array: [
['1', '28', 'John', 'New York'],
['2', '34', 'Jane', 'Los Angeles'],
['3', '27', 'Tom', 'Chicago']
]
},
}
]
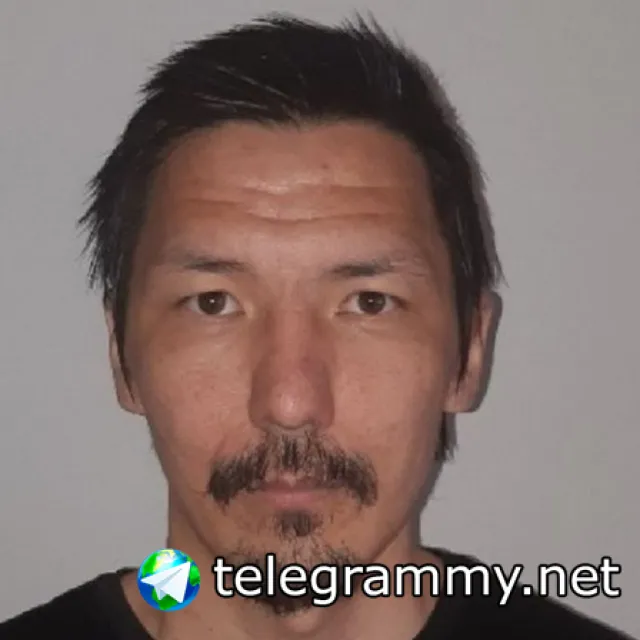
strict: false на постоянке это плохое решение? потому что [Schema.Types.Mixed] - любые данные не справляется.
 Ильдар
Ребят подскажите, как пмм настроить правильно.
Поставил пмм клиенты и сервер, а вот как добавлять клиенты в сервер не понимаю.
В кубере
Ильдар
Если просто указываю сервис cluster-r0 то добавляется один узел рандомом чтоли...
А перечислить все реплики не могу.
Богдан
 hoxnox
Имеется два одинаковых по железу сервера. БД лежат на XFS. Я думал можно остановить mongodb, скопировать все файлы с одного сервака на другой и там безболезненно поднять. Но походу это не работает - mongo не поднимается. Это я криворукий или действительно так нельзя? Если второе, то как можно? mongodump/restore очень долго перестраивает индексы. 😔
 Dmitry
Имеется два одинаковых по железу сервера. БД лежат на XFS. Я думал можно остановить mongodb, скопировать все файлы с одного сервака на другой и там безболезненно поднять. Но походу это не работает - mongo не поднимается. Это я криворукий или действительно так нельзя? Если второе, то как можно? mongodump/restore очень долго перестраивает индексы. 😔
https://www.mongodb.com/docs/manual/tutorial/backup-with-filesystem-snapshots/
Теоретически вот гайд близко к которому вы действуете.
Но без деталей сказать что не так сложно. Хотя бы что там монга при запуске пишет
 Arthur
Andrey
Имеется два одинаковых по железу сервера. БД лежат на XFS. Я думал можно остановить mongodb, скопировать все файлы с одного сервака на другой и там безболезненно поднять. Но походу это не работает - mongo не поднимается. Это я криворукий или действительно так нельзя? Если второе, то как можно? mongodump/restore очень долго перестраивает индексы. 😔
Скорее всего с правами на файлы вопрос
hoxnox
Скорее всего с правами на файлы вопрос
Данные копируются rsync-ом c опциями atU - права и время модификции/достпуа сохраняются.
Oleg
Имеется два одинаковых по железу сервера. БД лежат на XFS. Я думал можно остановить mongodb, скопировать все файлы с одного сервака на другой и там безболезненно поднять. Но походу это не работает - mongo не поднимается. Это я криворукий или действительно так нельзя? Если второе, то как можно? mongodump/restore очень долго перестраивает индексы. 😔
должно работать, проверьте права, возможно у монго разные uid на серверах
Dmitry
мне еще SELinux часто мог запуск испортить
hoxnox
Попробую еще разок. Может я что-то упустил в прошлый. 🤔
hoxnox
Вы упустили посмотреть в логи.
Смотрел. Но сейчас там очень много всего - не могу найти момент, когда я пускал после восстановления.
Попробую заново - акуратно логи сохраню.
madspectator
Смотрел. Но сейчас там очень много всего - не могу найти момент, когда я пускал после восстановления.
Попробую заново - акуратно логи сохраню.
Это будут последние строчки в файле. У вас же не работает процесс mongodb, следовательно лог не пополняется.