А может в $group есть какой нибудь флажок, чтобы он пустые группы создавал и не выкидывал?)
Мечтать не вредно)
 Дмитрий


 Nick
А может в $group есть какой нибудь флажок, чтобы он пустые группы создавал и не выкидывал?)
https://www.mongodb.com/docs/manual/reference/operator/aggregation/densify/
 Oleg
https://www.mongodb.com/docs/manual/reference/operator/aggregation/densify/
Спасибо, огромное это именно то, что нужно!
 Ivan
Добрый день, создал свой кластер, пытаюсь создать юзера нового и пробрасывается ошибка:
The full response is:
{
"ok" : 0.0,
"errmsg" : "(Unauthorized) not authorized on admin to execute command { usersInfo: 1, $db: \"admin\", $clusterTime: { clusterTime: {1715100109 21}, signature: { hash: {0 [155 99 61 44 145 252 98 124 87 218 92 192 61 194 127 106 195 237 245 158]}, keyId: 7329589311005786112.000000 } }, lsid: { id: {4 [184 219 102 230 133 192 78 196 169 192 65 126 115 155 219 227]} } }",
"code" : 8000.0,
"codeName" : "AtlasError"
}
Помогите исправить, пожалуйста)
Nick
Добрый день, создал свой кластер, пытаюсь создать юзера нового и пробрасывается ошибка:
The full response is:
{
"ok" : 0.0,
"errmsg" : "(Unauthorized) not authorized on admin to execute command { usersInfo: 1, $db: \"admin\", $clusterTime: { clusterTime: {1715100109 21}, signature: { hash: {0 [155 99 61 44 145 252 98 124 87 218 92 192 61 194 127 106 195 237 245 158]}, keyId: 7329589311005786112.000000 } }, lsid: { id: {4 [184 219 102 230 133 192 78 196 169 192 65 126 115 155 219 227]} } }",
"code" : 8000.0,
"codeName" : "AtlasError"
}
Помогите исправить, пожалуйста)
проверяйте креды с которыми подключаетесь и есть ли у этого юзера достаточно прав
 Danylo
Привет!
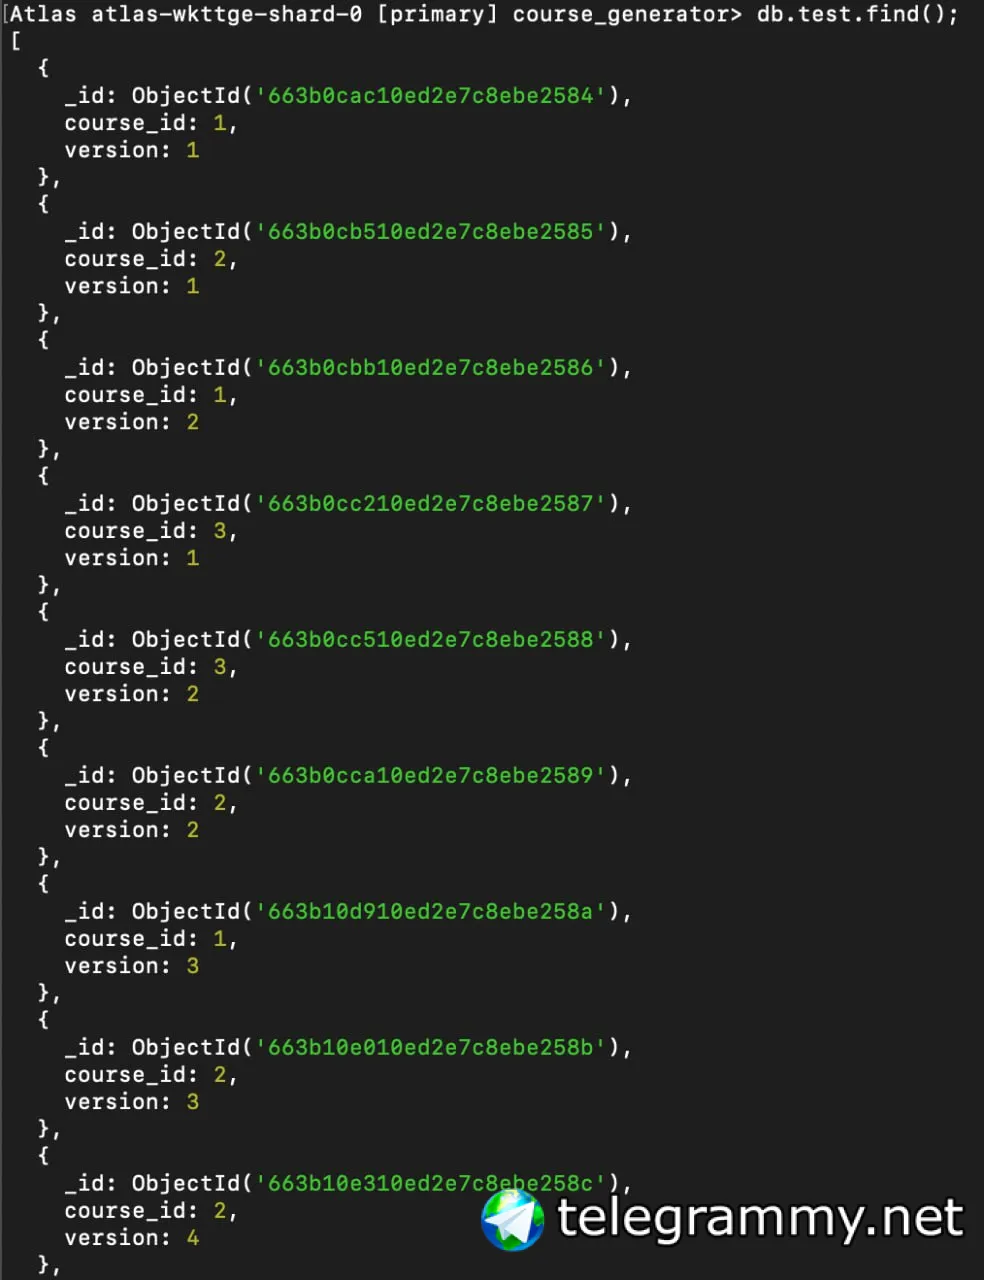
Хочу сделать пагинацию с возможностью сортировки. Использую event-based архитектуру документа mongodb, то есть на каждое внесенное изменение создается новый документ и инкрементируется поле version + 1.
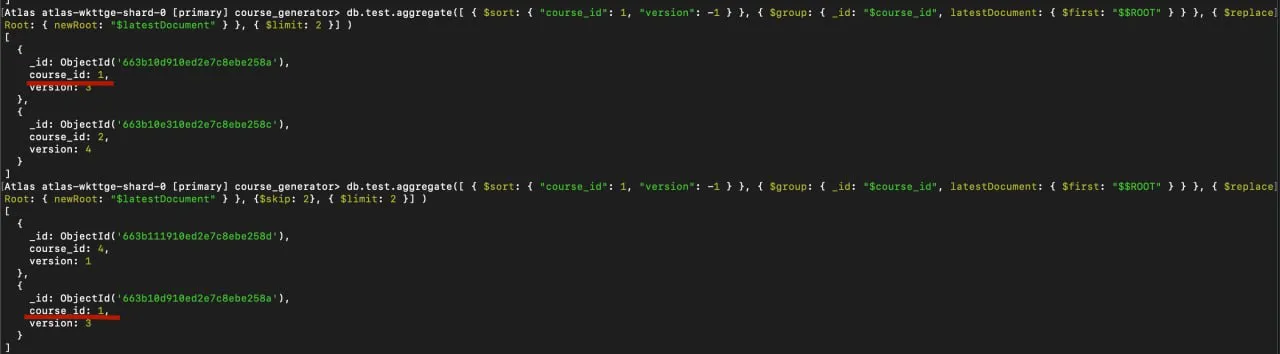
Если кратко описать проблему: то проблемы не существует если не использовать пагинацию, мы делаем {$sort: {course_id: 1}} и получаем куча отсортированных по возрастанию документов (можно также сгруппировать все документы по course_id и получить документ с наибольшей version дабы отсеять старые версии и не получить дубликатов). Но как это сделать используя пагинацию skip, limit? Документы разбросаны в не очевидном порядке, применяя такую технику мы получим дубликаты, так как в 1 запросе мы запросили документы A, B, C, затем в другом запросе мы выставили skip=10 и получили более поздние версии документов A, B, C. Также сортировка здесь работает в пределах 1 запроса и не отражается при других запросах с включенной пагинацией.
Как с этим бороться? Как можно более изящно решить эту проблему? На уровне кода или на уровне MongoDB или же на уровне Mongodb + на уровне кода? Не знаю куда копать...
Danylo
странное у вас условие сортировки раз такое происходит. Добавьте еще ту же версию в сортировку и все будет стабильно
Вы меня неправильно поняли, вот возьмем для иллюстрации несколько документов со следующей структурой:
[
{
"_id": "xxxx",
"course_id": 100,
"version": 1
},
{
"_id": "xxxx",
"course_id": 102,
"version": 1
},
{
"_id": "xxxx",
"course_id": 100,
"version": 2
},
{
"_id": "xxxx",
"course_id": 103,
"version": 1
},
{
"_id": "xxxx",
"course_id": 102,
"version": 2
}
]
Условно пусть limit=2, skip=0, мы делаем { $sort: {"course_id": 1, "version": -1} } получаем:
[ {
"_id": "xxxx",
"course_id": 100,
"version": 1
},
{
"_id": "xxxx",
"course_id": 102,
"version": 1
} ]
Тут всё хорошо, вопросо нет!
Затем пользователь открывает следующую страницу, мы делаем skip=2, limit=2, получаем:
[ {
"_id": "xxxx",
"course_id": 100,
"version": 2
},
{
"_id": "xxxx",
"course_id": 103,
"version": 1
} ]
То есть получаем вновь курс c course_id = 100, но более новую версию. Получается что на первой страницы пагинаци мы показываем курс с айди 100 (но из-за того, что мы делаем limit мы не можем охватить более поздние документы с новейшей версией) , на второй страницы мы показываем тот же курс с course_id = 100, но версия уже 2.
Это уже не хендлится простым sort условием , нужно либо прокидывать в match != in (массив course_id с предыдущих страниц пагинации) или как по другому чтоб не наворотить франкенштейна я хз..
Nick
Вы меня неправильно поняли, вот возьмем для иллюстрации несколько документов со следующей структурой:
[
{
"_id": "xxxx",
"course_id": 100,
"version": 1
},
{
"_id": "xxxx",
"course_id": 102,
"version": 1
},
{
"_id": "xxxx",
"course_id": 100,
"version": 2
},
{
"_id": "xxxx",
"course_id": 103,
"version": 1
},
{
"_id": "xxxx",
"course_id": 102,
"version": 2
}
]
Условно пусть limit=2, skip=0, мы делаем { $sort: {"course_id": 1, "version": -1} } получаем:
[ {
"_id": "xxxx",
"course_id": 100,
"version": 1
},
{
"_id": "xxxx",
"course_id": 102,
"version": 1
} ]
Тут всё хорошо, вопросо нет!
Затем пользователь открывает следующую страницу, мы делаем skip=2, limit=2, получаем:
[ {
"_id": "xxxx",
"course_id": 100,
"version": 2
},
{
"_id": "xxxx",
"course_id": 103,
"version": 1
} ]
То есть получаем вновь курс c course_id = 100, но более новую версию. Получается что на первой страницы пагинаци мы показываем курс с айди 100 (но из-за того, что мы делаем limit мы не можем охватить более поздние документы с новейшей версией) , на второй страницы мы показываем тот же курс с course_id = 100, но версия уже 2.
Это уже не хендлится простым sort условием , нужно либо прокидывать в match != in (массив course_id с предыдущих страниц пагинации) или как по другому чтоб не наворотить франкенштейна я хз..
но вообще реально ли надо сохранять очередность по страницам если пока пользователь просматривает текущую страницу и переходя потом на следующуюю он не увидел сдивга от появления новых доков?
Ivan
проверяйте креды с которыми подключаетесь и есть ли у этого юзера достаточно прав
Проблема в том, что создал при подключении кластера пользователя с логином и паролем, но пользователь не появился в админке
Danylo
получаем 100-2, 100-1 в первом запросе. И во втором 102-2, 102-1. У вас какаято путаница в понимании работы сортировки
 -
 Danylo
А, что вам мешает добавить ещё одну сортировку после $group и потом делать пагинацию?
Не очень понимаю о чем вы. Зачем ещё одна сортировка после $group? И что значит "потом делать пагинацию"? У меня пагинация это 2 оператора которые идут последними в пайплайне skip, limit
-
Не очень понимаю о чем вы. Зачем ещё одна сортировка после $group? И что значит "потом делать пагинацию"? У меня пагинация это 2 оператора которые идут последними в пайплайне skip, limit
Смотри, первую сортировку можно убрать и по пробовать сделать через $max в $group, но тут до конца не уверен т.к. надо пробовать, потом после $replaceRoot вы можете добавить сортировку по course_id, потом сделать skip и limit. Тем самым вы избежите ситуации, когда у вас при
skip: 0 и limit: 2 выдало 1 и 2, а при skip: 2 и limit: 2 выдало 4 1
-
Смотри, первую сортировку можно убрать и по пробовать сделать через $max в $group, но тут до конца не уверен т.к. надо пробовать, потом после $replaceRoot вы можете добавить сортировку по course_id, потом сделать skip и limit. Тем самым вы избежите ситуации, когда у вас при
skip: 0 и limit: 2 выдало 1 и 2, а при skip: 2 и limit: 2 выдало 4 1
У вас при skip: 0 и limit: 2 выдаст 1 и 2, а при skip: 2 и limit: 2, выдаст 3 и 4
Nick
Не очень понимаю о чем вы. Зачем ещё одна сортировка после $group? И что значит "потом делать пагинацию"? У меня пагинация это 2 оператора которые идут последними в пайплайне skip, limit
После группировки данные не оисортированы. Использовать скип лимит на неотсортированных данных нельзя, т.к приводит как раз к вашим проблемам
 Temirlan
Всем привет, можете подсказать😅
Я пытаюсь разделить базу MongoDB используя Sharding, через docker-compose настроил контейнеры mongos, config-server и три mongo-shard каждый использует replication-set
мне надо настроить аутентификацию для подключения к базе
в обычной базе можно было настроить аутентификацию для базы монго в docker-compose указав Root username и password
mongodb_container:
container_name: mongodb_container
image: mongo:latest
environment:
MONGO_INITDB_ROOT_USERNAME : root
MONGO_INITDB_ROOT_PASSWORD : pass
ports:
- "27017:27017"
но с нескольками базами так не работает
я могу к базе подключиться не указав логин и пароль
можете подсказать как в этом случае решить проблему?
прикрепил docker-compose файл и файл скрипта
Temirlan
вот докер файл
 Kvhqm
Скажите пожалуйста, я ведь в лукапе могу группировать док по параметрам которые мне в голову взбредут?
Nick
Скажите пожалуйста, я ведь в лукапе могу группировать док по параметрам которые мне в голову взбредут?
в лукапе можно пайплайн указывать, кторый выполнится над связанной коллекцией, так что да что можно сделать в обычной пайпе можно и внутри лукапа
Kvhqm
в лукапе можно пайплайн указывать, кторый выполнится над связанной коллекцией, так что да что можно сделать в обычной пайпе можно и внутри лукапа
фух, зашаманил. /Кароч не, не вариант в лукапе костылить выбор полей, или я не правильно вчера вызарился
Kvhqm
чере аддФиелд делал
Nick
не должно быть ошибок, $inc создает поле если его нет. Какая ошибка увас?
 Dmitriy
Всем привет. В монге есть версионирование документа? Если да, то реализуется это на стороне сервиса БД или можно этим управлять в рамках языка?
-
Всем привет. В монге есть версионирование документа? Если да, то реализуется это на стороне сервиса БД или можно этим управлять в рамках языка?
https://www.mongodb.com/community/forums/t/document-versioning/212011
https://www.mongodb.com/blog/post/building-with-patterns-the-document-versioning-pattern
Danylo
После группировки данные не оисортированы. Использовать скип лимит на неотсортированных данных нельзя, т.к приводит как раз к вашим проблемам
А как можно обойти PlanExecutor error during aggregation :: caused by :: Sort exceeded memory limit of 33554432 bytes, but did not opt in to external sorting? allowDiskUsage: true не помогает, а как переписать запрос более эффективно я не имею ни малейшего представления.
[
{
"$sort": {
"version": -1
}
},
{
"$group": {
"_id": "$course_id",
"doc": {
"$first": "$$ROOT"
}
}
},
{
"$replaceWith": "$doc"
},
{
"$sort": {
"course_id": 1,
"version": -1
}
},
{
"$skip": 50
},
{
"$limit": 10
}
]
Nick
А как можно обойти PlanExecutor error during aggregation :: caused by :: Sort exceeded memory limit of 33554432 bytes, but did not opt in to external sorting? allowDiskUsage: true не помогает, а как переписать запрос более эффективно я не имею ни малейшего представления.
[
{
"$sort": {
"version": -1
}
},
{
"$group": {
"_id": "$course_id",
"doc": {
"$first": "$$ROOT"
}
}
},
{
"$replaceWith": "$doc"
},
{
"$sort": {
"course_id": 1,
"version": -1
}
},
{
"$skip": 50
},
{
"$limit": 10
}
]
включить aлаг allowDiskUse, пример https://stackoverflow.com/a/26375840
Danylo
включить aлаг allowDiskUse, пример https://stackoverflow.com/a/26375840
 Danylo
Или же на бесплатном кластере Atlas'а недоступна опция allowDiskUse? Если
Nick
Или же на бесплатном кластере Atlas'а недоступна опция allowDiskUse? Если
да верно на бесплатном не работаетhttps://www.mongodb.com/docs/atlas/reference/free-shared-limitations/#operational-limits
 Adanti
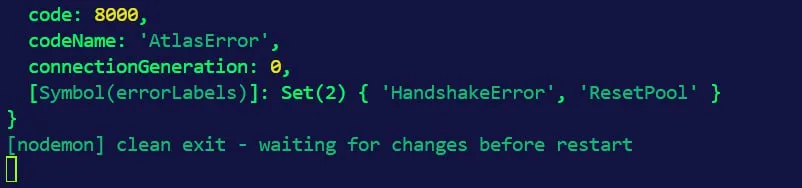 Adanti
app.use(cors());
app.use(express.json());
app.use("/auth", authRouter);
const start = async () => {
try {
await mongoose.connect(
"url..."
);
app.listen(PORT, () => console.log(`Server started on PORT ${PORT}`));
} catch (e) {
console.log(e);
}
};
start();
Nick
 Aleksandr
Всем привет, нужна помощь народа.
В коллекции лежат такие данные:
[
{
"event": "REGISTRATE_PRODUCT",
"created_at": {
"$date": "2024-05-13T16:10:10.305Z"
}
},
{
"event": "UPDATE_PRODUCT",
"created_at": {
"$date": "2024-05-13T16:10:30.995Z"
}
},
{
"event": "REGISTRATE_PRODUCT",
"created_at": {
"$date": "2024-05-13T16:10:32.566Z"
}
},
{
"event": "UPDATE_PRODUCT",
"created_at": {
"$date": "2024-05-13T16:10:54.909Z"
}
}
]
Нужно написать аггрегирующий запрос, с добавлением поля delay, которого равно разнице значений created_at текущего документа и предыдущего, отсортированного по полю created_at, вычислять данное значение нужно для определенного event. то есть UPDATE_PRODUCT вычисляется только для UPDATE_PRODUCT
Пробовал группировать с помощью
{
$group: {
_id: "$event",
data: {
$push: "$$ROOT"
}
}
}
Затем получаю, вложенный массив документов, после не получается добавить новое поле с помощью addFields
Nick
Всем привет, нужна помощь народа.
В коллекции лежат такие данные:
[
{
"event": "REGISTRATE_PRODUCT",
"created_at": {
"$date": "2024-05-13T16:10:10.305Z"
}
},
{
"event": "UPDATE_PRODUCT",
"created_at": {
"$date": "2024-05-13T16:10:30.995Z"
}
},
{
"event": "REGISTRATE_PRODUCT",
"created_at": {
"$date": "2024-05-13T16:10:32.566Z"
}
},
{
"event": "UPDATE_PRODUCT",
"created_at": {
"$date": "2024-05-13T16:10:54.909Z"
}
}
]
Нужно написать аггрегирующий запрос, с добавлением поля delay, которого равно разнице значений created_at текущего документа и предыдущего, отсортированного по полю created_at, вычислять данное значение нужно для определенного event. то есть UPDATE_PRODUCT вычисляется только для UPDATE_PRODUCT
Пробовал группировать с помощью
{
$group: {
_id: "$event",
data: {
$push: "$$ROOT"
}
}
}
Затем получаю, вложенный массив документов, после не получается добавить новое поле с помощью addFields
А в коде это сделать никак? Просто в монге это будет ужасный запрос и который может быть нестабилен на больших объемах выборок
 ⬤Максим
Ребят, Привет! Подскажите по sharded cluster.
архитектура следующая:
2 конфиг сервера в реплкие
2 сервера с данными
и 1 mongos экземпляр. Все сервера добавились без проблем и работают вместе, вроде без ошибок.
но когда я хочу я хочу создать базу данных и коллекцию через mongos
db.mycollection.insertOne({ "name": "John", "age": 30 })
то получаю сообщение MongoServerError[NoShardingEnabled]: Cannot accept sharding commands if not started with --shardsvr
но притом на серверах с данными создалась и база, и коллекция . что может быть не так?
⬤Максим
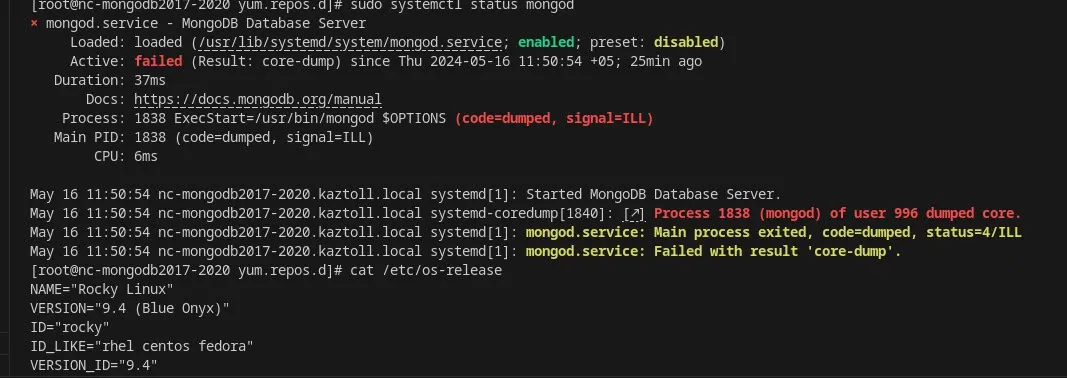
а монга как запущена? он же вон просит --shardsrv
запускаю через systemd ExecStart=/usr/bin/mongod --dbpath /opt/mongodb --config /etc/mongodb/mongod.conf
а роль указываю в файле с конфигом storage:
dbPath: /opt/mongodb/mongodb
journal:
enabled: true
systemLog:
destination: file
logAppend: true
path: /opt/mongodb/log//mongod.log
net:
port: 27017
bindIpAll: true
processManagement:
timeZoneInfo: /usr/share/zoneinfo
pidFilePath: /opt/mongodb/mongo.pid
sharding:
clusterRole: shardsvr
replication:
replSetName: datasrv
 andreyvsc
Ну остановите через systemd и запустите ручками с опцией --shardsrv. Если поможет, потом в systemd переделаете
Andry
Подскажите пожалуйста мне нужно реализовать поиск уникальных значений в поле
Andry
есть два метода db.collection.distinct() и могу через db.collection.aggregate() - как лучше и быстрее главное будет работать?
⬤Максим
Ну остановите через systemd и запустите ручками с опцией --shardsrv. Если поможет, потом в systemd переделаете
я уже разобрался, спасибо.
в доке просто написано replication:
replSetName: <replica set name>
ну я везде одно имя и захерачил, кто же мог подумать, что это плохая идея
Kvhqm
А в коде это сделать никак? Просто в монге это будет ужасный запрос и который может быть нестабилен на больших объемах выборок
О, кстати у меня долго в голове крутился подобный вопрос. А если делать что-то вместо агрегации на больших объемах, не приведёт ли это к непредвиденным последствиям, типа супер долгой обработки и т.д.
 Богдан
Всем привет!
Подскажите, какую структуру сделать в монго для приёма платежей за услуги и подписки.
Делаю сайт по генеалогии, где пользователи могут купить подписку и заказать услугу по поиску.
Основное, что пока не понял, это нужно ли делать разные коллекции для списания средств с карты пользователя и для списания средств со счёта внутри сайта или это можно хранить в одной коллекции.
В общем тема мне непонятна, поэтому даже вопрос не могу сформулировать)
 Нуриддин
Всем привет!
Подскажите, какую структуру сделать в монго для приёма платежей за услуги и подписки.
Делаю сайт по генеалогии, где пользователи могут купить подписку и заказать услугу по поиску.
Основное, что пока не понял, это нужно ли делать разные коллекции для списания средств с карты пользователя и для списания средств со счёта внутри сайта или это можно хранить в одной коллекции.
В общем тема мне непонятна, поэтому даже вопрос не могу сформулировать)
Ну тут на вкус и цвет. Но перед тем как решать как хранить данные задайте себе вопрос об том как много данных к вам придёт, и какие данные от вас будут требовать сайты. Если держать ответы на эти вопросы в уме, возможно вы естественным образом придёте к структуре данных которую хотите хранить. А дальше уже разграничиваете структуры опираясь на бизнес логику
Нуриддин
для монги, многого не надо. Вы можете придумать очень много вариантов структуры, но только у вас есть понимание бизнес логики и оптимизировать ваши запросы в зависимости от факторов.
Умид
Добрый вечер
Я новичок в этой сфере и начал в mongodb создания database добавление коллекции и документов всё это прописал на командном строке Mongosh
Дальше уже не знаю что делать можете посоветовать какие этапы изучить чтобы ориентироваться в дальнейшем
 yopp
Для денежных операций надежнее всегда иметь единственный источник всех операций, которые как-то влияют на баланс пользователя — единственная коллекция.
Ещё лучше если записи в этой коллекции не могут изменятся, а только добавляются
Все остальные данные либо хранить дополнительно в этой коллекции как метаданные, либо завести отдельные коллекции по типам операций
Такая организация сильно упрощает учет
yopp
Плюс с 5 версии есть time series, такие данные можно очень компактно хранить, но в этом случае точно нужно складывать дополнительную информацию в отдельные коллекции
yopp
Добрый вечер
Я новичок в этой сфере и начал в mongodb создания database добавление коллекции и документов всё это прописал на командном строке Mongosh
Дальше уже не знаю что делать можете посоветовать какие этапы изучить чтобы ориентироваться в дальнейшем
Здравствуйте! На https://learn.mongodb.com очень хороший набор курсов по монге
 Евгений
 yopp
KT
 Нуриддин
Nick
Andry
The maximum BSON document size is 16MB or 16777216 bytes. All conversions should use base-2 scale, e.g. 1024 kilobytes = 1 megabyte.
Nick
в коде есть такой коммент
https://github.com/mongodb/mongo/blob/master/src/mongo/db/update/path_support.h#L52
// Cap on the number of nulls we'll add to an array if we're inserting to an index that
// doesn't exist.
суля по тесту такое возникает когда пытаются создать массив с индексом больше чем лимит в 1.5кк через
array.2000000=dsafa
Nick
не используйте числа вназваниях полей, конвертните в строку
Nick
даже решит каст в строку
yopp
в большинстве случаев такая схема будет большой проблемой, так как у вас появляются динамические имена полей
а значения имён полей не покрываются индексами и с ними невероятно сложно работать в агрегациях
yopp
т.е поменяйте схему таким образом, чтоб айди пользователя было значением, а не ключом
Nick
а если так через апдейты делаете, то да добавлять префикс/суффикс. Но как уже отметили надо понимать что будут потенциальные проблемы (собственно вы прям сразу в них уже вляпались)
Black
В чем принципиальная разница между embded и reference?
Nick
В чем принципиальная разница между embded и reference?
ембеддед это поддокумент внутри этого документа, реф - есть связанный документ гдето еще
Black
В чём идея computed паттерна?
 Назар
всем привет. Мне нужно сделать insert допустим 5-10-100 документов. Какие на практите плюсы и минусы делать это через bulk? Во сколько раз быстрее если быстрее? Как зависит от колличества?
Nick
всем привет. Мне нужно сделать insert допустим 5-10-100 документов. Какие на практите плюсы и минусы делать это через bulk? Во сколько раз быстрее если быстрее? Как зависит от колличества?
Bulk в общем случае сокращает издержки на сетевой обмен. Если у вас итак вставка пачкой, то и просто заинсертите всю пачку. Балк можно использовать тут если вы готовы отслеживать в случае ошибок какой именно инсерт не отработал и его повторно отправлять
-
В чём идея computed паттерна?
Идея computed паттерна заключается в том, чтобы выполнять вычисления и хранить результат в соответствующем документе и коллекции.
Если нужно повторить вычисления или сохранить возможность их повторного выполнения, достаточно сохранить источники вычислений.
Евгений
 Александр
Нихуя
Шынгыс
добрый день, друзья. в истории чата поискал, вроде не обсуждалась эта тема. Тема такая. У меня на сервере постепенно увеличивается activeSessionsCount. Где и как найти эти сессии? не подскажете?
Евгений
 Евгений
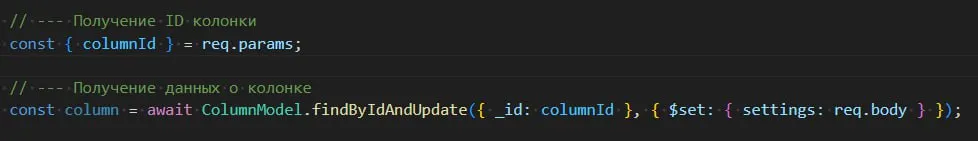
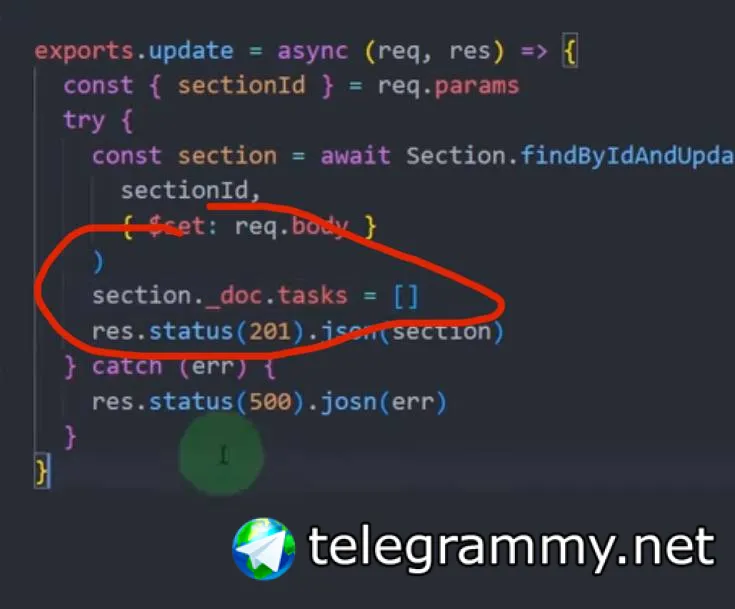
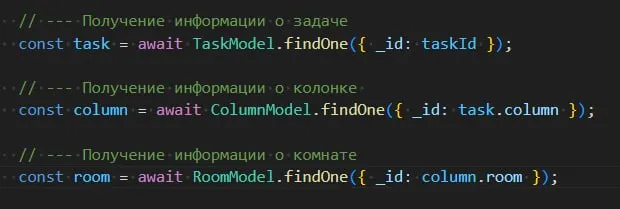
Схемы примерно такие:
Задача/Task: Хранит ID колонки/column
Колонка/Column: Хранит ID комнаты/room
Евгений
Добавлять в схему Задачи/Task - ID комнаты/room не хотелось бы