а, тапалку чтоль делаете
Да
 ADM


 Nick
Да
вы делаете ошибку, зачем сохранять каждый клик, если в том же хомяке сохраняет либо при достижении лимита энергии либо по таймауту раз в несколько секунд. Этакий бачинг как раз чтобы не мучить серваки, иначе бы никакого железа бы не хватили обрабатывать каждый запрос от тапальщиков.
Собсна если вдруг зачемто захочется прям каждый сохранять, то это значит что нужно нормально выстраивать работу фронта и бэка с базой - на фронте работать в синхронном режиме и ждать ответа от бэка что все сохранилось, на бэке поставить проверки на ошибки при записи в БД и ретраи и также дожидаться ответа что апдейты отработали в бд. Но это подход не для тапалок, т.к. никто не будет тапать на телефоне с говноинтернетом и ждать пока клик отработает в базе.
 Roman Khonichev
Здравствуйте, подскажите пожалуйста. Для кликера использую бд монго. Но не все клики успевает записать. Подскажите пожалуйста как сделать что бы сразу обновлялся документ
в голову приходит простой вариант, доступ к пустому файлу, парсинг логов по возможности, потом складывание в базу
Roman Khonichev
либо держите в памяти, потом батчами сохраняйте
ADM
либо держите в памяти, потом батчами сохраняйте
Примерно так и думал, но зачем-то полез сразу в бд
Nick
либо держите в памяти, потом батчами сохраняйте
надеюсь это не предложение использовать кэши на стороне сервера?
Roman Khonichev
надеюсь это не предложение использовать кэши на стороне сервера?
почему нет, тот же редис отлично с этим справится, если конечно не страшно потерять клики)
Roman Khonichev
в тот же кликхаус без накопления эффективно не сохранить
Nick
почему нет, тот же редис отлично с этим справится, если конечно не страшно потерять клики)
ну если пользователи только на вафле и на лте сидят, то наверное и да. Но это все бессымсленно, т.к. отдельное событие клика в тапалке это просто инкремент, а не какоето событие для аналитики с кучей метаинфомрации
Roman Khonichev
ну если пользователи только на вафле и на лте сидят, то наверное и да. Но это все бессымсленно, т.к. отдельное событие клика в тапалке это просто инкремент, а не какоето событие для аналитики с кучей метаинфомрации
подробностей не было, может они там тремор конечностей считают и координаты тапа записывают)
Nick
подробностей не было, может они там тремор конечностей считают и координаты тапа записывают)
было же - тапалку делает человек, там ничего не записывается никогда, проекты не такого уровня)
Roman Khonichev
было же - тапалку делает человек, там ничего не записывается никогда, проекты не такого уровня)
фантазеры разные бывают)
Nick
фантазеры разные бывают)
таким фантазерам никогда нагрузки большой не получить, да и будем честны никакой не получить, так что нормальные советы из коммерческих фин систем им не нужны
ADM
Roman Khonichev
все на клиенте
 yopp
таким фантазерам никогда нагрузки большой не получить, да и будем честны никакой не получить, так что нормальные советы из коммерческих фин систем им не нужны
Для одной тапалки мы сделали через редис и раз в некоторое время сливали тапы в монгу
Редис не выдержал нагрузки и пришлось его быстро менять на dragonfly :)
yopp
Для отслеживания форда инфу по тапам агрегировали и хранили для каждого батча как агрегированные значения
Nick
Для отслеживания форда инфу по тапам агрегировали и хранили для каждого батча как агрегированные значения
А нужно ли фрод отслеживать?)
yopp
тогда ответ выше, суммируешь, отсылаешь инкремент
Примерно 1% пользователей сразу нальёт 10к запросов в секунду с инкрементами на миллиард ;)
yopp
Там два вида форда: расковыривальщики протокола, которые скриптами начинают лить тапы или те кто автокликером пользуется.
Первые хуже, так как делают *очень* много нагрузки
Nick
Плохо :)))
вот поэтому и странно что аж антифрод нужен с анализом, это ж дорого без прямого дохода от самой тапалки в виде всяких бустов
yopp
Но тапалки технически очень интересный кейс когда много трафика, хотя казалось бы, что проще чем просто инкремент делать :)
Тот-же редис если в один ключ лить большие потоки инкрементов упирается в одно ядро. Так что если несколько тысяч человек долбят один ресурс, редис не подходит
Roman Khonichev
странный кейс, деньги есть, железа нет)
yopp
вот поэтому и странно что аж антифрод нужен с анализом, это ж дорого без прямого дохода от самой тапалки в виде всяких бустов
Зависит от тапалки и модели, где-то надо ловить и ловить задёшево :) по этому всякие дубовые решения
Roman Khonichev
отложенный антифрод с баном
yopp
странный кейс, деньги есть, железа нет)
Железо есть, но редис не умеет в много ядер, а одно ядро это не так уж и много
Nick
Но тапалки технически очень интересный кейс когда много трафика, хотя казалось бы, что проще чем просто инкремент делать :)
Тот-же редис если в один ключ лить большие потоки инкрементов упирается в одно ядро. Так что если несколько тысяч человек долбят один ресурс, редис не подходит
да как задача интересно, анализировал как бы такое сделать, но после раскрутки хомяка понял что можно очень сильно поспекулировать и на фронте и на бэке, разве что пользователей реально много будет
yopp
да как задача интересно, анализировал как бы такое сделать, но после раскрутки хомяка понял что можно очень сильно поспекулировать и на фронте и на бэке, разве что пользователей реально много будет
В большинстве случаев хватает простых сигналов: пишем в кольцевой буфер дельту между тапами и считаем по ним count, avg, stdev и ещё по мелочи. Переодически скидываем сигналы в базу. Потом выбираем медианное значение и всех кто за двумя сигмами стабильно больше баним
Тех кто за одной сигмой наказываем капчей
yopp
В timeseries это дешево хранить и удобно анализировать
yopp
Но мы и с w:1, j:0 писали, потому что ну потерял ты статы, ну и фиг с ней :)
Roman Khonichev
яндекс для тонны событий рекомендовал свой тарантул, можно презентации и цифры посмотреть... но тут действительно чем проще, тем лучше
 Tim🌵
И еще оказалось, что $merge не может в timeseries...то есть никак нельзя сделать continuous aggregation из timeseries в timeseries, как у того же timescale db. Короче какая-то слишком узко-применительная технология timeseries от монги, так как видимо они не смогли нормально внедрить ее в существующий core монги и сейчас либо забьют, либо будут делать костыли
 Oleh Kopyl
Здравствуйте. Нужна помощь по Vector Search.
Запускаю поиск, с фильтром, а мне ошибка
OperationFailure: PlanExecutor error during aggregation :: caused by :: Path 'video_name' needs to be indexed as token
Но я сделал все согласно инструкции тут:
https://www.mongodb.com/docs/atlas/atlas-search/field-types/token-type
Сейчас мои иднексы выглядят так:
https://i.imgur.com/fJTMKSk.png
https://i.imgur.com/JpM1U17.jpeg
https://i.imgur.com/TcOkn9z.jpeg
https://i.imgur.com/xtYL2pp.jpeg
Вот код aggregation:
video_path = "C42ULzECl9m.mp4"
sample_embeds = db_embeds.find_one({"video_name": video_path})
pipeline = [
{
'$vectorSearch': {
'index': 'embeds',
'path': 'embed',
'queryVector': sample_embeds['embed'],
'numCandidates': 10,
'limit': 10,
'filter': {
"video_name": { "$ne": video_path } # Exclude documents where exclude_from_search is True
}
}
},
{
"$project": {
"embed": 1,
"video_name": 1,
"score": { "$meta": "vectorSearchScore" }
}
}
]
db_embeds.aggregate(pipeline)
Подскажите пожалуйста как фиксить ошибку :)
Хочу сделать так, чтобы векторный поиск не искал документы с определенным именем...
Oleh Kopyl
Здравствуйте. Нужна помощь по Vector Search.
Запускаю поиск, с фильтром, а мне ошибка
OperationFailure: PlanExecutor error during aggregation :: caused by :: Path 'video_name' needs to be indexed as token
Но я сделал все согласно инструкции тут:
https://www.mongodb.com/docs/atlas/atlas-search/field-types/token-type
Сейчас мои иднексы выглядят так:
https://i.imgur.com/fJTMKSk.png
https://i.imgur.com/JpM1U17.jpeg
https://i.imgur.com/TcOkn9z.jpeg
https://i.imgur.com/xtYL2pp.jpeg
Вот код aggregation:
video_path = "C42ULzECl9m.mp4"
sample_embeds = db_embeds.find_one({"video_name": video_path})
pipeline = [
{
'$vectorSearch': {
'index': 'embeds',
'path': 'embed',
'queryVector': sample_embeds['embed'],
'numCandidates': 10,
'limit': 10,
'filter': {
"video_name": { "$ne": video_path } # Exclude documents where exclude_from_search is True
}
}
},
{
"$project": {
"embed": 1,
"video_name": 1,
"score": { "$meta": "vectorSearchScore" }
}
}
]
db_embeds.aggregate(pipeline)
Подскажите пожалуйста как фиксить ошибку :)
Хочу сделать так, чтобы векторный поиск не искал документы с определенным именем...
А, походу нужно было не создавать новый индекс, а менять векторный.
https://www.mongodb.com/docs/atlas/atlas-vector-search/vector-search-type/#about-the-filter-type
S
Привет, есть ли какой-то способ посчитать количество уникальных значений поля при $group? Нашел вариант через $addToSet и потом вывести размер сета, но боюсь, что такая агрегация будет больше лимита в 16MB из-за хранения всех значений в сете.
Nick
Привет, есть ли какой-то способ посчитать количество уникальных значений поля при $group? Нашел вариант через $addToSet и потом вывести размер сета, но боюсь, что такая агрегация будет больше лимита в 16MB из-за хранения всех значений в сете.
если просто уникальных, то просто группируете по этому полю и потом $count
 Ivan
Привет! В чат теперь апрувы нужны?
 Данил
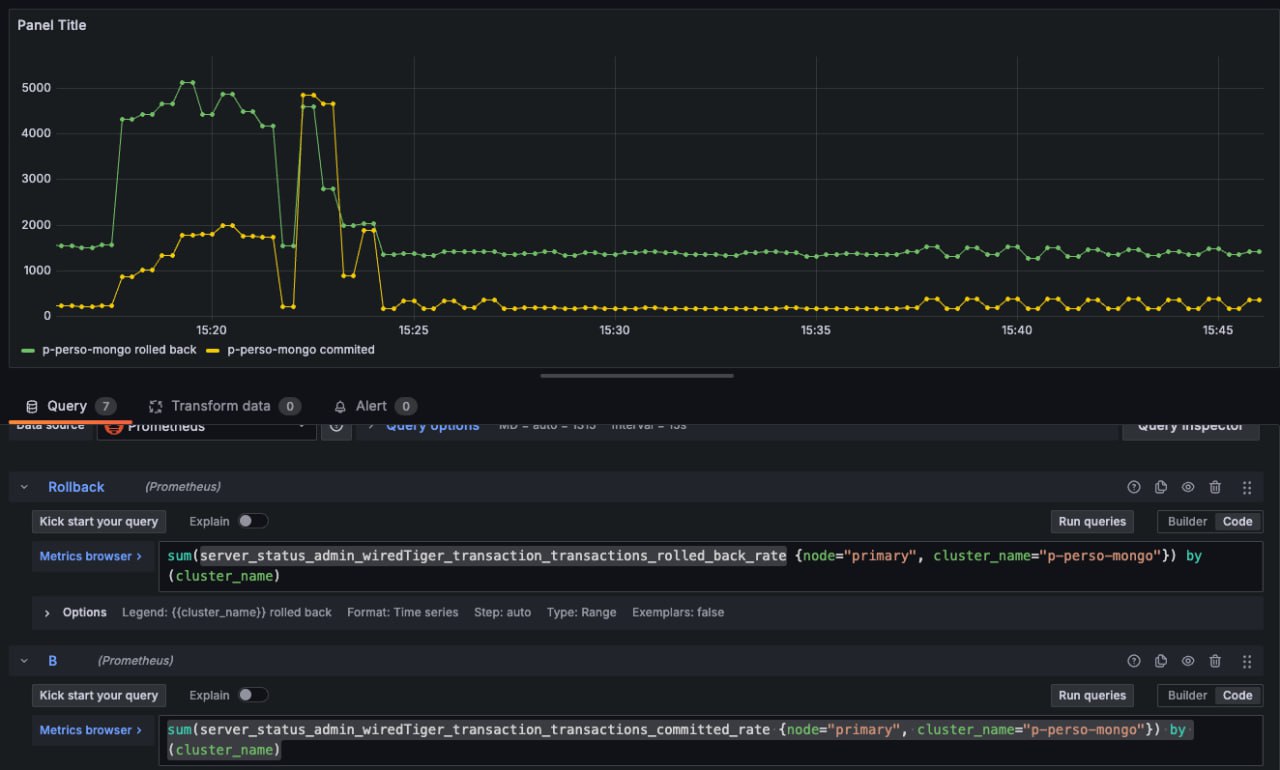
Привет! Может кто-то сталкивался с таким и может объяснить. В MongoDb есть метрики, отвечающие за кол-во wired tiger транзакций commited и rolled back. У нас соотношение 1 (commited) к 6 (rolled back). Сначала казалось, что это большая проблема и данные записываются условно с 5-ой попытки. Но потом нашел этот пост, в котором говорится, что это не такая очевидная метрика. Но описания толкового не могу найти. Может кто-то сталкивался и подскажет обращали ли внимание на метрики такие или нет у себя в сервисах. MongoDb у нас представляет кластер из двух шардов, шард состоит из primary и двух secondary
Данил
 yopp
Привет! Может кто-то сталкивался с таким и может объяснить. В MongoDb есть метрики, отвечающие за кол-во wired tiger транзакций commited и rolled back. У нас соотношение 1 (commited) к 6 (rolled back). Сначала казалось, что это большая проблема и данные записываются условно с 5-ой попытки. Но потом нашел этот пост, в котором говорится, что это не такая очевидная метрика. Но описания толкового не могу найти. Может кто-то сталкивался и подскажет обращали ли внимание на метрики такие или нет у себя в сервисах. MongoDb у нас представляет кластер из двух шардов, шард состоит из primary и двух secondary
Эти метрики транзакцияй внутри движка wiredTiger и они слабо коррелируют с реальными логическими транзакциями самой монги
Для логических транзакций другая метрика в serverStatus.transactions.totalAborted
https://www.mongodb.com/docs/v6.2/reference/command/serverStatus/#transactions
Oleh Kopyl
 Oleh Kopyl
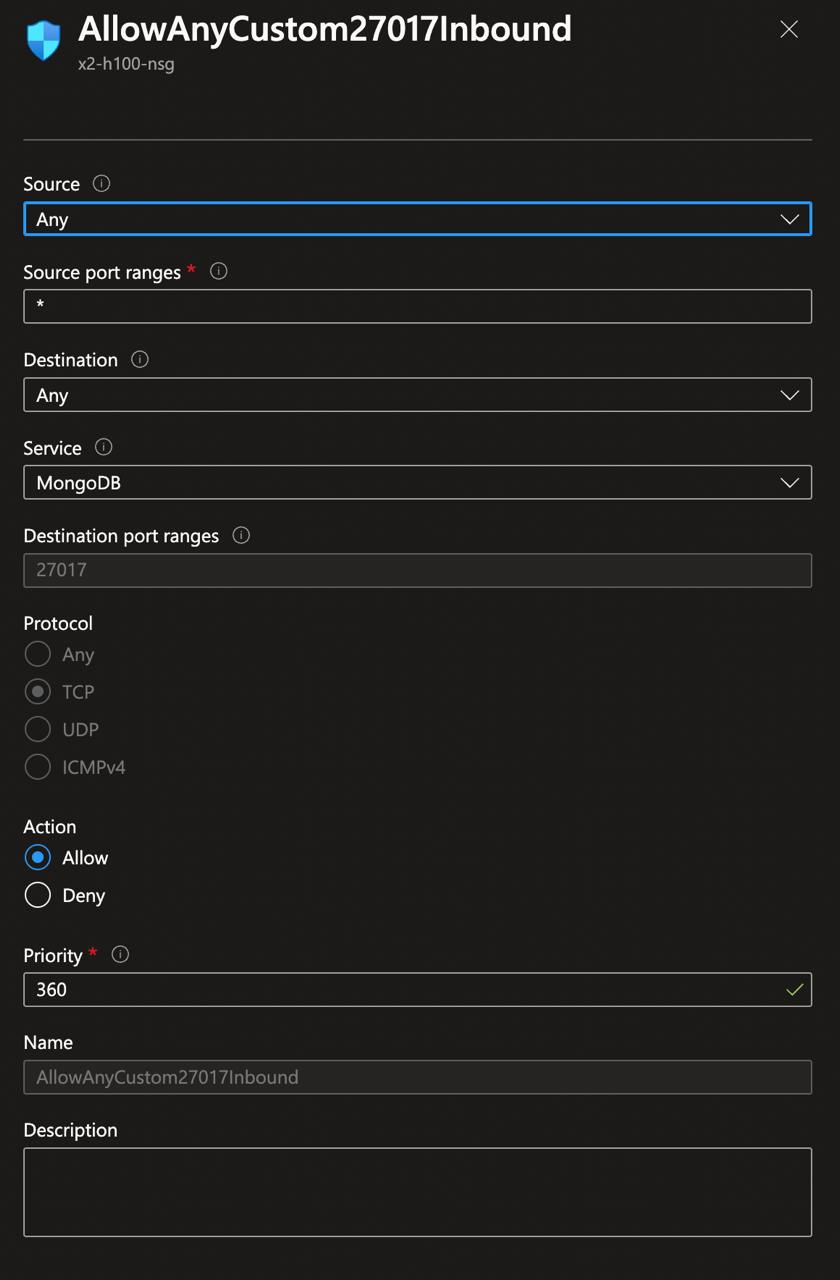
 Abdurazzoq
Чуть больше 1м документов на 26+ гигов
Ну если 26гб+ то это нормальное случи думаю, но появится вопрос - как долго висит?
Abdurazzoq
У меня не было такой опыт, но, если команду не смогла обработать за день то уже есть какая та проблема
Oleh Kopyl
Ну если 26гб+ то это нормальное случи думаю, но появится вопрос - как долго висит?
Ну минуту точно виснет. На ноуте виснет до 10 секунд
Abdurazzoq
Abdurazzoq
Ну минуту точно виснет. На ноуте виснет до 10 секунд
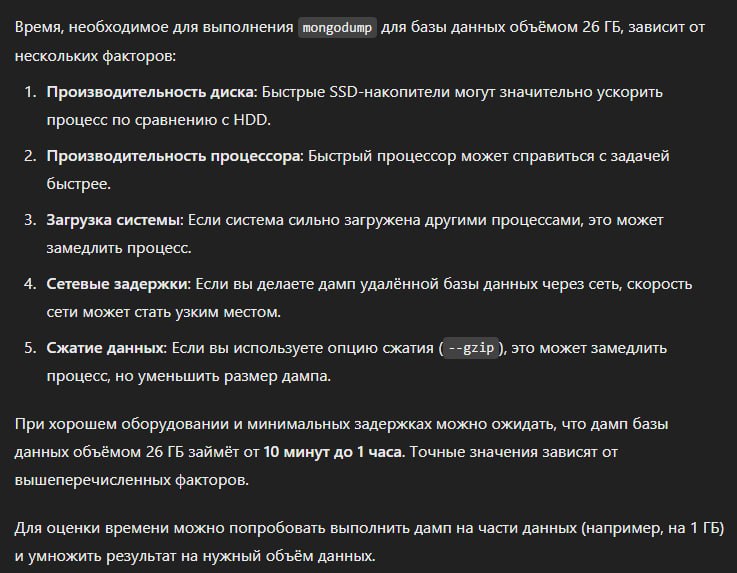
Ну пару минут это очень малое время для dump 26гб данных
Abdurazzoq
Советую дампить сначала самую маленькую коллекцию, если будет работать, это означает что нужно будет много времени что бы дампить весь данный
Oleh Kopyl
 Abdurazzoq
Хммм интересно
 Артем
Всем привет, пишу приложение на node.js + mongoose, мне нужно удалять документы из коллекции с интервалом 1 день и вызывать обработчик после удаления. Не совсем понятно как работает watch(change streams), т.к. написано, что рекомендуется использовать MongoDB Atlas в проде. Сработает ли это для MongoDB Community?
Артем
доков много будет удаляться?
не более одного документа за раз. В день ну штук 100 будет удаляться
Nick
не более одного документа за раз. В день ну штук 100 будет удаляться
ну так зачем тогда стримы, сделайте выборку и потом по одному доку удаляйте и выполняйте логику
Артем
ну так зачем тогда стримы, сделайте выборку и потом по одному доку удаляйте и выполняйте логику
я просто хотел логику удаления документов на mongo положить. Чтобы документ по истечению времени сам из базы удалялся. Ты предлагаешь логику проверки истекших документов в приложении реализовать? Здесь не совсем понял
Nick
Я имел в виду ttl который mongo предоставляет
а что будете делать если удаление пройдет а логика обработки свалится? как повторно будете обрабатывать
Nick
любые операции требующие какуюто доп логику по факту удаления требуют либо транзакций либо маркеров, чтобы это было стабильно. Использовать инструмент бд который в первую очередь рассчитан на очистку места, чтобы не распухали таблицы с временной информацией тут некорректно
Артем
а что будете делать если удаление пройдет а логика обработки свалится? как повторно будете обрабатывать
Вопрос хороший, не спорю, тогда можешь пояснить, что ты имел в виду под "сделать выборку и потом по одному удаляйте"?
Nick
Вопрос хороший, не спорю, тогда можешь пояснить, что ты имел в виду под "сделать выборку и потом по одному удаляйте"?
find
foreach
update // mark before delete logic
res = doLogic()
if(res)
delete
else alarm
Nick
find
foreach
update // mark before delete logic
res = doLogic()
if(res)
delete
else alarm
апдейт нужен чтобы промаркировать что работа уже ведется или была начата но изза чегото свалилась и т.п. чтобы потом разгребать
Nick
Вопрос хороший, не спорю, тогда можешь пояснить, что ты имел в виду под "сделать выборку и потом по одному удаляйте"?
в целом можно также на стримы приземлить, только помнить что если логика ссущественно и она должна всегда выполниться при удалении, то надо соответсвенно куда прихранивать таску на запуск логики для овзмонжости повторно ее дернуть. В очередь там какуюить персистентную или в другую коллекцию или еще чтото. В общем недостаточно просто взять ченж стрим и по нему идти
Артем
Спасибо, дал пищу для размышлений)
 mshsacc
Привет всем! Можете порекомендовать сорсы чтоб учить монго с nodejs кроме официальной документации