 Vladimir


Теперь понятнее стало The mongo shell (as at 3.4.5) does not support arithmetic with NumberDecimal values. The decimal type is not native to JavaScript, so decimal values in the shell are strings representing the BSON value stored in MongoDB.
S
на каждое поле по индексу, планировщик сам разберется
Это точно так? Не увидел нигде в доке такого
Vladimir
Хотя мне до конца не понятно, тип данных везде один, но в некоторых случаях сложение отрабатывает, как с числами, а в некоторых, как со строками
 yopp
Привет, я же правильно понимаю, что если у меня может быть match по полю a, b и по ним вместе, то мне необходимо все равно два индекса? { a: 1, b: 1} и { b: 1 }. И соответственно что тогда делать когда у меня таких полей 5 штук ? Нужно как-то по умному продумать дофига индексов, которые покроют все случаи?
В таких случаях эффективнее сложить поля в массив объектов в виде
fields: [{type: foo, value: bar}, type: baz, value: bar2}]
И сделать составной индекс
fields.type, fields.value
Тогда поиск по паре type/value будет покрываться индексу, включая несколько пар условий одновременно
Vladimir
братцы, может кто-нибудь сможет подсказать варианты, не могу разобраться с агрегацией https://stackoverflow.com/questions/78955731/how-to-sum-by-date-a-list-of-items
 Kirilll
Всем привет
Кто может подсказать, возможно ли в adminCommand при указании WiredTiger cacheSize не указывать точный размер кэша, а указать кол-во от общего размера оперативной памяти
а-ля как в конфиге постгри, например
yopp
Всем привет
Кто может подсказать, возможно ли в adminCommand при указании WiredTiger cacheSize не указывать точный размер кэша, а указать кол-во от общего размера оперативной памяти
а-ля как в конфиге постгри, например
Здравствуйте. Нет, размер задаётся только в гб. Если не указывать то 50%
А какой у вас кейс для изменения размера кеша?
Kirilll
Здравствуйте. Нет, размер задаётся только в гб. Если не указывать то 50%
А какой у вас кейс для изменения размера кеша?
вот хотелось бы указать 70%, к примеру
yopp
вот хотелось бы указать 70%, к примеру
В этом случае оставьте по дефолту. Увеличение размера кеша выше 50% на самом деле уменьшит объём закешированных данных в памяти
в самом кеше данные хранятся в оригинальном виде, а сжимаются только при сбросе на диск. Монга расчитывает что остальные ~50% ос заберёт под дисковый кеш
если сделать выше половины, то под дисковый кеш памяти будет меньше
Kirilll
В этом случае оставьте по дефолту. Увеличение размера кеша выше 50% на самом деле уменьшит объём закешированных данных в памяти
в самом кеше данные хранятся в оригинальном виде, а сжимаются только при сбросе на диск. Монга расчитывает что остальные ~50% ос заберёт под дисковый кеш
если сделать выше половины, то под дисковый кеш памяти будет меньше
хм
изначальная проблема в том, что сейчас превысил кол-во объема данных рекомендуемое монгой, собственно чуть более тяжеловесные запросы, которые раньше отрабатывали без проблем, сейчас делают базе плохо
причем, что часть оперативы на машине лежит без дела
предположил, что увеличение кэша поможет решить проблем, но видимо ошибся
yopp
хм
изначальная проблема в том, что сейчас превысил кол-во объема данных рекомендуемое монгой, собственно чуть более тяжеловесные запросы, которые раньше отрабатывали без проблем, сейчас делают базе плохо
причем, что часть оперативы на машине лежит без дела
предположил, что увеличение кэша поможет решить проблем, но видимо ошибся
а какие объёмы данных? 🙂 покрываются ли все запросы индексами?
 Егор
как в motor сделать пул соединени?
или AsyncIoMotorClient под капотом делает?
 Артем
как в motor сделать пул соединени?
или AsyncIoMotorClient под капотом делает?
Пул делает pymongo внутри
По умолчанию там размер 100 вроде
maxPoolSize параметр у клиента
Егор
Пул делает pymongo внутри
По умолчанию там размер 100 вроде
maxPoolSize параметр у клиента
from motor.motor_asyncio import AsyncIOMotorClient
class DataBase:
def __init__(self,
dsn: str):
self.client = AsyncIOMotorClient(
dsn
)
Егор
from motor.motor_asyncio import AsyncIOMotorClient
class DataBase:
def __init__(self,
dsn: str):
self.client = AsyncIOMotorClient(
dsn
)
Я вот, про эту штуку. Она вроде пул под капотом создает
Kirilll
а какие объёмы данных? 🙂 покрываются ли все запросы индексами?
объем: 11 шардов по 4 Тб
стандартные запросы покрываются индексами
на стандартной нагрузке пока монга живет нормально
yopp
объем: 11 шардов по 4 Тб
стандартные запросы покрываются индексами
на стандартной нагрузке пока монга живет нормально
Нормальные объёмы, 4тб на ноду это совсем не много
а тяжелые запросы какой структуры? широкие выборки и аналитика или сложные условия по большим объёмам?
Kirilll
условные монгоэкспорты с широкой выборкой и большим кол-вом полей
либо тяжелые каунты, пусть и по индексам
mk
Джельтмены, кто нибудь алерты для Replication Lag в атласе не через гуи создавал?
yopp
условные монгоэкспорты с широкой выборкой и большим кол-вом полей
либо тяжелые каунты, пусть и по индексам
если шарды в PSS, то с readPreferrence secondary/secondaryPreferred можно перекинуть нагрузку на секондари, для таких задач это вполне допустимый подход
если проблема в скорости, тот тут увы только масштабированием. вероятнее всего выборки i/o bound и вертикально можно slc nmve с хорошим контроллером выжать. если там в принципе не nvme то почти любым можно выжать 🙂
Kirilll
если шарды в PSS, то с readPreferrence secondary/secondaryPreferred можно перекинуть нагрузку на секондари, для таких задач это вполне допустимый подход
если проблема в скорости, тот тут увы только масштабированием. вероятнее всего выборки i/o bound и вертикально можно slc nmve с хорошим контроллером выжать. если там в принципе не nvme то почти любым можно выжать 🙂
Ну в целом одно из первых предположений по решению проблемы, но захотелось поэкспериментировать))
Благодарю за оперативную помощь!
 Yura
хм
изначальная проблема в том, что сейчас превысил кол-во объема данных рекомендуемое монгой, собственно чуть более тяжеловесные запросы, которые раньше отрабатывали без проблем, сейчас делают базе плохо
причем, что часть оперативы на машине лежит без дела
предположил, что увеличение кэша поможет решить проблем, но видимо ошибся
Увеличивать объем кэша wt не несет в себе никакого практического смысла, т.к. монга всё равно автоматически потребит больше дефолтных 50%, если ей это потребуется, вплоть до падения от ООМ.
 Артем
Всем привет! Кто нибудь пользуется PMM для бэкапа монги? Настроенны запланированные бэкапы и в один момент начали выдавать ошибку:
Job terminated with error: not found
В логах подробностей нету - та же самая ошибка
Oleg
 Oleg
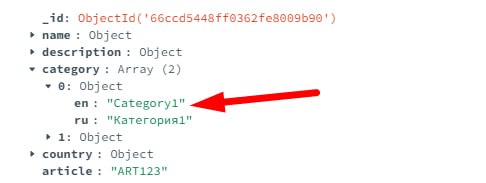
Если хранить имена категорий прямо в бд, потом возникает сложность обратного мапинга на клиенте, потому что в документе нет id категории.
yopp
Увеличивать объем кэша wt не несет в себе никакого практического смысла, т.к. монга всё равно автоматически потребит больше дефолтных 50%, если ей это потребуется, вплоть до падения от ООМ.
Это не верное утверждение.
Да, монга может выделять под структуры необходимые для обработки запросов сверх установленного размера кеша wt, например под сортировки и агрегации, но сам размер кеша жестко ограничен указанным размером и не будет превышен
Если у вас наблюдается другая ситуация на поддерживаемых версиях, то заведите пожалуйста тикет в jira.mongodb.org, это не нормальное поведение
yopp
Oleg
Какой решение выбрать ?
Может рядом хранить id категории? Чтобы на клиенте можно было выбрать нужный элемент ?
Oleg
Мне нужно хранить информацию о товаре на разных языках. Придерживаюсь модели descriltion: ru: opisanie, en: desxription для всех полей, которые требуют перевода
 Ξ
ребят, а в compass в aggregations в pipeline output (preview) могут показываться промежуточные результаты, да (до полного выполнения агрегации)? потому что у меня там выходит результат не такой же, как в all results
Kirilll
Всем привет
Интересует опыт бекапа больших объемов из монги
кто какими средствами пользуется?
 Нуриддин
Всем привет
Интересует опыт бекапа больших объемов из монги
кто какими средствами пользуется?
А их всего 2 pbm и встроенное решение
Нуриддин
Чаще всего интузиасты создают скрипты для "инкрементального бэкапа" на основе второго варианта
Kirilll
Ну, неправда)
Wal-g еще гуглится, например)
 andreyvsc
Kirilll
Чаще всего интузиасты создают скрипты для "инкрементального бэкапа" на основе второго варианта
Ну вот может тут есть такие, кто на гитхабе держит такой проектик открытым)
Нуриддин
Ну вот может тут есть такие, кто на гитхабе держит такой проектик открытым)
Тут такая же ситуация как и с wal-g тем более от версии к версии бэкапа, могут не накатиться они
Нуриддин
Так что я бы не рисковал
Kirilll
Тут такая же ситуация как и с wal-g тем более от версии к версии бэкапа, могут не накатиться они
Ну, берешь основу с проекта, тестишь на воробушках
Допиливаешь, если нужно, мелочи под себя
Юзаешь
Не забываешь ставить звезды проекту)
Kirilll
Ну прям в общих чертах если
Думаю, идею ты понял))
Нуриддин
GitHub - BisratGirma/incremental-backup-mongodb
https://github.com/BisratGirma/incremental-backup-mongodb
Нуриддин
Вот корм для ваших воробушков, дерзайте
Нуриддин
Только pbm, как по мне, надёжнее
yopp
GitHub - BisratGirma/incremental-backup-mongodb
https://github.com/BisratGirma/incremental-backup-mongodb
Вот такое делать совсем не стоит
yopp
В бесплатной монге есть три опции:
* mongodump
* оплог
* снепшоты
pbm это вариант с оплогом, который bpm умеет накатывать на данные создавая «чекпоинты»
С этим вариантом есть две проблемы:
* размер «чекпоинтов» будет примерно с размер дампа (если ничего не поменялось за последние года)
* RTO равен времени на развернуть чекпоинт из хранилища + время проигрывания оплога. А оплог наказывается медленно и в один поток, последовательно.
Снепшоты, если их настроить так, чтоб lvm не ломался или делать на официально не поддерживаемых zfs/btrfs, самый оптимальный вариант. Делать его с hidden реплики и хранить в холодном хранилище. На фс снепшоты обычно накатываются очень быстро, несколько снепшотов можно доставать из хранилища настолько быстро, насколько хватает сети. Плюс в снепшоты в отличии от оплога не будут содержать всю историю изменения документа между снепшотами, а только конечную версию (на деле там сложнее из-за COW)
Ну а дамп работает хорошо только на небольших объемах. Долго снимается и долго накатывается
Mark
Looking for someone good in Arduino
 Хикматжон
Всем привет
Интересует опыт бекапа больших объемов из монги
кто какими средствами пользуется?
Veeam последний версии заявила что умеет делать бекап с монги.
 Awned
Добрый день. Вы когда тестируется запись, обновление и чтение в монгу. Вы это мокайте? Или же поднимаете монгу в ci/cd
Амир
Добрый день. Вы когда тестируется запись, обновление и чтение в монгу. Вы это мокайте? Или же поднимаете монгу в ci/cd
тест контейнеры в интеграционных тестах приложения если нужно проверить
Viktar
Добрый день, подскажите, можно ли узнать какие файлы для хранения колекций и индексов используются. Ситуация такая, было удалено много колекций, но индексные файлы к ним почему то остались на диске. хотелось бы их удалить, что бы освободить место. `db.collection.stats({indexDetails:true}) показывает как называются файлы которые используются. но колекций достаточно много, поэтому может есть возможность получить все файлы одним разом?
 Юлиан🦉
Привет, а может дроп индексов как-то дропнуть коллекцию\записи? Произошёл инцидент, предположительно после операций с индексами, на локал и деве =(
 Nick
Добрый день, подскажите, можно ли узнать какие файлы для хранения колекций и индексов используются. Ситуация такая, было удалено много колекций, но индексные файлы к ним почему то остались на диске. хотелось бы их удалить, что бы освободить место. `db.collection.stats({indexDetails:true}) показывает как называются файлы которые используются. но колекций достаточно много, поэтому может есть возможность получить все файлы одним разом?
нормального способа нет, только вытаскивать список коллекций, по ним собирать имена индексов и коллекций и удалять все что будет вне этого списка. Только не спешите сразу удалять, для начала переместите куданить и посмотрите не сломается ли БД, а то мало ли
Viktar
нормального способа нет, только вытаскивать список коллекций, по ним собирать имена индексов и коллекций и удалять все что будет вне этого списка. Только не спешите сразу удалять, для начала переместите куданить и посмотрите не сломается ли БД, а то мало ли
Так и сделал. Написал на питоне скрипт, который собрал имена, и перенес файлы. Вот уже 2 часа полет нормальный. Если все будет ок, через неделю удалю
Viktar
Но странно что индексы вместе с коллекциями не удалились
Viktar
Я думаю, что я быстро удалил 1.3 ТБ данных и система не справилась. —repair показал что 5 коллекций попало в local.ophan. Думаю это индексы этих коллекций
 Tim🌵
Привет! Использую time series коллекцию, почему-то не используется индекс { timestamp: -1, _id: -1 } при сортировке. Таблица 4.75 GB. На обычной коллекции 500MB такой индекс используется. Кто-то знает почему с time series коллекцией такие проблемы?
Tim🌵
При использовании hint, он его использует, но время 110 секунд 🤯 Не понимаю в чем проблема
yopp
Надо написать статью про подводные камни ts
Если коротко, то данные в коллекции разбиваются на бакеты по двум измерениям: timeField и metaField, остальные поля складываются в бакет в виде сжатых колонок по алгоритму delta-of-deta enxoding
Когда вы запрашиваете данные, если запрос и сортировка не находятся в этих двух измерениях, то монге чтоб сделать сортировку нужно расжать все бакеты, реконструировать из них полноценные документы и потом отсортировать все это в памяти
Индекс тут помогает только сократить число бакетов которые нужно обработать
Если выборка по широкому условию, то будет медленно
В 8 версию обещали завести block processing: в случаях когда это возможно, данные в колонках будут сначала обрабатываться без трансформации в документы. Но там куча ограничений и в каком виде это будет в релизе пока не очень понятно. Фичу активно пилят, но в release notes про неё пока ни слова, есть шанс что в 8 не войдет или войдет частично. Могут и до 8.1 отложить, чтоб был дополнительный резон пользоваться атласом. Тогда в CE мы её не скоро увидим, возможно аж до следующего года, когда 9 выпустят
yopp
Но не думаю что сортировка хороший кейс для блочной обработки, но это уже надо джиру или исходники изучать на предмет того что они собираются таким образом ускорить.
Думаю что в первую очередь агрегаты типа группировок и всяких $sum/$min/$max.
Плюс такие кейсы и в других колончатых хранилищах не самые быстрые, так как источник везде один: чтоб отсортировать строку, надо сначала расжать и отсортировать колонки участвующие в сортировке, а потом уже реконструировать строку из других колонок. Так как обычно данные сжатые, это просто по индексам внутри блока не сделать, нужно расжать, потом найти индекс и вот это всё. В итоге такие запросы ездят случайным образом по куче блоков и это все плохо помещается в кеш процессора и нужно постоянно ходить в память, а там возможно ещё и на диск. Короче это кейс random i/o на сжатых данных
yopp
Кликхаус по-моему умеет сразу отсортировано хранить, чтоб под какой-то основной кейс упаковать данные, но мимо этого порядка проблема будет та же самая
Tim🌵
Надо написать статью про подводные камни ts
Если коротко, то данные в коллекции разбиваются на бакеты по двум измерениям: timeField и metaField, остальные поля складываются в бакет в виде сжатых колонок по алгоритму delta-of-deta enxoding
Когда вы запрашиваете данные, если запрос и сортировка не находятся в этих двух измерениях, то монге чтоб сделать сортировку нужно расжать все бакеты, реконструировать из них полноценные документы и потом отсортировать все это в памяти
Индекс тут помогает только сократить число бакетов которые нужно обработать
Если выборка по широкому условию, то будет медленно
В 8 версию обещали завести block processing: в случаях когда это возможно, данные в колонках будут сначала обрабатываться без трансформации в документы. Но там куча ограничений и в каком виде это будет в релизе пока не очень понятно. Фичу активно пилят, но в release notes про неё пока ни слова, есть шанс что в 8 не войдет или войдет частично. Могут и до 8.1 отложить, чтоб был дополнительный резон пользоваться атласом. Тогда в CE мы её не скоро увидим, возможно аж до следующего года, когда 9 выпустят
Блин, спасибо, кстати с удовольствием бы прочитал статью )
А если metaField это объект (документ), то для сортировки по его вложенному полю тоже нужно проводить расжатие?
Сейчас попробовал sort({ timestamp: -1, 'meta.pool': -1 }) и он тоже работает 100 секунд...
У меня просто конкретный кейс сортировка по timestamp + уникальному полю для cursor based pagination, вот не знаю что делать сейчас с ts коллекцией.
yopp
А фильтр для курсора попадает в meta/time поля?
Nick
Tim🌵
А фильтр для курсора попадает в meta/time поля?
Пока вообще без фильтра сделал запрос. Просто sort + limit.
Sort по timefield + вложенному полю из metafield
Tim🌵
а почему выбрали ts коллекцию а не обычную?
Я просто храню цены для отрисовки их на графике. Во всех статьях про timeseries это самый базовый пример, поэтому не думая выбрал timeseries, и до этой проблемы с пагинацией в целом все устраивало.
В глубине души надеюсь, что оно помогает занимать меньше места в БД, но бенчмарки не делал
Nick
Я просто храню цены для отрисовки их на графике. Во всех статьях про timeseries это самый базовый пример, поэтому не думая выбрал timeseries, и до этой проблемы с пагинацией в целом все устраивало.
В глубине души надеюсь, что оно помогает занимать меньше места в БД, но бенчмарки не делал
а пагинация откуда взялась для графика?
Tim🌵
а пагинация откуда взялась для графика?
Чуть соврал ) В time series сохраняются транзакции, а потом из транзакций строится коллекция с ценами для графика (materialized view)
А вот для отображения транзакций нужна пагинация. Пагинация только в убывающем порядке по timestamp. Но несколько транзакций может быть в одно время, поэтому сортировка только по timestamp не получится
Tim🌵
В теории я могу транзакции сохранять в обычную коллекцию, но тогда вопрос нужна ли мне монга или лучше уже полноценная time series база данных…
 ADM
Здравствуйте, подскажите пожалуйста. Для кликера использую бд монго. Но не все клики успевает записать. Подскажите пожалуйста как сделать что бы сразу обновлялся документ
Nick
Здравствуйте, подскажите пожалуйста. Для кликера использую бд монго. Но не все клики успевает записать. Подскажите пожалуйста как сделать что бы сразу обновлялся документ
опишите что для вас кликер и для чего именно база используется?
ADM
опишите что для вас кликер и для чего именно база используется?
Сохранение кликов, просто при частом клике не все сохраняются
Nick
Сохранение кликов, просто при частом клике не все сохраняются
сохраняете отдельные евенты для последеющей аналитики или зачемто сразу обновляете? что дальше с этими кликами делать планиурете?
ADM