 Kvhqm


Во вторых, что вот этот консоль выводит?
console.log(product1Arrays[3]);
Kvhqm
В третьих, твой вопрос проблемный, т.к. не понятно что ты делаешь, и для чего все эти танцы
 Grt
Во вторых, что вот этот консоль выводит?
console.log(product1Arrays[3]);
Хочу что бы по типу делало продукты
-
А можно пример пожалуйста?
Пример №1:
find().projection({ path: 1 }) либо find().project({ path: 1 })
Пример №2:
find({}, { path: 1 })
Документация:
1. https://www.mongodb.com/docs/manual/tutorial/project-fields-from-query-results/
2. https://www.mongodb.com/docs/manual/reference/operator/aggregation/project/
Grt
Пример №1:
find().projection({ path: 1 }) либо find().project({ path: 1 })
Пример №2:
find({}, { path: 1 })
Документация:
1. https://www.mongodb.com/docs/manual/tutorial/project-fields-from-query-results/
2. https://www.mongodb.com/docs/manual/reference/operator/aggregation/project/
А он сможет возвращать по type если нашел совпадения
product1: [{"id":"1bf27371-138a-4a5d-8233-08b386495a0a","name":"Молоко","sum":30,"type":"milk","typ":"buy","kol":1}]
-
А он сможет возвращать по type если нашел совпадения
product1: [{"id":"1bf27371-138a-4a5d-8233-08b386495a0a","name":"Молоко","sum":30,"type":"milk","typ":"buy","kol":1}]
Если вам надо от фильтровать, то это надо сразу в find прописать либо если использовать аггрегацию, то $match
-
А он сможет возвращать по type если нашел совпадения
product1: [{"id":"1bf27371-138a-4a5d-8233-08b386495a0a","name":"Молоко","sum":30,"type":"milk","typ":"buy","kol":1}]
Если вам нужны только документы, где type === milk, то find({type: milk})
Grt
Если вам нужны только документы, где type === milk, то find({type: milk})
Возвращает пустой массив, ходя в базе оно есть
Grt
Можете показать полный документ?
{
_id: new ObjectId("6562fc5a1ee4ffe35c41fe08"),
name: 'Тест',
creator_id: 123456789, creator_name: 'testname',
balance: 0,
bal: 0,
product1: [{"id":"1bf27371-138a-4a5d-8233-08b386495a0a","name":"Молоко","sum":30,"type":"milk","typ":"buy","kol":1}],
product2: [],
product3: [],
product4: [],
product5: [],
product6: [],
product7: [],
__v: 1
}
]
-
Пример №1
find({"product1.type": "milk"})
Пример №2
find(
{"product1.type": "milk"},
{products: {$filter: {input: "$product1",as: "product",cond: { $eq: ["$$product.type", "milk"] }}}})
Grt
То есть он вернет все массивы у кого milk есть?
 Nick
Вопрос про индексацию,
например, документы сейчас имеют такой вид: {x: 'a', y: 'b', z:'c'}
где, a,b,c - это по сути, split строки, a-b-c. Однако, регулярно, приходят строки со значениями(и это нормально), где префикса a - нет, то есть строки вида b-c.
Тогда документы сохраняются в виде, {'y:' 'b', 'z':'c'}. Так как поиск предусматривается и по полной форме {x: 'a', 'y:' 'b', 'z':'c'}, и по частичной. { 'y:' 'b', 'z':'c'}. То построен индекс {y:1, z:1, x:1}, такой порядок, ввиду того, что y более уникален, чем z.
Так вот, так как индекс сразу по 3 полям, то в поиске(агрегации), когда ищут данные по b-c (то есть на вход дают только значения для y,z), я использую для поля x такое добавление в match:
'$or': [{'x': {'$exists': false}},
{'x': {'$exists': true}}]
И вот думаю, если для случаев когда приходит документ без префикса, в короткой форме, может быть всё таки лучше сохранять документ в "полной" форме, а в значение этого "префикса" назначать, на пример, -1 - (такого точно не может прийти во входных данных).
То есть документы примут вид для таких случаев:
{x: -1, y: 'b', z:'c'}.
И вот вопрос, у меня получится что в поле может быть как "целое" -1, так и строка, при полной форме входной строки. Или всё такие сохранять в x -1 как строку? И при поиска. когда на вход подадут только y и z в match будет такое:
'$or': [{'x': -1},
{'x': {'$ne':-1}}]
И вопросы такие
Будет ли такое эффективней чем exists,
Нормально ли смешивать два типа, в одних документах целое, в других строка, в контексте построения индекса.
По размеру документа, для целого монга сразу будет занимать сколько то байт, а для строки, будет увеличиваться документ на 2 сколько байт, если будет только '-1'. Потому как такое изменение повлечет и увеличение документов, и увеличение индекса.
Документов, 40 млрд, и на таком количестве разница в байтах, будет видна.
не очень понятно зачем надо добавлять условия вида
'$or': [{'x': {'$exists': false}},
{'x': {'$exists': true}}]
т.к. они всегда истинны и имеют смысл разве что для полей посреди составного индекса, чтобы попытаться триггернуть covered выборку.
Будет ли эффективнее замена экзист - да, т.к. надо монга дополнительно читает документ с диска чтобы проверить этот факт если это не sparse индекс (https://www.mongodb.com/docs/manual/reference/operator/query/exists/#use-a-sparse-index-to-improve--exists-performance)
По размеру числа почти всегда дадут меньший размер индекса по сравнению со строками и соответственно снизят требования к памяти и как следствие нагрузку на систему изза объемов гоняемых данных между диском и оперативой.
Однако в вашем случае где есть всегда выборка по y+z и иногда к ним добавляется еще x, мне например видится вариант строки вида "y-z:x" которая покрывает все указанные выборки (дефис и двоеточие тут символы разделители). Возможнос такой индекс даст больший импакт чем суррогат из трех интовых полей
Andrey
Строка из значений полей
строка из значений, значения всегда вида a-b-c (поля x, y, z), и это всегда строки, но, бывают, что нет a, и приходит строка b-c. Так удобней индекс строить по 3 полям, составной, но в документе, когда a не приходит, соответственнно нет поля x. Но оно участвует в индексе, потому его решил указывают, при поиске.
Andrey
и что бы избежать exists, когда значения а - не приходит, писать его все-таки, но как какой-то символ, или значение, заведомо невозможное для данных. И тогда оно будет участвовать в индексе уже со значением.
 yopp
строка из значений, значения всегда вида a-b-c (поля x, y, z), и это всегда строки, но, бывают, что нет a, и приходит строка b-c. Так удобней индекс строить по 3 полям, составной, но в документе, когда a не приходит, соответственнно нет поля x. Но оно участвует в индексе, потому его решил указывают, при поиске.
Если я правильно помню, то хватит записывать null как значение и явно в запросе указывать a: null. Монга может индексировать поля с разными типами, проблем с этим не будет :)
yopp
$exists лучше избегать, это дорогая операция и планировщику будет сложно выбрать подходящий индекс
yopp
Еще из вариантов, если нет сортировок и вы не делаете выборок по префиксу, то положить a в суффикс индекса, раз это опциональное поле
Andrey
Если я правильно помню, то хватит записывать null как значение и явно в запросе указывать a: null. Монга может индексировать поля с разными типами, проблем с этим не будет :)
вот тут в Covered Query про null пишут не очень хорошо.
no fields in the query are equal to null (i.e. {"field" : null} or {"field" : {$eq : null}} ).
https://www.mongodb.com/docs/manual/core/query-optimization/#std-label-indexes-covered-queries
Andrey
Еще из вариантов, если нет сортировок и вы не делаете выборок по префиксу, то положить a в суффикс индекса, раз это опциональное поле
так и делаю, самое последнее поле со значением а в индексе.
Про "поля с разными типами, проблем с этим не будет :)" - тут скорее от меня еще скрытый подвопрос :) что больше будет занимать место, замена отсутствующего поля на что-типа '~' - строкой, или -1 - которое будет как int32 - то есть + 4 байта?
yopp
так и делаю, самое последнее поле со значением а в индексе.
Про "поля с разными типами, проблем с этим не будет :)" - тут скорее от меня еще скрытый подвопрос :) что больше будет занимать место, замена отсутствующего поля на что-типа '~' - строкой, или -1 - которое будет как int32 - то есть + 4 байта?
Если хотите covered queries в этом случае действительно лучше поле со специальным значением.
Меньше всего по спецификации занимают $minKey/$maxKey, они как и null «immediate values», без аргументов,: т.е 0 байт оверхеда
https://bsonspec.org/spec.html
Ну и такие значения точно пересекаться не будут с другими и при сортировке точно будут или в конце или в начале :)
Andrey
Если хотите covered queries в этом случае действительно лучше поле со специальным значением.
Меньше всего по спецификации занимают $minKey/$maxKey, они как и null «immediate values», без аргументов,: т.е 0 байт оверхеда
https://bsonspec.org/spec.html
Ну и такие значения точно пересекаться не будут с другими и при сортировке точно будут или в конце или в начале :)
Спасибо, думал и читал про них сегодня, но не очень понял концепта, что это такое за внутренний тип.
yopp
Спасибо, думал и читал про них сегодня, но не очень понял концепта, что это такое за внутренний тип.
Это значения которые всегда или меньше или больше других значений, удобно когда какие-то значения нужно в начале любой сортировки воткнуть
Andrey
Это значения которые всегда или меньше или больше других значений, удобно когда какие-то значения нужно в начале любой сортировки воткнуть
А примера такой сортировки нет под рукой, а что то очень абстрактное, меньше каких значение, из документа, когда есть какие то значения, и есть где нет значений, и где нет - и они первыми приходят после запроса?
yopp
А примера такой сортировки нет под рукой, а что то очень абстрактное, меньше каких значение, из документа, когда есть какие то значения, и есть где нет значений, и где нет - и они первыми приходят после запроса?
Оно при любых условиях в операциях сравнения всегда меньше/больше любых других значений любых типов
https://www.mongodb.com/docs/manual/reference/operator/query/type/#minkey-and-maxkey
yopp
Например иногда нужно пропустить один из уровней в индексе, но хочется даже не эффективно все равно искать по индексам, тут через $gte: $minKey $lte: $maxKey можно такое иногда провернуть
yopp
Планировщик не всегда с таким соглашается, но часто прокатывает :)
Kvhqm
Помню кто-то спрашивал про таймеры в монге... А есть только таймеры, или можно задавать какие-то свои правила. Например, у меня есть тудуха, и я хочу при выполнении задачи на сайте или в приложении автоматически перемещать задачу из тудухи в выполненное...
 Нуриддин
Помню кто-то спрашивал про таймеры в монге... А есть только таймеры, или можно задавать какие-то свои правила. Например, у меня есть тудуха, и я хочу при выполнении задачи на сайте или в приложении автоматически перемещать задачу из тудухи в выполненное...
можно использовать встроенный интерпретатор javascript и создать нужную функцию
Kvhqm
можно использовать встроенный интерпретатор javascript и создать нужную функцию
Я имею ввиду другое. В монге есть что-то, что бы чекало при каждом запросе выполнена задача или нет?
Nick
 Ернар
Всем привет! Есть ли в монго treshold чтобы база не переполнилась на 100%, чтобы при 95% заполнение он перешел на режим read-only
 XMT
Ээ, за шо удалили эпилепсию? 😁
Nick
Всем привет! Есть ли в монго treshold чтобы база не переполнилась на 100%, чтобы при 95% заполнение он перешел на режим read-only
такого не встречал, https://www.mongodb.com/docs/manual/reference/configuration-options/#storage-options говорит что тоже параметров в настройке нет. Можете чтото в энтерпрайз версии версии есть, но я бы не расчитывали настраивал нормальный мониторинг и алерты
narrow victory
добрый день! наблюдаем по нашим оценкам весьма долгий фетч. база около 1.4 млрд документов. средний размер документа около 300кб . запрос отдает около 1 млн результатов. выполняется на nvme - 1 мин 50 сек, из оперативки - 1 мин 10 сек. при этом свыше 90% времени - фетч. это адекватное время для монги или же нет? если нет то в чём может быть проблема?
Nick
добрый день! наблюдаем по нашим оценкам весьма долгий фетч. база около 1.4 млрд документов. средний размер документа около 300кб . запрос отдает около 1 млн результатов. выполняется на nvme - 1 мин 50 сек, из оперативки - 1 мин 10 сек. при этом свыше 90% времени - фетч. это адекватное время для монги или же нет? если нет то в чём может быть проблема?
как замеряете?
и все с одной ноды выбирается или из шардированного кластера?
narrow victory
как замеряете?
и все с одной ноды выбирается или из шардированного кластера?
через explain. кластер есть. 2 ноды на 2 серверах в докерах. 1 шарда, 1 реплика
Nick
добрый день! наблюдаем по нашим оценкам весьма долгий фетч. база около 1.4 млрд документов. средний размер документа около 300кб . запрос отдает около 1 млн результатов. выполняется на nvme - 1 мин 50 сек, из оперативки - 1 мин 10 сек. при этом свыше 90% времени - фетч. это адекватное время для монги или же нет? если нет то в чём может быть проблема?
если средний размер действительно 300кб, то 1 млн доков - это 300 Гб, за 2 минуты это достаточно быстро
Andrey
если средний размер действительно 300кб, то 1 млн доков - это 300 Гб, за 2 минуты это достаточно быстро
Тоже посчитал, что быстро
narrow victory
прошу прощения, ошибся. 300 байт конечно
Nick
прошу прощения, ошибся. 300 байт конечно
а что значит "из оперативки"? типа с прогретого кэша?
narrow victory
насколько я понимаю если оперативка позволяет всю базу поместить в память то монга это делает. мы наблюдали за памятью и при первом же запросе память освоилась аккурат на размер базы
Nick
значит надо смотреть во что упирается при запросе, скорее всего должно в диски упираться, т.к. по такому времени это 10к иопс стабильных надо + накладные расходы на передачу. Так что да очень возможно что в диски уперлись
narrow victory
я понял что написал ерунду
narrow victory
мы сделали запрос и монга, судя по размеру освоенной памяти, поместила в память индексы тех полей по которым осуществлялся поиск в запросе.
Nick
мы сделали запрос и монга, судя по размеру освоенной памяти, поместила в память индексы тех полей по которым осуществлялся поиск в запросе.
поиск это пол дела, данные то с диска считать надо
narrow victory
я понимаю. фетч это же и есть чтение с диска, так?
Nick
да
narrow victory
большое спасибо за ответы! уже натолкнули на некоторые мысли, надо их проверить)
Nick
большое спасибо за ответы! уже натолкнули на некоторые мысли, надо их проверить)
вообще не нормально тянуть 1кк доков из бд, поэтому даже хз нормальное ли это время
Andrey
вообще не нормально тянуть 1кк доков из бд, поэтому даже хз нормальное ли это время
Ну почему, выгрузка данных в другие «системы»
Nick
Ну почему, выгрузка данных в другие «системы»
с моей колокольни тут несколько вопросов возникает, почему не CDC на потоках? если не надо реалтайм, то почему образовался такой разрыв? если и это ок то почему вообще важна скорость, если был допущен такой разрыв?
narrow victory
вообще не нормально тянуть 1кк доков из бд, поэтому даже хз нормальное ли это время
нам действительно в нормальной работе столько не надо с одного запроса. но заметили факт и он вызвал большие сомнения в адекватности. для нас это важно поскольку планируем параллельность и в этом режиме суммарное количество доставаемых записей в единицу времени действительно требуется весьма высокое
Andrey
с моей колокольни тут несколько вопросов возникает, почему не CDC на потоках? если не надо реалтайм, то почему образовался такой разрыв? если и это ок то почему вообще важна скорость, если был допущен такой разрыв?
ну да, или "отложенная" выгрузка по некоторым запросам, для импортов в другие приложения. Но по мне, минута две, ну норм, для такого.
 Ящик водки
Я пришёл к выводу, что я сам себе дал нереальные ограничения для теста
Нужно понимать, что в реальном юзкейсе 1000 человек одномоментно не постучится на роут, а даже если такой волшебный кейс случится, то это не постоянная нагрузка, и такую ситуацию, пусть и с задержкой, сервер разрулит
Тем более в продашкне будет развёрнуто несколько копий ноды + nginx в качестве балансировщика, и у каждой копии будет свой коннекшн к бд
Я бы не советовал сильно увеличивать пулсайз, умные ребята из других чатов сказали, что так лучше не делать и может быть плохо)
Если один конкретный маршрут делает тяжелые запросы, можешь реализовать несколько коннекшнов и на конкретные тяжелые запросы использовать отдельный коннекшн, чтобы лёгкие запросы не вставали в очередь за тяжёлыми
при чем тут несколько коннекшионов и пулл? ты путаешь понятия
у меня задача несколько другая - найти оптимальную конфигурацию системы и запросов, что бы выдать максимум из имеющихся вдс
 Alexander
Всем привет, уже мучаюсь 2 часа и не могу реализовать следующую логику: Хочу чтобы в mongoDb добавлялась запись и через 15 секунд удалялась, добавляю следующие индексы "expireAt": 1 и expireAfterSeconds: 0 , далее указываю дату в формате mongo с типом Date, где указываю точное время после которого должна удаляться запись, а она не удаляется, кто-нибудь реализовывал подобное ? Буду очень признателен за ответ
Nick
просто надо сверить какое на серваке и в поле с учетом перевода в utc. Для эксперимента можешь добавить док у которого время текущее плюс 3 часа и посмотреть удалится или нет
Alexander
просто надо сверить какое на серваке и в поле с учетом перевода в utc. Для эксперимента можешь добавить док у которого время текущее плюс 3 часа и посмотреть удалится или нет
У меня работает удаление, если я expireAfterSeconds ставлю например 5, и делаю просроченную дату и через 5 секунд удаляет, а через expireAfterSeconds 0 не работает, если ставить точную дату
Alexander
Ну пока проблема решена)
 Игорь
 Игорь
 Nick
Игорь
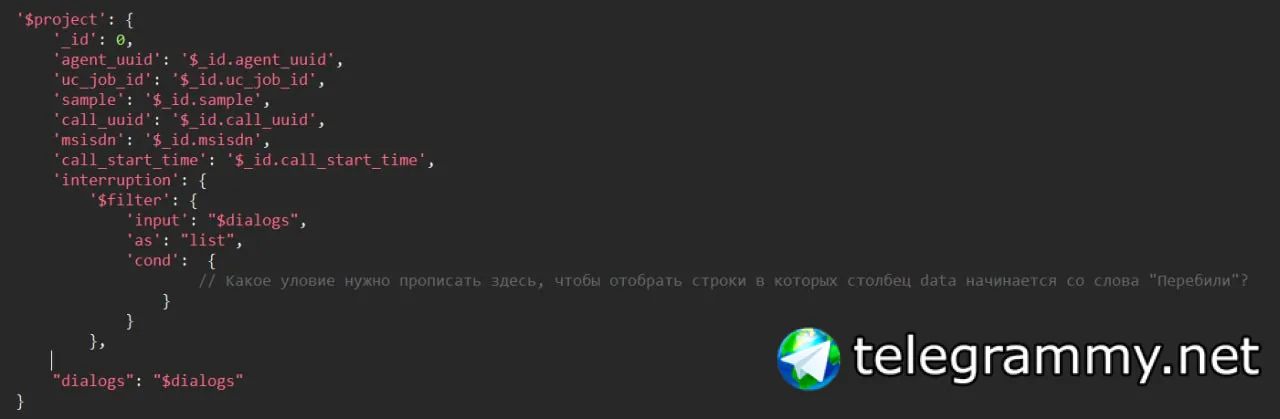
https://www.mongodb.com/docs/manual/reference/operator/aggregation/regexMatch/
большое спасибо, я попробую
Alexander
Всем привет, подскажите пожалуйста как выставить дату и время в котором должна работать БД ?
Ivan