Ребят, подскажите, пожалуйста, на show dbs ничего выводит, хотя базы есть - почему так может быть?
Подключаюсь из-под рутовской системной учетки просто через команду mongo (пользователь и пароль неизвестны). Хотелось бы обойтись как-то без сброса пароля.
Просто непонятно mongo вообще что делает и в качестве кого подключает?
Версия 4.5.6.
ну и 4.5 версия эт вообще что такое?) то что было потом в пятую переделано к релизу? в общем нечего сидеть на таких билдах
 Nick


 Dmitry
зачем вы об этом думаете и какую пробелму решаете?
Думаю, какого типа данных и какого размера создать поле, integer/String. Это своего рода уникальный идентификатор объекта в проекте. И будет ли это вообще влиять на скорость поиска документа. Думаю об этом, т.к. это будет самый частый запрос к бд в проекте
Nick
Думаю, какого типа данных и какого размера создать поле, integer/String. Это своего рода уникальный идентификатор объекта в проекте. И будет ли это вообще влиять на скорость поиска документа. Думаю об этом, т.к. это будет самый частый запрос к бд в проекте
это повлияет только на размер индекса и требования RAM чтобы туда влезало. Но в общем случае об этом нет смысла думать, т.к. влияние проявляться начнет скорее всего к десятку-сотне млн доков. Вот там уже по факту надо будет решать проблема ли это и надо ли ее решать. А сейчас потратьте время на написание кода
 Dmytro
Добрый вечер, подскажите как в массив добавить к каждому элементу уникальный ObjectId, если массив уже существует, но без айдих
Dmytro
И можно или так сделать без пересоздания всей модели
Tetra
Добрый вечер, подскажите как в массив добавить к каждому элементу уникальный ObjectId, если массив уже существует, но без айдих
в массивы внутри каждого дока просто нагенерить идшники?
 yopp
Добрый вечер, подскажите как в массив добавить к каждому элементу уникальный ObjectId, если массив уже существует, но без айдих
db.getCollection('foobar').updateMany({}, [
{
"$set": {
"array": {
"$function": {
"body": "function (array) {return array.map( item => { item[\"_id\"]??= new ObjectId(); return item; })}",
"args": [
"$array"
],
"lang": "js"
}
}
}
}])
yopp
если массива в документе может не быть, то внутри function() нужно ещё добавить проверку на то определенно ли значение
Dmytro
db.getCollection('foobar').updateMany({}, [
{
"$set": {
"array": {
"$function": {
"body": "function (array) {return array.map( item => { item[\"_id\"]??= new ObjectId(); return item; })}",
"args": [
"$array"
],
"lang": "js"
}
}
}
}])
Вторым параметром updateMany можно отправить массив 0_о
yopp
Да, этоupdate with aggregation pipeline
yopp
https://www.mongodb.com/docs/manual/tutorial/update-documents-with-aggregation-pipeline/
Dmytro
А я думал я хорошо знаю монгу...
yopp
FYI, $function не доступна на бесплатном тарифе Atlas
yopp
Вот так ломается: https://play.db-ai.dev/m/ZV98HdoRRwABD_JW )
Dmytro
Спасибо большое
fartolomeev
Добрый вечер. Подскажите, пожалуйста, почему сайт не работает? Конкретно когда войти хочешь
fartolomeev
Короче говоря, что делать?
Nick
Андрей
Всем привет!
Я понимаю, что группа технологическая, но может кто подскажет группу или место, где можно найти Ваших коллег, которые в поиске новых возможностей / работы?
Mongo не так распространена, как реляционки (в РБ по крайней мере), но все-таки
Андрей
ну там не вариант(
кроме этого...
fartolomeev
Mongodb.com
Nick
Mongodb.com
А, тогда вы наверное пытаетесь подрубиться из РФ, контора монги не работает с РФ изза санкций и решают они это докучи и ограничением по сети. Используйте впн
 Ящик водки
Добрый день, может кто сможет подсказать в чём проблема
Нода имеет одно подключение к монге
Роут, который тестирую не делает ничего кроме запроса в бд
При нагрузке на роут 1000 подключениями коннекшн к бд начинает сильно запаздывать
Задержка цикла событий небольшая, ~30мс
Задержка ответа на запрос уже 1300мс
Как я понимаю, пул соединений полностью забит и новые запросы просто в ожидании освобождения сокета из-за чего и появляется такая большая задержка
Никакие настройки PoolSize не исправили ситуацию
Запрос не самый простой, с .populate() по id, коллекция индексирована
Смотрю, ответа толкового так и не дали?
У меня та же проблема, использую пулл, при более 350 единовременных запросов, задержка резко увеличивается с 12 мс до 4560 мс
По профилю нагрузки видно, что процесс начинает складывать запросы в очередь.
Думаю начать копать в сторону пулл сайза, так как в логи постоянно плюётся варнингом на счёт топологии, но это относится к условию - несколько процессов использует 1 подключение, странно, потому что у меня коннекшон_пулл, каждый запрос берёт из пула коннект и его юзает.
Заранее отвечаю на вопросы типа: "а может что-то настроено неверно или запросы тяжёлые, нет индексов, нет чёрта лысого и др." - нет.
При изменении маршрута и функций таким образом, что бы запросы в базу не шли, задержка возрастает с 140 мс до 370 при 1000 иммитации 1000 юзеров и 2700 рпс.
Нагрузку даю с помощью locust.
 Alex
 Alex
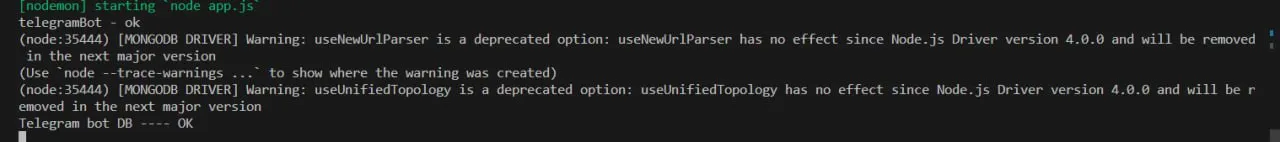
useNewUrlParser: true,
useUnifiedTopology: true,
Alex
Говорит что это устарело и будет удалено
I
Смотрю, ответа толкового так и не дали?
У меня та же проблема, использую пулл, при более 350 единовременных запросов, задержка резко увеличивается с 12 мс до 4560 мс
По профилю нагрузки видно, что процесс начинает складывать запросы в очередь.
Думаю начать копать в сторону пулл сайза, так как в логи постоянно плюётся варнингом на счёт топологии, но это относится к условию - несколько процессов использует 1 подключение, странно, потому что у меня коннекшон_пулл, каждый запрос берёт из пула коннект и его юзает.
Заранее отвечаю на вопросы типа: "а может что-то настроено неверно или запросы тяжёлые, нет индексов, нет чёрта лысого и др." - нет.
При изменении маршрута и функций таким образом, что бы запросы в базу не шли, задержка возрастает с 140 мс до 370 при 1000 иммитации 1000 юзеров и 2700 рпс.
Нагрузку даю с помощью locust.
Я пришёл к выводу, что я сам себе дал нереальные ограничения для теста
Нужно понимать, что в реальном юзкейсе 1000 человек одномоментно не постучится на роут, а даже если такой волшебный кейс случится, то это не постоянная нагрузка, и такую ситуацию, пусть и с задержкой, сервер разрулит
Тем более в продашкне будет развёрнуто несколько копий ноды + nginx в качестве балансировщика, и у каждой копии будет свой коннекшн к бд
Я бы не советовал сильно увеличивать пулсайз, умные ребята из других чатов сказали, что так лучше не делать и может быть плохо)
Если один конкретный маршрут делает тяжелые запросы, можешь реализовать несколько коннекшнов и на конкретные тяжелые запросы использовать отдельный коннекшн, чтобы лёгкие запросы не вставали в очередь за тяжёлыми
I
Могу посоветовать посмотреть как ведёт себя сам запрос, включить профилировщик и посмотреть что он выдаст
Посмотреть mongostat под нагрузкой
Nalik
Привет всем!
Можно выполнить lookup только при условие, что $user_id равно 444 ?
Данный пример всегда возвращает null, но запрос все равно выполняется и соответственно на него тратится время. Как вообще не выполнять запрос если $user_id не равно 444?
{
$lookup: {
from: 'chats_user',
let: { chatID: { $cond: { if: { $eq: ['$user_id', 444] }, then: '$chat_id', else: null }}, msgID: '$msg_id', userID: '$user_id' },
pipeline: [
{ $match: { $expr: { $and: [{ $eq: ['$chat_id', '$$chatID'] }, { $ne: ['$user_id', '$$userID'] }, { $gte: ['$read_msg_id', '$$msgID'] }] } } },
{ $limit: 1 },
{ $project: { _id: 1 } },
],
as: 'dbRead',
},
}, { $set: { 'dbRead': { $gt: [{ $size: '$dbRead' }, 0] } } },
Nick
Nick
Привет всем!
Можно выполнить lookup только при условие, что $user_id равно 444 ?
Данный пример всегда возвращает null, но запрос все равно выполняется и соответственно на него тратится время. Как вообще не выполнять запрос если $user_id не равно 444?
{
$lookup: {
from: 'chats_user',
let: { chatID: { $cond: { if: { $eq: ['$user_id', 444] }, then: '$chat_id', else: null }}, msgID: '$msg_id', userID: '$user_id' },
pipeline: [
{ $match: { $expr: { $and: [{ $eq: ['$chat_id', '$$chatID'] }, { $ne: ['$user_id', '$$userID'] }, { $gte: ['$read_msg_id', '$$msgID'] }] } } },
{ $limit: 1 },
{ $project: { _id: 1 } },
],
as: 'dbRead',
},
}, { $set: { 'dbRead': { $gt: [{ $size: '$dbRead' }, 0] } } },
Решить что не выполнять запрос вообще можно только на уровне кода собственно перед его выполнением. Может опишите ситуацию поподробнее в чем проблема?
Nalik
Решить что не выполнять запрос вообще можно только на уровне кода собственно перед его выполнением. Может опишите ситуацию поподробнее в чем проблема?
Понимаю.
Да, могу описать.
Есть коллекция (message_list) сообщений с полями: msg_id, msg_local_id, chat_id, reply_id, user_id, msg_text, msg_del_time, msg_edit_time, msg_time.
Есть коллекция (chats_user) чатов пользователе с полями: user_id, chat_id, join_time, leave_time, chat_read_time, read_msg_id, chat_sound.
Выполняю агрегацию коллекции (message_list), там добавляются некоторые данные. Но так же мне нужно добавить к каждому документу сообщения (у которого user_id будет равно моему id, т.е. только для своих сообщений) поле read, значение которого будет 0 или 1. Для этого мне нужно получить из таблицы (chats_user) документ с максимальным полем read_msg_id и если msg_id текущего сообщения меньше read_msg_id, то read принимает значение 1, в иных случаях 0.
Можно сделать отдельным запросом получение документа с максимальным read_msg_id из коллекции (chats_user), а потом просто сравнивать в $project агрегации. Но я хотел бы включить этот запрос внутрь агрегации.
Nalik
Я немного себя накрутил и запутался. Надеюсь задача не слишком сумбурной кажется и у меня получилось ясно выразить свои мысли.
Nick
Я пришёл к выводу, что я сам себе дал нереальные ограничения для теста
Нужно понимать, что в реальном юзкейсе 1000 человек одномоментно не постучится на роут, а даже если такой волшебный кейс случится, то это не постоянная нагрузка, и такую ситуацию, пусть и с задержкой, сервер разрулит
Тем более в продашкне будет развёрнуто несколько копий ноды + nginx в качестве балансировщика, и у каждой копии будет свой коннекшн к бд
Я бы не советовал сильно увеличивать пулсайз, умные ребята из других чатов сказали, что так лучше не делать и может быть плохо)
Если один конкретный маршрут делает тяжелые запросы, можешь реализовать несколько коннекшнов и на конкретные тяжелые запросы использовать отдельный коннекшн, чтобы лёгкие запросы не вставали в очередь за тяжёлыми
в принципе можно сгонять на https://www.techempower.com/benchmarks/#hw=ph&test=db&section=data-r22 посмотреть на сколько производительна ваша связка, учитывая разницу в cpu само собой. И при необходимости глянуть сырцы тестов и как там там настроено для достижения результатов https://github.com/TechEmpower/FrameworkBenchmarks/tree/master/frameworks/JavaScript/nodejs.
Ну и конечно же никакие нагрузочные тесты не могут завершиться словами "тут проблема", если не зафиксированы требования по типу - время ответа не дольше 3 секунд, процент ошибок 5ХХ ниже 1%. И они должны быть адекватные и соответствовать сервису и быть обоснованы, а не быть "хочу субмилисекундные ответы просто потому что хочу". И в рамках НТ вы как раз должны найти границы где вы перестаете соблюдать требования.
Nalik
так а проблема то в чем? запрос вроде есть
Проблема в том, что отдельный запрос выполняется за 2-3 ms.
const read_id = await db.ChatsUser.findOne({ chat_id: chat_id, user_id: { $ne: socket.user.user_id } }, { _id: 0, read_msg_id: 1} ,{ sort: { read_msg_id: -1 } })
А внутри агрегации он добавляет около 20-30 ms ко времени запроса
const dbChatMessages = await db.Messages.aggregate([
//Получить список сообщений
{
$match: {
chat_id: chat_id,
msg_del_time: 0,
}
},
// ================================================================================
// Добавляем информацию о статусе сообщения [прочитано хоть раз или нет]
// ================================================================================
{
$lookup: {
from: 'chats_user',
let: {
chatID: { $cond: { if: { $eq: ['$user_id', socket.user.user_id] }, then: '$chat_id', else: null }}, //Если user_id !== socket.user.user_id, то не выполнять поиск
msgID: '$msg_id',
userID: '$user_id'
},
pipeline: [
{ $match: { $expr: { $and: [{ $eq: ['$chat_id', '$$chatID'] }, { $ne: ['$user_id', '$$userID'] }, { $gte: ['$read_msg_id', '$$msgID'] }] } } },
{ $limit: 1 },
{ $project: { _id: 1 } },
],
as: 'dbRead',
},
}, { $set: { 'dbRead': { $cond: { if: { $gt: [{ $size: '$dbRead' }, 0] }, then: 1, else: 0 } } } },
//Объединяем данные
{
$project: {
_id: 0,
msg_id: 1,
msg_local_id: 1,
chat_id: 1,
reply_id: 1,
user_id: 1,
user_ip: 1,
msg_text: 1,
msg_del_time: 1,
msg_edit_time: 1,
msg_time: 1,
read: { $ifNull: ['$dbRead', null] },
//read: { $cond: [ { $ne: ["$user_id", socket.user.user_id] }, "$dbRead", false ] }
}
},
{ $sort : { 'msg_id' : 1 } }, //Сортировать выбранный результат
]);
Nalik
так, а 20-30мс это проблема?
Я думаю когда речь идет о разнице в десятки раз, то да.
Если запрос можно выполнить за 3 ms, зачем его выполнять за 30
Nick
Я думаю когда речь идет о разнице в десятки раз, то да.
Если запрос можно выполнить за 3 ms, зачем его выполнять за 30
нет это не десятки раз, т.к. вы гоняете запрос не на пром данных
Nalik
В любом случае когда я выполняю запрос вне агрегации он выполняется гораздо быстрее.
Нельзя его просто засунуть в агрегации без увеличение времени?)
const read_id = await db.ChatsUser.findOne({ chat_id: chat_id, user_id: { $ne: socket.user.user_id } }, { _id: 0, read_msg_id: 1} ,{ sort: { read_msg_id: -1 } })
.then(u => u.read_msg_id).catch(error => { console.error(error); return 0; });
const dbChatMessages = await db.Messages.aggregate([
{
$match: {
chat_id: chat_id,
msg_del_time: 0,
}
},
{
$project: {
_id: 0,
msg_id: 1,
msg_local_id: 1,
chat_id: 1,
reply_id: 1,
user_id: 1,
user_ip: 1,
msg_text: 1,
msg_del_time: 1,
msg_edit_time: 1,
msg_time: 1,
reply_message: { $ifNull: ['$dbReplyMessage', null] },
read: {
$cond: {
if: { $lt: ["$msg_id", read_id] },
then: 1,
else: 0
}
}
}
},
]);
Nick
В любом случае когда я выполняю запрос вне агрегации он выполняется гораздо быстрее.
Нельзя его просто засунуть в агрегации без увеличение времени?)
const read_id = await db.ChatsUser.findOne({ chat_id: chat_id, user_id: { $ne: socket.user.user_id } }, { _id: 0, read_msg_id: 1} ,{ sort: { read_msg_id: -1 } })
.then(u => u.read_msg_id).catch(error => { console.error(error); return 0; });
const dbChatMessages = await db.Messages.aggregate([
{
$match: {
chat_id: chat_id,
msg_del_time: 0,
}
},
{
$project: {
_id: 0,
msg_id: 1,
msg_local_id: 1,
chat_id: 1,
reply_id: 1,
user_id: 1,
user_ip: 1,
msg_text: 1,
msg_del_time: 1,
msg_edit_time: 1,
msg_time: 1,
reply_message: { $ifNull: ['$dbReplyMessage', null] },
read: {
$cond: {
if: { $lt: ["$msg_id", read_id] },
then: 1,
else: 0
}
}
}
},
]);
вы же понимаете что лукап выполняется для всех найденных документов в первом этапе? там только один док?
Nalik
вы же понимаете что лукап выполняется для всех найденных документов в первом этапе? там только один док?
Да. Отсюда и был вопрос, как пропустить лукап для части документов. Но потом меня осенило, что лукап нужно выполнить вообще только один раз в запросе.
Nalik
И наверное это будет уже не лукап хаха
Nalik
а какой нить фейсит или что-то типа того
Nick
Да. Отсюда и был вопрос, как пропустить лукап для части документов. Но потом меня осенило, что лукап нужно выполнить вообще только один раз в запросе.
он всегда выполняется для всех документов. Не хотите чтобы он выполнянлся - исключить ненужные документы из выборки. Например разбейте выборку и потом через $unionWith соберите
Nalik
В целом в этом и был вопрос. Можно ли выполнить лукап для части документов, а не для всех.
Nalik
Ответ получен, как всегда спасибо!
Nick
но советую пересмотреть подход к тестированию производительности, сначала напишите чтоб все работало и а потом уже будете ускорять, и желательно тестировать на рабочей нагрузке и на адекватно наполненной базе.
Nalik
Кстати раз такая пляска пошла с лукапами.
Может подскажете.
Есть коллекция (message_list) сообщений с полями: msg_id, msg_local_id, chat_id, reply_id, user_id, msg_text, msg_del_time, msg_edit_time, msg_time.
Если reply_id не равен 0, то из этой же коллекции нужно получить документ у которого msg_id будет равен reply_id.
Как это лучше всего сделать?
Сейчас я это делаю так:
const dbChatMessages = await db.Messages.aggregate([
//Получить список сообщений
{
$match: {
chat_id: chat_id,
msg_del_time: 0,
}
},
// ================================================================================
//Добавляем информацию о цитируемом сообщении
// ================================================================================
{
$lookup: {
from: 'messages_list',
let: {
chatID: '$chat_id',
replyID: {
$cond: {
if: { $eq: [{ $ifNull: ['$reply_id', null] }, 0] }, //Если reply_id === 0, то не выполнять поиск
then: null,
else: '$reply_id'
}
}
},
pipeline: [
{ $match: { $expr: { $and: [{ $eq: ['$chat_id', '$$chatID'] }, { $eq: ['$msg_del_time', 0] }, { $eq: ['$msg_id', '$$replyID'] }] } } },
{ $limit: 1 }, // Ограничиваем результат одним документом
],
as: 'dbReplyMessage',
},
}, { $set: { 'dbReplyMessage': { $first: '$dbReplyMessage' } } },
//Объединяем данные
{
$project: {
_id: 0,
msg_id: 1,
msg_local_id: 1,
chat_id: 1,
reply_id: 1,
user_id: 1,
user_ip: 1,
msg_text: 1,
msg_del_time: 1,
msg_edit_time: 1,
msg_time: 1,
reply_message: { $ifNull: ['$dbReplyMessage', null] },
}
},
]);
Nalik
Но тут опять же вопрос, зачем выполнять lookup для документов у которых reply_id равен 0.. Лишняя трата ресурсов и времени.
Nick
Но тут опять же вопрос, зачем выполнять lookup для документов у которых reply_id равен 0.. Лишняя трата ресурсов и времени.
наблюдаю у вас какоето неправильное отношение к абстракциям и слоям. Чем ближе к данным - тем больше и сложнее надо кодировать то что хочется сделать с этими данными. И уровень этой сложности это ваш выбор как программиста - хотите собирать логику не задумываюясь о том как внутри работает БД - абстрагируйте все что только можно, но поулчите сложность в абстракциях. Хотите максимально эффективно использовать бд - не удивляйтесь лапше в коде и что надо на каждый запрос тратить кучу своего личного времени. Вы сейчас почемуто хотите второе, но чтобы все как будто бы организовано было как первое, так не получится. И как ни странно то время разработчика намного дороже времени проца и если у вас дилема что гдето там чтото будет не супермегаоптимально, то и хрен с ним, главное получить результат
Oleg
Добрый день! Хочу сделать группировку по полю investigationtype и вернуть count для него. С предфильтрацией по startdate, enddate.
почему-то всегда получаю пустой результат. где ошибся?
[
{
$match: {
$and: [{ startdate: { $lte: new Date("2023-11-23") } }, { enddate: { $gt: new Date("2023-11-23") } }],
},
},
{
$group: {
_id: "$investigationtype",
total: {
$sum: 1,
},
},
},
];
Oleg
$gte чтобы включить нижнюю границу
Имею такое:
db.collection.aggregate([
{
$match: {
startdate: {
$lte: "2023-11-23"
},
enddate: {
$gte: "2023-11-23"
}
}
},
{
$group: {
_id: "$investigationtype",
totals: {
$push: {
_id: "$_id",
total: 1
}
}
}
},
{
$project: {
_id: 0,
investigationtype: "$_id",
totals: 1
}
}
])
получаю это:
[
{
"_id": "AS",
"totals": [
{
"_id": ObjectId("5a934e000102030405000000"),
"total": 1
},
{
"_id": ObjectId("5a934e000102030405000001"),
"total": 1
}
]
},
{
"_id": "AD",
"totals": [
{
"_id": ObjectId("5a934e000102030405000002"),
"total": 1
}
]
}
]
можно ли как-то вернуть просто ["AS": 1, "AD": 2]?
Nick
Oleg
не стоит, лучше вытащите и в коде уже преобразуйте к нужному виду из
_id: AS, count: 2
там порядка 40 тыс записей. поэтому хочется на стороне монги сделать
Oleg
хотелось бы через агрегацию
Nick
хотелось бы через агрегацию
если сильно охота то есть такое https://www.mongodb.com/docs/manual/reference/operator/aggregation/setField/
Oleg
если сильно охота то есть такое https://www.mongodb.com/docs/manual/reference/operator/aggregation/setField/
вот так получилось:
db.collection.aggregate([
{
$match: {
startdate: {
$lte: "2023-11-23"
},
enddate: {
$gte: "2023-11-23"
}
}
},
{
"$group": {
_id: "$investigationtype",
count: {
$sum: 1
}
}
}
])
Nick
Oleg
но тут же не связки [{AS:2}, {AD:1}]
да. но тоже устроит. а можно ли сделать группировку двойню? как два подзапроса. Один по активным заявкам второй по завершенным. Разница только в условиях lte, gte?
const request = [
{
$match: {
startdate: {
$gte: _curentdate,
},
enddate: {
$gte: _curentdate,
},
},
},
{
$group: {
_id: "$investigationtype",
count: {
$sum: 1,
},
},
},
];
Nick
да. но тоже устроит. а можно ли сделать группировку двойню? как два подзапроса. Один по активным заявкам второй по завершенным. Разница только в условиях lte, gte?
const request = [
{
$match: {
startdate: {
$gte: _curentdate,
},
enddate: {
$gte: _curentdate,
},
},
},
{
$group: {
_id: "$investigationtype",
count: {
$sum: 1,
},
},
},
];
у меня нет понимания какие критерии определяют активность заявки
Oleg
у меня нет понимания какие критерии определяют активность заявки
1. активная если дата startdate в записи >=currentdate && endate <= currentdate
2. все наоборот
Nick
Nick
нет проблем перезаложить
Nick
ну тогда просто два запроса сделайте
Nick
эффективные запросы без эффективной структуры и адекватных бизнес критериев невозможны
Andrey
эффективные запросы без эффективной структуры и адекватных бизнес критериев невозможны
Вопрос про индексацию,
например, документы сейчас имеют такой вид: {x: 'a', y: 'b', z:'c'}
где, a,b,c - это по сути, split строки, a-b-c. Однако, регулярно, приходят строки со значениями(и это нормально), где префикса a - нет, то есть строки вида b-c.
Тогда документы сохраняются в виде, {'y:' 'b', 'z':'c'}. Так как поиск предусматривается и по полной форме {x: 'a', 'y:' 'b', 'z':'c'}, и по частичной. { 'y:' 'b', 'z':'c'}. То построен индекс {y:1, z:1, x:1}, такой порядок, ввиду того, что y более уникален, чем z.
Так вот, так как индекс сразу по 3 полям, то в поиске(агрегации), когда ищут данные по b-c (то есть на вход дают только значения для y,z), я использую для поля x такое добавление в match:
'$or': [{'x': {'$exists': false}},
{'x': {'$exists': true}}]
И вот думаю, если для случаев когда приходит документ без префикса, в короткой форме, может быть всё таки лучше сохранять документ в "полной" форме, а в значение этого "префикса" назначать, на пример, -1 - (такого точно не может прийти во входных данных).
То есть документы примут вид для таких случаев:
{x: -1, y: 'b', z:'c'}.
И вот вопрос, у меня получится что в поле может быть как "целое" -1, так и строка, при полной форме входной строки. Или всё такие сохранять в x -1 как строку? И при поиска. когда на вход подадут только y и z в match будет такое:
'$or': [{'x': -1},
{'x': {'$ne':-1}}]
И вопросы такие
Будет ли такое эффективней чем exists,
Нормально ли смешивать два типа, в одних документах целое, в других строка, в контексте построения индекса.
По размеру документа, для целого монга сразу будет занимать сколько то байт, а для строки, будет увеличиваться документ на 2 сколько байт, если будет только '-1'. Потому как такое изменение повлечет и увеличение документов, и увеличение индекса.
Документов, 40 млрд, и на таком количестве разница в байтах, будет видна.
Grt
Здравствуйте что не так делаю
const allProducts = await Product.find({});
const product1Arrays = allProducts.map(product => product.product1)
console.log(product1Arrays[3]);
мне нужно что бы он вернул только type в массиве
 Kvhqm
Kvhqm
Т.к. возможно у тебя в будущем будет миллион продуктов