источников сотни тысяч из разных регионов, данных очень много, один "кадр" из источника, это документ, с динамическим набором полей. Таких "кадров" от десятков до 300 сотен в день. История с 2018 по сегодня.
Задача: дать датасатанистам, доступ к этим данным.
идея в том, что 1 источник ==1 коллекция
Кроме ДСов с данными ктото работает?
 Nick


 Kino Recovery
Кроме ДСов с данными ктото работает?
да, сбоку должен быть микросервис веб морды с elk
 milad
hi
Is it possible to add .wt files to the database?
 yopp
hi
Is it possible to add .wt files to the database?
You can create new collection, insert one document, find the name of corresponding .wt file from db.collname.stats(), then stop mongod, replace file with yours and start mongo again
milad
You can create new collection, insert one document, find the name of corresponding .wt file from db.collname.stats(), then stop mongod, replace file with yours and start mongo again
I only have these files
The previous access to mongodb was cut off and I have the same .wt files
Is there a way to put the files and get all the data?
 Vladimir
подскажите по поводу поиска: есть документы с нестед массивом, я ищу по значению в массиве, как найти только документы, у которых все значения соответствуют?
пример:
{
myArray: [
{ someText: 'AAA', someNumber: 50 },
{ someText: 'BBB', someNumber: 40 },
]
}
я, допустим, ищу: myArray.someNumber > 45, выдает этот документ, ибо одно из значений соответствует, но мне надо, чтобы выдавало только если оба значения больше 45, то есть, в данном примере, этот документ я получать не хочу :)
Tetra
подскажите по поводу поиска: есть документы с нестед массивом, я ищу по значению в массиве, как найти только документы, у которых все значения соответствуют?
пример:
{
myArray: [
{ someText: 'AAA', someNumber: 50 },
{ someText: 'BBB', someNumber: 40 },
]
}
я, допустим, ищу: myArray.someNumber > 45, выдает этот документ, ибо одно из значений соответствует, но мне надо, чтобы выдавало только если оба значения больше 45, то есть, в данном примере, этот документ я получать не хочу :)
Конкретно здесь надо выборку от обратного строить $ne:$lte:45
Vladimir
гм, идея
Tetra
подскажите по поводу поиска: есть документы с нестед массивом, я ищу по значению в массиве, как найти только документы, у которых все значения соответствуют?
пример:
{
myArray: [
{ someText: 'AAA', someNumber: 50 },
{ someText: 'BBB', someNumber: 40 },
]
}
я, допустим, ищу: myArray.someNumber > 45, выдает этот документ, ибо одно из значений соответствует, но мне надо, чтобы выдавало только если оба значения больше 45, то есть, в данном примере, этот документ я получать не хочу :)
Но в общем случае нормально это не сделать, нужно явно перечислять соответсвия либо чтото изобретать с агргеацией
 iWatchYouFromAfar
Ребят подскажите. Как мне провести фильтрацию по полю, которое я через populate в запросе джойню?
iWatchYouFromAfar
нужно что-то такое - query.role = { name: 'Root' };, но если я правильно понял, в query такое пихать при populate неправильно и нужно в самом populate запрос писать?
 Ilya
Ребята привет, нужна ваша помощь
Получаю ошибку - ERROR (payload): Error: cannot connect to MongoDB. Details: connect ECONNREFUSED 127.0.0.1:27017, при попытке подключения к бд. В интернете глянул ошибку, сказали что mongodb не запущен, зашёл в Services на Windows, MongoDb в Running статусе.
Даже запускал процесс через - .\bin\mongod.exe --dbpath="C:\Program Files\MongoDB\Server\7.0\data\db", но чёт не особо помогло
 Maxmudjon
нужна помощь
db.collection.find({title: {$in: ['foo', 'bar', 'foo ', 'bar ', 'foo ', 'bar ']}})
здесь в массиве вариантов как то можно воспользоваться с $regex?
Nick
Ребята привет, нужна ваша помощь
Получаю ошибку - ERROR (payload): Error: cannot connect to MongoDB. Details: connect ECONNREFUSED 127.0.0.1:27017, при попытке подключения к бд. В интернете глянул ошибку, сказали что mongodb не запущен, зашёл в Services на Windows, MongoDb в Running статусе.
Даже запускал процесс через - .\bin\mongod.exe --dbpath="C:\Program Files\MongoDB\Server\7.0\data\db", но чёт не особо помогло
такая ошибка происходит когда по указанному адресу нет возможности подключиться, а это значит либо адрес-порт неверные, либо фаирвол его закрывает, и есть еще вариант что монга запустилась не до конца и не открыла порт.
Поэтому надо еще проверить какой конфиг, потом проверить что всетаки сокет слушается (netstat в помощь или монитор ресурсов) , ну и если все ок то отрубаем все фаирволы и антивири (включая защитника винды) и тестим
Nick
Nick
чтобы не учол несколько пробелов в конце
\s* - это как раз про пробелы и другие пробельные символы типа табов, не помню только большое и малое надо
 Ящик водки
Viktar
I only have these files
The previous access to mongodb was cut off and I have the same .wt files
Is there a way to put the files and get all the data?
@dd_bb described the way. You need create new collection, find filename and replace file to your data.
Dmitry
Всем привет. В виртуалках на базе qemu для резервного копирования с сохранением консистентности снимков рекомендуется замораживать состояние файловой системы и приостанавливать операции на момент снятия снимка.
Для MySQL есть вот такой пример команды. Никто для MongoDB не встречал аналогичного?
https://github.com/qemu/qemu/blob/master/scripts/qemu-guest-agent/fsfreeze-hook.d/mysql-flush.sh.sample
Ilshat
Всем привет. В виртуалках на базе qemu для резервного копирования с сохранением консистентности снимков рекомендуется замораживать состояние файловой системы и приостанавливать операции на момент снятия снимка.
Для MySQL есть вот такой пример команды. Никто для MongoDB не встречал аналогичного?
https://github.com/qemu/qemu/blob/master/scripts/qemu-guest-agent/fsfreeze-hook.d/mysql-flush.sh.sample
https://www.mongodb.com/docs/v3.0/reference/method/db.fsyncLock/
 popa228
Здравствуйте
У меня вот есть проблема с подключением mongoDB compass
Из-за ограничения на территории РФ
Можно ли это как то обойти ?
popa228
Yevhenii
А кто-то разворачивал кластер в кубере с помощь оператора от percona?
Вроде как добавил опцию шардинга, но вижу, что на всех репликах копии данных в полном объеме 🥲
milad
@dd_bb described the way. You need create new collection, find filename and replace file to your data.
There are many of them
Isn't there a better way?
 Stanislav
Кто может помочь?
VPN нормальное решение. Если беспокоитесь за безопасность разверните собственный сервер с IP адресом за пределами России за 100 рублей.
popa228
VPN нормальное решение. Если беспокоитесь за безопасность разверните собственный сервер с IP адресом за пределами России за 100 рублей.
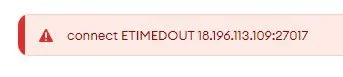
Я делал через впн
Но выдавал ошибку
Connect ETIMEDOUT
Nick
А кто-то разворачивал кластер в кубере с помощь оператора от percona?
Вроде как добавил опцию шардинга, но вижу, что на всех репликах копии данных в полном объеме 🥲
а коллекцию как создавали? там надо явно настраивать шардирование
Yevhenii
а коллекцию как создавали? там надо явно настраивать шардирование
Думал достатно подключиться через mongos
Nick
Думал достатно подключиться через mongos
это уже для выполнения запросов, для раскидывания по шардам
Nick
Думал достатно подключиться через mongos
и еще, пока данных мало они могут оставаться на одном из шардов, пока не будет производиться перебалансировка. В новых версиях 6+ меняли и она вроде поотзывчевее, в старых данных над много набрать чтоб они начали разъезжаться
Yevhenii
Stanislav
 Кылычбек
Всем привет. Недавно я добавил аналитиктер нод, и как мне сделать так чтобы сервисы коннектились с этим нодом
 Данил
:(
Ребят а подписку на монгодб можно оплатить рос картой?
yopp
А кто-то разворачивал кластер в кубере с помощь оператора от percona?
Вроде как добавил опцию шардинга, но вижу, что на всех репликах копии данных в полном объеме 🥲
Проверьте что вы включили шардирование у коллекции (see https://www.mongodb.com/docs/manual/core/sharding-shard-a-collection/#std-label-sharding-shard-key-creation). Если точно шардировали, то посмотрите в статус шарда: sh.status(). Там будет информация о количестве чанков на шардах, статистика балансировщика и если были ошибки, то сообщения об ошибках https://www.mongodb.com/docs/manual/reference/method/sh.status/
yopp
There are many of them
Isn't there a better way?
If it’s not full copy of dbPath, including catalog file, then it’s the only option. But you can automate it with few lines of code
Yevhenii
Проверьте что вы включили шардирование у коллекции (see https://www.mongodb.com/docs/manual/core/sharding-shard-a-collection/#std-label-sharding-shard-key-creation). Если точно шардировали, то посмотрите в статус шарда: sh.status(). Там будет информация о количестве чанков на шардах, статистика балансировщика и если были ошибки, то сообщения об ошибках https://www.mongodb.com/docs/manual/reference/method/sh.status/
А уже на существующей коллекции с данными можно включить шардирование? И разнесет ли после этого информацию по нодам?
yopp
А уже на существующей коллекции с данными можно включить шардирование? И разнесет ли после этого информацию по нодам?
Да, вы можете шардировать существующую коллекцию и балансировщик её постепенно разнесет по всему кластеру.
Сразу отмечу что балансировка занимает кучу времени, плюс балансируется не по размеру, а по количеству чанков
yopp
На 250гб это может быть и неделя
yopp
:(
Ребят а подписку на монгодб можно оплатить рос картой?
Нет, увы никакие продукты и сервисы сейчас в Россию сейчас не продаются
yopp
На 250гб это может быть и неделя
Но вы с коллекцией сможете спокойно продолжать работать, на производительность это не очень сильно влияет
Yevhenii
yopp
Если хочется быстро, то mongodump и потом уже mongorestore через mongos. надо будет сразу порезать и разнести чанки по шардам (https://www.mongodb.com/docs/v4.4/tutorial/create-chunks-in-sharded-cluster/) и потом в mongorestore передать несколько адресов mongos и увеличить число параллельных соединений (ключ numInsertionWorkersPerCollection, я обычно выбираю 3x от числа шардов ). Это очень быстро, если можете позволить себе даунтайм
Резать первый чанк лучше сначала на столько чанков, сколько есть шардов и сразу сделать moveChunk на каждый шард. Дальше уже резать на шардах, иначе пустые чанки тоже будут балансироваться какое-то ощутимое время
yopp
В целом если у вас хороший шард ключ, то дальше уже можно и не резать, сплиты будут при вставке уже происходить
yopp
А вот если там время или еще какие-то не очень селективные вещи, то растаскивать надо будет сначала нарезав чанки по временным отрезкам, а потом уже перемещать отрезки round robin по шардам
yopp
И потом дальше еще автоматизировать нарезку чанка с MaxKey и последующий перенос чанков по шарду чтоб хоть как-то размазать нагрузку
Yevhenii
yopp
Обращайтесь, я помогу, начиная от 2190€ в месяц за безлимитную поддержку в чатах и 1 часом созвонов в день :)
Михаил
Слушайте есть сервер с 1 гигом оперативки. При использовании $exists постоянно увеличивается потребление памяти пока его не убьет oom killer. Все что нашел это cachesizegb но я так понимаю он вообще не применяется к ситуации когда памяти всего меньше 1 гига?
 Alex
Ребят, есть вопрос. Есть БД:
const arr = [1,2,3];
db.collection.insertMany([
{numbers: [1,2]},
{numbers: [1,3]},
{numbers: [1]},
{numbers: [3, 2, 1]}
])
Нужно написать запрос в БД, который вернёт документы, если они пересекаются с массивом arr (если в массиве arr есть хоть одно число, которое есть в массиве numbers у документа)
Михаил
Ребят, есть вопрос. Есть БД:
const arr = [1,2,3];
db.collection.insertMany([
{numbers: [1,2]},
{numbers: [1,3]},
{numbers: [1]},
{numbers: [3, 2, 1]}
])
Нужно написать запрос в БД, который вернёт документы, если они пересекаются с массивом arr (если в массиве arr есть хоть одно число, которое есть в массиве numbers у документа)
db.collection.find({
numbers: {
$in: arr
}
})
Alex
db.collection.find({
numbers: {
$in: arr
}
})
Так и думал, но был процентов на 60 уверен, что сработает. Спасибо
 Arthur
Всем привет, подскажите пожалуйста - есть 3 репликасета с разным набором dbs, необходимо создать 4-ую и перенести в нее несколько dbs с имеющихся, в дальнейшем удалить их со старых.
Думал о том чтобы добавить в репликацию новые ноды и натравить application на них и когда доедет, вывести из реплики и создать новый репликасет из новых нод и удалить ненужные dbs, но это вроде как не сработает с тем, что мне надо с 3 старых репликасет тянуть dbs.
Egor
Всем привет! Есть вопрос. Сильно разжевывать не надо. Просто пните в нужном направлении. У меня есть $group stage. В ней _id - это два поля - name (простая строка) и status (enum {"red", "yellow", "green", "na"}). Name можно и нужно сортировать (в последующей $sort stage) просто по возрастанию. А вот status также просто так отсортировать не получится. Точнее, конечно же, получится, но так не надо. А надо, чтобы был именно порядок, как я указал выше. Это можно как-то сделать на уровне БД?
Egor
Nick
Nick
Всем привет, подскажите пожалуйста - есть 3 репликасета с разным набором dbs, необходимо создать 4-ую и перенести в нее несколько dbs с имеющихся, в дальнейшем удалить их со старых.
Думал о том чтобы добавить в репликацию новые ноды и натравить application на них и когда доедет, вывести из реплики и создать новый репликасет из новых нод и удалить ненужные dbs, но это вроде как не сработает с тем, что мне надо с 3 старых репликасет тянуть dbs.
Именно три репликасета или репликасет с 3 репликами?
Nick
три репликасета
Не синхронизируете, разве что с одного сета вытащите, но смысла нет. Монгодамп и не надо заморочек
Arthur
Не синхронизируете, разве что с одного сета вытащите, но смысла нет. Монгодамп и не надо заморочек
Спасибо за совет. В случае с дампом, не выйдет ли даунтайм или неконсистентность данных? mongodump -d some_database -c some_collection
mongorestore -d some_other_db -c some_or_other_collection dump/some_collection.bson
Возможно я недопонял - на sof нашел пару примеров.
На время пока я ресторю, в коллекции появляются новые документы, которые я очевидно недополучу в дампе, это как-то можно обойти?
Михаил
Данных обрабатывается много по объему?
не очень бд сама около 500мб и 10-20 запросов в секунду
Андрей
Можно догнаться экспортами по условию и тогда даунтайм будет незначительным либо поселить сбоку кроля или кафку и начать писать в очередь и тогда даунтайма не будет вообще.
Nick
не очень бд сама около 500мб и 10-20 запросов в секунду
а еще чтото крутится на серваке? ощущение что память съедает не только монга но ее прибивают как самую прожорливую
Arthur
а что так что так будет даунтайм
я подумал о том, чтобы самые большие коллекции через репликацию докинуть, благо крутятся на одной, после переключить аппликейшен на новую репликасет.
А мелкие коллекции уже дампом докинуть, жизнеспособно же это?
Nick
я подумал о том, чтобы самые большие коллекции через репликацию докинуть, благо крутятся на одной, после переключить аппликейшен на новую репликасет.
А мелкие коллекции уже дампом докинуть, жизнеспособно же это?
да вполне. Тут же вопрос в том сможет ли аппликуха работать без части данных пока вы их доливаете
Arthur
да вполне. Тут же вопрос в том сможет ли аппликуха работать без части данных пока вы их доливаете
Спасибо большое за помощь
Yevhenii
Подскажите, а шардинг в коллекции можно включать только по hashed индексам? или regular тоже подойдет?
Nick
Yevhenii
Да, вы можете шардировать существующую коллекцию и балансировщик её постепенно разнесет по всему кластеру.
Сразу отмечу что балансировка занимает кучу времени, плюс балансируется не по размеру, а по количеству чанков
а как увидеть что балансировщик начал разносить чанки по шардам?
в sh.status() виже следующее:
{
'Currently enabled': 'yes',
'Failed balancer rounds in last 5 attempts': 0,
'Migration Results for the last 24 hours': 'No recent migrations',
'Currently running': 'no'
}
но вероятно не туда смотрю)
Андрей
Всем привет!
Подскажите пожалуйста
как удалить элемент image с id = 1 из такой структуры
{
name: 'companyName',
options: [
{
color: 'red',
images: [
{ imageId: '1', image: 'image1' },
{ imageId: '2', image: 'image2' },
],
},
],
}
Пробовал вот так
db.companies.updateOne({'options.images.imageId': 1}, {$pull: {'options.images.$': 1}})
Появляется ошибка
Cannot use the part (images) of (options.images.0) to traverse the element
yopp
а как увидеть что балансировщик начал разносить чанки по шардам?
в sh.status() виже следующее:
{
'Currently enabled': 'yes',
'Failed balancer rounds in last 5 attempts': 0,
'Migration Results for the last 24 hours': 'No recent migrations',
'Currently running': 'no'
}
но вероятно не туда смотрю)
А у вас ниже есть информация о расшарженых базах и коллекциях?
Yevhenii
А у вас ниже есть информация о расшарженых базах и коллекциях?
[
{
database: {
_id: 'config',
...
...
...
{
database: {
_id: 'crawler',
primary: 'rs0',
partitioned: true,
version: {
uuid: UUID("7c82efd0-3744-4480-9e0b-4b891ab2a01e"),
timestamp: Timestamp({ t: 1691434708, i: 4 }),
lastMod: 1
}
},
collections: {
'crawler.pages33': {
shardKey: {
url: 1,
hash: 1
},
unique: false,
balancing: true,
chunkMetadata: [
{
shard: 'rs0',
nChunks: 7136
}
],
chunks: [
'too many chunks to print, use verbose if you want to force print'
],
tags: []
}
}
}
]