 Ян 🌙


 Mashxurbek
 of Astora 𒉭
 -
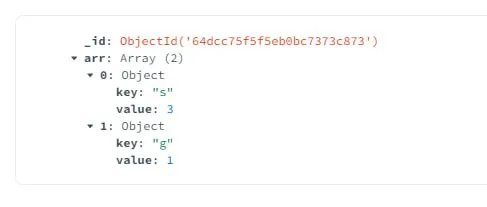
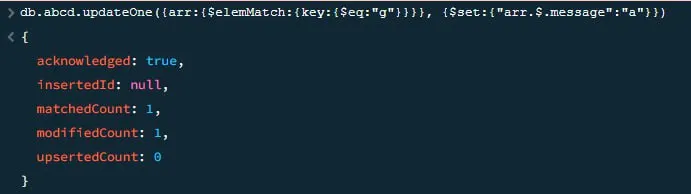
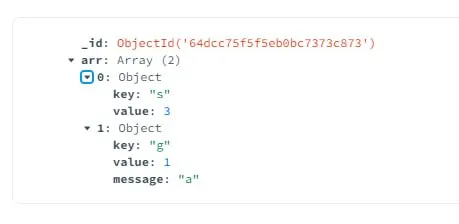
Оператор $push используеться для добавления нового элемента в массив, чтобы отредактировать конкретный элемент массива в некоторых случаях надо использовать $ либо $elemMatch, либо $ и $elemMatch одновременно, возможно понадобятся и другие операторы, всё зависит от конкретной ситуации.
-
Допустим в массиве у тебя 3 элемента и тебе надо отредактировать 2 элемент, но ты не знаешь, что он находится на этом месте. Поэтому тебе через $elemMatch указатьусловие, которое подскажет системе, что надо отредактировать именно второй элемент
Ян 🌙
Допустим в массиве у тебя 3 элемента и тебе надо отредактировать 2 элемент, но ты не знаешь, что он находится на этом месте. Поэтому тебе через $elemMatch указатьусловие, которое подскажет системе, что надо отредактировать именно второй элемент
значит это условие, а само изменение как должно выглядеть?
-
Через $
Ян 🌙
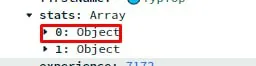
stats.$
Ян 🌙
и все?
-
 -
 -
 yopp
Привет. Подскажите пожалуйта. Есть коллекция, в ней есть поле orderN. В коллекции есть например 10 записей, все orderN имеют значения от 1 до 10, без разрывов. Есть индекс unique на orderN. Хочу атомарно инкрементировать значения orderN, которые например >= 3, но получаю ошибку из-за дубля индекса. Как можно по-другому сделать адекватно? Мой запрос:
updateMany({ orderN: { $gte: 3 } }, { $inc: { orderN: 1 } })
Ошибка 11000
Внутри транзакци сначала удалить, а потом снова создать документы с новыми значениями
Alexandr
Внутри транзакци сначала удалить, а потом снова создать документы с новыми значениями
Такое решение не подойдет, забыл уточнить, что монга 3 версии. Придумали вариант с двумя индексами asc desc и засунуть hint в курсор, тогда можно будет с конца начать апдейтить.
Спасибо за ваш ответ)
Alex
а встречали какие то туториалы по работе з монго из java?
Null
Какая сейчас есть замена mongodb atlas?
Null
Какая сейчас есть замена mongodb atlas?
Нашел что-то типа
https://xn--d1abanujej0c.xn--p1ai/tproduct/425389100-272174082191-mongodb
Но что делать, если у меня схемы и json уже готовы для mongoose?
 Nick
Нашел что-то типа
https://xn--d1abanujej0c.xn--p1ai/tproduct/425389100-272174082191-mongodb
Но что делать, если у меня схемы и json уже готовы для mongoose?
читать доку монгуса на предмет интеграции с этими БД
Alexandr
Нашел что-то типа
https://xn--d1abanujej0c.xn--p1ai/tproduct/425389100-272174082191-mongodb
Но что делать, если у меня схемы и json уже готовы для mongoose?
Так атлас это про монгу в клауде, причем тут mongoose? Вы можете развернуть где угодно базу
 Hunter
yopp
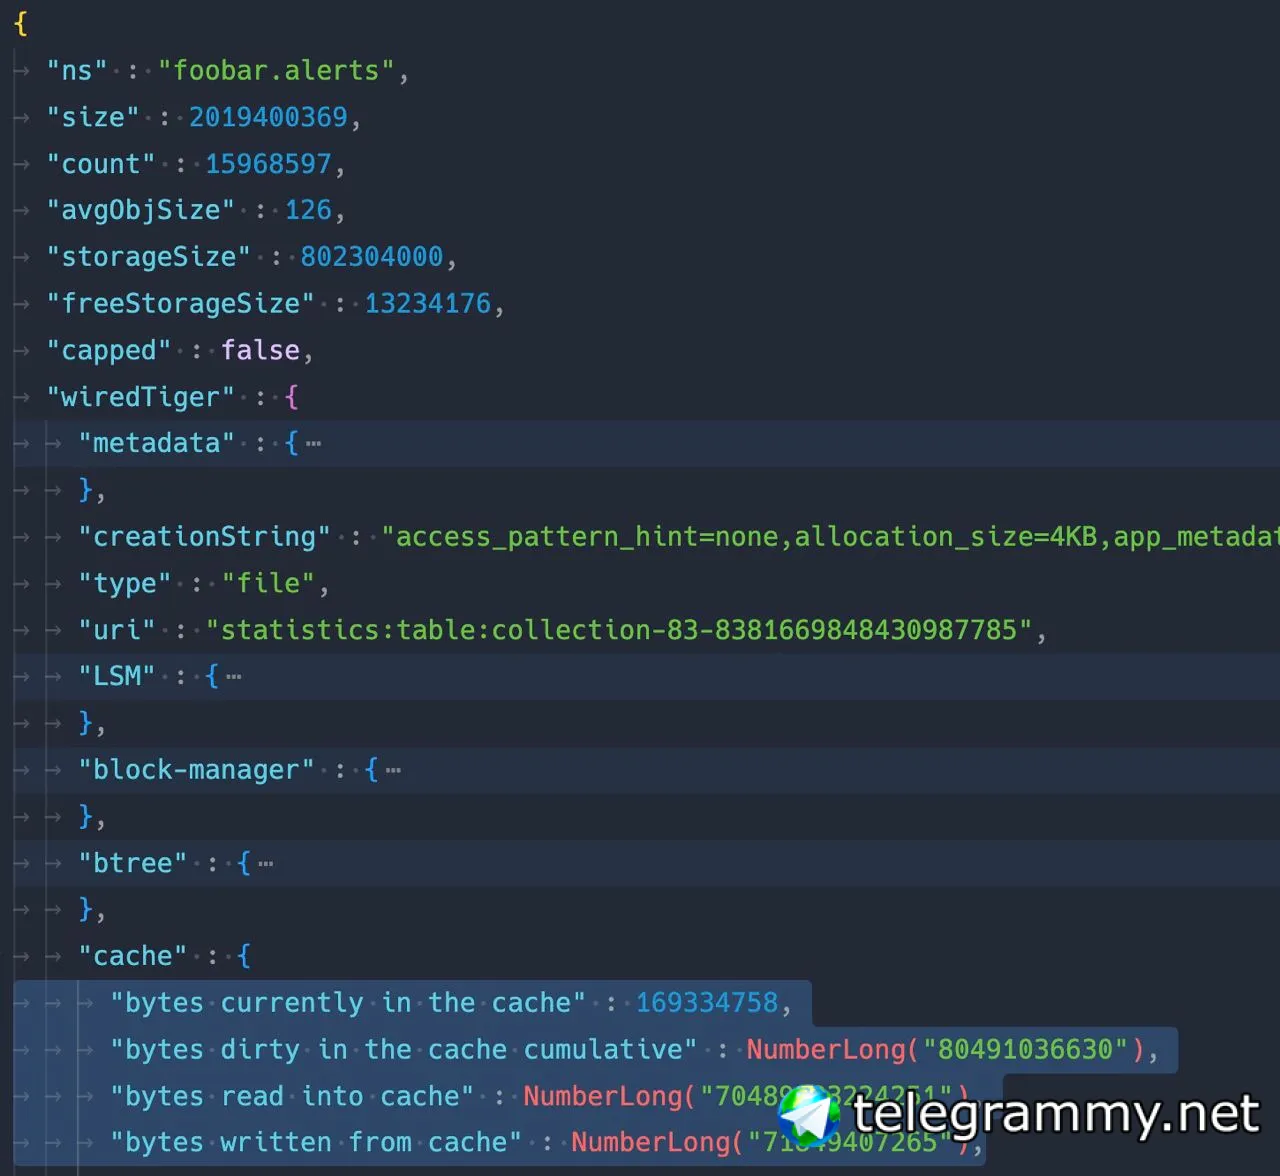
Всем привет! А MongoDB где-то хранит информацию по количеству прочитанных/записанных данных в коллекции/индексы?
db.foo.stats({"indexDetails": 1})
по коллекции
wiredTiger.cache."bytes read into cache"
wiredTiger.cache."bytes written from cache"
по каждому из индексов
indexDetails.<name>.wiredTiger.cache."bytes read into cache"
indexDetails.<name>.wiredTiger.cache."bytes written from cache"
yopp
это дисковое i/o
yopp
там-же в wt.cache есть ключ "pages requested from the cache", который показывает количество запросов данных уже непосредственно из самого индекса
 Cheusov Alexandr
yopp
по коллекциям ключ wiredTiger в корне документа со статистикой
yopp
в collStat конкретной коллекции
Cheusov Alexandr
хм... смотрел, не нашёл. Может я слепой. Посмотрю ещё раз
yopp
 Cheusov Alexandr
 Aleksey
Всем большой привет!
Пишу запрос на аггрегацию, чтобы получить количество всех заказов и заказов за последний день. Сам запрос:
var now = new Date();
var lastDay = new Date(now - 24 * 60 * 60 * 1000);
db.orders.aggregate([
{
$match: {
kitchen: "72c58acf-5506-4c7b-adcc-a9b082a623e6",
}
},
{
$group: {
_id: null,
allTimeCount: { $sum: 1 },
lastDayCount: { $sum: { $cond: [{ $gte: ["$created_at", lastDay] }, 1, 0] } }
}
},
{
$project: {
_id: 0,
allTimeCount: 1,
lastDayCount: 1
}
}
]);
Если по условию для агрегации не нашлось документов, то возращается null, но это ломает валидацию при обработке этого запроса.
Как возвращать { "allTimeCount" : 0, "lastDayCount" : 0 }, если не нашлись документы для агрегации??
Уже пробовал делать проверку на $isNull и добавлять поля в $addFields
 Yaro
Всем большой привет!
Пишу запрос на аггрегацию, чтобы получить количество всех заказов и заказов за последний день. Сам запрос:
var now = new Date();
var lastDay = new Date(now - 24 * 60 * 60 * 1000);
db.orders.aggregate([
{
$match: {
kitchen: "72c58acf-5506-4c7b-adcc-a9b082a623e6",
}
},
{
$group: {
_id: null,
allTimeCount: { $sum: 1 },
lastDayCount: { $sum: { $cond: [{ $gte: ["$created_at", lastDay] }, 1, 0] } }
}
},
{
$project: {
_id: 0,
allTimeCount: 1,
lastDayCount: 1
}
}
]);
Если по условию для агрегации не нашлось документов, то возращается null, но это ломает валидацию при обработке этого запроса.
Как возвращать { "allTimeCount" : 0, "lastDayCount" : 0 }, если не нашлись документы для агрегации??
Уже пробовал делать проверку на $isNull и добавлять поля в $addFields
А, если вообще null
Значит нечего аггрегировать
Никак
На стороне клиента обрабатывать случай
 Arthur
Добрый вечер, подскажите пожалуйста, как можно решить задачку - есть необходимость грохать долгие запросы. Питонячий скрипт крутится в кубе, который через while True стучится по кластерам и делает db.killOp запросов превышающих порог и кидает инфу в слак.
Хочется попробовать нативную jsину, https://gist.github.com/kylemclaren/3c09a4dda5991cf0bf9c, насколько я понимаю, можно через load() грузить этот скрипт, но он должен работать постоянно, возможно через cront/systemd держать как сервис, либо есть что-то более рабочее?
Может как-то извнешки можно дергать этот скрипт, положив его в монгу как функцию?
yopp
Всем большой привет!
Пишу запрос на аггрегацию, чтобы получить количество всех заказов и заказов за последний день. Сам запрос:
var now = new Date();
var lastDay = new Date(now - 24 * 60 * 60 * 1000);
db.orders.aggregate([
{
$match: {
kitchen: "72c58acf-5506-4c7b-adcc-a9b082a623e6",
}
},
{
$group: {
_id: null,
allTimeCount: { $sum: 1 },
lastDayCount: { $sum: { $cond: [{ $gte: ["$created_at", lastDay] }, 1, 0] } }
}
},
{
$project: {
_id: 0,
allTimeCount: 1,
lastDayCount: 1
}
}
]);
Если по условию для агрегации не нашлось документов, то возращается null, но это ломает валидацию при обработке этого запроса.
Как возвращать { "allTimeCount" : 0, "lastDayCount" : 0 }, если не нашлись документы для агрегации??
Уже пробовал делать проверку на $isNull и добавлять поля в $addFields
Не уверен, но вы можете попробовать сделать $densify последним шагом
https://www.mongodb.com/docs/v6.2/reference/operator/aggregation/densify/
yopp
Добрый вечер, подскажите пожалуйста, как можно решить задачку - есть необходимость грохать долгие запросы. Питонячий скрипт крутится в кубе, который через while True стучится по кластерам и делает db.killOp запросов превышающих порог и кидает инфу в слак.
Хочется попробовать нативную jsину, https://gist.github.com/kylemclaren/3c09a4dda5991cf0bf9c, насколько я понимаю, можно через load() грузить этот скрипт, но он должен работать постоянно, возможно через cront/systemd держать как сервис, либо есть что-то более рабочее?
Может как-то извнешки можно дергать этот скрипт, положив его в монгу как функцию?
Самый надёжный вариант указывать в драйвере maxTimeMs:
см https://www.mongodb.com/docs/v6.2/reference/method/cursor.maxTimeMS/ и в доке по вашему драйверу
yopp
это не даст запросам в принципе исполнятся дольше указанного времени
yopp
killOp не гарантирует что операция сразу завершится
Arthur
killOp не гарантирует что операция сразу завершится
есть ли у вас ссылка на почитать про это?
Aleksey
А, если вообще null
Значит нечего аггрегировать
Никак
На стороне клиента обрабатывать случай
В целом к тому и пришёл, что буду обрабатывать ответ с null
Aleksey
Но ещё попробую описанные методы, спасибо большое
yopp
есть ли у вас ссылка на почитать про это?
https://www.mongodb.com/docs/v6.2/reference/command/killOp/
killOp reports success if it succeeded in marking the specified operation for termination. Operations may not actually be terminated until they reach an appropriate interruption point. Use $currentOp or db.currentOp() to confirm the target operation was terminated.
Arthur
https://www.mongodb.com/docs/v6.2/reference/command/killOp/
killOp reports success if it succeeded in marking the specified operation for termination. Operations may not actually be terminated until they reach an appropriate interruption point. Use $currentOp or db.currentOp() to confirm the target operation was terminated.
спасибо за помощь, задачу с килялкой запросов не решил конечно, но новенькое узнал : )
Milknei
А на cloud.mongodb.com можно настроить, что бы выдавались данные не с старого к новому, а с нового у старому?
Kino Recovery
в go драйвере при вызове col := k.Db.Collection(fmt.Sprintf("profile_%d", k.ID))
идет неявное создание коллекция??? ответа в документации ненашел
 Комёб
в go драйвере при вызове col := k.Db.Collection(fmt.Sprintf("profile_%d", k.ID))
идет неявное создание коллекция??? ответа в документации ненашел
Да, в go драйвере для MongoDB при вызове col := k.Db.Collection(fmt.Sprintf("profile_%d", k.ID)) происходит неявное создание коллекции, если она еще не существует.
В документации нет явного упоминания этого поведения, но оно соответствует стандартной логике работы драйвера MongoDB. При обращении к коллекции, если она уже существует, то она будет открыта для чтения и записи. Если коллекция не существует, она будет автоматически создана при первой операции записи в нее.
Если требуется явно создать коллекцию до выполнения операций с ней, можно использовать метод CreateCollection для объекта базы данных:
k.Db.CreateCollection(fmt.Sprintf("profile_%d", k.ID))
Kino Recovery
Комёб
а как проверить,что она ужесть,без перебора у меня сотни тысяч коллекций
Если у вас есть сотни тысяч коллекций, и вы хотите проверить, есть ли в них определенная коллекция, без перебора всех элементов, вы можете воспользоваться одним из следующих подходов:
1. Используйте хэш-функцию: Создайте хэш-функцию, которая будет преобразовывать каждую коллекцию в уникальное число. Затем создайте хэш-таблицу, в которой ключами будут значения хэш-функции, а значениями - сами коллекции. При проверке существования коллекции вы сможете быстро найти нужный ключ в хэш-таблице и, если ключ найден, коллекция существует.
2. Используйте структуры данных с быстрым доступом: Используйте специализированные структуры данных, такие как деревья поиска или битовые векторы, которые позволяют быстро проверять наличие элементов. Имейте в виду, что предварительная обработка данных может потребоваться для построения этих структур, но затем проверка существования будет более эффективна.
3. Используйте индексирование: Если у вас есть критерии или метаданные, которые вы можете использовать для быстрой фильтрации коллекций, вы можете построить индексы или создать каталоги, чтобы быстро найти нужные коллекции без необходимости перебора всех коллекций.
В зависимости от конкретной задачи и доступных данных, один из этих подходов может быть более эффективным.
Nick
Хотел как то помочь.
Если используете чатгпт не копируйте ответ как есть - читайте ответ, переваривайте и выдавайте то что является корректной частью, если оно там действительно есть. Не перекладывайте часть с оценкой адекватности ответа безумной нейронки людям которые обращаются за помощью и не в состоянии отсечь дичь.
Конретно тут все дичь
Nick
а как проверить,что она ужесть,без перебора у меня сотни тысяч коллекций
Сам факт того что у вас сотни тысяч коллекций говорит что проблема с проектированием и на этом фоне потребность проверять перебором наличие коллекции вполне нормальная плата.
Kino Recovery
Стоп а почему я такой дурак
Kino Recovery
Достаточно лишь проверять количество записей в коллекции если оно равно нулю
Kino Recovery
Хотел как то помочь.
Спасибо вам огромное, за старание, но пока chatgpt конечно дополняет наш мозг, но не заменяет его
Kino Recovery
Сам факт того что у вас сотни тысяч коллекций говорит что проблема с проектированием и на этом фоне потребность проверять перебором наличие коллекции вполне нормальная плата.
Действительно у меня достаточно мало опыта общения с монгой. Не могли бы вы рассказать почему такое большое количество коллекций в одной базе это плохо
Kino Recovery
Nick
Действительно у меня достаточно мало опыта общения с монгой. Не могли бы вы рассказать почему такое большое количество коллекций в одной базе это плохо
как правило коллекция выделяется под один тип документов. Очень мало случаев когда реально существует потребность в сотнях тысячах различных типах документов с различной структурой. Также на таких количествах очень сильно затрудняется менеджмент и мониторинг бд вцелом, т.к. нужно выдумывать средства автоматизации на каждый чих и руками мало что можно проверить. Такое допустимо разве что есть потребность делать например коллекцию на каждый новый день для разных источников, но даже так насобирать сотни тысяч это даже для 5 лет по одному дню - это сотня источников и любой поиск по этим данным будет сложен по сравнению со сливанием в большие коллекции
Nick
Действительно у меня достаточно мало опыта общения с монгой. Не могли бы вы рассказать почему такое большое количество коллекций в одной базе это плохо
расскажите почему у вас так много коллекций? по какому признаку они разделены?
ну и тут назревает важный вопрос не путаете ли вы коллекции с документами в коллекции?
.
645bca35f7424eb305fc385c помогите надо
.
Декодер
.
Нужна
.
Обжект ид
Elvee
Всем привет! Подскажите момент с режимом реплик в монго. Если я сейчас создам базу в обычном режиме, смогу ли я в дальнейшем перевести в режим набора реплик без потери данных?
Андрей
да
Андрей
Имеет ли смысл запускать в режиме набора реплик с одной нодой? или лучше обычный запуск
Только если транзакции нужны, а "контора - бомж".
Elvee
Мне чисто для хранения. И контора Бомж 😂
Kino Recovery
расскажите почему у вас так много коллекций? по какому признаку они разделены?
ну и тут назревает важный вопрос не путаете ли вы коллекции с документами в коллекции?
источников сотни тысяч из разных регионов, данных очень много, один "кадр" из источника, это документ, с динамическим набором полей. Таких "кадров" от десятков до 300 сотен в день. История с 2018 по сегодня.
Задача: дать датасатанистам, доступ к этим данным.
идея в том, что 1 источник ==1 коллекция