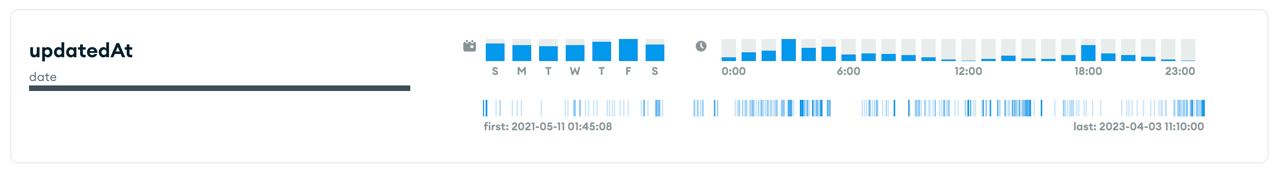
Date
Просто Date, не array of Date?
 Alexander

 Alexander
 Alexander
у него скорее всего ISODate используется, а не таймштамп
ISODate() - это просто функция, которая возвращает Date
Alexander
test> a = ISODate()
ISODate("2023-04-03T13:12:10.249Z")
test> new Date()
ISODate("2023-04-03T13:12:15.061Z")
 Alexandrr
 Hunter
Alexander
sizeof сколько?
Все не так просто. В индексе данные хранятся, предварительно сконвертированные в KeyString:
https://github.com/mongodb/mongo/blob/f7722296ffa2f05b755abc081b59a036db7bbf1f/src/mongo/db/storage/key_string.cpp#L756-L762
Мы видим, что Date() добавляет 9 байт - 1 байт на тип данных + 8 байт на timestamp.
Это для ключа, значение же хранится в RecordId, которое обычно занимает 8 байт.
Но, WiredTiger сжимает данные, поэтому реальный размер меньше.
 The end.
Добрый день! Подскажите, пожалуйста на счет установки mongo c++ и C driver. Когда я собираю c driver у меня нету папки lib в которой должен быть файл libmongoc-1.0.lib.
собираю на windows
Alexandrr
Все не так просто. В индексе данные хранятся, предварительно сконвертированные в KeyString:
https://github.com/mongodb/mongo/blob/f7722296ffa2f05b755abc081b59a036db7bbf1f/src/mongo/db/storage/key_string.cpp#L756-L762
Мы видим, что Date() добавляет 9 байт - 1 байт на тип данных + 8 байт на timestamp.
Это для ключа, значение же хранится в RecordId, которое обычно занимает 8 байт.
Но, WiredTiger сжимает данные, поэтому реальный размер меньше.
для сравнения, в python sizeof() для объекта таймштампа в _id возвращает 48 байт, +12 байт согласно доки сам _id ("Returns a new ObjectId. The 12-byte ObjectId consists of:"), итого 60 байт.
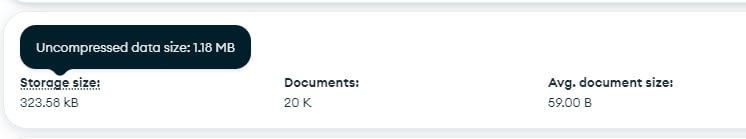
при простом подсчёте 129кк (судя по скрину) = 60*129000000/1024/1024/1024 = 7.2 ГБ, это без учёта unicode/decode операций при прохождении через IO.
фактический размер будет гораздо больше.
удивительно, что на скрине 115 ГБ индексы весят.
но если пересчитывать на аверадж документа 129кк * 1.09 / 1024 / 1024 = 134 ГБ
при этом написано storadge_size = 42 ГБ, это как вообще?
ну и если 134 - 42, то ни как не равно 115 ГБ.
получается эта программа, что на скрине нагло врёт про размеры
The end.
Добрый день! Подскажите, пожалуйста на счет установки mongo c++ и C driver. Когда я собираю c driver у меня нету папки lib в которой должен быть файл libmongoc-1.0.lib.
собираю на windows
1. git clone https://github.com/mongodb/mongo-c-driver.git
2. cd mongo-c-driver
3. cd build
4. cmake -G "Visual Studio 17 2022" -A x64 -DENABLE_AUTOMATIC_INIT_AND_CLEANUP=OFF -DCMAKE_INSTALL_PREFIX=C:\cpp_libs\mongo-c-driver ..
5. cmake --build . --config Release
Alexander
для сравнения, в python sizeof() для объекта таймштампа в _id возвращает 48 байт, +12 байт согласно доки сам _id ("Returns a new ObjectId. The 12-byte ObjectId consists of:"), итого 60 байт.
при простом подсчёте 129кк (судя по скрину) = 60*129000000/1024/1024/1024 = 7.2 ГБ, это без учёта unicode/decode операций при прохождении через IO.
фактический размер будет гораздо больше.
удивительно, что на скрине 115 ГБ индексы весят.
но если пересчитывать на аверадж документа 129кк * 1.09 / 1024 / 1024 = 134 ГБ
при этом написано storadge_size = 42 ГБ, это как вообще?
ну и если 134 - 42, то ни как не равно 115 ГБ.
получается эта программа, что на скрине нагло врёт про размеры
 Alexandrr
Alexander
Кстати, при чем тут размер объекта в Python? Данные в MongoDB хранятся в сжатом BSON. Собственно сжатие объясняет путаницу с размерами
Alexandrr
по умолчанию используется http://google.github.io/snappy/
там прям чёрным по белому написано:
"For instance, compared to the fastest mode of zlib, Snappy is an order of magnitude faster for most inputs, but the resulting compressed files are anywhere from 20% to 100% bigger."
перевод:
"Например, по сравнению с самым быстрым режимом zlib, Snappy на порядок быстрее для большинства входных данных, но получаемые сжатые файлы от 20% до 100% больше."
а теперь идём сюда (https://www.mongodb.com/docs/manual/core/wiredtiger/#std-label-storage-wiredtiger-compression) и смотрим:
"Compression
With WiredTiger, MongoDB supports compression for all collections and indexes. Compression minimizes storage use at the expense of additional CPU.
By default, WiredTiger uses block compression with the snappy compression library for all collections and prefix compression for all indexes."
перевод:
"Сжатие
Благодаря WiredTiger, MongoDB поддерживает сжатие для всех коллекций и индексов. Сжатие минимизирует использование хранилища за счет дополнительного процессора.
По умолчанию WiredTiger использует блочное сжатие с библиотекой сжатия snappy для всех коллекций и префиксное сжатие для всех индексов."
Alexandrr
теперь понятно почему я привёл в пример именно sizeof() python?...
ну вообщем там на странице гитхаба в сорсе всё расписано если вчитываться
Alexander
теперь понятно почему я привёл в пример именно sizeof() python?...
ну вообщем там на странице гитхаба в сорсе всё расписано если вчитываться
Честно говоря, непонятно при чем тут размер в Python.
Alexandrr
Честно говоря, непонятно при чем тут размер в Python.
проще говоря этот метод делает unicode|decode операции, то же, что и сам snappy, так как исходники одинаковые
на счёт последнего могу ошибаться, потому что давно в плюсы не смотрел последних версий, но вроде не менялось ничего
Alexandrr
вообщем, для 17 индексов криво настроенных, которые используются не по назначению, 115 ГБ это норм
 Daniel
Да без индексов
То есть как я понял из вашего диалога
У меня с индексами все в порядке, просто коллекция сжата и весит 40 гигов, а по факту вселила бы намного больше и размер индекса по дате нормальный?
И оптимизировать это дело некуда?
Alexander
То есть как я понял из вашего диалога
У меня с индексами все в порядке, просто коллекция сжата и весит 40 гигов, а по факту вселила бы намного больше и размер индекса по дате нормальный?
И оптимизировать это дело некуда?
Я не уверен, что все в порядке, индексы с updatedAt занимают в 30 раз больше места, чем бы я ожидал от non multikey index, или всё-таки они multikey?
Alexander
Попробуйте посмотреть в explain тин индекса, если вы выполните команду вроде
db.productcolors.find({updatedAt: ISODate()}).hint('updatedAt_-1').explain()
IXSCAN stage будет содержать информацию об индексе
stage: 'IXSCAN',
keyPattern: {
updatedAt: -1
},
indexName: 'updatedAt_-1',
isMultiKey: true,
multiKeyPaths: {
updatedAt: [
'updatedAt'
]
},
isUnique: false,
isSparse: false,
isPartial: false,
indexVersion: 2,
direction: 'forward',
indexBounds: {
updatedAt: [
'[new Date(1680541832466), new Date(1680541832466)]'
]
}
 Александр
 Александр
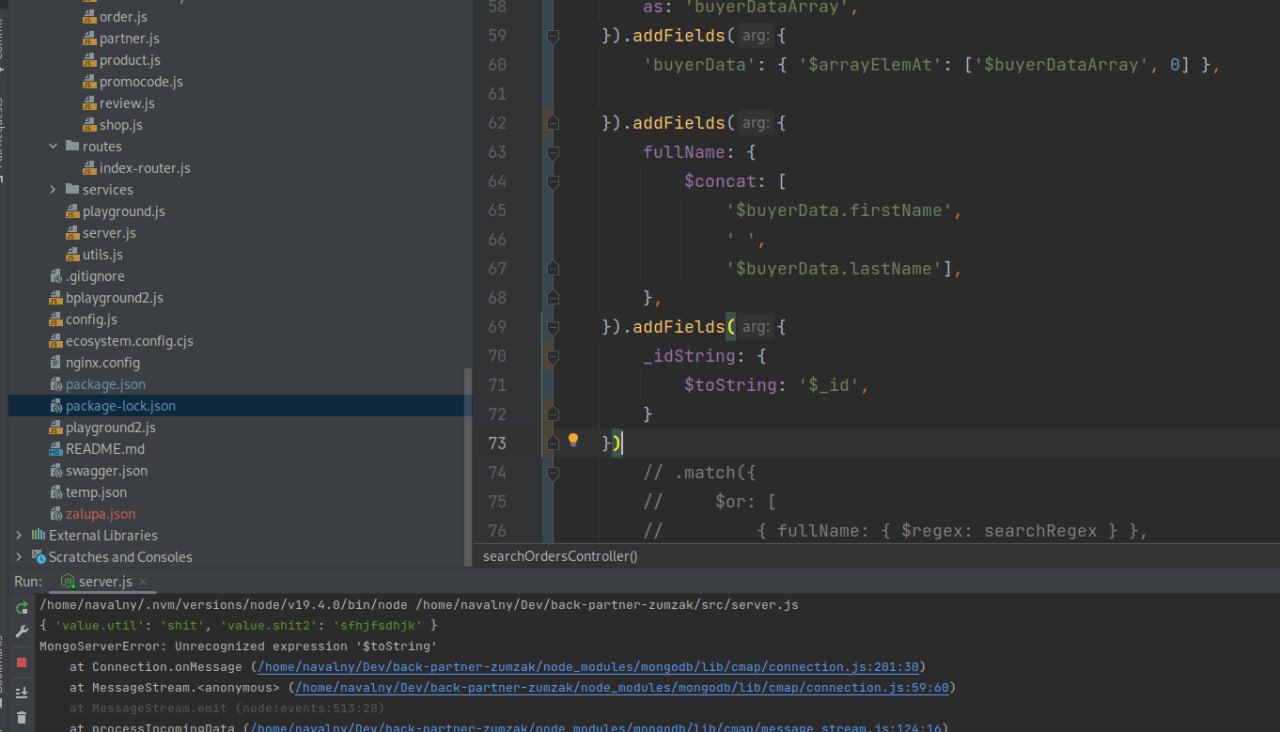
$convert тоже не работает, все перепробывал
Александр
Подскажите пожалуйста в чем может быть проблема, версия монгуза "version": "7.0.3",
Александр
Igor
Всем добрый день.
Не сталкивался никто с проблемами сортировки на вьюхах ? Проконсультирует ли кто по особенностям и как решать проблему медленных запросов с сортировкой? Спасибо.
Alexander
Всем добрый день.
Не сталкивался никто с проблемами сортировки на вьюхах ? Проконсультирует ли кто по особенностям и как решать проблему медленных запросов с сортировкой? Спасибо.
Нужны правильные индексы, слышали про правило ESR?
https://www.mongodb.com/docs/manual/tutorial/equality-sort-range-rule/
Alexander
И если много документов возвращается, то идеально бы использовать covered query, иначе FETCH убьет всю производительность
https://www.mongodb.com/docs/manual/core/query-optimization/#covered-query
Igor
filter:{ <диапазон по date>}, sort:{ "date" : -1 }, limit:50.
Поле разумеется в индексе.
Во вьюхе две коллекции по одинаковой схеме. Я здесь соблюдаю правило ESR.
Запрос чисто на коллекции работает, а на вьюхе над двумя коллекциями тормозит.
 Евгений
Привет, народ. Немогу осилить вопрос, помогите.
Мои документы (пример)
{... 'status': 'Отклик', 'id_contact': '111' ...}
{... 'status': 'Анкета', 'id_contact': '111' ...}
{... 'status': 'Отклик', 'id_contact': '222' ...}
{... 'status': 'Анкета', 'id_contact': '222' ...}
{... 'status': 'Анкета', 'id_contact': '222' ...}
Моя группировка
{'$group': {'_id': '$status', 'count': {'$sum': 1}}}
Мой результат
{'_id': 'Отклик', 'count': 2}
{'_id': 'Анкета', 'count': 3}
Но мне нужно посчитать уникальные id_contact в каждой группе. Т.е. я хочу получить такой результат:
{'_id': 'Отклик', 'count': 2}
{'_id': 'Анкета', 'count': 2}
Как подсчитать количество уникальных id_contact в каждой группе?
Alexander
Привет, народ. Немогу осилить вопрос, помогите.
Мои документы (пример)
{... 'status': 'Отклик', 'id_contact': '111' ...}
{... 'status': 'Анкета', 'id_contact': '111' ...}
{... 'status': 'Отклик', 'id_contact': '222' ...}
{... 'status': 'Анкета', 'id_contact': '222' ...}
{... 'status': 'Анкета', 'id_contact': '222' ...}
Моя группировка
{'$group': {'_id': '$status', 'count': {'$sum': 1}}}
Мой результат
{'_id': 'Отклик', 'count': 2}
{'_id': 'Анкета', 'count': 3}
Но мне нужно посчитать уникальные id_contact в каждой группе. Т.е. я хочу получить такой результат:
{'_id': 'Отклик', 'count': 2}
{'_id': 'Анкета', 'count': 2}
Как подсчитать количество уникальных id_contact в каждой группе?
Можно например, оставить только уникальные комбинации status и id_contact сначала, добавив другой $group:
[
{$group: {_id: {status: "$status", id_contact: "$id_contact}},
{$group: {_id: "$_id.status", count: {$sum: 1}}}
]
Евгений
Можно например, оставить только уникальные комбинации status и id_contact сначала, добавив другой $group:
[
{$group: {_id: {status: "$status", id_contact: "$id_contact}},
{$group: {_id: "$_id.status", count: {$sum: 1}}}
]
Спасибо тебе, это работает, я если честно не знал что можно group использовать повторно ))
First
привет, подскажите, почему так:
collection
.find(filter)
.sort(sort)
.skip(pageSize * page)
.limit(pageSize)
.iterator()
.forEachRemaining(
на второй и следующих страницах выдает частично одинаковые результаты? фильтр и сортировка не менялись
Alexandrr
Alexandrr
привет, подскажите, почему так:
collection
.find(filter)
.sort(sort)
.skip(pageSize * page)
.limit(pageSize)
.iterator()
.forEachRemaining(
на второй и следующих страницах выдает частично одинаковые результаты? фильтр и сортировка не менялись
просто если ты скипаешь ps*p, то в случае если это 2 страница, нужно вычитать ещё ps для скипа, иначе ты ту же страницу будешь показывать.
я написал так:
skip = pagination[0] * pagination[1] - pagination[1] if pagination[0] > 1 else None
if skip:
return .find(params).skip(skip).limit(pagination[1]))
else:
return .find(params).limit(pagination[1]))
где:
pagination[0] - страница
pagination[1] - количество элементов на странице
в таком случае у меня постоянно выходит одинаковый результат.
если протестируешь, и будет всё равно разные результаты поиска, то значит дело в сортировке или изменениях коллекции
First
спасибо, сейчас проверю
First
просто если ты скипаешь ps*p, то в случае если это 2 страница, нужно вычитать ещё ps для скипа, иначе ты ту же страницу будешь показывать.
я написал так:
skip = pagination[0] * pagination[1] - pagination[1] if pagination[0] > 1 else None
if skip:
return .find(params).skip(skip).limit(pagination[1]))
else:
return .find(params).limit(pagination[1]))
где:
pagination[0] - страница
pagination[1] - количество элементов на странице
в таком случае у меня постоянно выходит одинаковый результат.
если протестируешь, и будет всё равно разные результаты поиска, то значит дело в сортировке или изменениях коллекции
наверное это будет работать если страницы начинаются с 1 , а у меня с 0 :)
First
коллекция 100% не меняется, сортировку отключал... остался только фильтр видимо
Alexandrr
наверное это будет работать если страницы начинаются с 1 , а у меня с 0 :)
да, я мысли читать не умею, не было указано с какого числа начинается нумерация страниц
начинать нумерацию с нуля не самый лучший вариант, есть несколько причин (имхо)
но каждый делает как хочет
остался фильтр, да, если сортировка не меняется
Alexander
Наоборот нужна сортировка которая задаёт total order, иначе порядок документов неопределен. В вашем случае сортировка скорее не по уникальным полям
First
да, я мысли читать не умею, не было указано с какого числа начинается нумерация страниц
начинать нумерацию с нуля не самый лучший вариант, есть несколько причин (имхо)
но каждый делает как хочет
остался фильтр, да, если сортировка не меняется
я без претензий :) подозреваю, что проблема в фильтре, в котором используется патерн для поиска по тексту
Alexandrr
я без претензий :) подозреваю, что проблема в фильтре, в котором используется патерн для поиска по тексту
напиши что внутри переменной суёшь
Alexander
https://medium.com/swlh/mongodb-pagination-fast-consistent-ece2a97070f3
Раздел "Sorting and Tiebreaker"
Alexander
И официальная документация
Using skip() with sort()
If using
skip()
with sort(), be sure to include at least one field in your sort that contains unique values, before passing results to
skip().
Sorting on fields that contain duplicate values may return an inconsistent sort order for those duplicate fields over multiple executions, especially when the collection is actively receiving writes.
The easiest way to guarantee sort consistency is to include the _id field in your sort query.
See Consistent sorting with the sort() method for more information.
https://www.mongodb.com/docs/manual/reference/method/cursor.skip/#using-skip---with-sort--
First
спасиб, буду читать)
Alexandrr
я не имел ввиду код, я имел ввиду конечное выражение mongodb, нужно понимать ты осуществляешь:
- поиск текста по строкам, строка фильтра = искомой строке
- полнотекстовый поиск
- поиск с помощью регулярных выражений
- поиск строки в bytes зашифрованной алгоритмами типа AES
но выше тебе правильный ответ дал Александр
First
Наоборот нужна сортировка которая задаёт total order, иначе порядок документов неопределен. В вашем случае сортировка скорее не по уникальным полям
да, поля не уникальные, я прочитал статью, но не понял как сделать total order. Сделал составной индекс для не уникальных полей, но это не то видимо
First
разобрался, всем спасибо:)
First
а кто-нибудь подскажет могу я использовать один объект BSON для фильтра в многопотоке? или на каждый запрос нужен свой объект?
 Nick
а кто-нибудь подскажет могу я использовать один объект BSON для фильтра в многопотоке? или на каждый запрос нужен свой объект?
Какой язык и меняется ли содержимое объекта?
Nick
Может драйвер там чего пишет в него
Вряд ли, но всегда можно открыть сырцы или дебагером пройтись
First
Вряд ли, но всегда можно открыть сырцы или дебагером пройтись
Да, тоже подумал об этом, спасиб)
Nick
прорабатывают логику изменения данных с учетом требований и возможностей бд. например берут транзакции и не думают об этом
Nick
если что в монге тразакции уже тыщу лет как есть
Nick
https://www.mongodb.com/docs/manual/core/transactions/
Nick
не менее увлекательное чтиво https://www.mongodb.com/docs/manual/indexes/
Nick
если у вас какойто конкретный вопрос, то задавайте, по общим вопросам слишком много текста выдат ьпридется
 Vlad Dubok
Подскажите плиз как решить задачу. У меня есть коллекция А в которой есть массив B в котором есть массив С. В последнем есть поле EndDate она же дата. Мне нужно достать всю коллекцию, но при этом отфильтровать ее так чтобы в массиве С остались только те документы которые EndDate > Datetime().
Я начал делать через агрегацию:
Сначала откинул все елементы которые не имеют нужной даты
{
$match: {
"B.C.EndDate": { $gte: new Date("2023-01-01") }
}
},
Vlad Dubok
дальше пытаюсь делать следущее
{
$project:{
B: {
C: {
$filter: {
input: "$B.C",
as: "task",
cond:{
$gte: ["$$task.EndDate", new Date("2021-01-01")]
}
}
}
}
}
},
Vlad Dubok
Сейчас возвращаються пустые С без какой либо инфы
 ᅠIgor
Всем привет.
Если я хочу сделать приложение, чтобы пользователи могли загружать картинки (разные пользователи - разное кол-во картинок), подойдёт ли мне для этого mongo?
Ivan
ᅠIgor
А может подскажите, где можно именно картинки хранить?
ᅠIgor
Думал может есть сервис какой то для хранения такого рода файлов
ᅠIgor
Это понятно
ᅠIgor
Буду разбираться, спасибо
Daniil
Думал может есть сервис какой то для хранения такого рода файлов
любой S3-like сторадж, включая minio, который можно развернуть локально
Alexandrr
Думал может есть сервис какой то для хранения такого рода файлов
CDN сеть можно использовать
ᅠIgor
любой S3-like сторадж, включая minio, который можно развернуть локально
Я так понял, что это что то типа amazon s3?
 Алексей
Всем привет) А используюя .populate() можно делать какую то выборку по полям?
К примеру есть схема поста которая ссылается на схему юзера, как сделать так что бы тянулись не все данные юзера а несколько полей?
Alexander