 🅰️nimeCoder


тогда должно работать) проблема снята?
🅰️nimeCoder
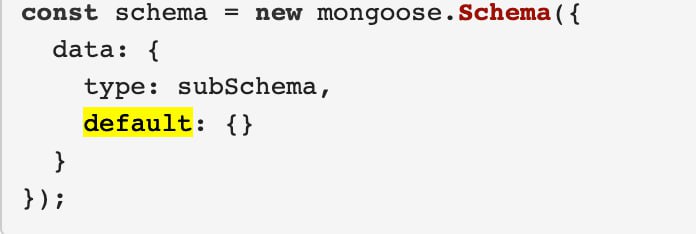
ну я чет погугулил на стэке чет есть какие то примеры. но никогда не видел чтоб так делали если честно, можешь скинуть страницу на документации монгуза?
 Данил
ну я чет погугулил на стэке чет есть какие то примеры. но никогда не видел чтоб так делали если честно, можешь скинуть страницу на документации монгуза?
https://mongoosejs.com/docs/schematypes.html
типы
🅰️nimeCoder
чет нету такм такого)
🅰️nimeCoder
да и тут тоже https://mongoosejs.com/docs/defaults.html
Данил
примитивы в default можно записывать, вот я и подумал что объекты тоже можно, нельзя видимо)
🅰️nimeCoder
но думаю можно
{
type: Array,
default: ['1', '2']
}
🅰️nimeCoder
возможно если в type можно передать Schema объект, то мб и прокатит, но я не видел тоже такого, чисто предположение
Данил
 TTY
добрый день. не подскажите как экспортировать данные из кластера атласа?
у них там на этапе изучения предлагается дб, но кроме как импортировать ее на самом атласе описания не нашел
спасибо
TTY
 Easy Rider
Я за 5 минут разобрался и сделал дамп и обратно restore, но у меня на vds mongo
🅰️nimeCoder
🅰️nimeCoder
 TTY
Через утилиту я видел команду, но у меня впн только в браузере висит. А там ещё список разрешенных айпишников
Тогда перефразирую немного. Если я добавлю свой айпи адрес от провайдера в список разрешенных к коннекту, атлас запретит соединение?(пк отключен, просто. Так бы сам попробовал)
🅰️nimeCoder
почему атлас должен запретить коннект на разрешенный IP
🅰️nimeCoder
да и если включена авторизация, я бы не сильно парился о доступа пок левому IP
🅰️nimeCoder
есть десяток кластеров ни с оним нет проблем, все разрешены с ANYWHERE, пароли ясно что не qwerty
🅰️nimeCoder
ну и плюс можно же прокидывать коннект через ssh обычно, тут я думаю утилиты тоже поддерживают
 Дашини
Всем привет, я джун мало, что понимаю, почему в sql лучше не хранить картинки?  И может посоветуете инструмент, который больше для этой задачи подходит?
TTY
Viktar
Всем привет, я джун мало, что понимаю, почему в sql лучше не хранить картинки?  И может посоветуете инструмент, который больше для этой задачи подходит?
Можно хранить. Но лучшей практикой является хранить ссылки на картинки.
Дашини
Мне кажется,что для быстрой обработки файлов не подойдет, храня их ссылками
Дашини
Вообще больше интересуют инструменты для машинного обучения, может есть здесь лидеры?
 Nick
Всем привет, я джун мало, что понимаю, почему в sql лучше не хранить картинки?  И может посоветуете инструмент, который больше для этой задачи подходит?
Сначала определитесь что делаться будет с картинками и какие требования к этому процессу есть, от этого уже определять как хранить
Easy Rider
сами картинки обычно хранят в файлах. это правильный путь, т.к. веб-сервер хорошо оптимизирован для кэширования статики, ну и нагрузки на БД нет
Easy Rider
но при этом надо хранить метаданные часто, описания какие-то, разные версии, следить за синхронизацией этого всего
Easy Rider
поэтому возникает порой искушение хранить картинки в виде массива байт в базе
Easy Rider
так можно делать, но надо сделать кэш в памяти обязательно.
Easy Rider
иначе базу данных любой школьник положит
 Alexandrr
так можно делать, но надо сделать кэш в памяти обязательно.
так нельзя делать никогда.
использовать CDN для этого нужно
либо жынксь с динамическими маршрутами или другие приблуды
Easy Rider
так нельзя делать никогда.
использовать CDN для этого нужно
либо жынксь с динамическими маршрутами или другие приблуды
почкему нельзя? религия запрещает? есть разные случаи, например мелкие аватарки, которые занимают по пару килобайт, можно хранить в базе
Easy Rider
в идеале конечно, картинки должны быть в файлах
Easy Rider
но при этом придется писать кучу кода для синхронизации
Easy Rider
с базой данных
Easy Rider
поэтому в некоторых случаях можно зафигачить картинки в отдельную коллекцию, ничего мега-страшного тут нет
Easy Rider
особенно если выделить гиг оперативы на кэш, тогда они не будут нагружать вообще базу почти
Easy Rider
а чтобы замаскировать факт такого безобразия, можно маршрут сделать к ним начинающийся на /static
Дашини
А есть ли какая-то альтернатива дефолт файлам? Не знаю, например, hdf?
Easy Rider
А есть ли какая-то альтернатива дефолт файлам? Не знаю, например, hdf?
файловая система это и есть идеальная база данных для хранения файлов 😂 лучше просто не придумать
Alexandrr
почкему нельзя? религия запрещает? есть разные случаи, например мелкие аватарки, которые занимают по пару килобайт, можно хранить в базе
ну храни, молодец😅, кто ж тебе запрещает
Дашини
файловая система это и есть идеальная база данных для хранения файлов 😂 лучше просто не придумать
Хаха, ладно
Поняла, спасибо
Дашини
А что на счёт машинного обучения?
Easy Rider
к примеру мы удаляем юзера. у него хуева гора картинок может быть. нам надо написать отдельный сервис для работы с файлами тогда, и в транзкции его учитывать, а также делать откат например, это может быть весьма сложно запилить если нет какого-то готового решения. а если хранить все в коллекции, то все это делается как обычно. хотя производительность страдает
 Hunter
Кто знает как сделать синхронизацию двух коллекций, что б если в одной поле изменилось значение в другой коллекции тоже изменилось
Easy Rider
Кто знает как сделать синхронизацию двух коллекций, что б если в одной поле изменилось значение в другой коллекции тоже изменилось
это архитектурный вопрос, скорее всего тебе нужно иметь одну коллекцию просто
Hunter
Ну так не выйдет, в одной у меня упражнения (название, описание и видео) , а в другой уже тренировки которые состоят из этих упражнений и вот нужно при изменение видео в одной и з упражнений изменять его в тренировках
Дашини
так нельзя делать никогда.
использовать CDN для этого нужно
либо жынксь с динамическими маршрутами или другие приблуды
Насколько быстро работает CDN?
Easy Rider
Ну так не выйдет, в одной у меня упражнения (название, описание и видео) , а в другой уже тренировки которые состоят из этих упражнений и вот нужно при изменение видео в одной и з упражнений изменять его в тренировках
у тебя на уровне приложения должно браться и там и там всё из одной коллекции просто.
Alexandrr
Насколько быстро работает CDN?
зависит от CDN
можно и самому организовать, только нужно прочитать для начала что это такое
Mirzafar
Всем привет возможно ли восстановить базу, если я удалил саму mongo то есть purge и удалил log, lib?
Andrey
Логироние - читаю документацию, и не могу найти - как ограничить размер лог файла
Andrey
как установить условный logrotate по размеру, ограничить текущий лог
Wassilevs
Wassilevs
<path>mongod.log {
daily
size 500M
rotate 10
missingok
compress
dateext dateformat
notifempty
create 600 mongodb mongodb
sharedscripts
postrotate
/bin/kill -SIGUSR1 cat /var/run/mongodb/mongod.pid 2>/dev/null >/dev/null 2>&1
endscript }
Vik II
если нет createdAt и updatedAt, то по какому параметру можно сортировать ?
Vik II
_id правильно сортировать ?
 Mark
Mirzafar
<path>mongod.log {
daily
size 500M
rotate 10
missingok
compress
dateext dateformat
notifempty
create 600 mongodb mongodb
sharedscripts
postrotate
/bin/kill -SIGUSR1 cat /var/run/mongodb/mongod.pid 2>/dev/null >/dev/null 2>&1
endscript }
получается можно восстановить если даже удалено log?
Mirzafar
или можно ли восстановить удаленный log?
Alexander
или можно ли восстановить удаленный log?
Удаленные файлы действительно можно восстановить, но не всегда. Есть специальные утилиты, типа TestDisk: https://www.cgsecurity.org/wiki/TestDisk, есть даже люди и фирмы, специализизирующиеся на восстановлении данных. Идея восстановления заключается в том, что операционная система не затирает удаленные файлы, а просто помечает их как удаленные. В этот момент их еще можно восстановить, но в любой момент, место на диске, которое хранит удаленный файл, может быть переиспользовано для другого файла и тогда восстановить не получится.
Alexander
Всем привет, я джун мало, что понимаю, почему в sql лучше не хранить картинки?  И может посоветуете инструмент, который больше для этой задачи подходит?
Это прямо большой вопрос. Все дело в том, что базы данных (я думаю именно базы данных вы назвали sql), хранят данные в том, что называет страница памяти. Когда базы данных работают с данными они читают данные с диска и пишут их на диск постранично. Если мы пытаемся записать что-то большое в базу данных, например, картинку, она не помещается в одну страницу и тогда создаются дополнительные страницы - overflow pages. Это значит, что чтении данных с диска вместо одной операции поиска и чтения данных с диска, нам потребуется несколько операций поиска и чтения. И это гораздо дороже, чем вы можете себе представить, операция поиска на HDD - это примерно 10ms, то есть всего 100 операций поиска в секунду, а на SSD - это 0.1 ms, 10000 в секунду.
То есть картинка размером в 1MB, и размером страницы в базе данных в 4KB, потребует 250 операций поиска на диске, на HDD - это 2 с половиной секунды. На самом деле многие базы данных оптимизируют этот процесс, и хранят большие блобы не в страницах. Но это не отменяет того факта, что эти блобы требуют дополнительных операций поиска, пусть и не так много.
Большие картинки гораздо выгоднее хранить одним большим блобом на диске, тогда при чтении их с диска, скорей всего потребуется всего одна операция поиска на картинку.
Про то как работать с размерами страниц MongoDB можно почитать в документации WiredTiger (MongoDB storage engine): https://source.wiredtiger.com/3.1.0/tune_page_size_and_comp.html
Alexander
Вообще больше интересуют инструменты для машинного обучения, может есть здесь лидеры?
Что за лидеры? Вообще, для машинного обучения в целом по барабану, раз уж вы задаете этот вопрос. Операции чтения из базы данных перед обучением моделей занимает не так много времени по сравнению со временем обучения. Поэтому можно хранить в том хранилище где удобнее. При условии конечно что к самому хранилищу есть быстрые каналы.
Alexander
Ну так не выйдет, в одной у меня упражнения (название, описание и видео) , а в другой уже тренировки которые состоят из этих упражнений и вот нужно при изменение видео в одной и з упражнений изменять его в тренировках
Можно слушать изменения в одной коллекции с помощью Change Streams и писать в другую, когда в первой что-то поменялось.
https://www.mongodb.com/docs/manual/changeStreams/
Alexander
_id правильно сортировать ?
Если его тип ObjectID, то первые 4 байта кодируют timestamp, когда этот ObjectID был создан.
Alexandrr
Если его тип ObjectID, то первые 4 байта кодируют timestamp, когда этот ObjectID был создан.
стоит уточнить:
https://www.mongodb.com/docs/manual/reference/method/ObjectId/
 Daniel
добрый день
столкнулись с вопросом про индексы
не могу найти ответ на свой вопрос
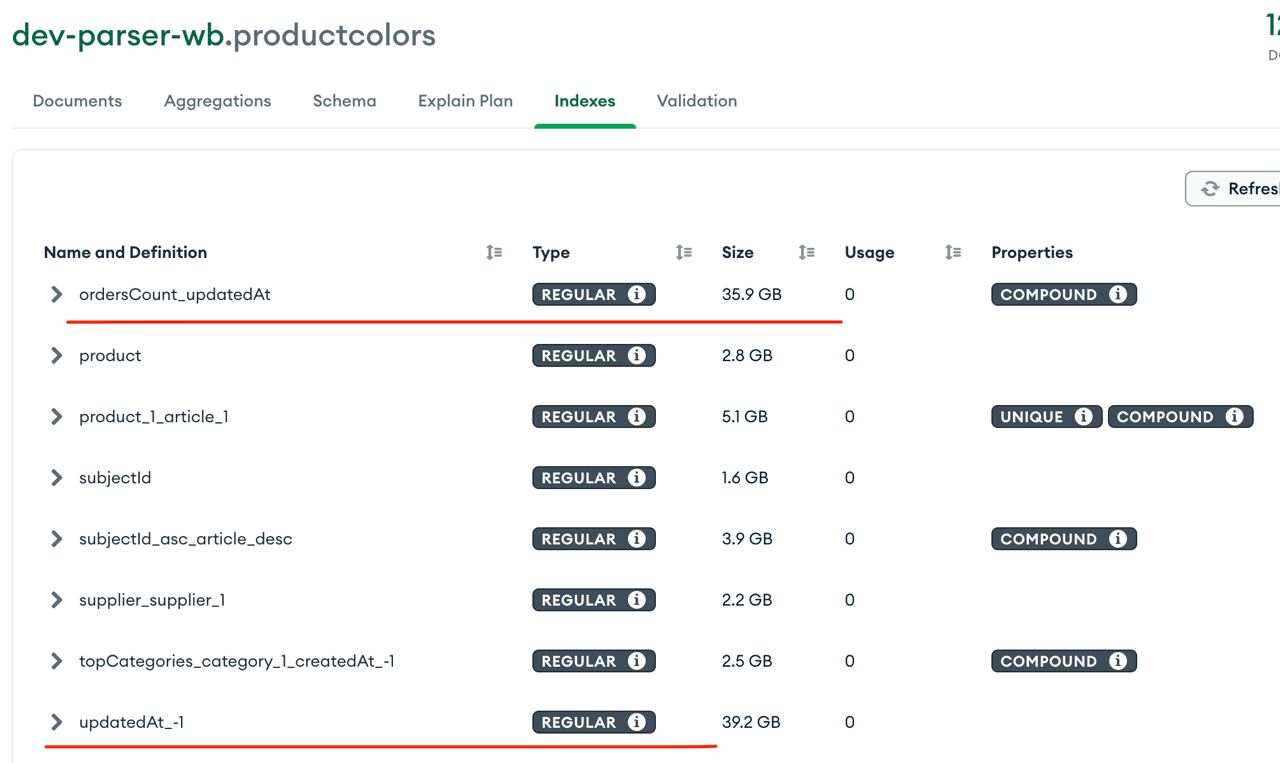
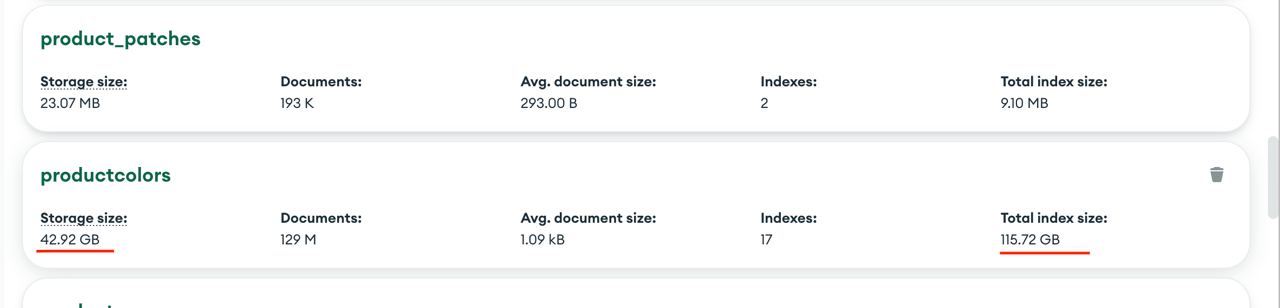
есть несколько коллекций, где в каждой пара compound индексов по updatedAt весит в полтора раза больше, чем весь датасет
почему так?
 Aleksander
 Daniel
тантор?
Alexandrr
добрый день
столкнулись с вопросом про индексы
не могу найти ответ на свой вопрос
есть несколько коллекций, где в каждой пара compound индексов по updatedAt весит в полтора раза больше, чем весь датасет
почему так?
потому, что нужно почитать про механизмы создания индексов для начала, а потом начать их оптимизировать.
начать стоит от сюда: https://www.mongodb.com/docs/manual/indexes/
Nick
 Alexander