спасибо, в принципе так и думал. задача стоит более широко - сделать очтеты универсальными, чтобы не нужно было каждый отчет в коде делать (их у нас много). поэтому пока пришел к решению разбить на несколкьо агрегаций и получается что мы запускаем цепочку агрегаций, передавая результаты одной в другую по установленным правилам. думаю как сделать это унирвесальным и не очень сложным одновременно)
нормальный подход, но монга не про универсальные отчеты. Она вообще не про отчеты, если у вас они сложные.
 Nick

 Nick
Nick
В документе определенный набор полей. Имеет ли значение всегда один и тот же порядок полей в разных документах, например с точки зрения производиельности?
не имеет, хотя в питоновском маппере считают что имеет и там более коротки названия идут сначала
 Alexandrr
не имеет, хотя в питоновском маппере считают что имеет и там более коротки названия идут сначала
нет, маппер так же по хэшам раскладывает
словарь хранит хэши значений при сравнениях и перезаписи
https://docs.python.org/3/tutorial/datastructures.html#dictionaries
 Alexander
нормальный подход, но монга не про универсальные отчеты. Она вообще не про отчеты, если у вас они сложные.
будет вызываться несколько пайплайнов, объем данных не запредельный.
Nick
нет, маппер так же по хэшам раскладывает
словарь хранит хэши значений при сравнениях и перезаписи
https://docs.python.org/3/tutorial/datastructures.html#dictionaries
не могу найти, короче в какомто драйвере или какомто десериализаторе поля в jsonах переупорядочивались в порядке от самого короткого названия к самому старшему в результате в бд попадали даные в таком порядке
Nick
нет, маппер так же по хэшам раскладывает
словарь хранит хэши значений при сравнениях и перезаписи
https://docs.python.org/3/tutorial/datastructures.html#dictionaries
это не в питоне было, а постгресе, чет попутал
Alexandrr
это не в питоне было, а постгресе, чет попутал
ну да)
я же тоже думаю, там от этого не зависит)
 yopp
В документе определенный набор полей. Имеет ли значение всегда один и тот же порядок полей в разных документах, например с точки зрения производиельности?
В основном имеет значение в случае сравнения
Документы {a:1,b:2} и {b:2,a:1} разные документы. Если вы будете искать по полному совпадению (например вложенная структура), то результат может быть неожиданным
yopp
Alexander
(1) лукап из продуктов в продажи
(2) и (3) через $faucet
поподробнее по п1. как лукап поможет если в продажах нет этого продукта (нет продаж)? ))
yopp
Ник, вот скажи новичку - если мы грузим такими запросами, как выше (сложными) БД, то производительность её снижается - значительно? или не значительно?
представим пример, есть вот какая-то сложная операция, например О(n), сведение данных, агрегация и т.д. в 1 запросе.
представим, что такая же логика, но описана кодом, на таком же уровне реализации (максимально оптимизировано, минимальное количество вызовов и т.д.)
что эффективнее с точки зрения:
1. поддержки (о чём мы ранее общались, более сложные запросы сложнее поддерживать, изменять)
2. обработки (понятно, что если БД нагрузить, то она так же, как и нагруженное приложение будет долго обрабатывать данные)
3. потребления памяти (если приложение можно оптимизировать, то БД нет, кроме корневых конфигов)
получается, что в итоге, обработка более сложных вещей в коде даёт из плюсов только "умение делать более сложные вещи" и "проще поддерживать и изменять написанное, в сравнении с запросами к БД"
в твоей практике, как чаще бывает?
конечно, есть вариант ответа на мой вопрос - всё зависит от конкретной ситуации, приложения, запросов, количества коннектов, но если усреднить реализацию кодом и БД
Смысл базы данных в том чтобы грузить её по полной :)
«производительность» абстрактное понятие. Важно выбрать метрики влияющие на бизнес, а не на саму БД
Вне зависимости от того где вы будете обрабатывать данные, вы не можете избежать чтения всего массива.
Вопрос «где обрабатывать» сводится к совокупной стоимостью соблюдения «производительности». Т.е вариант «на бэкенде» может быть обоснован наличием подходящей экспертизы, а «считаем в монге» к стоимости эксплуатации кластера, когда дешевле нанять человека который будет писать огромные запросы, но при этом сокращать RTT запроса, без инвестиций в код.
yopp
поподробнее по п1. как лукап поможет если в продажах нет этого продукта (нет продаж)? ))
Так как источник выборки это продукты, то у вас всегда будет список всех продуктов, просто у тех продуктов у которых нет связанных продаж будут иметь «пустые» продажи
Alexander
Так как источник выборки это продукты, то у вас всегда будет список всех продуктов, просто у тех продуктов у которых нет связанных продаж будут иметь «пустые» продажи
агрегацию запускать на какую коллекцию? продукты? и из нее делать лукам в продажи? и потом считать? хм…. попробую
Alexandrr
 Иван
 Alexander
find().fetch()
Иван
find().fetch()
если у меня это все локально хранится (это пет проект), все равно нужен fetch()
?
Dmitry
 yopp
агрегацию запускать на какую коллекцию? продукты? и из нее делать лукам в продажи? и потом считать? хм…. попробую
Да, на продукты и потом оттуда лукапы
Иван
 Dmitry
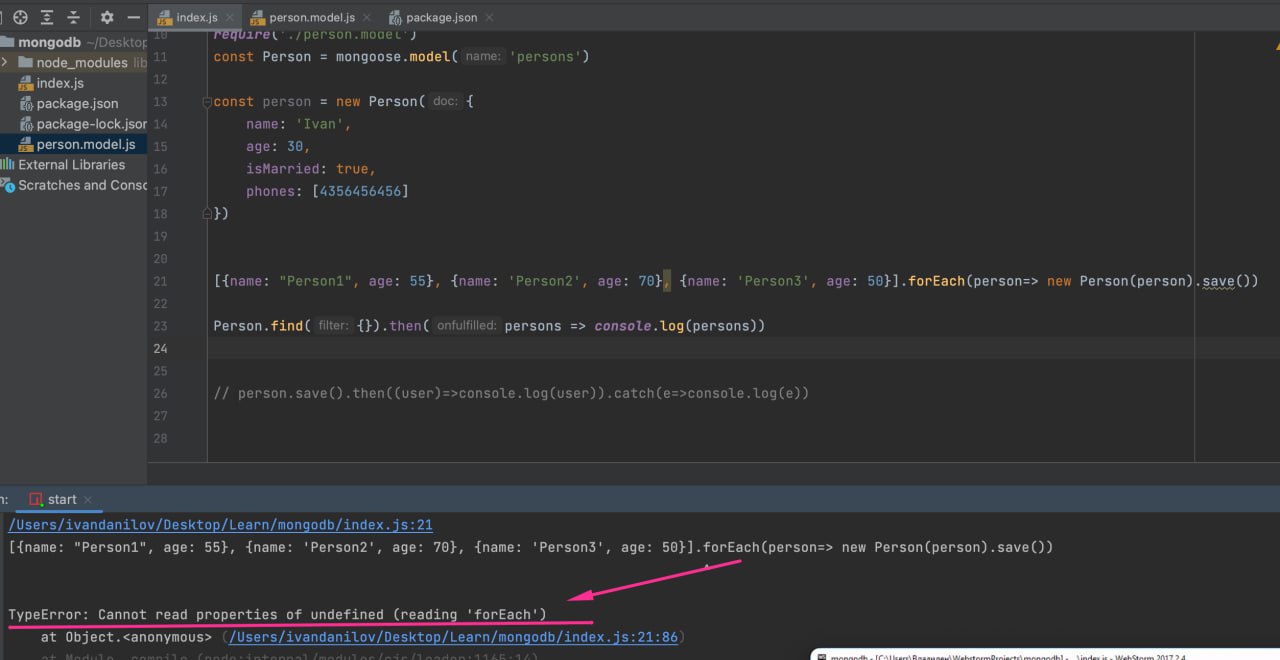
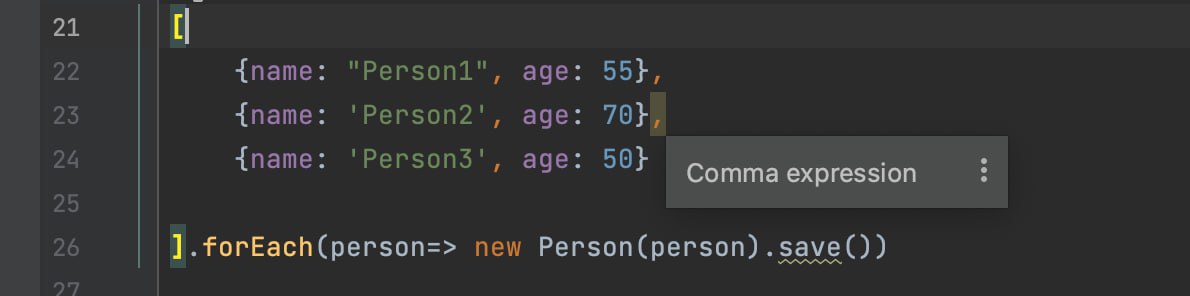
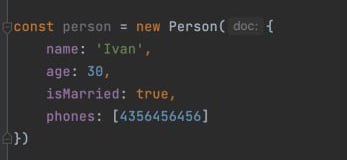
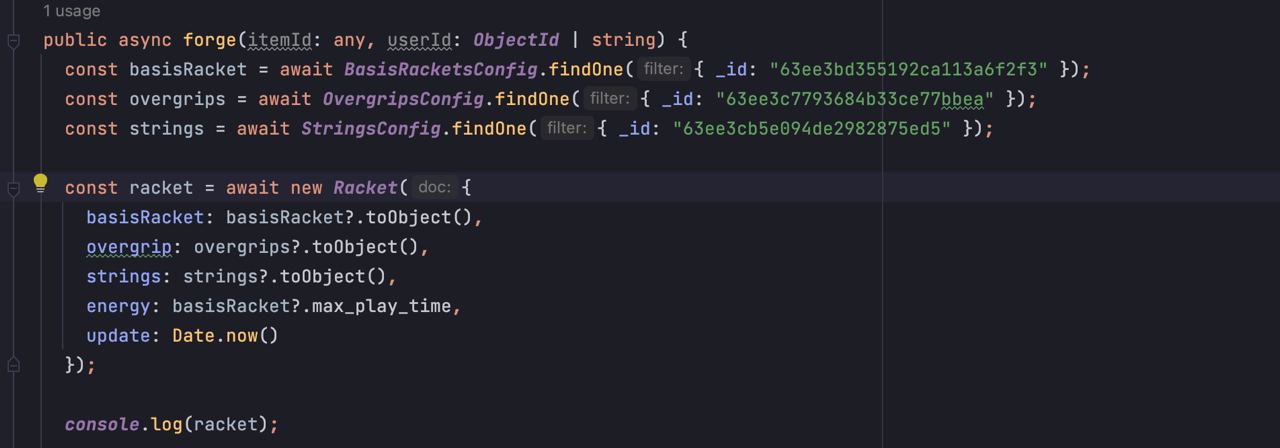
У тебя сейчас конструкция const person = new Person({...})[...].forEach(...)
 Egor
 Alexander
В Mongo есть ли возможность для хранения pipleline агрегации? Приходится конвретировать их в строки, чтобы в коллекцию запихнуть. В виде объектов - не дает из-за $…. (Монго 5.0 у меня)
 Yury
ребят, я совсем новый в монге, скажите, где лучше хостить БД - на том же хостинге, где и сам бек, или в MongoDB Atlas?
Дэн Миков PRM
Дэн Миков PRM
Привет!
Поломал репликацию: удалил secondary ноду, не тормознув на ней монго-сервер. Нужно ее назад добавить, но не получается - на мастере делаю rs.add({host:"hostname"}), и оно "висит" бесконечно , выхожу только через ctrl-C.
На секондари ноде в логах вот такое:
<стартую сервис systemctl start mongodb>
.....
"ctx":"initandlisten","msg":"Attempting to create internal replication collections"}
"ctx":"monitoring-keys-for-HMAC","msg":"Failed to refresh key cache","attr":{"error":"ReadConcernMajorityNotAvailableYet: Read concern majority reads are currently not possible.","nextWakeupMillis":200}}
"ctx":"initandlisten","msg":"Attempting to load local voted for document"}
"ctx":"initandlisten","msg":"Did not find local initialized voted for document at startup"}
"ctx":"initandlisten","msg":"Searching for local Rollback ID document"}
"ctx":"initandlisten","msg":"Initializing rollback ID","attr":{"rbid":1}}
"ctx":"initandlisten","msg":"Did not find local replica set configuration document at startup","attr":{"error":{"code":47,"codeName":"NoMatchingDocument","errmsg":"Did not find replica set configuration document in local.system.replset"}}}
"ctx":"initandlisten","msg":"Setting new configuration state","attr":{"newState":"ConfigUninitialized","oldState":"ConfigStartingUp"}}
"ctx":"monitoring-keys-for-HMAC","msg":"Failed to refresh key cache","attr":{"error":"NotYetInitialized: Cannot use non-local read concern until replica set is finished initializing.","nextWakeupMillis":400}}
в mongod.conf есть имя репликаСета (такое же как на мастере и на арбитре):
replication:
replSetName: "rs"
подскажите, как вернуть ноду в репликусет ?
Дэн Миков PRM
да
имхо, ну его нафик облака в наше время. от блокировок никто не застахован
хотя от локации зависит, конечно
Egor
ты или сам себе поднимаешь серв или пользуешься их серверами
Yury
имхо, ну его нафик облака в наше время. от блокировок никто не застахован
хотя от локации зависит, конечно
Согласен, но я лишь с той точки зрения, что я слабо шарю в администрировании, а там настроены backup и реплики
Дэн Миков PRM
ты или сам себе поднимаешь серв или пользуешься их серверами
тоесть можно этот Атлас поднять в своей корп сети ?
Egor
ну по идее да
Дэн Миков PRM
не знал 👍
Egor
ща погоди, могу врать
Egor
ну да, я не соврал, ты можешь у себя поднять монгу и вот тебе она
Дэн Миков PRM
я "тот еще " монговед ,мне их Атлас запомнился по этому : https://www.securitylab.ru/news/530550.php
Alexander
ребят, я совсем новый в монге, скажите, где лучше хостить БД - на том же хостинге, где и сам бек, или в MongoDB Atlas?
мы хостим там же где бэк, в отдельном контейнере. для наших нужд хватает )
Yury
мы хостим там же где бэк, в отдельном контейнере. для наших нужд хватает )
А как автобекап настраивали? Есть хорошая инструкция?
Yury
И репликацию
Alexander
Так как источник выборки это продукты, то у вас всегда будет список всех продуктов, просто у тех продуктов у которых нет связанных продаж будут иметь «пустые» продажи
не получается все-таки через lookup, пока запускаем выборку на всю базу продаж - все ок, но как только выбираем временной интервал, то упс. придется все-таки выносить в код и обрабатывать в ккоде
 Vadicus
Всем привет. Недавно начал изучать бекенд и по курсу подключение бд с монгодб. Оказывается компания в России не работает и я пишу узнать у сообщества как вы это обходите? Просто в двух словах напишите плиз в какую сторону думать.
Alexander
Всем привет. Недавно начал изучать бекенд и по курсу подключение бд с монгодб. Оказывается компания в России не работает и я пишу узнать у сообщества как вы это обходите? Просто в двух словах напишите плиз в какую сторону думать.
не работает, но пока проблем нет. были весной - сайт был недоступен без VPN, но сейчас все норм. но переходим на posgresql в дальнейшем.
Nick
подумайте насчёт восточной Европы
Vadicus
не работает, но пока проблем нет. были весной - сайт был недоступен без VPN, но сейчас все норм. но переходим на posgresql в дальнейшем.
У меня без впн в авторизацию не пускает. А с впн там при создании кластера надо указать айпи с которого будут идти запросы. Если указать текущий(а он с впн) то потом при попытке подключения из приложения он не узнает айпи. Я не знаю бекенд и думаю можно же как то не в атласе создать бд а у себя на хостинге? Так будет работать верно?
Alexander
У меня без впн в авторизацию не пускает. А с впн там при создании кластера надо указать айпи с которого будут идти запросы. Если указать текущий(а он с впн) то потом при попытке подключения из приложения он не узнает айпи. Я не знаю бекенд и думаю можно же как то не в атласе создать бд а у себя на хостинге? Так будет работать верно?
да, конечно, мы не исмользуем атлас и хостим сами
Vadicus
да, конечно, мы не исмользуем атлас и хостим сами
Понял, тогда просто досмотра курс, без практики и попробую на хосте создать бд. Спасибо, Александр.
Alexander
Понял, тогда просто досмотра курс, без практики и попробую на хосте создать бд. Спасибо, Александр.
запустить можно и на винде и на маке - даже хостинг не обязателен.
Vadicus
запустить можно и на винде и на маке - даже хостинг не обязателен.
О, отлично, погуглю это. Так даже удобнее для обучения.
Vadicus
Случайно нашел способ все таки работать с монгодб атлас. Вдруг кому пригодится - если не подключается к бд потому что ругается на айпи из впн то можно во вкладке Нетворк акцесс сбросить вписанный айпи и разрешить подключаться с любого айпи. Так все подключается и работает.
Может это очевидно для многих, но я с монго дБ знакомлюсь пару часов поэтому для потомков и таких как я оставляю это сообщение.
yopp
не получается все-таки через lookup, пока запускаем выборку на всю базу продаж - все ок, но как только выбираем временной интервал, то упс. придется все-таки выносить в код и обрабатывать в ккоде
А какие именно проблемы с временным интервалом? Вы можете в подзапросе внутри $lookup в коллекцию продаж указать временной диапазон
yopp
ребят, я совсем новый в монге, скажите, где лучше хостить БД - на том же хостинге, где и сам бек, или в MongoDB Atlas?
В атласе, это дешевле чем самостоятельно содержать монгу:)
Alexander
А какие именно проблемы с временным интервалом? Вы можете в подзапросе внутри $lookup в коллекцию продаж указать временной диапазон
а как в lookup’е задать условие? pipeline?
yopp
а как в lookup’е задать условие? pipeline?
Да
https://www.mongodb.com/docs/manual/reference/operator/aggregation/lookup/#join-conditions-and-subqueries-on-a-joined-collection
Yury
В атласе, это дешевле чем самостоятельно содержать монгу:)
У них минимальный тариф - 57 баксов в месяц, так ведь?
Yury
И это всего 10 гб хранилища
Alexandrr
У них минимальный тариф - 57 баксов в месяц, так ведь?
zomro hosting попробуй, но там деплоить самому придётся
yopp
У них минимальный тариф - 57 баксов в месяц, так ведь?
Да, это всё равно сильно дешевле чем если вы сами будете администрировать монгу. Там можно докупить больше дискового пространства, не уверен что на всех тарифах
Плюс у них еще есть serverless, там практически полностью pay as you go.
yopp
Посчитайте сколько стоит час времени человека который будет заниматься монгой, заложите часов 10 в месяц на её обслуживание. Сумма получится скорее всего больше чем атлас.
Но проблема в том, что чем больше данных, тем больше времени нужно на обслуживание. После 1тб уже будет совсем другой набор проблем и в целом в атласе всё равно будет дешевле :)
Я бы задумывался о self hosted решении, когда стоимость атласа становится дороже чем фуллтайм команда человек из 2-4, в зависимости от размера кластера
 Dima
А можете объяснить пожалуйста тоже новичку, обслуживание базы это что подразумевается?
Просто вот у меня есть сайт небольшой мне его делали 8 лет назад, там база данных на мскл я туда никогда не лазил даже, разработчики там бывают только если добавляем функционал.
Сейчас учу ноде жс и монгу, и не совсем понимаю что именно это за обслуживание? Безопасность или что то другое?
Alexandrr
А можете объяснить пожалуйста тоже новичку, обслуживание базы это что подразумевается?
Просто вот у меня есть сайт небольшой мне его делали 8 лет назад, там база данных на мскл я туда никогда не лазил даже, разработчики там бывают только если добавляем функционал.
Сейчас учу ноде жс и монгу, и не совсем понимаю что именно это за обслуживание? Безопасность или что то другое?
"разработчики там бывают только если добавляем функционал" - это оно
Dima
"разработчики там бывают только если добавляем функционал" - это оно
Понял, спасибо большое
Dima
У меня просто за 8 лет там база в районе 30 мб , читаю тут чаты у вас базы в терабайтах, думал из за масштабирования проблемы, но тут читаю что новичку предлагают юзать, задумался)
То есть если я сам целенаправленно хочу свою базу строить и обследовать мне пока не нужно это?
А то я только опыт на локале имею
Alexandrr
У меня просто за 8 лет там база в районе 30 мб , читаю тут чаты у вас базы в терабайтах, думал из за масштабирования проблемы, но тут читаю что новичку предлагают юзать, задумался)
То есть если я сам целенаправленно хочу свою базу строить и обследовать мне пока не нужно это?
А то я только опыт на локале имею
знания всегда нужны, если есть свободное время, чем больше тем лучше.
если проектировать с нуля базу, то нужно всё, в том числе знание какие когда запросы применяются.
а проблемы масштабирования - есть всегда, даже на базах в 30мб, пока они не разрослись.
да и если охота быстрее на сотню, другую ms отдать пользователю ответ, то тоже нужно
Yury
Yury
serverless
Yury
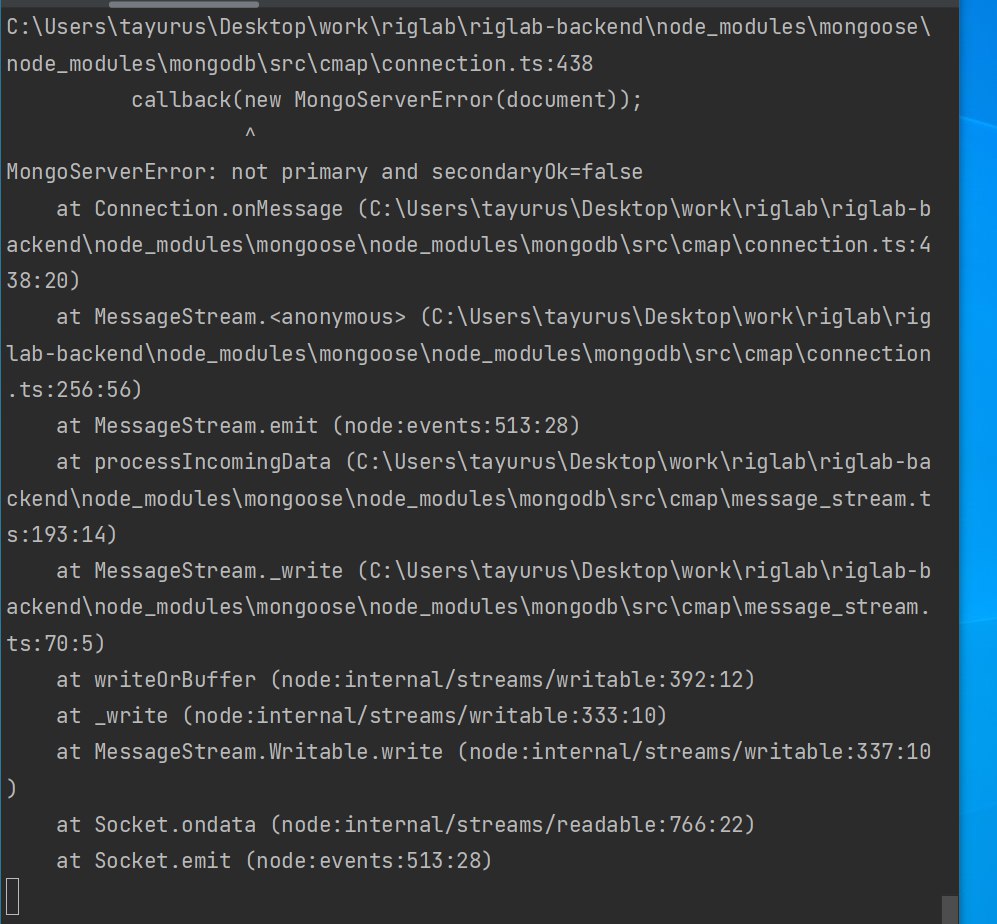
У меня БД с репликами, транзакциями, в этой serverless поддерживается такое, не знаете?
Yury
 Yury
 Yury
 Yury
