Здравствуйте, кто знает как можно искать одновременно по двум таблицам, которые между собой не связаны? (Например у меня есть таблица постов от двух разных типов пользователей, по таблице на каждый тип, и мне надо искать по допустим заголовку этих постов, но они по прежнему в отдельных таблицах)
2 запроса почему не устраивает?
 Отдельно Очумелые


 Dmytro
И чтобы это все ещё работало быстро
Dmytro
А не тянуло миллион объектов с базы
Dmitry
И потом merge
Dmytro
Угу, merge, надо ознакомиться
Отдельно Очумелые
У вас же на выходе список (массив) объектов, делайте аппенд в результатов и возвращайте этот список
fd
 Vladyslav
fd
принял
 Egor
ребят салют, а можно для популейта метода не указывать реф?
Egor
судя по всему раньше такая возможность была
Dmitry
То есть вы хотите сказать, что у вас 1 id ссылается сразу на несколько коллекций?
Egor
у меня айдишники в разных коллекция в рамках одной бд
 Nick
Здравствуйте, кто знает как можно искать одновременно по двум таблицам, которые между собой не связаны? (Например у меня есть таблица постов от двух разных типов пользователей, по таблице на каждый тип, и мне надо искать по допустим заголовку этих постов, но они по прежнему в отдельных таблицах)
Объединить выборки можно через unionWith а дальше уже логику докручивать
Hethal
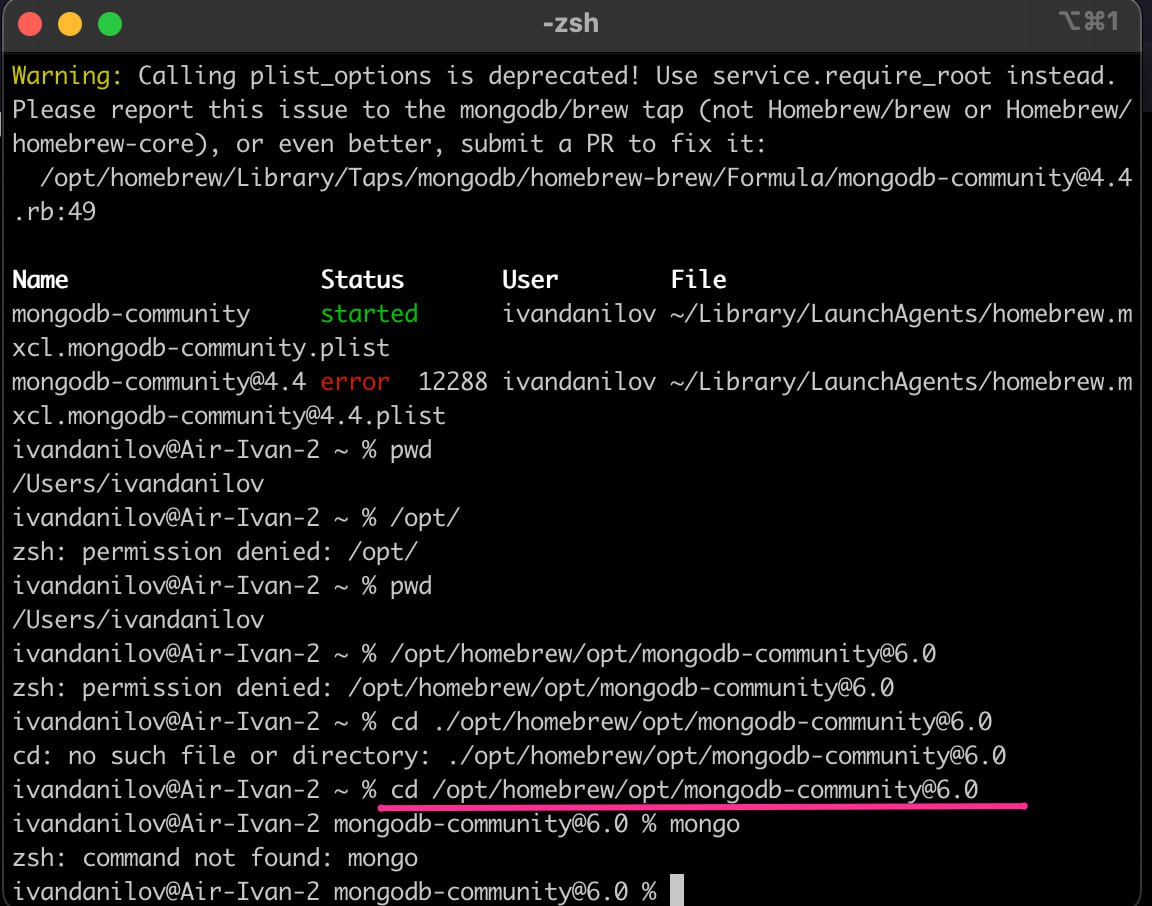
Ребят у кого мак на м1 помогите плиз установить монгодб
Hethal
А локально накатить никак?
Dmitry
А локально накатить никак?
Это рекомендация и не более того, чтобы систему не захламлять и быстро между версиями прыгать
C
В докере?
Да, за полностью локальный вариант я не знаю, даже не задумывался об этом при запуске. Мне опыта с локальным поднятием хватило и на винде
Hethal
Ок, спасибо большое. Буду разбираться
 Alexandrr
Да, за полностью локальный вариант я не знаю, даже не задумывался об этом при запуске. Мне опыта с локальным поднятием хватило и на винде
а что там?
найти исполняемый файл, нажать ввод - это сложно?
Dmitry
а что там?
найти исполняемый файл, нажать ввод - это сложно?
Бывают различные сбои и софт криво ложится
 yopp
А локально накатить никак?
Можно, есть официальныйпакет для homebrew
https://www.mongodb.com/docs/manual/tutorial/install-mongodb-on-os-x/
Hethal
Можно, есть официальныйпакет для homebrew
https://www.mongodb.com/docs/manual/tutorial/install-mongodb-on-os-x/
Он у меня никак не ставился
Alexandrr
Бывают различные сбои и софт криво ложится
на стандартную винду, 7-10-11 обычный установочник с офф сайта ложится как родной, какие сбои?
 Alexander
 Alexandrr
Alexander
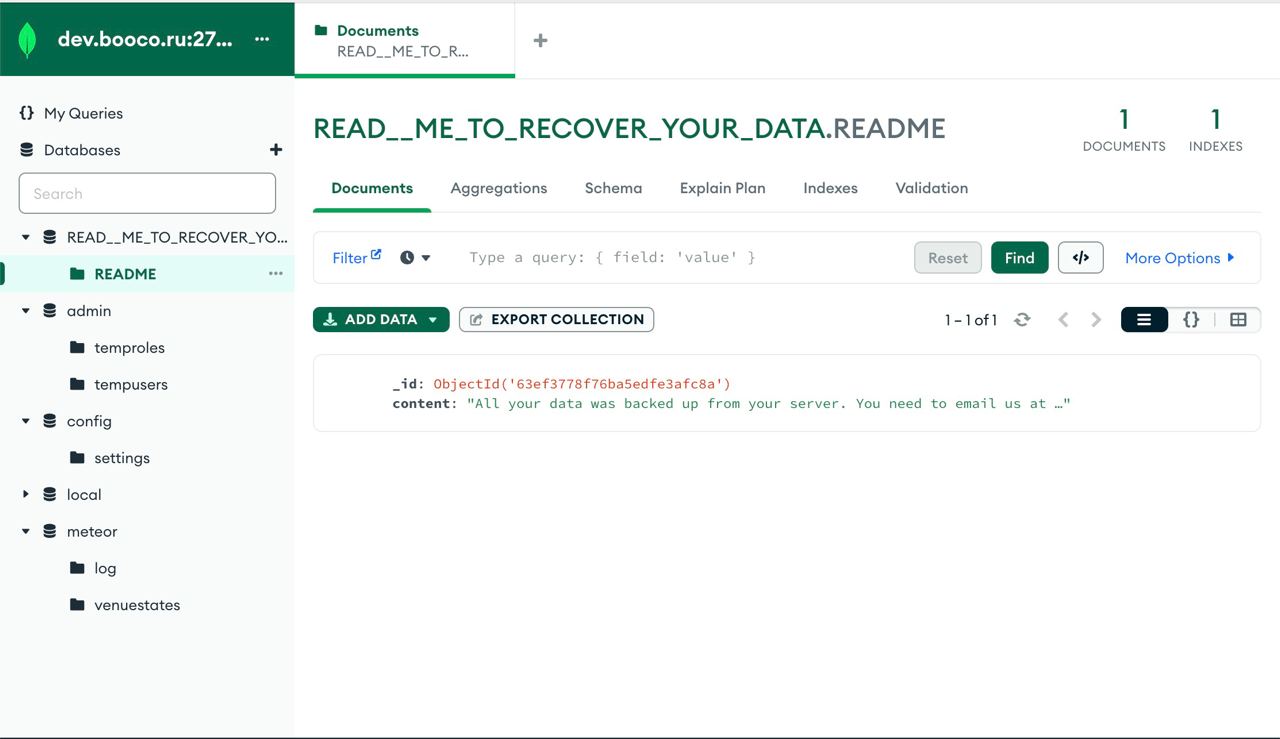
тут логи не нужны, просто пароль был слит каким-то образом
все проще! пароль поставили, а авторизацию в mongod.conf не включили…
Alexandrr
😂
 Dima
Dima
Аналогично и сайты бьют софтом и наверняка там ридми с ссылкой на отправку биткоинов
Dmitry
на стандартную винду, 7-10-11 обычный установочник с офф сайта ложится как родной, какие сбои?
Кто-то не обновлялся, у кого-то обновления криво вставили, настройки в системе менялись, вирус был подхвачен, конфликт с другой программой и т.д.
Dmitry
Нет же идеальных условий и у каждого человека по сути свой уникальный образ
Alexander
Это софт, автоматически такое делается
да, это понятно, что автоматически. у нас обычно все в docker’е, наружун порт не открыт, парль стоит, и сейчас проверил - там авторизация по умочланию включена. тут на деве потрубовалось дать доступ вовне и вот )))
Alexander
я немного удивлен, что по умолчанию mongo не включает авторизацию
Alexander
во всех скриптах - везде все настроено правильно. а тут особый случай вручную включали и забыли ))))
Alexandrr
я немного удивлен, что по умолчанию mongo не включает авторизацию
если бы у меня на проде упала база из-за такого, сразу бы уволил того, кто причастен к "настройке"
Alexander
если бы у меня на проде упала база из-за такого, сразу бы уволил того, кто причастен к "настройке"
я согласен, но это не прод. такие истории - хороший повод еще раз везде все проверить и реузльтаты проверик меня радуют )
D
если бы у меня на проде упала база из-за такого, сразу бы уволил того, кто причастен к "настройке"
Я знаю одного дурачка, который открыл базу на внешнем хосте, без пароля и никому не сказал, чтобы можно было к ней коннектиться через JetBrains ))
Alexandrr
Я знаю одного дурачка, который открыл базу на внешнем хосте, без пароля и никому не сказал, чтобы можно было к ней коннектиться через JetBrains ))
может и не дурачок, просто хотел проект положить и всё
поднасрать кабанычу так сказать
D
может и не дурачок, просто хотел проект положить и всё
поднасрать кабанычу так сказать
я этот вариант допускаю
Alexandrr
я этот вариант допускаю
как-то был у меня в конторе лид-псих, он за мердж реквесты с неиспользовавшимися импортами удалял доступ к репе у такого персонажа, хороший метод воспитания, хочу заметить.
хоть я и не рекомендовал такие меры, но работало как часы😅
пару раз руками перекладывать пойдёшь строки кода, потратишь пару дней, потом больше так не делал ни кто😅
Иван
 No
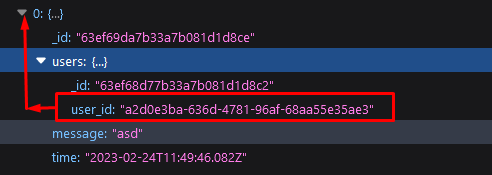
Когда юзаешь populate можно ли сделать чтобы он не был вне обьекта
No
 Nick
Отдельно Очумелые
Alexander
как-то был у меня в конторе лид-псих, он за мердж реквесты с неиспользовавшимися импортами удалял доступ к репе у такого персонажа, хороший метод воспитания, хочу заметить.
хоть я и не рекомендовал такие меры, но работало как часы😅
пару раз руками перекладывать пойдёшь строки кода, потратишь пару дней, потом больше так не делал ни кто😅
А не проще было lint настроить и проверять автоматически?
Alexandrr
А не проще было lint настроить и проверять автоматически?
я не кодер, а управленец, мне на это с прибором😅
 1
Всем привет, ищу специалиста по MongoDB, чтобы помог разобраться в ошибке, за помощь заплачу
lmn
В новой версии называется mongosh. Хз как для макоси ставится и может отдельно надо поставить
ставил отдельно через brew
 Yury
 Yury
 Yury
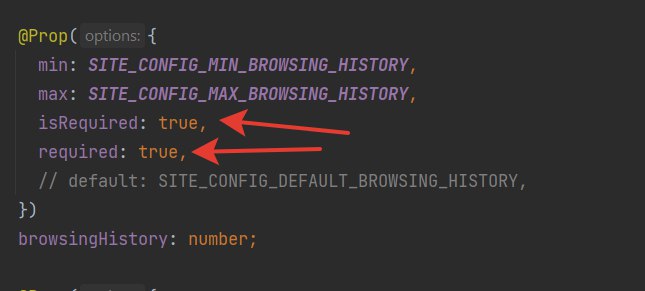
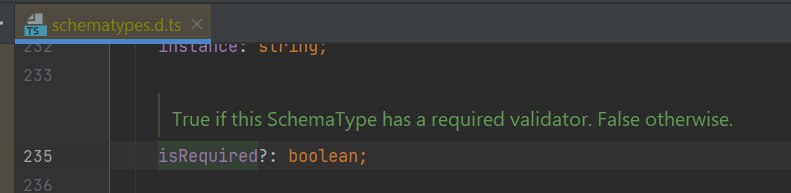
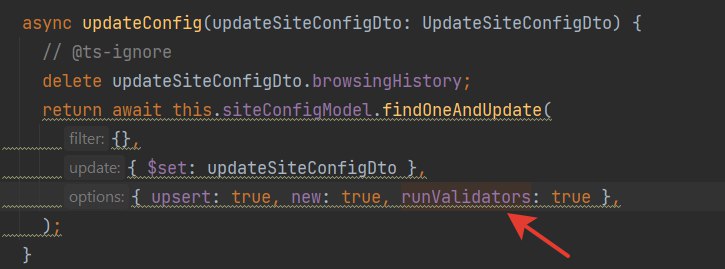
И еще вопрос - я поставил полю required - mongoose перестал давать создавать документ без данного поля, а обновлять дает. Как запретить обновлять без required поля?
Yury
 Nick
Yury
Alexander
Как строить отчеты при помощи aggregate? Вот такой вымышленный кейс: есть коллекция продукты - в ней название и кол-во и коллекция продажи. Хочу построить отчет по продажам. В простом варианте aggregate запросто решает задачу. Но есть три момента, которые все портят: (1) мы хотим включить в отчет продукты по которым не было продаж, (2) мы хотим посчитать долю продукта от общего объема продаж и (3) хотим посчитать долю по штукам относительно общего кол-ва, которое считается по коллекции продукты. Как это можно сделать?
Nick
Как строить отчеты при помощи aggregate? Вот такой вымышленный кейс: есть коллекция продукты - в ней название и кол-во и коллекция продажи. Хочу построить отчет по продажам. В простом варианте aggregate запросто решает задачу. Но есть три момента, которые все портят: (1) мы хотим включить в отчет продукты по которым не было продаж, (2) мы хотим посчитать долю продукта от общего объема продаж и (3) хотим посчитать долю по штукам относительно общего кол-ва, которое считается по коллекции продукты. Как это можно сделать?
Все это можно закрыть в коде. Верните достаточно данных из агрегации и в путь. Либо используйте $facet, но сводить всеравно придется в коде
Nick
Первым стейджем фасет с расчетами отдельными по продуктам и общие цифры. Следующим стейджем сведение результатов отдлельных фасетных выборок, то что итак будет делаться в коде
Alexandrr
Первым стейджем фасет с расчетами отдельными по продуктам и общие цифры. Следующим стейджем сведение результатов отдлельных фасетных выборок, то что итак будет делаться в коде
Ник, вот скажи новичку - если мы грузим такими запросами, как выше (сложными) БД, то производительность её снижается - значительно? или не значительно?
представим пример, есть вот какая-то сложная операция, например О(n), сведение данных, агрегация и т.д. в 1 запросе.
представим, что такая же логика, но описана кодом, на таком же уровне реализации (максимально оптимизировано, минимальное количество вызовов и т.д.)
что эффективнее с точки зрения:
1. поддержки (о чём мы ранее общались, более сложные запросы сложнее поддерживать, изменять)
2. обработки (понятно, что если БД нагрузить, то она так же, как и нагруженное приложение будет долго обрабатывать данные)
3. потребления памяти (если приложение можно оптимизировать, то БД нет, кроме корневых конфигов)
получается, что в итоге, обработка более сложных вещей в коде даёт из плюсов только "умение делать более сложные вещи" и "проще поддерживать и изменять написанное, в сравнении с запросами к БД"
в твоей практике, как чаще бывает?
конечно, есть вариант ответа на мой вопрос - всё зависит от конкретной ситуации, приложения, запросов, количества коннектов, но если усреднить реализацию кодом и БД
Assanoff
В документе определенный набор полей. Имеет ли значение всегда один и тот же порядок полей в разных документах, например с точки зрения производиельности?
Alexander
Все это можно закрыть в коде. Верните достаточно данных из агрегации и в путь. Либо используйте $facet, но сводить всеравно придется в коде
спасибо, в принципе так и думал. задача стоит более широко - сделать очтеты универсальными, чтобы не нужно было каждый отчет в коде делать (их у нас много). поэтому пока пришел к решению разбить на несколкьо агрегаций и получается что мы запускаем цепочку агрегаций, передавая результаты одной в другую по установленным правилам. думаю как сделать это унирвесальным и не очень сложным одновременно)
Nick
Ник, вот скажи новичку - если мы грузим такими запросами, как выше (сложными) БД, то производительность её снижается - значительно? или не значительно?
представим пример, есть вот какая-то сложная операция, например О(n), сведение данных, агрегация и т.д. в 1 запросе.
представим, что такая же логика, но описана кодом, на таком же уровне реализации (максимально оптимизировано, минимальное количество вызовов и т.д.)
что эффективнее с точки зрения:
1. поддержки (о чём мы ранее общались, более сложные запросы сложнее поддерживать, изменять)
2. обработки (понятно, что если БД нагрузить, то она так же, как и нагруженное приложение будет долго обрабатывать данные)
3. потребления памяти (если приложение можно оптимизировать, то БД нет, кроме корневых конфигов)
получается, что в итоге, обработка более сложных вещей в коде даёт из плюсов только "умение делать более сложные вещи" и "проще поддерживать и изменять написанное, в сравнении с запросами к БД"
в твоей практике, как чаще бывает?
конечно, есть вариант ответа на мой вопрос - всё зависит от конкретной ситуации, приложения, запросов, количества коннектов, но если усреднить реализацию кодом и БД
СУБД это всеголишь абстракция над самими данными и возможность выполнить логику над ними максимально близко к ним. Удобство написания запросов, языковая выразительность (как зависит размер текста запроса от сложности), ограничения связанные со способом хранения (документы, строки, колонки и т.п.), наличие сырцов или оперативной поддержки и т.д. все влияет на тот самый выбор инструмента, т.е. СУБД, под задачи.
Так что если ваши хотелки в виде запросов делаются сложнее чем вам кажется должны были бы делаться, или запросы сильно дольше выполняются чем в других бд, то это лишь изза не профильного использования. И в таких случаях нормально и в коде реализовать необходимый функционал.
По пунктам эффективности:
1. поддержка - увы но зависит от спецов и их уровня, если возможна ситуация с попаданием на проект человека со слабыми скилами, то монстрозапросы станут неприкасаемы, а функционал связанный с ними невозможно будет развивать без привлечения спецов или перепесывания
2. 3. как выше сказал СУБД позволяет работать максимально близко к данным достаточно эффективно, так что при возможности всегда надо гонять запросы в СУБД. Сам факт вычитки данных и передачи в код может не укладываться во временные и другие лимиты на выполнение запроса. Там где лимитов нет (например ежедневные отчеты) то это не имеет значения и хорошо уносится код.
Nick
Ник, вот скажи новичку - если мы грузим такими запросами, как выше (сложными) БД, то производительность её снижается - значительно? или не значительно?
представим пример, есть вот какая-то сложная операция, например О(n), сведение данных, агрегация и т.д. в 1 запросе.
представим, что такая же логика, но описана кодом, на таком же уровне реализации (максимально оптимизировано, минимальное количество вызовов и т.д.)
что эффективнее с точки зрения:
1. поддержки (о чём мы ранее общались, более сложные запросы сложнее поддерживать, изменять)
2. обработки (понятно, что если БД нагрузить, то она так же, как и нагруженное приложение будет долго обрабатывать данные)
3. потребления памяти (если приложение можно оптимизировать, то БД нет, кроме корневых конфигов)
получается, что в итоге, обработка более сложных вещей в коде даёт из плюсов только "умение делать более сложные вещи" и "проще поддерживать и изменять написанное, в сравнении с запросами к БД"
в твоей практике, как чаще бывает?
конечно, есть вариант ответа на мой вопрос - всё зависит от конкретной ситуации, приложения, запросов, количества коннектов, но если усреднить реализацию кодом и БД
по производительности - если для выполнения задачи вам надо перечитывать данные и жрать много проца - вы от этого никуда не денетесь. И как ни странно это легко определяется на стадии постановки задачи, достаточно представлять как бы вы такое сделали в коде сами и сколько бы вам чего потребовалось - в субд как правило будет лучше ввиду оптимизаций ну и в целом банальной траты человекочасов на доводку, которых у вас одного никогда не будет.
А медленнее от наплыва запросов станет, когда ресурсы закончатся - проц, диск, сеть, потоки, коннекты, порты, дексрипторы, ентропия и т.п.
Alexander
понял, благодарю, да, тоже думал об IO проблемах
IO - это реально может быть большой проблемой. Сервера в Яндекс облаке вешаются очень легко именно на IO. ))
Nick
Ник, вот скажи новичку - если мы грузим такими запросами, как выше (сложными) БД, то производительность её снижается - значительно? или не значительно?
представим пример, есть вот какая-то сложная операция, например О(n), сведение данных, агрегация и т.д. в 1 запросе.
представим, что такая же логика, но описана кодом, на таком же уровне реализации (максимально оптимизировано, минимальное количество вызовов и т.д.)
что эффективнее с точки зрения:
1. поддержки (о чём мы ранее общались, более сложные запросы сложнее поддерживать, изменять)
2. обработки (понятно, что если БД нагрузить, то она так же, как и нагруженное приложение будет долго обрабатывать данные)
3. потребления памяти (если приложение можно оптимизировать, то БД нет, кроме корневых конфигов)
получается, что в итоге, обработка более сложных вещей в коде даёт из плюсов только "умение делать более сложные вещи" и "проще поддерживать и изменять написанное, в сравнении с запросами к БД"
в твоей практике, как чаще бывает?
конечно, есть вариант ответа на мой вопрос - всё зависит от конкретной ситуации, приложения, запросов, количества коннектов, но если усреднить реализацию кодом и БД
в моей практике было достаточно дешево выкидывать неоптимальные структуры и переналивать данные в нормальном виде или вообще уехать на другую БД. Но были и времена когда железо в наличии не было в состоянии переварить запросы определенного вида на вставке ввиду слабоватых дисков и все уносилось в код где строилась хитрая буферизация - по факту спец решение чтобы перелопать десяток ТБ из кафки не за месяц а в пределах недели
Alexandrr
IO - это реально может быть большой проблемой. Сервера в Яндекс облаке вешаются очень легко именно на IO. ))
но это уже относится к OS оптимизациям, в любом случае, что в приложении, что в СУБД с этим будут проблемы
Alexandrr
в моей практике было достаточно дешево выкидывать неоптимальные структуры и переналивать данные в нормальном виде или вообще уехать на другую БД. Но были и времена когда железо в наличии не было в состоянии переварить запросы определенного вида на вставке ввиду слабоватых дисков и все уносилось в код где строилась хитрая буферизация - по факту спец решение чтобы перелопать десяток ТБ из кафки не за месяц а в пределах недели
понял, надо вырабатывать схему действий при определённых ситуациях вообщем, одного гвоздя нет для всех проблем, как и всегда.
спасибо за потраченное время объяснений🤝