С lean сколько занимает?
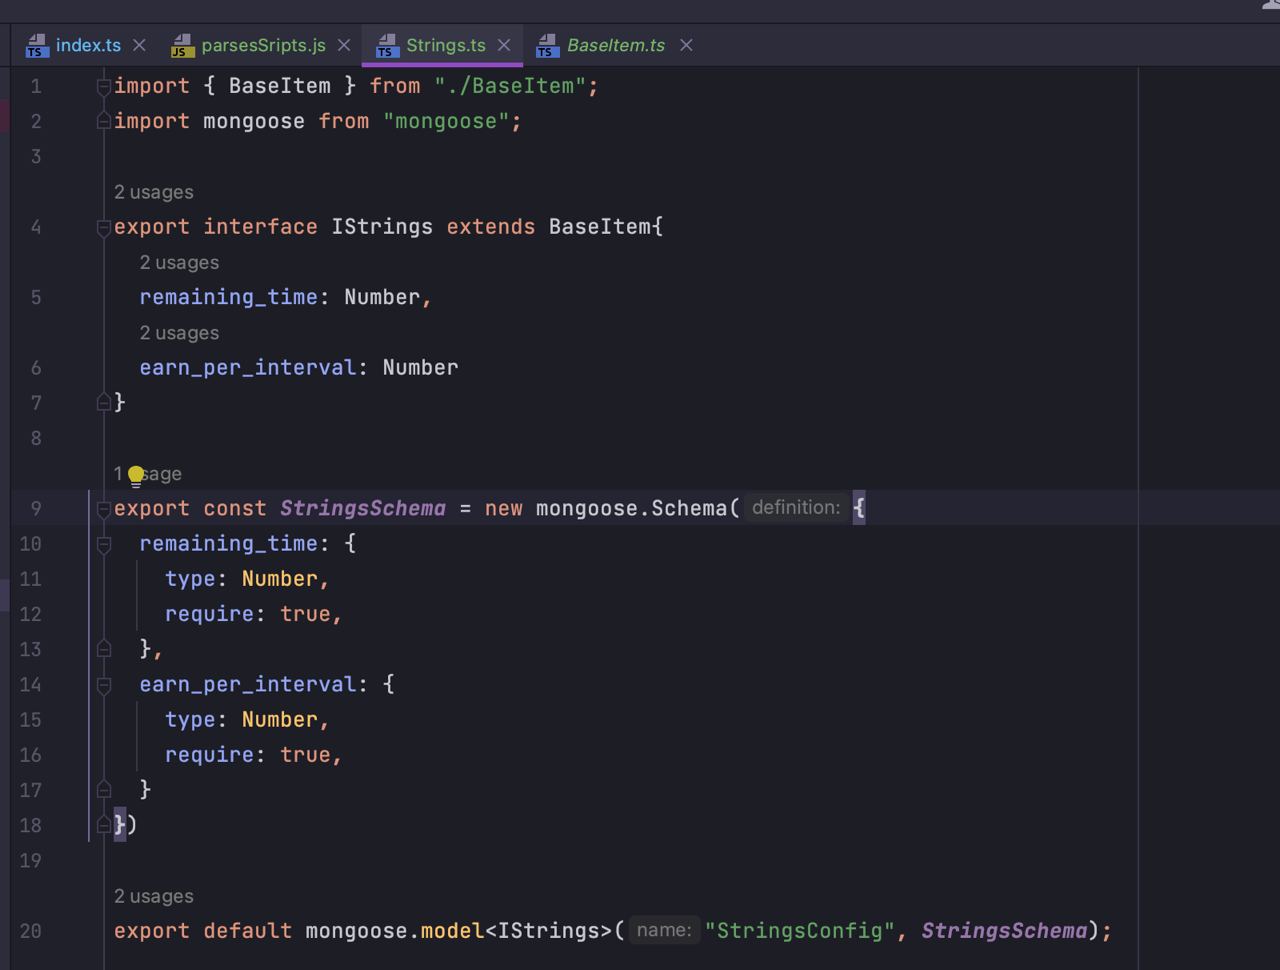
Это mongoose функция и в самом drive mongo её нет
 Dmitry


 Egor
 Egor
Dmitry
https://mongoosejs.com/docs/discriminators.html
 Inc
 Андрей
Так обновите свои тулзы, видимо драйвера кривые там стоят
в том то и дело, что на другой бд с версией 6.0.3 эта тулза работает прекрасно
 Nick
в том то и дело, что на другой бд с версией 6.0.3 эта тулза работает прекрасно
запросы откуда медленно выполняются?
Андрей
запросы откуда медленно выполняются?
с консоли моментально, с вьюх типа dbgate, compas сек по 50
Nick
с консоли моментально, с вьюх типа dbgate, compas сек по 50
про первое не слышал, а компас какой версии?
Андрей
про первое не слышал, а компас какой версии?
appName: 'MongoDB Compass',
clientMetadata: {
driver: { name: 'nodejs', version: '4.13.0' },
Андрей
про первое не слышал, а компас какой версии?
ну он не у меня стоит а у тестировщика, говорит последняя версия
Nick
Nick
appName: 'MongoDB Compass',
clientMetadata: {
driver: { name: 'nodejs', version: '4.13.0' },
тогда следующий вопрос про объем возвращаемых данных, большая выборка делается?
Андрей
всего в коллекции
Андрей
а в другой БД структура доков такая же?
структура приблизительно такая же, но и записей там по 50 тыс
Андрей
сейчас разверну ещё стенд, перенесу данные с проблемного кластера, посмотрим
Андрей
в тестовом стенде, аналогичная ситуация, я всё-таки склоняюсь к варианту, что что-то не так с данными.
Nick
всего в коллекции
из предположений, что в софте какието проблемы с визуализацией. Похорошему надо бы логи там както включить дебажные, но не нашел как это в компасе сделать
Андрей
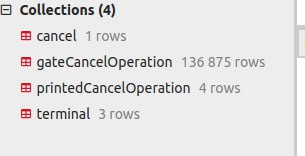 Андрей
это я сдернул дамп с бд на которой нет проблем
Андрей
тогда пойду к разрабам, может удастся что из логов приложухи вытянуть, всем спасибо!!!
Nick
тогда пойду к разрабам, может удастся что из логов приложухи вытянуть, всем спасибо!!!
проверил в последней версии компаса (1.35) в логах есть информация о выполненных командах и времени выполнения. Можете посмотреть
 Никита
Всем привет!
Ищу помощи с Котлином/монго или джавой/монго, кто разбирается в вопросе.
Если вкратце, то не получается обновить поля в коллекции данных, содержащих сложные структуры данных, сейчас для обновления полей записи каждый раз выполняю метод replaceOne, которая вызывает проблемы при многопоточной работе с одной и той же коллекцией. Хочу найти способ заменить в документе только конкретные поля и сделать commit.
Также есть пара вопросов про использование монги именно в спрингбут проектах, например, если конфигурация монги не является бобом, а сам проект спринг бутовский, могут ли из-за этого быть рассинхроны при многопоточном доступе к данным?
Пишу на котлине спрингбут проект с ДБ монго, спасибо за обратную связь!
 yopp
Всем привет!
Ищу помощи с Котлином/монго или джавой/монго, кто разбирается в вопросе.
Если вкратце, то не получается обновить поля в коллекции данных, содержащих сложные структуры данных, сейчас для обновления полей записи каждый раз выполняю метод replaceOne, которая вызывает проблемы при многопоточной работе с одной и той же коллекцией. Хочу найти способ заменить в документе только конкретные поля и сделать commit.
Также есть пара вопросов про использование монги именно в спрингбут проектах, например, если конфигурация монги не является бобом, а сам проект спринг бутовский, могут ли из-за этого быть рассинхроны при многопоточном доступе к данным?
Пишу на котлине спрингбут проект с ДБ монго, спасибо за обратную связь!
replaceOne заменяет полностью документ, скорее всего вам нужен updateOne плюс атомарные операции или транзакции
https://www.mongodb.com/docs/manual/core/write-operations-atomicity/
Никита
 Vladyslav
Всем привет!
Ищу помощи с Котлином/монго или джавой/монго, кто разбирается в вопросе.
Если вкратце, то не получается обновить поля в коллекции данных, содержащих сложные структуры данных, сейчас для обновления полей записи каждый раз выполняю метод replaceOne, которая вызывает проблемы при многопоточной работе с одной и той же коллекцией. Хочу найти способ заменить в документе только конкретные поля и сделать commit.
Также есть пара вопросов про использование монги именно в спрингбут проектах, например, если конфигурация монги не является бобом, а сам проект спринг бутовский, могут ли из-за этого быть рассинхроны при многопоточном доступе к данным?
Пишу на котлине спрингбут проект с ДБ монго, спасибо за обратную связь!
по replaceOne - можете заменить:
создаете лист updateOneModel. дальше пушите туда обьекты с обновлениями(через Update + Set)
потом bulkwriteasync(list)
Никита
по replaceOne - можете заменить:
создаете лист updateOneModel. дальше пушите туда обьекты с обновлениями(через Update + Set)
потом bulkwriteasync(list)
понял, у меня сейчас используется синхронный драйвер монги в проекте, перепишу конфигурацию тогда и попробую такой способ
 Alexandrr
replaceOne заменяет полностью документ, скорее всего вам нужен updateOne плюс атомарные операции или транзакции
https://www.mongodb.com/docs/manual/core/write-operations-atomicity/
@ByteCrusher
ещё важно помнить о: https://pymongo.readthedocs.io/en/stable/faq.html#multiprocessing
пример для питона, но относится к любым драйверам.
так как скорее всего реализация одинаковая.
 Taras Kosyi (ง•̀o•́)ง
Привет! А можно ли оптимизировать facet c count? На форумах пишут о проблеме с производительностью - я тоже столкнулся с этим. Но очень нуждаюсь в таких кверях для пагинации..
Alexandrr
Привет! А можно ли оптимизировать facet c count? На форумах пишут о проблеме с производительностью - я тоже столкнулся с этим. Но очень нуждаюсь в таких кверях для пагинации..
а в чём проблема использовать skip() & limit()?
Taras Kosyi (ง•̀o•́)ง
а в чём проблема использовать skip() & limit()?
нужно знать количество все равно
Alexandrr
для статистки, допустим
эмм, зачем велосипед?
https://www.mongodb.com/docs/manual/reference/method/db.collection.countDocuments/
Taras Kosyi (ง•̀o•́)ง
эмм, зачем велосипед?
https://www.mongodb.com/docs/manual/reference/method/db.collection.countDocuments/
Проблема заключается в том, что это все должно быть в агрегации
Я понимаю, конечно же, что есть возможность получить все используя разные квери
Но в моем случае, кусочек кодане разрешает это делать через разные квери
Alexandrr
Проблема заключается в том, что это все должно быть в агрегации
Я понимаю, конечно же, что есть возможность получить все используя разные квери
Но в моем случае, кусочек кодане разрешает это делать через разные квери
https://stackoverflow.com/questions/20348093/mongodb-aggregation-how-to-get-total-records-count
Taras Kosyi (ง•̀o•́)ง
https://stackoverflow.com/questions/20348093/mongodb-aggregation-how-to-get-total-records-count
Вопрос был не в том, как
А можно ли оптимизировать
Facet + count = кверя выполняется в 10 раз дольше
Alexandrr
Вопрос был не в том, как
А можно ли оптимизировать
Facet + count = кверя выполняется в 10 раз дольше
если решение существует только 1, значит очевидно - нет.
к тому же условие - в 1 запросе
Nick
Вопрос был не в том, как
А можно ли оптимизировать
Facet + count = кверя выполняется в 10 раз дольше
сколько в count возвращается?
 Dmytro
Коллеги, как посоветуете лучше искать регуляркой имя пользователя, если оно лежит в двух полях (имя и фамилия), а надо чтобы строка "Иван Иванов" находила необходимого пользователя
Nick
Dmytro
Не особо понимаю как одной строкой искать по двум полям
Dmytro
То есть как те два поля динамически превратить в одно?
Dmytro
Или есть какой другой элегантный способ
Dmytro
Ибо имя не обязательно состоит из одного слова, и простым разделением по пробелу не обойтись
Nick
Ибо имя не обязательно состоит из одного слова, и простым разделением по пробелу не обойтись
в поиске как вводить будут?
Dmytro
Как я и написал выше, одной строкой будут вводить
Nick
тогда попробуйте текстовый индекс и поиск через $text
Dmytro
Спасибо, ознакомлюсь
Abdulaziz
 Nick
Abdulaziz
 Abdulaziz
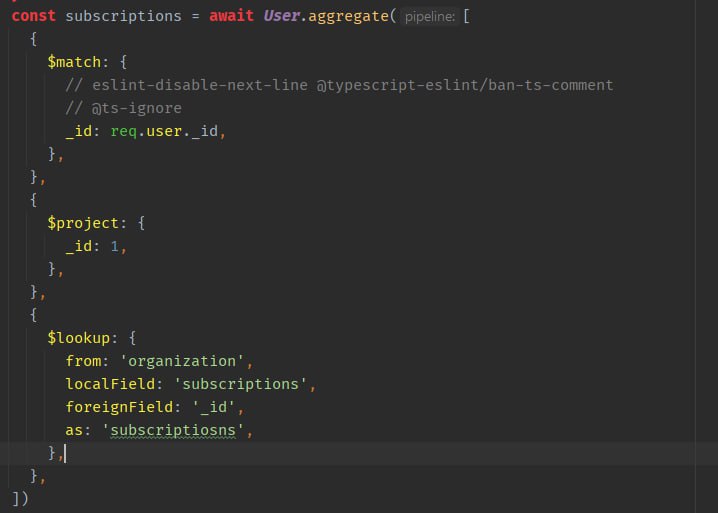
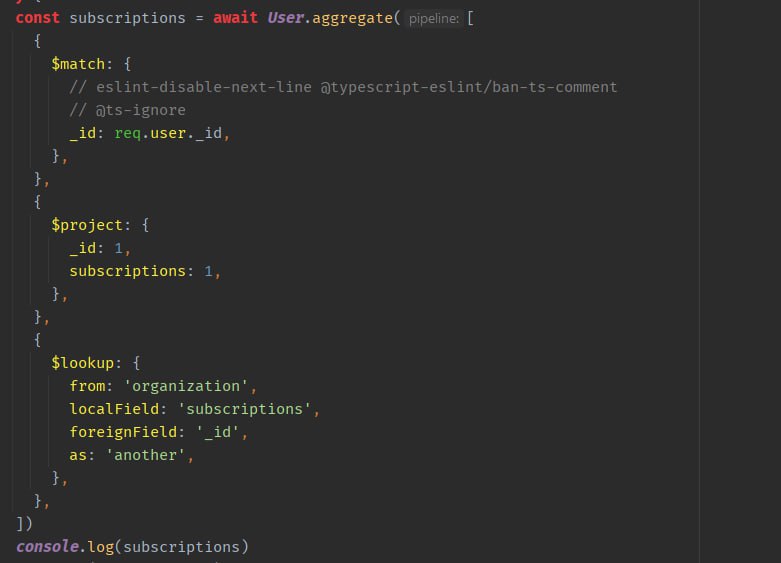
Придумал один способ но не знаю насколько он оптимальный, сначала взять сам массив, а потом через $in взять данные с другой модели
Nick
вот походу с массивом есть тонкости
Nick
Придумал один способ но не знаю насколько он оптимальный, сначала взять сам массив, а потом через $in взять данные с другой модели
все корректно, массив развернется, $in не нужно городить https://www.mongodb.com/docs/manual/reference/operator/aggregation/lookup/#use--lookup-with-an-array
Abdulaziz
вот походу с массивом есть тонкости
 Abdulaziz
Nick
проверьте название колелкции organization точно ли она в базе без s на конце
Nick
вообще тут проще использовать populate() метод у монгуса, если вы всегда тянете только по одному юзеру инфу
Alexandrr
все корректно, массив развернется, $in не нужно городить https://www.mongodb.com/docs/manual/reference/operator/aggregation/lookup/#use--lookup-with-an-array
вопрос с промежуточными вычислениями, сегодня писал логику работы апишного метода.
там использую синхронно последовательно 6 запросов к БД с промежуточными расчётами.
естественно, логика запросов базируется на результатах промежуточных расчётах.
такие задачи в рамках "1 запроса" с каким-нить pipeline не решаются, как я понимаю?
Abdulaziz
проверьте название колелкции organization точно ли она в базе без s на конце
ахах, там было без s, решил, спасибо еще раз))
Abdulaziz
А как монго дает названия коллекция, добавляет s к названиям моделей?
Abdulaziz
Просто я нигде не писал вместе с s
Nick
А как монго дает названия коллекция, добавляет s к названиям моделей?
это монгус дает, испольузется множественное число от названия модели на англицком, как правило это просто добавление s
Abdulaziz
Alexandrr
не очень понял суть вопроса
у ребят в пайплайне смотрю в проектах используется логика - собрать, сортировать, фильтровать, обновить или добавить новый.
но вычисления СУБД не делает, как я понимаю, значит, на уровне её это не решается.
просто по 6 запросов гонять, сложно.
хочется оптимизировать, но пока не пойму как, разве, что логику промежуточных вычислений изменить
Nick
вопрос с промежуточными вычислениями, сегодня писал логику работы апишного метода.
там использую синхронно последовательно 6 запросов к БД с промежуточными расчётами.
естественно, логика запросов базируется на результатах промежуточных расчётах.
такие задачи в рамках "1 запроса" с каким-нить pipeline не решаются, как я понимаю?
если это про "можно ли все уместить в пайплайн" - если не нужны доп данных, которых нет в базе и не требуется супер логики на всяких циклах, то как правило можно. Но это большие запросы и не всегда их можно быстро написать
Alexandrr
если это про "можно ли все уместить в пайплайн" - если не нужны доп данных, которых нет в базе и не требуется супер логики на всяких циклах, то как правило можно. Но это большие запросы и не всегда их можно быстро написать
доп. данные как раз появляются в результате "промежуточных вычислений"
Alexandrr
ну тогда вопрос отпадает сам собой.
благодарю🤝
Nick
в агрегатах сейчас достаточно средств чтобы повычислять, простая математика вся есть, условия есть, аккумуляторы для мапредьюся массивов есть, группировки с применением этой логики есть
Nick
доп. данные как раз появляются в результате "промежуточных вычислений"
ну промежуточные вычисления точно так же можно поулчить на первой стадии при использовании того же $facet, а дальше уже накрутить чтото безумное над полученными массивами
Nick
только может поулчиться так, что вы бизнес логику унесете в запрос, а запрос получится сильно сложный для понимания и при необходимости доработки или исправления проще будет его либо заново переписать либо выкинуть и сделать опять 6 простызхапросов
Alexandrr
только может поулчиться так, что вы бизнес логику унесете в запрос, а запрос получится сильно сложный для понимания и при необходимости доработки или исправления проще будет его либо заново переписать либо выкинуть и сделать опять 6 простызхапросов
да, да, я как раз о поддерживаемости, расширяемости.
краеугольный камень, как говорится.
ускорение получится, как мне кажется, небольшим, а вот всё остальное пострадает сильнее
Nick
увы да, если sql народ с опытом читает в целом хорошо даже сложные конструкции, то для монго языка деградация понимания очень сильная от лишних конструкций
Отдельно Очумелые
Всем привет!
Дурацкий вопрос, но задам. Как одним запросом зацепить сабквери, что б из вторая колекция подцепилась, опираясь на данные из первой. Было бы все круто если бы $lookup.from умела в переменные. Может есть какой грязный хак?) Не хочется делать 2 запроса в одно и тоже место. Спасибо.