 Maksim


Всем привет
Подскажите у кого есть опыт
Есть 3 базы монги , размером по 500 гиг
Проксмокс
На его основе что оптимальнее поднять
3 VPS
1 vps
3 lxc контецнера
Во всех случаях для каждой базы будет свой отдельный раздел на диске
 Egor
есть вот бейс айтем
export interface BaseItem {
type: _ItemType;
code: String,
model: String,
title: String,
}
и есть струны
export interface IStrings extends BaseItem{
remaining_time: Number,
earn_per_interval: Number
}
я хотел бы использовать так же и с монго моделью
 yopp
Всем привет
Подскажите у кого есть опыт
Есть 3 базы монги , размером по 500 гиг
Проксмокс
На его основе что оптимальнее поднять
3 VPS
1 vps
3 lxc контецнера
Во всех случаях для каждой базы будет свой отдельный раздел на диске
Зависит от того каких ресурсов вам не хватает. Если больше не хватает пропускной способности диска, то на одной виртуальной машине с тремя разделами может быть оптимальнее. Если высокая загрузка CPU с низким iowait, то три виртуальные машины, предпочтительно на разных физических серверах будет более эффективно
Maksim
Зависит от того каких ресурсов вам не хватает. Если больше не хватает пропускной способности диска, то на одной виртуальной машине с тремя разделами может быть оптимальнее. Если высокая загрузка CPU с низким iowait, то три виртуальные машины, предпочтительно на разных физических серверах будет более эффективно
RAM узкое место, нужно память использовать максимально эфективно
yopp
В этом случае лучше три виртуалки
yopp
Прямо с lxc нет, в основном докер. Но в целом разницы между нативным и контейнеризированным деплоем нет, но нужно обратить внимание на то, сколько памяти доступно контейнеру и сколько видит монга.
Кстати, если узкое место это объём памяти и индексов не очень много, то можно попробовать использовать сжатие zstd, вместо стандартного snappy. Если данные будут лучше сжиматься, то в дисковом кеше будет больше данных
 Назар
Всем привет. Как посчитать колличество документов, с уникальным полем и фильтром? Вот такая запись не работает model.distinct('fieldName').countDocument({fieldName: {$in: arr}}). Пишут что вообще distinct с большими обьемами данных не работает.
 Inc
Привет, честно попытался найти в гугле какую-то инфу по поводу стоит ли разбивать большую коллекцию на партиции (меньшие коллекции например по дате), но не нашел ничего внятного, может кто подскажет где можно почитать про это или есть опыт из собственной практики?
 Bohdan
Привет, честно попытался найти в гугле какую-то инфу по поводу стоит ли разбивать большую коллекцию на партиции (меньшие коллекции например по дате), но не нашел ничего внятного, может кто подскажет где можно почитать про это или есть опыт из собственной практики?
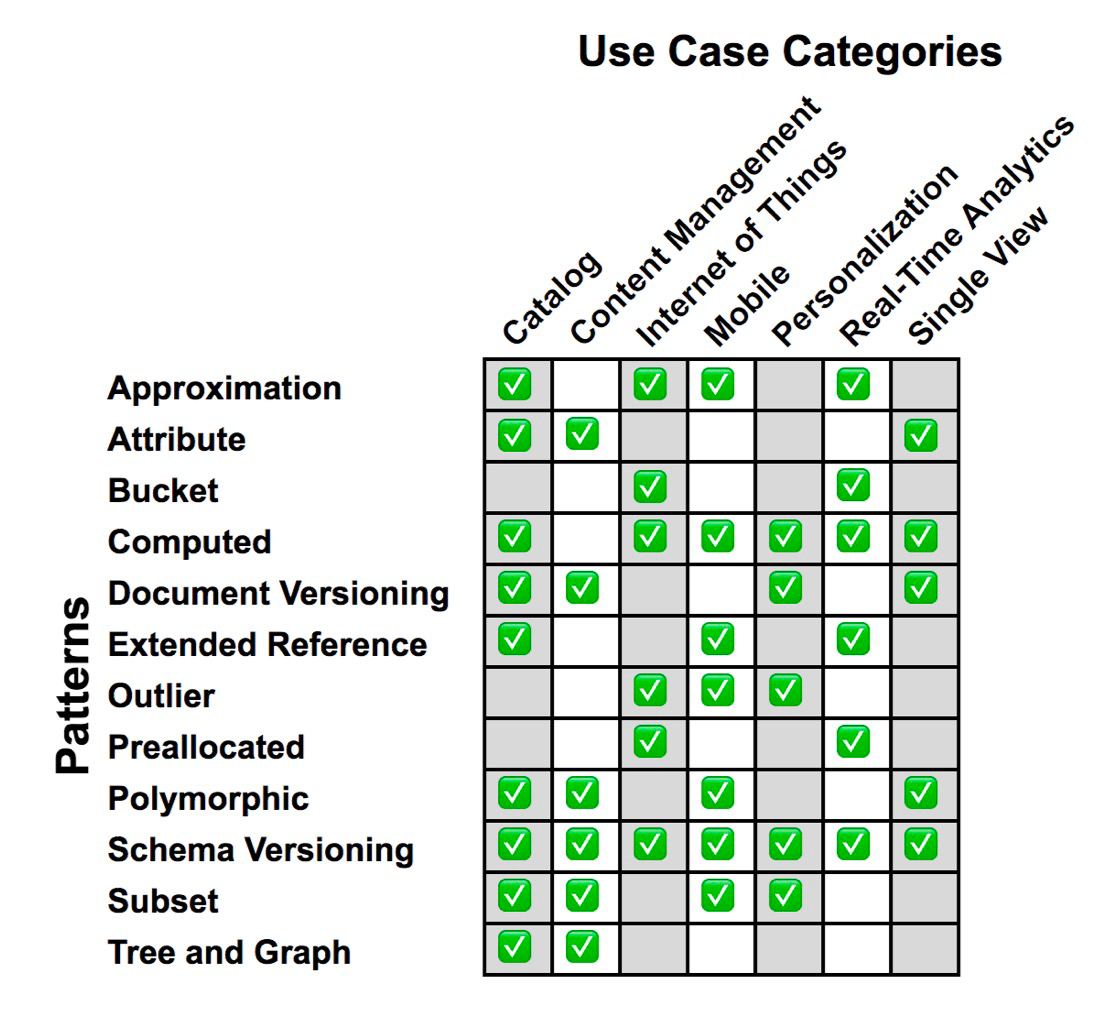
В монго есть статьи по паттернам, где четко описано что и когда разбивать
 Alexandrr
Всем привет
Подскажите у кого есть опыт
Есть 3 базы монги , размером по 500 гиг
Проксмокс
На его основе что оптимальнее поднять
3 VPS
1 vps
3 lxc контецнера
Во всех случаях для каждой базы будет свой отдельный раздел на диске
присоединяюсь к ответу выше - 3 разных тачки покроют большинство проблем в обозримом будущем
 Vladyslav
 "
 "
 "
 yopp
Привет, честно попытался найти в гугле какую-то инфу по поводу стоит ли разбивать большую коллекцию на партиции (меньшие коллекции например по дате), но не нашел ничего внятного, может кто подскажет где можно почитать про это или есть опыт из собственной практики?
Разбивать на отдельные коллекции одинаковые по структуре документы не самая эффективная стратегия, так как она не решает проблем которые такой разбивкой пытаются решить. Если хочется начинать увеличивать ресурсы, то более эффективно использовать шардинг и зонировать документы
 Artem
товарищи, а что считается "лучше" : делать выборку через файнд, или через агрегацию.
обоими способами задачу можно решить, но какой правильнее, и хотяб кратко почему ?)
спасибо
 Dmitry
товарищи, а что считается "лучше" : делать выборку через файнд, или через агрегацию.
обоими способами задачу можно решить, но какой правильнее, и хотяб кратко почему ?)
спасибо
find если ничего сложного
aggregate для более сложной логики
Artem
в плане перебора больших коллекций разницы нету ?
Artem
и вообще, от каких размеров коллекции можно начинать задумываться об вот таких оптимизациях ? это чисто для общего развития)
Dmitry
в плане перебора больших коллекций разницы нету ?
Разница есть т.к. в aggregation порядок задаешь сам, а в find порядок определяется самой функцией. Как ранее уже сказал в aggregation можно реализовать более сложную логику.
Dmitry
и вообще, от каких размеров коллекции можно начинать задумываться об вот таких оптимизациях ? это чисто для общего развития)
Какой именно оптимизации?
Скорость выполнения запроса зависит от множества факторов
Artem
оптимизация имел в виду, по подкапотной логике монги мб различия в алгоритмах какие-то
Artem
а вообще есть стойкое ощущение, что файнд это просо оболочка удобная надо агрегация + мэтч, нет ?
Dmitry
Dmitry
Они могут разные результаты выдавать т.к. как ранее говорил, у aggregate порядок сам задаешь
 Mike
Такой вопрос:
Если после подобной реализации:
await bulk.insert( {...databaseAnsCollection[0]} )
await bulk.execute();
await upgradeDbCollection.createIndex({_currency: 1});
вылетает следующая ошибка:
throw new error_1.MongoInvalidArgumentError(Document is larger than the maximum size ${this.s.maxBsonObjectSize});
^
MongoInvalidArgumentError: Document is larger than the maximum size 16777216
at UnorderedBulkOperation.addToOperationsList (E:\Progi3\Trading-tester-vanilla-node\node_modules\mongodb\lib\bulk\unordered.js:29:19)
at UnorderedBulkOperation.insert (E:\Progi3\Trading-tester-vanilla-node\node_modules\mongodb\lib\bulk\common.js:725:21)
at setDatabasesAndCollections (E:\Progi3\Trading-tester-vanilla-node\HistoryDataParsers\databasesAndCollectionsUpgrade.js:54:14)
at runMicrotasks (<anonymous>)
at processTicksAndRejections (node:internal/process/task_queues:96:5) {
[Symbol(errorLabels)]: Set(0) {}
А необходимо иметь именно такого формата и размера документ - какие есть варианты?
Mike
как это реализовать?
Alexandrr
но лучше пересматривать структуру документов и коллекции, так как гридфс намного медленнее работает
 Андрей
Всем привет! Обновился на 6.0.3, после обновления БД стала тупить, т.е долго запросы выполняются. Локально с консоли всё как обычно, но с campass либо gatedb, запрос на вывод 100 строк коллекции занимает больше 10 сек. Куда смотреть, в ресурсы не упираюсь, утилизация процессора и памяти в норме. БД маленькая, 4 коллекции по 200 строк.
 Shane
Покажи запрос
Андрей
167 строк
Андрей
в старой версии менее чем за сек выполнялся
Андрей
просто другой проект, тоже на монге, после обновления такой проблемы не возникло
Shane
find().lean()
Shane
После метода find
Shane
Я же написал
Shane
Через что делаешь запросы?
Shane
Да
Андрей
Error evaluating expression: db.dayReportChunk.find(...).lean is not a function
Андрей
[direct: primary] reports> db.dayReportChunk.find().lean()
TypeError: db.dayReportChunk.find().lean is not a function
Андрей
думаю разницы нет, до сих пор выполняется
Андрей
43 сек
Андрей
с консоли мгновенно
Shane
А откуда не мгновенно? Не могу понять
Shane
На беке?
Андрей
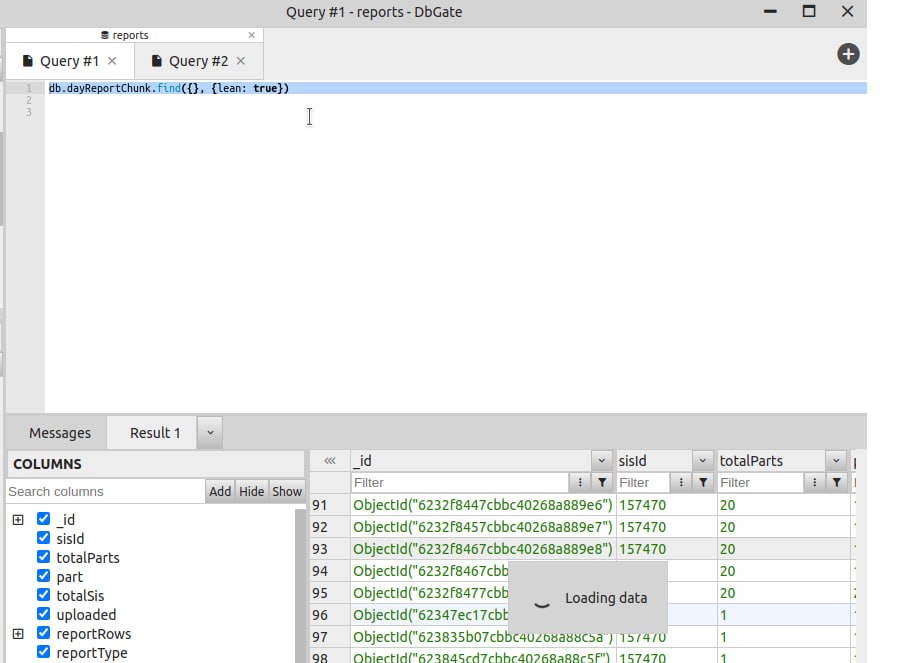
с DbGate
Андрей
 Shane
Не использовал
Shane
Он напрямую запросы делает или прокси?
Shane
Явно проблема в этом
Андрей
ну тут что-то из магии
Shane
Другая бд где стоит?
Shane
Атлас?
Андрей
если делать откат на старую версию, всё норм
Андрей
Спасибо! Буду ещё с версиями играться, задействую ещё тестовую среду.
Alexandrr
на 3.6.22 🙈
уже стопийсят тысяч раз все поменялось с этой версии.
проблемы могут быть с чем угодно.
нужно разбираться.
начать с what's news, версии 6.0.2.
потом к запросам идти.
потом к способам подключения и другим второстепенным проблемам
 Nick
Всем привет! Обновился на 6.0.3, после обновления БД стала тупить, т.е долго запросы выполняются. Локально с консоли всё как обычно, но с campass либо gatedb, запрос на вывод 100 строк коллекции занимает больше 10 сек. Куда смотреть, в ресурсы не упираюсь, утилизация процессора и памяти в норме. БД маленькая, 4 коллекции по 200 строк.
Так обновите свои тулзы, видимо драйвера кривые там стоят