 Alexandrr


https://pypi.org/project/ssh-python/
мне ещё и гуглить за тебя?
 Ksh
Господа, есть вопрос с переносом данных с одного кластера на другой.
Имеем шардинг кластер с репликацией, всего 3 шарды.
Задача сдампить часть данных (за один день) кластер большой по размеру по этому сдампить все невыйдет.
Данные нормально дампятся через mongoexport. Получаю валидные json и все красиво.
Но при попытке импортировать в другой кластер получаю такую ошибку.
Failed: zeroparallel.lead_log: error restoring from zeroparallel/lead_log.bson: bulk write exception: write errors: [no progress was made executing batch write op in zeroparallel.lead_log after 5 rounds (0 ops completed in 6 rounds total)
Это при попытке дописать данные в уже существующую колекцию, если импортить в новую то все проходит без ошибок.
Export и import делаю на mongos.
Есть идеи что я делаю не так?
 Nick
 Alexander
 Eva🇺🇦
$facet с $count внутри выполняется дольше в 3 раза, чем две разные агрегации из агрегации facet
этому есть какое-то объяснение? на форумах очень мало информации
в доке не упоминается такое
 Александр
 Александр
 Yury
Александр
 Александр
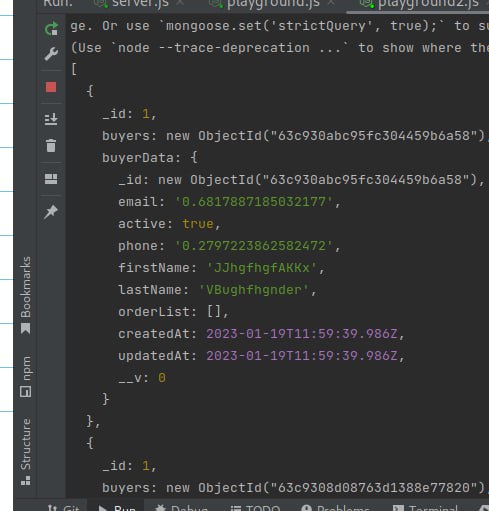
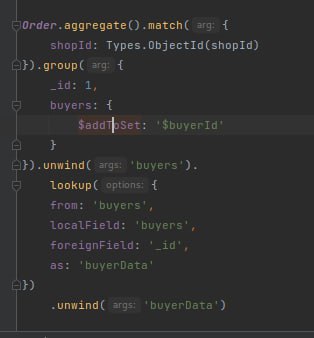
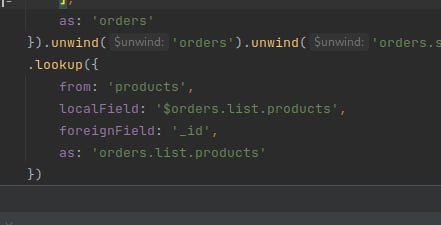
Привет, попробуй оператор агрегации project
Вставь после unwind
.project({_id: 0, buyerData: 1})
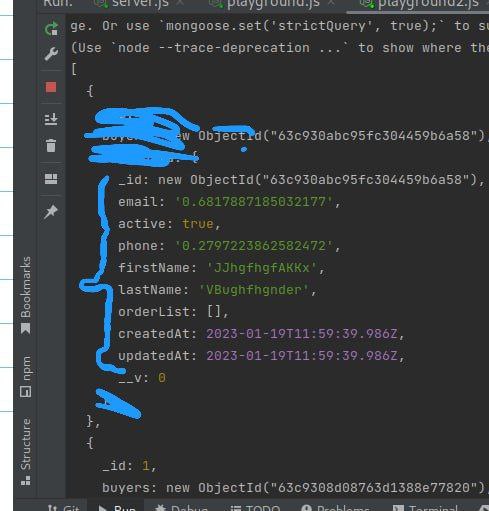
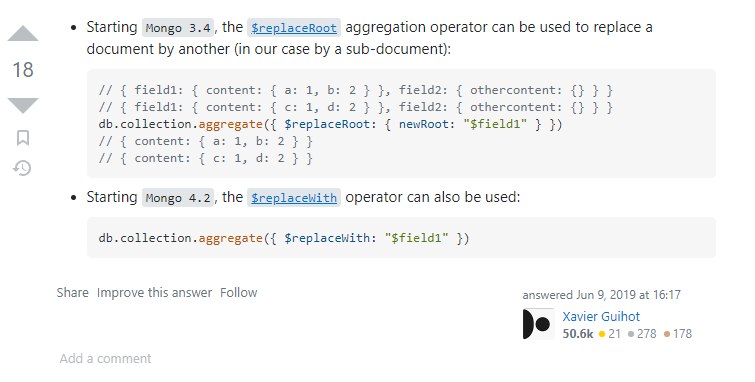
Что в таком случае делать? Это оставляет вложенность buyerData
Yury
Что в таком случае делать? Это оставляет вложенность buyerData
Нужно сам ключ buyerData убрать, оставив только содержимое?
Александр
Верно
Yury
Что в таком случае делать? Это оставляет вложенность buyerData
Попробуй после project написать еще
replaceWith('$buyerData')
Yury
Что в таком случае делать? Это оставляет вложенность buyerData
 Александр
 C
О!!! Благодарю, сегодня с коллегами не могу решить проблему эту весь день
=> Senior back-end, NodeJS software engineer
Это же пранк, да? 😂
D
=> Senior back-end, NodeJS software engineer
Это же пранк, да? 😂
Нормальный 19-летний сеньёр, снйчас все такие.
 flyingshine
Dmitrii
Нормальный 19-летний сеньёр, снйчас все такие.
я не сеньёр, но хочу понимать в сколько лет им становятся?
 𝔏𝔢𝔯𝔬𝔶
я не сеньёр, но хочу понимать в сколько лет им становятся?
возраст не показатель, а знания и коммерческий опыт
Dmitrii
возраст не показатель, а знания и коммерческий опыт
реплай был к меседжу где акцент на возрасте
D
реплай был к меседжу где акцент на возрасте
В юном возрасте, нельзя иметь достаточно опыта, чтобы называться сеньёром, кодеры же не идут на работу в 10 лет. Тебя же не смутит, если я скажу, что в 20 лет не реально иметь внуков? Так и здесь.
Dmitrii
В юном возрасте, нельзя иметь достаточно опыта, чтобы называться сеньёром, кодеры же не идут на работу в 10 лет. Тебя же не смутит, если я скажу, что в 20 лет не реально иметь внуков? Так и здесь.
не цепляюсь к 19 годам
но разве за 4 года что-то мешает стать сеньёром?
начать в 19, в 23 быть сеньёром
D
не цепляюсь к 19 годам
но разве за 4 года что-то мешает стать сеньёром?
начать в 19, в 23 быть сеньёром
Я бы поставил рамку в 10 лет опыта.
Dmitrii
а архитектор?
Dmitrii
разве не нужно быть хорошим программистом что бы стать архитектором?
D
разве не нужно быть хорошим программистом что бы стать архитектором?
нужно, но требтся еще отдельно навыки прокктирования.
lmn
не цепляюсь к 19 годам
но разве за 4 года что-то мешает стать сеньёром?
начать в 19, в 23 быть сеньёром
Реально начать в 19 и в 23 иметь сколиоз и межпозвоночные грыжи
Dmitrii
Реально начать в 19 и в 23 иметь сколиоз и межпозвоночные грыжи
с такими диагнозами можно подумать что кто-то в 19 начал кирпичи центнерами носить
 Eva
не цепляюсь к 19 годам
но разве за 4 года что-то мешает стать сеньёром?
начать в 19, в 23 быть сеньёром
Интересно, а можно начать в 50 и в 54 быть сеньором ))
Alexandrr
Интересно, а можно начать в 50 и в 54 быть сеньором ))
смотря с чего, с абсолютного нуля или с новой области/нового языка
Eva
С абсолютного нуля. Из другой профессии.
Eva
Как из 19 лет )
Eva
Редко в 19 бэкграунд есть.
Alexandrr
С абсолютного нуля. Из другой профессии.
зависит от привычек.
если инженерные привычки, усидчивость есть, то да, вполне реально, за свою карьеру были 4 человека таких в подчинённых
Alexander
Всем привет! Есть некоторый папйлайн по большой коллекции, делаю сортиовку по некоторому полю с датой, потом $limit: 100, потом идет некоторое кол-во lookup’ов, unwind’ов и group/ungrop. В резудльтате сортировка нарушается и приходится делать еще раз. Так все работает. Меня смщуает, что сортировать приходится дважды или это нормально?
Yury
 Yury
 Yury
 Yury
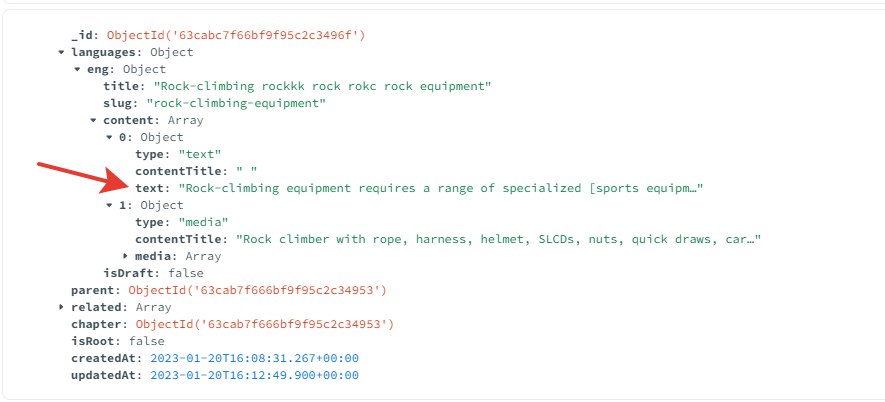
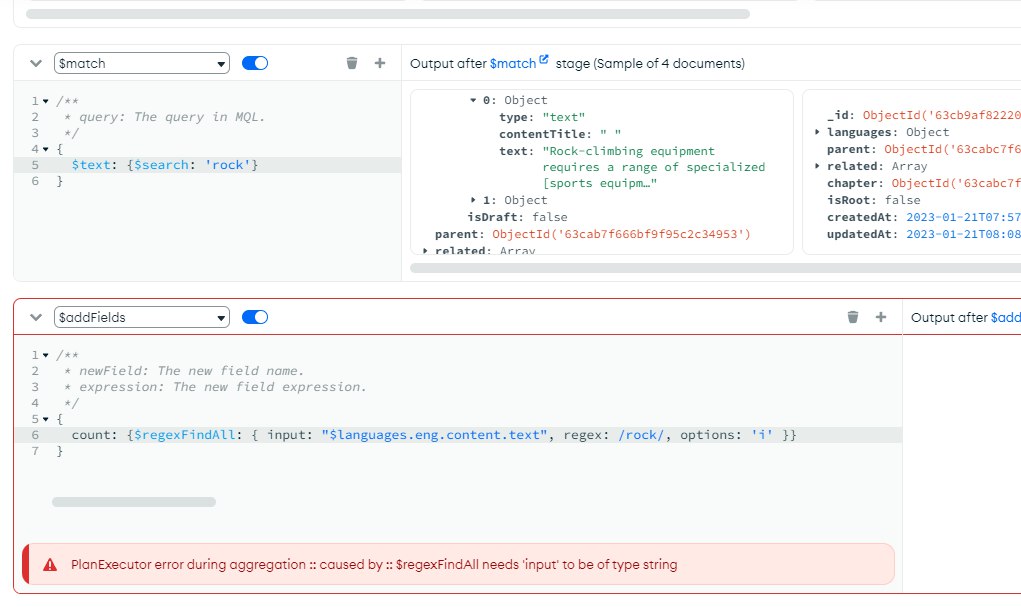
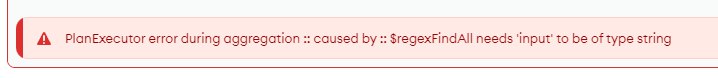
regexFindAll в массивы не умеет?
Alexandrr
regexFindAll в массивы не умеет?
1. нужно открыть документацию, там описан хорошо синтаксис, тут: https://www.mongodb.com/docs/manual/reference/operator/query/regex/
и тут: https://www.mongodb.com/docs/v4.2/reference/operator/query/regex/
2. для полнотекстового поиска лучше использовать индекс, регулярки очень медленные и не удобные
Yury
В сторону регулярок посмотрел, потому что нужно, кроме результата поиска, еще иметь количество вхождений поисковой строки в каждый документ
Alexandrr
В сторону регулярок посмотрел, потому что нужно, кроме результата поиска, еще иметь количество вхождений поисковой строки в каждый документ
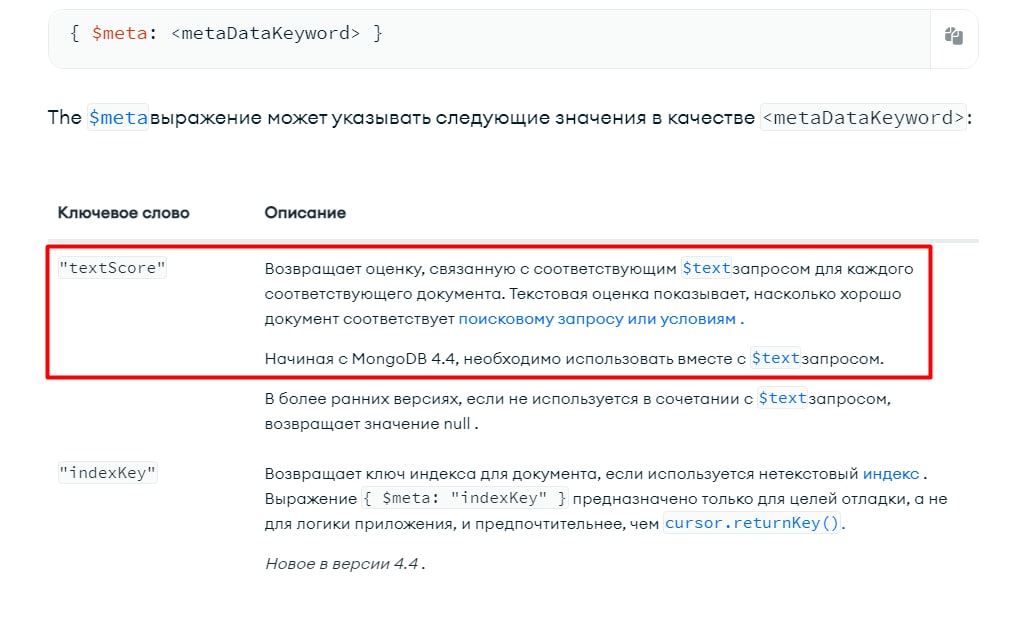 Yury
Alexandrr
Пробовал, возвращает некое число от 0 до 1, а не число вхождений. Можно иначе?
зачем число вхождений?
Yury
зачем число вхождений?
Потому что в результатах поиска мне нужны все документы, у которых есть поисковая строка и количество вхождений строки в данный документ
Alexandrr
Потому что в результатах поиска мне нужны все документы, у которых есть поисковая строка и количество вхождений строки в данный документ
что такое: "у которых есть поисковая строка"?
"количество вхождений строки в данный документ" или количество вхождений поисковой фразы в строку в "некоторых" документах?
Yury
Yury
Я хочу найти строку hi
Yury
Среди документов и сохранить в поле num_of_occ
Yury
Ожидаю вот такой результат
[
{
"_id" : ObjectId("6033a3b0406aaa04445434a1"),
"name" : "Dheemanth",
"description" : "Everything has hI in it.",
"num_of_occ" : 2
},
{
"_id" : ObjectId("6033a3b0406aaa04445434a2"),
"name" : "Heath",
"description" : "shushi ends with Hi.",
"num_of_occ" : 2
},
{
"_id" : ObjectId("6033a3b0406aaa04445434a3"),
"name" : "Abdelmlak",
"description" : "Hi i am Abdelmlak.",
"num_of_occ" : 1
},
{
"_id" : ObjectId("6033a3b0406aaa04445434a4"),
"name" : "Alex",
"description" : "missing keyword",
"num_of_occ" : 0
}
]
Alexandrr
Ожидаю вот такой результат
[
{
"_id" : ObjectId("6033a3b0406aaa04445434a1"),
"name" : "Dheemanth",
"description" : "Everything has hI in it.",
"num_of_occ" : 2
},
{
"_id" : ObjectId("6033a3b0406aaa04445434a2"),
"name" : "Heath",
"description" : "shushi ends with Hi.",
"num_of_occ" : 2
},
{
"_id" : ObjectId("6033a3b0406aaa04445434a3"),
"name" : "Abdelmlak",
"description" : "Hi i am Abdelmlak.",
"num_of_occ" : 1
},
{
"_id" : ObjectId("6033a3b0406aaa04445434a4"),
"name" : "Alex",
"description" : "missing keyword",
"num_of_occ" : 0
}
]
такие вещи лучше делегировать приложению, логику дописывать на уровне кода, потому что СУБД не будет достаточно продуктивно решать такие задачи.
обычно, такое решается в 3 этапа:
1. найти самые релевантные поисковые результаты, сортировка согласно metascore. от 0 до 1 - это условное выражение в %/100, самые подходящие результаты = наибольшее количество вхождений будет у документов, у которых метаскор будет ближе всего к 1.
2. берём эти документы (например, первые 1000, если требуется все, то берём все), на уровне кода считаем вхождения "hi", добавляем необходимое к объектам=документам
3. апдейтим документы в БД
если требуется обновить записи в БД, то есть после того, как поле "num_of_occ" : 0" добавлено, то тогда нужно применять промежуточную доп. логику, например, "модифицировать все документы, у которых metascore >= 0.7", но на сколько я знаю, регулярки не позволяют подсчитать количество вхождений.
тут может кто поправит меня, могу ошибаться.
Yury
Касательно подсчета - я уже нашел решение вот тут
https://stackoverflow.com/questions/66275959/how-to-get-the-number-of-occurence-of-a-keyword-inside-a-string-using-mongodb
let keyword = new RegExp("Hi", "i")
db.myCollection.aggregate([
{
$addFields: {
num_of_occ: {
$size: {
$filter: {
input: { $split: ["$description", " "] },
as: "text",
cond: {
$regexMatch: { input: "$$text", regex: keyword }
}
}
}
}
}
}
]);
Yury
А касательно идеи с фильтрацией через metascore и делегированием всего остального языку программирования, хм. Разве пример, который я скинул, имеет минусы при том, что решает задачу (возможно, медленно)
Yury
В БД мне записывать не нужно ничего. Просто нашел и отправил клиенту
Alexandrr
Касательно подсчета - я уже нашел решение вот тут
https://stackoverflow.com/questions/66275959/how-to-get-the-number-of-occurence-of-a-keyword-inside-a-string-using-mongodb
let keyword = new RegExp("Hi", "i")
db.myCollection.aggregate([
{
$addFields: {
num_of_occ: {
$size: {
$filter: {
input: { $split: ["$description", " "] },
as: "text",
cond: {
$regexMatch: { input: "$$text", regex: keyword }
}
}
}
}
}
}
]);
это решение имеет ряд минусов, главный из которых - НЕгибкость, в случае изменения логики, придётся это решение выкинуть в мусорное ведро, вместе с "частью надстроек на уровне кода"
ещё один минус - нагрузка на базу, если есть свободное время бездействия, и запросов не сотни тысяч, тогда нормально, но в ином случае, лучше делегировать приложению такие задачи
Yury
это решение имеет ряд минусов, главный из которых - НЕгибкость, в случае изменения логики, придётся это решение выкинуть в мусорное ведро, вместе с "частью надстроек на уровне кода"
ещё один минус - нагрузка на базу, если есть свободное время бездействия, и запросов не сотни тысяч, тогда нормально, но в ином случае, лучше делегировать приложению такие задачи
Запомнил, спасибо за очень подробное описание!
 Dima
всем привет, кто может подсказать почему не могу по айдишнику обновить документ?
coll.updateOne({ _id: idArticle }, { $set: { text: textArticle } });
в idArticle корректный айдишник нужного мне документа.
TypeError: ObjectID is not a function
аналогичный код на удаление работает
coll.deleteOne({ _id: ObjectID(req.body[0]) });
Dima
делаю две кнопки удалить и редачить, после редачить обрабатываю айдишник и новый текст. Но не могу перезаписать в базе. Удалить прекрасно работает.
Александр
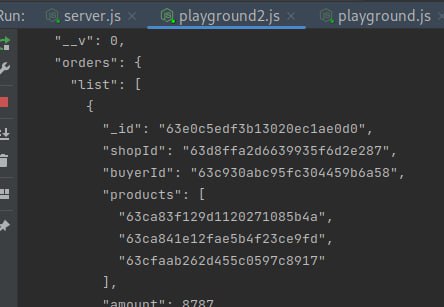 Александр
 Artem
Dima
63d25c8289db2154228dfe57 такого формата прилетает
Dima
просто меня смущает что удаление работает а апдейт нет, это какие то особенности?
Artem
просто меня смущает что удаление работает а апдейт нет, это какие то особенности?
В удалении вроде у вас ObjectID
Dima
а оно так же ругается сек точно щас верну код, я просто уже пол часа туда сюда его меняю
Dima
бляха ошибка была такой тупой что мне даже стыдно признаться где она была)))
Dima
нужно ObjectID, а ObjectId вот так было написано в реализации)) не знаю откуда я мелкую букву Д скопировал
Dmitry
нужно ObjectID, а ObjectId вот так было написано в реализации)) не знаю откуда я мелкую букву Д скопировал
Раньше в пакетах, два варианта было и мб как заглушка осталась
Dmitry
Они вроде к единому стандарту всё приводят
Dima
скорее всего либо линтер подсказку сделал либо где то с документации дернул.
У меня просто были старые стандарты импорта монго и была аналогичная проблема, показать документы через _id работало, а удалить или добавить не работало.
Я вот и подумал что тут еще какая то пакость с импортом
 Алёна
Добрый день. Подскажите, пжста, в чате разрешено постить вакансии? или не предусмотрено правилами канала?
Alexandrr
Добрый день. Подскажите, пжста, в чате разрешено постить вакансии? или не предусмотрено правилами канала?
вам каналы подсказать для вакансий?
кого ищете?