 Emil22878


мне нужно посчтатиь сколько объектов у меня в массиве
Emil22878
 Dmytro
 Александр
Коллеги доброго дня, довольно простой вопрос, так как прогуглиные ответы не помогают у меня есть массив объектов у каждого из них есть _id = new ObjectId("63c7c38223f4418ac0fc991f")
- вот такого формата как мне преобразовать дабы сравнить с 63c7c38223f4418ac0fc991f?? или второй id преобразовать как то
 Валерий
подскажите как получить поля удаляемых документов
например удаляем пять документов
возвращает удалено 3 с ид + имя 2 не найдено
 Andrey
Всем привет!
При выполнении db.adminCommand({listDatabases: 1}) выводятся только не пустые БД.
При выполнении db.adminCommand({listDatabases: 1, filter: {empty: true}}) выводится пустой список БД, хотя одна пустая БД есть и я выполнил use <db_name>.
Вроде бы фильтр empty:true намекает, что будут выведены пустые базы, но это не так.
Подскажите, пожалуйста, как вывести пустые БД?
 "
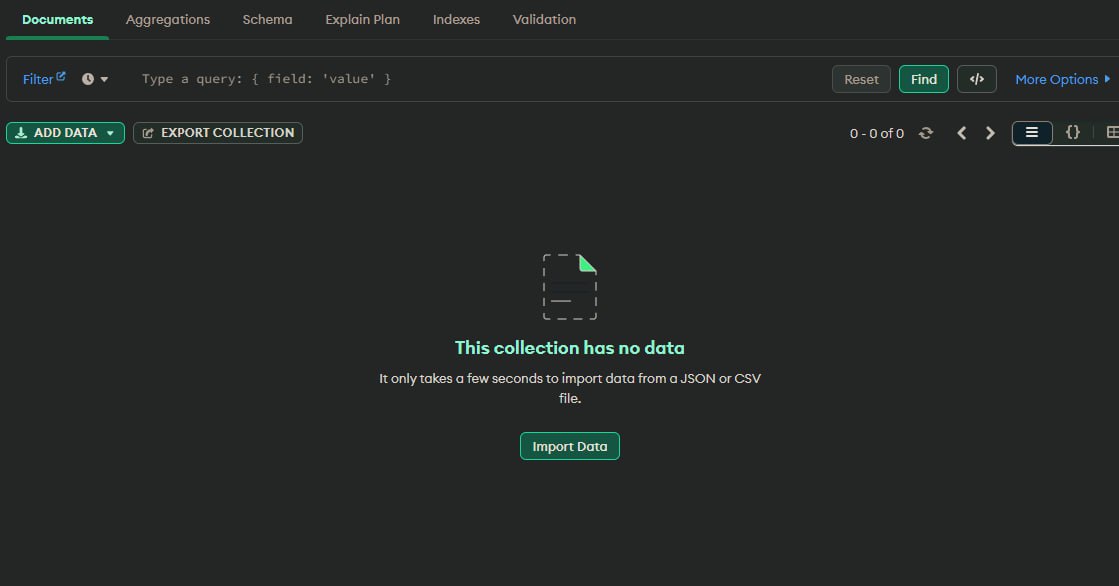
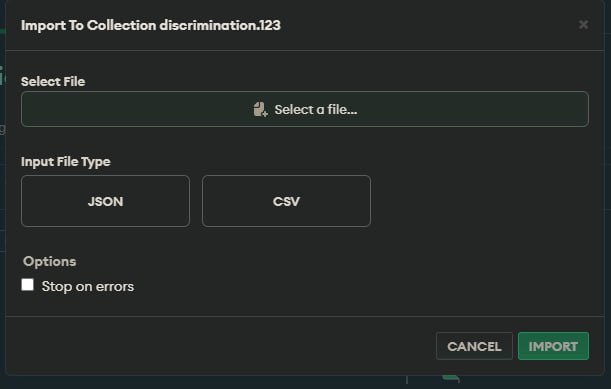
Is there any way to transform data from any db to mongo without coding or stored data manually
 Vladyslav
Is there any way to transform data from any db to mongo without coding or stored data manually
export as json\csv and import
 Yury
Подскажите в агрегациях { $match: { $text: ... } } нельзя использовать, кроме как в начале самой агрегации?
 Artem
Привет.
Подскажите корректный способ удаления большого набора записей из большой коллекции по фильтру неиндексированного поля. Поле фильтрации содержит дату. Запросы выполняются долго.
Может есть какой нибудь вариант скрипта когда сперва выполняется запрос на выборку а потом удаляем по id найденым и все это в цикле до последнего батча поискового запроса?
Artem
Привет.
Подскажите корректный способ удаления большого набора записей из большой коллекции по фильтру неиндексированного поля. Поле фильтрации содержит дату. Запросы выполняются долго.
Может есть какой нибудь вариант скрипта когда сперва выполняется запрос на выборку а потом удаляем по id найденым и все это в цикле до последнего батча поискового запроса?
Или если включить TTL насколько это повлияет на скорость работы с коллекцией? Насколько корректно выполнять такую операцию через TTL , а потом просто отключить?
 Nick
Или если включить TTL насколько это повлияет на скорость работы с коллекцией? Насколько корректно выполнять такую операцию через TTL , а потом просто отключить?
что ттл что рекомендация - постройте индекс
 Andrey K.
Подскажите, пжл, по паймонго, где-то косяк...
Делаю две временных засечки
min_timestamp = ObjectId.from_datetime(datetime.datetime.now())
time.sleep(1)
max_timestamp = ObjectId.from_datetime(datetime.datetime.now())
контрольный запрос по случайному айди работает
print (list(my_collection.find({"_id": ObjectId('63516e23457b7c1b6aaef61b')})))
А вот так не работает, когда я фильтрую по этим засечкам
print (list(my_collection.find({"_id": {"$gte": ObjectId(min_timestamp), "$lt": ObjectId(max_timestamp)}})))
непонятно - по идее, должны быть айдишники в заданном диапазоне, т.к. наполнение БД идет вот прямо в данный момент
Nick
Подскажите, пжл, по паймонго, где-то косяк...
Делаю две временных засечки
min_timestamp = ObjectId.from_datetime(datetime.datetime.now())
time.sleep(1)
max_timestamp = ObjectId.from_datetime(datetime.datetime.now())
контрольный запрос по случайному айди работает
print (list(my_collection.find({"_id": ObjectId('63516e23457b7c1b6aaef61b')})))
А вот так не работает, когда я фильтрую по этим засечкам
print (list(my_collection.find({"_id": {"$gte": ObjectId(min_timestamp), "$lt": ObjectId(max_timestamp)}})))
непонятно - по идее, должны быть айдишники в заданном диапазоне, т.к. наполнение БД идет вот прямо в данный момент
хз как тут питон работает, но второй раз оборачивать в objectid действительно надо?
Nick
и для тестов используйте фиксированное время, а не вызов now
Andrey K.
хз как тут питон работает, но второй раз оборачивать в objectid действительно надо?
да вроде уже пробовал и так, и сяк, проверю контрольно, спасибо.
 Alexandrr
Привет.
Подскажите корректный способ удаления большого набора записей из большой коллекции по фильтру неиндексированного поля. Поле фильтрации содержит дату. Запросы выполняются долго.
Может есть какой нибудь вариант скрипта когда сперва выполняется запрос на выборку а потом удаляем по id найденым и все это в цикле до последнего батча поискового запроса?
я делал перезапись коллекции, у меня обновления каждые 15 минут, по 15-25млн объектов были.
я делал следующее:
1. создаём новую коллекцию
2. наполняем ее нужными записями
3. удаляем старую
4. переименовываем новую в старую
Artem
Alexandrr
Да такой вариант тоже рассматриваю, спасибо
при таком решении, если нагрузка большая на базу, коллекция может быть недоступна порядка 5-7 секунд, стоит отловить исключения в этот момент, что бы пользователи не испытывали дискомфорта
Artem
при таком решении, если нагрузка большая на базу, коллекция может быть недоступна порядка 5-7 секунд, стоит отловить исключения в этот момент, что бы пользователи не испытывали дискомфорта
это пока причина, по которой не хотелось бы использовать этот способ. Думал может есть способ без остановки приложения запустить удаление не сильно влияющее на чтение из коллекции.
Alexandrr
это пока причина, по которой не хотелось бы использовать этот способ. Думал может есть способ без остановки приложения запустить удаление не сильно влияющее на чтение из коллекции.
а приложение ни кто и не останавливает, просто обе коллекции блокируются на время переименования
Artem
Alexandrr
один мудрец изощрился вообще прокидывать через трубы между процессами и шару памяти в приложении, менять конфиг приложения на лету, при этом просто изменяя название переменной хранящей название коллекции, на новое название коллекции "новая_2", старая называется "новая_1".
недоступность коллекции при таком способе около 0.001 секунды, но это для какого-то космического владения языком и знанием его исходников
Nick
один мудрец изощрился вообще прокидывать через трубы между процессами и шару памяти в приложении, менять конфиг приложения на лету, при этом просто изменяя название переменной хранящей название коллекции, на новое название коллекции "новая_2", старая называется "новая_1".
недоступность коллекции при таком способе около 0.001 секунды, но это для какого-то космического владения языком и знанием его исходников
такто в таком исполнении самая простая реализация, нужно только снаружи триггерить смену названия
Andrey K.
и для тестов используйте фиксированное время, а не вызов now
не понял пока почему, но именно это сработало. Почему то значения, полученные через datetime.datetime.now() не работали как диапазон
Nick
не понял пока почему, но именно это сработало. Почему то значения, полученные через datetime.datetime.now() не работали как диапазон
обычная проблема питона, что выглядит все работающим, а в результате херота с которой изза отсутствия типизации надо долго разобраться
 Murena
Всем привет - подскажите как в монге на лету (во время поиска/запроса) слить две коллекции вместе и делать по ним пагинацию ? Суть в том что есть две коллекции с тем же типом данных и мне нужно делать поиск по двум коллекциям, сортировку и пагинацию по результатам offset + limit, как можно на лету слить эти две коллекции в aggregation (или может есть другой вариант) и сделать по ним пагинацию/сортировку ? В доке не нашел подходящего ничего... подскажите кто шарит как это сделать ? Спасибо.
Murena
не нашел никакого способа как на лету в aggregation добавить данные с другой коллекции, отсортировать данные с двух колекций и вернуть результат, чтоб это все внутри монги сделать.
Nick
Всем привет - подскажите как в монге на лету (во время поиска/запроса) слить две коллекции вместе и делать по ним пагинацию ? Суть в том что есть две коллекции с тем же типом данных и мне нужно делать поиск по двум коллекциям, сортировку и пагинацию по результатам offset + limit, как можно на лету слить эти две коллекции в aggregation (или может есть другой вариант) и сделать по ним пагинацию/сортировку ? В доке не нашел подходящего ничего... подскажите кто шарит как это сделать ? Спасибо.
https://www.mongodb.com/docs/manual/reference/operator/aggregation/unionWith/
MGS
Приветствую всех, подскажите как можно вывести все строки содержащие все элементы запроса независимо от их расположения?
к примеру у меня есть записи:
Le Paul Vens, 123123
Vens Paul Le , 123123
Vens Le Paul , 123123
person Le Paul Vens, 123123
Denis Melnik , None
мой запрос выглядит следующим образом:
query = {"$text": {"$search": "\"Le Paul Vens\""}}
он выводит все записи где встречается фраза: Le Paul Vens
но мне нужно вывести все строки где встречается фраза Le Paul Vens независимо от расположения каждого слова.
как мне составить запрос?
Alexandrr
Приветствую всех, подскажите как можно вывести все строки содержащие все элементы запроса независимо от их расположения?
к примеру у меня есть записи:
Le Paul Vens, 123123
Vens Paul Le , 123123
Vens Le Paul , 123123
person Le Paul Vens, 123123
Denis Melnik , None
мой запрос выглядит следующим образом:
query = {"$text": {"$search": "\"Le Paul Vens\""}}
он выводит все записи где встречается фраза: Le Paul Vens
но мне нужно вывести все строки где встречается фраза Le Paul Vens независимо от расположения каждого слова.
как мне составить запрос?
я делал:
{'$match': {'$text': {'$search': "string"}}}
всё работает.
он разбивает поисковую фразу по пробелы по дефолту и вне зависимости от последовательности находит разные варианты.
работает только для текстового индекса
MGS
я делал:
{'$match': {'$text': {'$search': "string"}}}
всё работает.
он разбивает поисковую фразу по пробелы по дефолту и вне зависимости от последовательности находит разные варианты.
работает только для текстового индекса
у меня возникает ошибка unknown top level operator: $match. If you have a field name that starts with a '$' symbol, consider using $getField or $setField.
Alexandrr
у меня возникает ошибка unknown top level operator: $match. If you have a field name that starts with a '$' symbol, consider using $getField or $setField.
.aggregate({'$match': {'$text': {'$search': "string"}"}}}, {'$sort': {'score': {'$meta': "textScore"}}})
естественно
MGS
.aggregate({'$match': {'$text': {'$search': "string"}"}}}, {'$sort': {'score': {'$meta': "textScore"}}})
естественно
как я понял здесь используется метод поиска OR, можно ли сделать тоже самое с AND?
чтобы не выводились строки где только один элемент из моей фразы
Alexandrr
как я понял здесь используется метод поиска OR, можно ли сделать тоже самое с AND?
чтобы не выводились строки где только один элемент из моей фразы
думаю да, надо смотреть в сторону опций сортировки
 Александр
а как в монго можно посчитать кол-во строк, которые удовлетворяют условию? И вообще такое можно сделать?\
Nick
а как в монго можно посчитать кол-во строк, которые удовлетворяют условию? И вообще такое можно сделать?\
Группировка с $sum либо $count стейдж
Nick
Это было в агрегации, можно find().count()
Александр
а там какой-то язык для описания условий есть ?
Александр
нашел, спасибо
 Aleksandr
Подскажите, пожалуйста, по следующему вопросу: Планирую весь контент сайта разместить в БД MongoDB. Сайт у меня на трёх языках (русский, английский, испанский). Вопрос: нужно ли мне для каждой языковой версии создавать новую базу данных или достаточно в одной БД создавать разные коллекции для каждого языка по отдельности? Как правильнее или удобнее? Спасибо!
Alexandrr
Подскажите, пожалуйста, по следующему вопросу: Планирую весь контент сайта разместить в БД MongoDB. Сайт у меня на трёх языках (русский, английский, испанский). Вопрос: нужно ли мне для каждой языковой версии создавать новую базу данных или достаточно в одной БД создавать разные коллекции для каждого языка по отдельности? Как правильнее или удобнее? Спасибо!
недавно занимался мультиязычностью
задача была - статьи на 4х языках.
с возможностью независимого редактирования и параметров у каждой, все языки должны находиться в 1 объекте, в итоге пришёл к такой структуре:
{uuid: str,
lang_1: {other fields},
lang_2: {other fields},
...
lang_100500: {other fields}}
может есть решения и лучше, но пока не встречал, да и смотря какие задачи проводить требуется с объектами.
лучше исходить от задач и прогонять use-case's, смотря соответствие модели данных
Aleksandr
недавно занимался мультиязычностью
задача была - статьи на 4х языках.
с возможностью независимого редактирования и параметров у каждой, все языки должны находиться в 1 объекте, в итоге пришёл к такой структуре:
{uuid: str,
lang_1: {other fields},
lang_2: {other fields},
...
lang_100500: {other fields}}
может есть решения и лучше, но пока не встречал, да и смотря какие задачи проводить требуется с объектами.
лучше исходить от задач и прогонять use-case's, смотря соответствие модели данных
Это начально условие такое, что все языки должны находиться в 1 объекте? Или так удобнее было делать?
Я то вообще рассматриваю - либо отдельную БД для каждого языка, либо коллекцию для каждого языка.
А тут ты вообще предлагаешь всё в один объект. Даже не думал о таком решении. Надо подумать над таким способом.
Спасибо за вариант!
Alexandrr
Это начально условие такое, что все языки должны находиться в 1 объекте? Или так удобнее было делать?
Я то вообще рассматриваю - либо отдельную БД для каждого языка, либо коллекцию для каждого языка.
А тут ты вообще предлагаешь всё в один объект. Даже не думал о таком решении. Надо подумать над таким способом.
Спасибо за вариант!
необходимо, так как uuid статьи должен быть 1, не может же вести 4 ссылки к 4 разным языкам 1 и той же статьи (вернее может, но так не делают).
по этому, чтоб uuid был 1, необходимо было поместить все 4 языка в 1 объект.
у каждого "подобъекта"=языка есть свой набор полей внутри
 yopp
Подскажите, пожалуйста, по следующему вопросу: Планирую весь контент сайта разместить в БД MongoDB. Сайт у меня на трёх языках (русский, английский, испанский). Вопрос: нужно ли мне для каждой языковой версии создавать новую базу данных или достаточно в одной БД создавать разные коллекции для каждого языка по отдельности? Как правильнее или удобнее? Спасибо!
В одной коллекции, локализуемые поля удобнее всего хранить как:
field_i18n: [{lang: "en", value: "hello"}, {lang: "ru", value: "привет"}]
тогда можно использовать индекс field_i18n.lang, field_i18n.value
это самый гибкий из возможных вариантов, так как и хорошо индексируется и позволяет иметь произвольное количество языков и при желании в одном запросе можно сразу сделать fallback на нужный язык
yopp
если у вас много локализуемых аттрибутов, можно попробовать entity-attribute-value схему
dynamic_fields: [{attribute: "greeting", lang: "en", value: "hello"}, {attribute: "greeting", lang: "ru", value: "привет"}, {attribute: "foo", lang: "ru", value: "бар"}]
Aleksandr
В одной коллекции, локализуемые поля удобнее всего хранить как:
field_i18n: [{lang: "en", value: "hello"}, {lang: "ru", value: "привет"}]
тогда можно использовать индекс field_i18n.lang, field_i18n.value
это самый гибкий из возможных вариантов, так как и хорошо индексируется и позволяет иметь произвольное количество языков и при желании в одном запросе можно сразу сделать fallback на нужный язык
Классно! Спасибо, понятно! У меня явно изначально были ошибочные представления по неопытности.
 Alexander Cheprasov
Всем привет!
Кто знает как делать поиск в монге по полному совпадению в массиве?
Есть запись в базе
{
name: 'test',
array: [{
key: 'test'
}]
}
если я использую весь объект как фильр
.find({
name: 'test',
array: [{
key: 'test'
}]
} )
Не находит запись, как это исправить?
В жини array может содержать N объектов и поиск будет осеществляться по полному совпадению. Это для проверке на полное совпадение
Viktar
Всем привет!
Кто знает как делать поиск в монге по полному совпадению в массиве?
Есть запись в базе
{
name: 'test',
array: [{
key: 'test'
}]
}
если я использую весь объект как фильр
.find({
name: 'test',
array: [{
key: 'test'
}]
} )
Не находит запись, как это исправить?
В жини array может содержать N объектов и поиск будет осеществляться по полному совпадению. Это для проверке на полное совпадение
Попробуйте .find({name:'test','array.key':'test'})
Alexander Cheprasov
Попробуйте .find({name:'test','array.key':'test'})
не срабатывает, пробовал и array.0.key':'test'
Viktar
Странно. У меня отлично работает. Попробуйте ещё $elemMatch
https://www.mongodb.com/docs/manual/reference/operator/query/elemMatch/
 Hannibal
Ребят, как лучше делать админа в MongoDB? Специальное булевое значение в массиве пользователя, прям внутри кода точечно указав айди или токен?
Hannibal
Фронт на Реакте, вместе с MongoDB используется Express
lmn
Проц интел или амд?
В любом случае сли мышка серая то булевое будет хорошим решением а если с блютус то еще надо подумать
Vladyslav
Hannibal
Или чисто потом через path задавать условную роль?
Hannibal
А по умолчанию, в начале юзера делать
 Alexander
Подскажите, пожалуйста, по следующему вопросу: Планирую весь контент сайта разместить в БД MongoDB. Сайт у меня на трёх языках (русский, английский, испанский). Вопрос: нужно ли мне для каждой языковой версии создавать новую базу данных или достаточно в одной БД создавать разные коллекции для каждого языка по отдельности? Как правильнее или удобнее? Спасибо!
Если планируется очень высокая нагрузка разделённая по направлениям, то имеет смысл разделить. В других случаях просто увеличите сложность решения
Aleksandr
Если планируется очень высокая нагрузка разделённая по направлениям, то имеет смысл разделить. В других случаях просто увеличите сложность решения
Нет, большой нагрузки точно не планируется. В этой базе всего лишь будет контент (содержимое страниц) сайта. Судя по предыдущим ответам и Вашему замечанию, я так понял, что правильнее делать разные языки в рамках одного документа (объекта)? Попробую так и реализовать.
Pavel
Если планируется очень высокая нагрузка разделённая по направлениям, то имеет смысл разделить. В других случаях просто увеличите сложность решения
Ну на счет сложности я бы тут усомнился. Возьмем облако тегов, там есть теги на русском а есть на английском, и получается что нужен будет вместо простой выборке по массиву, выбирать из массивов объектов с фильтрацией по языку. Плюс если одновременно с документом работают разные контенщики каждый своего языка… Я бы взвесил, вынести по коллекциям языковым идея тоже жизнеспособна
Alexandrr
Ну на счет сложности я бы тут усомнился. Возьмем облако тегов, там есть теги на русском а есть на английском, и получается что нужен будет вместо простой выборке по массиву, выбирать из массивов объектов с фильтрацией по языку. Плюс если одновременно с документом работают разные контенщики каждый своего языка… Я бы взвесил, вынести по коллекциям языковым идея тоже жизнеспособна
обычный полнотекстовый поиск без указания дефолтного языка в поле, отлично работает с разными языками
Pavel
обычный полнотекстовый поиск без указания дефолтного языка в поле, отлично работает с разными языками
Это как пример, мне например в интернет магазине приходится выносить поля фильтров в корень документа, так как с вложенными монга начинает захлебываться
Alexandrr
Это как пример, мне например в интернет магазине приходится выносить поля фильтров в корень документа, так как с вложенными монга начинает захлебываться
индексы составные или обычные используются при этом?
если не в корень выносить
Alexandrr
Составные
ну так делать и нужно, понятное дело, что, что бы распаковать до "определённого уровня", нужно увеличить нагрузку на количество уровней * количество релевантных записей
Alexandrr
например, у нас есть 1 млрд записей с составным индексом: "ar.bt.err", где фильтруемое поле "err", количество операций увеличивается кратно вложенности: 1 * 3 = 3 млрд, если не использовать .skip() или .limit()
курсор будет идти именно 3 млрд раз
если бы индекс был просто "err", то естественно было бы 1 * 1 = 1 млрд.