ну получается буду сразу создавать индекс, а потом наполнять коллекцию, будет немного дольше, но за то без ошибок
если вы не используете диск на все 100% то даже не заметите разницы
 Viktar


 Alexandrr
если вы не используете диск на все 100% то даже не заметите разницы
диск далеко не на 100% занят
понял, спасибо
Viktar
диск далеко не на 100% занят
понял, спасибо
я про IO. операции вставки и чтения. У каждого диска есть предельные значения. больше которых он не может выполнить в единицу времени. А какой у вас размер вставляемых данных?
Alexandrr
Viktar
на 5 гб, вы даже не заметите разницы я думаю.
 Константин
кто в курсе, имеет ли смысл в MongoDB индексировать поле связи в коллекции ?
@Prop({ type: Types.ObjectId, ref: 'User', index: true, required: true })
userId: User;
 Astra
Привет, всем. Как вы считаете тянет ли на бакалавровскую выпускную квалификационную работу тема анализа быстродействия операций поиска (по нескольким или одному фильтра) и записи в базу данных (сравнивать хочу MongoDB и MySQL на примере каталога товаров, т.е построить какую нибудь классическую EAV в MySQL и её аналог в mongo, на генерировать данных столько сколько выдержит компьтер, затем делать одинаковые запросы к двум базам и смотреть как долго они выполняются)?
Спросить у препода пока не могу, идея вот только что пришли в голову, хочу узнать мнение со стороны, поэтому пишу сюда, возможно кто то в последние годы заканчивал универ и сможет мне подсказать
Astra
Так же хочу поиграться с архитектурой БД и индексами, потом сделать вывод что лучше применять, в каких кейсах какая БД выигрывает по производительности
 Vladyslav
Так же хочу поиграться с архитектурой БД и индексами, потом сделать вывод что лучше применять, в каких кейсах какая БД выигрывает по производительности
в этом смысла нету, так как есть куча статей, где подробно уже расписан этот вопрос
Astra
тема нормальная.
Ну тогда в сравнении нет смысла? Тоже много статей наверняка написано на эту тему, NoSQL/SQL тема холиварная ведь
Vladyslav
Ну тогда в сравнении нет смысла? Тоже много статей наверняка написано на эту тему, NoSQL/SQL тема холиварная ведь
так в этом и смысл дипломки - налить воды)
Я же отдельно ответил про дипломку и отдельно на другой вопрос
Astra
Меня просто тревожит, что тема довольно простая ведь? Программно нагенерировать фейковые данные (товар и его вариации) на пару миллионов строк, засунуть в две БД и просто читать/записывать данные
Astra
так в этом и смысл дипломки - налить воды)
Я же отдельно ответил про дипломку и отдельно на другой вопрос
А, я для воды и хотел поиграться с индексами)) у меня тема изначально другая была, нужно было что то вроде интернет магазина и админки для интернет магазина, я долго думал какую БД использовать, пришёл к тому, что лучше сделать сразу две и сравнить что лучше, потом осенило, почему сам процесс анализа не представить как диплом
Astra
Диплом вообще что то новое должен привносить в мир?))) Я же по сути буду делать то, что уже кто то наверняка делал и не раз
Vladyslav
А, я для воды и хотел поиграться с индексами)) у меня тема изначально другая была, нужно было что то вроде интернет магазина и админки для интернет магазина, я долго думал какую БД использовать, пришёл к тому, что лучше сделать сразу две и сравнить что лучше, потом осенило, почему сам процесс анализа не представить как диплом
сама тема для дипломки: сравнения 2 бд = норм.
А вот как развитие для разработчика - не имеет смысла.
Лучше уж для себя пойти в сторону тюнинга запросов на бд. Находить слабые\долгие запросы и уметь их оптимизировать.
Vladyslav
Диплом вообще что то новое должен привносить в мир?))) Я же по сути буду делать то, что уже кто то наверняка делал и не раз
кто вам такое сказал? а если вы даже и сделает что-то новое, то что вам взамен даст универ - ничего?
Astra
кто вам такое сказал? а если вы даже и сделает что-то новое, то что вам взамен даст универ - ничего?
Никто не говорил, я видимо сам себе внушил, что человек, получающий высшее образование должен для этого сделать что то серьёзное, профессиональное, как специалист
Vladyslav
Никто не говорил, я видимо сам себе внушил, что человек, получающий высшее образование должен для этого сделать что то серьёзное, профессиональное, как специалист
диплом, обучение в универе, никак вас не научат делать вещи в реальном мире. Если вы этого еще не поняли и выбираете тему для дипломки уже - то у меня для вас плохие новости о розовом мире))
Astra
сама тема для дипломки: сравнения 2 бд = норм.
А вот как развитие для разработчика - не имеет смысла.
Лучше уж для себя пойти в сторону тюнинга запросов на бд. Находить слабые\долгие запросы и уметь их оптимизировать.
Думаю в целом это можно прикрутить к моей теме, написать сначала простые запросы на фильтрацию товаров, чтобы хотя бы работали, затем их оптимизировать (для обеих БД) и посмотреть, что в итоге будет быстрее и гибче для возможного масштабирования, например добавления колонки, создание новой категории товара и тому подобное. Ну и я всё таки не готовый разработчик, такое сравнение и для меня будет полезно, я фронтом занимаюсь в большей степени, мир БД для меня загадка
Astra
диплом, обучение в универе, никак вас не научат делать вещи в реальном мире. Если вы этого еще не поняли и выбираете тему для дипломки уже - то у меня для вас плохие новости о розовом мире))
Ну официально я ещё не поменял, возможно и не смогу поменять, на дворе уже декабрь((( Будет жаль если не смогу, тема для меня интересна
Vladyslav
Думаю в целом это можно прикрутить к моей теме, написать сначала простые запросы на фильтрацию товаров, чтобы хотя бы работали, затем их оптимизировать (для обеих БД) и посмотреть, что в итоге будет быстрее и гибче для возможного масштабирования, например добавления колонки, создание новой категории товара и тому подобное. Ну и я всё таки не готовый разработчик, такое сравнение и для меня будет полезно, я фронтом занимаюсь в большей степени, мир БД для меня загадка
а смысл для фронта выбирать дипломную - сравнение бд?
Astra
диплом, обучение в универе, никак вас не научат делать вещи в реальном мире. Если вы этого еще не поняли и выбираете тему для дипломки уже - то у меня для вас плохие новости о розовом мире))
Я понимаю что от универа мало толку, но государство так не считает, я думал, что будут какие то стандарты по сложности диплома и т.д.
Vladyslav
Я понимаю что от универа мало толку, но государство так не считает, я думал, что будут какие то стандарты по сложности диплома и т.д.
будут требования по количеству страниц, форматированию и обложке))
Astra
а смысл для фронта выбирать дипломную - сравнение бд?
У меня специальность "прикладная информатика" с профилем "управление данными" Было бы как то странно, если бы для диплома я писал какое нибудь react (для примера) приложение
Vladyslav
У меня специальность "прикладная информатика" с профилем "управление данными" Было бы как то странно, если бы для диплома я писал какое нибудь react (для примера) приложение
если вы сказали, что вы хотите заниматься фронтом, то какая разница о чем дипломка.
Да хоть закончите на повара, главное: умейте фронт
Astra
Я в том плане, что возможно кафедра бы не одобрила тему не связанную с моей специальностью, я не рассматриваю диплом, как этап своего обучения фронтенду, просто хочу написать и наконец закончить универ
Astra
Ведь учат нас одному (скорее не учат) а занимаюсь я другим, но дипломку то писать нужно по тому что учат
Vladyslav
Astra
Возможно, я как то и не пробовал на самом деле)
Vladyslav
Ведь учат нас одному (скорее не учат) а занимаюсь я другим, но дипломку то писать нужно по тому что учат
в корне не верно: дипломку то писать нужно по тому что учат
Astra
Разве?
Astra
Ну блин в таком случае условный студент факультета журналистики может писать дипломную работу на тему "сравнение ДНК человек разумного с ДНК австралопитека"
Astra
Тема же всё таки должна коррелировать с получаемой специальностью
Vladyslav
Ну блин в таком случае условный студент факультета журналистики может писать дипломную работу на тему "сравнение ДНК человек разумного с ДНК австралопитека"
если раскрыть тему с точки зрения журналистики, то конечно.
Или вы если зайдете в продуктовый магазин и увидите там клей - то сразу пожалуетесь, что его тут не должно быть в продажи?
Astra
если раскрыть тему с точки зрения журналистики, то конечно.
Или вы если зайдете в продуктовый магазин и увидите там клей - то сразу пожалуетесь, что его тут не должно быть в продажи?
В таком случае, на ваш взгляд, какую тема можно выбрать с направлением во фронтенд?
Astra
Разработка клиентского приложения интернет-магазина подойдёт?
Vladyslav
Разработка клиентского приложения интернет-магазина подойдёт?
дефолтная, проста тема - если вам одобрят, можно
Astra
А что нибудь ещё можете предложить? А то интернет магазин действительно как то банально
Vladyslav
вдруг нет, вот вам более техническая - сравнение произвдительности angular/react/vue
Vladyslav
А что нибудь ещё можете предложить? А то интернет магазин действительно как то банально
если хотите чему-то научится и получить пользу - микрофронтенды - тема
Astra
Для этого нужно знать на хорошом уровне все три технологии
Astra
Ну тогда сравнение будет на каком то любительском уровне
Vladyslav
Ну тогда сравнение будет на каком то любительском уровне
вы хотите "профессионально" лить воду?
Astra
Было бы неплохо
 Ivan
У меня специальность "прикладная информатика" с профилем "управление данными" Было бы как то странно, если бы для диплома я писал какое нибудь react (для примера) приложение
Обычно за студентом закрепляют научного руководителя (либо вы делаете это сами исходя из своих интересов, если вы ответственный и увлеченный студент), с которым вы выбираете или согласовываете тему. Критерии работ (ее объем, оформление, процент плагиата), обычно, у каждого университета свои.
Тема диплома не обязательно должна четко соответствовать факультету, она может иметь отклонение в сторону кафедры, что более правильно. Это даёт больший маневр для выбора по интересам.
В любом случае, вам стоит уточнить у преподавателя и обсудить это с ним.
А по поводу знать что-то хорошо перед написанием диплома: да, безусловно, какое-то представление желательно иметь, но этого достаточно. Учитесь вы, а не комиссия, они знают все это и так, поэтому вы и должны, делая диплом, разобраться в теме и чему-то научиться. Именно это и требуется от вас на данном этапе.
 Элёр
 Alexandrr
Ну тогда в сравнении нет смысла? Тоже много статей наверняка написано на эту тему, NoSQL/SQL тема холиварная ведь
если хватит ума и тысячи страниц учесть все параметры от которых зависят скорости исполнения одинаковых команд в разных средах, а потом сравнить разные способы использования данных (скул, носкул), то можно сразу претендовать на помидорку.
в ином случае - не имеет смысла
 Nick
Ну тогда в сравнении нет смысла? Тоже много статей наверняка написано на эту тему, NoSQL/SQL тема холиварная ведь
она холиварная только когда нет требований, как только появляются требования и понимание что требуется от БД сразу решается какой тип БД под какую часть системы брать. Сравнивать разные БД без явного указания всех требований бессмысленно (участвовал в таком, аж смешно вспоминать). Но вы можете взять конкретный случай и под него посмотреть что будет подходить, выберите что-то что еще не освещалось в интернетах (хех, тут думаю прям удача нужна, чтобы найти новое). Хотя без большого опыта разработки получить полезные выводы всеравно не получится, как и вообще корректно организовать сам процесс тестирования производительности (для диплома может ок, но если хочется пользу какуюто привнести то маловероятно)
Как сказали выше поговорите с научруком, если хочется хардкора и он может чтото предложить или хотя бы готов будет понаправлят ьи материалами, то ввязывайтесь. Например взять ту же монгу, взять ее индекс, оценить реализацию с точки зрения скорости работы и накладных расходов на разных объемах самого индекса (1к, 1кк, 1ккк, 100ккк записей) и ограниченных ресурсах оперативы, потом оценить под какой вообще теоретический предел, и предложить что можно улучшить. По аналогии можно взять любую БД, можно не самую известную, где будет простор для улучшений
Nick
Элёр
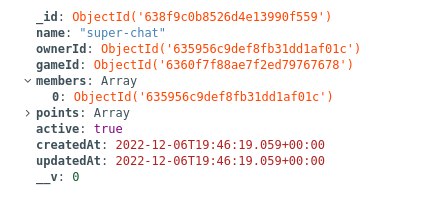
фильтровать по members
Ivan
Типа находить исходную запись по одному из id поля members?
Ivan
Можно через обычный find, используя arrayFilters, вроде
Ivan
Model.find({members: {$elemMatch: {_id: ваш id}}).
Astra
Обычно за студентом закрепляют научного руководителя (либо вы делаете это сами исходя из своих интересов, если вы ответственный и увлеченный студент), с которым вы выбираете или согласовываете тему. Критерии работ (ее объем, оформление, процент плагиата), обычно, у каждого университета свои.
Тема диплома не обязательно должна четко соответствовать факультету, она может иметь отклонение в сторону кафедры, что более правильно. Это даёт больший маневр для выбора по интересам.
В любом случае, вам стоит уточнить у преподавателя и обсудить это с ним.
А по поводу знать что-то хорошо перед написанием диплома: да, безусловно, какое-то представление желательно иметь, но этого достаточно. Учитесь вы, а не комиссия, они знают все это и так, поэтому вы и должны, делая диплом, разобраться в теме и чему-то научиться. Именно это и требуется от вас на данном этапе.
Да, я понимаю, конечно уточню у научрука, просто идеи вот прям сегодня вечером в голову пришла, не хотел писать преподу в столь поздний час.
Astra
если хватит ума и тысячи страниц учесть все параметры от которых зависят скорости исполнения одинаковых команд в разных средах, а потом сравнить разные способы использования данных (скул, носкул), то можно сразу претендовать на помидорку.
в ином случае - не имеет смысла
Ну я не претендую на помидорку)) (знать бы что это ещё :) ) Просто если так посмотреть то почти ни один диплом не имеет делать смысла. Я видел темы своих одногруппников, у них так же всё банально, все эти темы уже давно разобраны по косточкам, т.е ничего нового мы не привнесем
Константин
всем привет, изучаю возможности MongoDB, не совсем понял момент, в реляционных SQL, индексы создаются при создании таблиц, т.е. при добавлении данных в таблицы индексы перестраиваются
в MongoDB во многих примерах идет сперва добавление данных в коллекцию, а затем накидывают индекс
возникает вопрос, как будет правильнее и эффективнее для MongoDB:
1. сперва добавить данные и затем накинуть индекс
2. сперва создать индексы для коллекции и затем уже добавлять, удалять данные
Alexandrr
всем привет, изучаю возможности MongoDB, не совсем понял момент, в реляционных SQL, индексы создаются при создании таблиц, т.е. при добавлении данных в таблицы индексы перестраиваются
в MongoDB во многих примерах идет сперва добавление данных в коллекцию, а затем накидывают индекс
возникает вопрос, как будет правильнее и эффективнее для MongoDB:
1. сперва добавить данные и затем накинуть индекс
2. сперва создать индексы для коллекции и затем уже добавлять, удалять данные
- добавление данных с созданными индексами идёт медленнее
- добавление индекса с версии 4.2 идёт асинхронно (если данных много, могут быть ошибки, недавно я столкнулся с такой)
- если данных не много или они не часто обновляются, лучше накинуть сразу индекс, так как в процессе изменения данных уже залитых, индекс сразу может потребоваться, а данные ещё только заливаются/обновляются
Alexandrr
Ну я не претендую на помидорку)) (знать бы что это ещё :) ) Просто если так посмотреть то почти ни один диплом не имеет делать смысла. Я видел темы своих одногруппников, у них так же всё банально, все эти темы уже давно разобраны по косточкам, т.е ничего нового мы не привнесем
лучше разбери, почему толковый десктоп-апп ui возможен только на плюсах
Константин
- добавление данных с созданными индексами идёт медленнее
- добавление индекса с версии 4.2 идёт асинхронно (если данных много, могут быть ошибки, недавно я столкнулся с такой)
- если данных не много или они не часто обновляются, лучше накинуть сразу индекс, так как в процессе изменения данных уже залитых, индекс сразу может потребоваться, а данные ещё только заливаются/обновляются
я подобное уже читал выше тут, но так и не понял, если в пустую коллекцию сразу накинуть индекс на поле, то при добавлении документов в коллекцию, индекс будет перестраиваться или нет
Alexandrr
я подобное уже читал выше тут, но так и не понял, если в пустую коллекцию сразу накинуть индекс на поле, то при добавлении документов в коллекцию, индекс будет перестраиваться или нет
да, добавленные поля, для которых создан индекс будут перестраиваться (учитываться/индексироваться на лету)
Константин
Astra
она холиварная только когда нет требований, как только появляются требования и понимание что требуется от БД сразу решается какой тип БД под какую часть системы брать. Сравнивать разные БД без явного указания всех требований бессмысленно (участвовал в таком, аж смешно вспоминать). Но вы можете взять конкретный случай и под него посмотреть что будет подходить, выберите что-то что еще не освещалось в интернетах (хех, тут думаю прям удача нужна, чтобы найти новое). Хотя без большого опыта разработки получить полезные выводы всеравно не получится, как и вообще корректно организовать сам процесс тестирования производительности (для диплома может ок, но если хочется пользу какуюто привнести то маловероятно)
Как сказали выше поговорите с научруком, если хочется хардкора и он может чтото предложить или хотя бы готов будет понаправлят ьи материалами, то ввязывайтесь. Например взять ту же монгу, взять ее индекс, оценить реализацию с точки зрения скорости работы и накладных расходов на разных объемах самого индекса (1к, 1кк, 1ккк, 100ккк записей) и ограниченных ресурсах оперативы, потом оценить под какой вообще теоретический предел, и предложить что можно улучшить. По аналогии можно взять любую БД, можно не самую известную, где будет простор для улучшений
Конкретный случай есть - каталог товаров, хочу нагенерировать фейковых данных, будет около 10-20 категорий товара + различные вариации, т.е разные цвета, у разных цветов разные размеры, бренд, состав, производитель и так далее. В реляционных базах для таких случаев есть популярное (как я читал) решение - это EAV, но её многие ругают за то что нужно делать много join- ов чтобы получить конкретный товар с конкретными характеристика, это решается индексами, но для каталогов так же популярна и mongo (как я читал) пока не знаю как каталог реализуется в mongo ( с учётом возможности расширения в будущем, например добавление новой категории, товара или атрибута) вот хочу сравнить как себя будут вести эти базы данных при одних и тех же задачах, таких как фильтрация, поиск и добавление товара
Alexandrr
спс за разъяснение )))
подробнее можно почитать в документации
https://www.mongodb.com/docs/manual/tutorial/manage-indexes/
Astra
лучше разбери, почему толковый десктоп-апп ui возможен только на плюсах
Лучшее управление памятью? По этой же причине его используют и в геймдеве (unreal engine)
Alexandrr
Лучшее управление памятью? По этой же причине его используют и в геймдеве (unreal engine)
ты у меня не спрашивай)
иди разбирайся, изучай
I
Лучшее управление памятью? По этой же причине его используют и в геймдеве (unreal engine)
Там вон уже раст в ядре линукса маячит )
 of Astora 𒉭
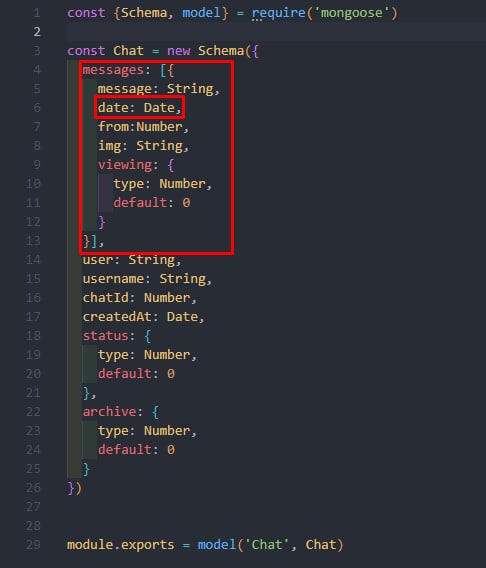 of Astora 𒉭
.sort({? -date})?
Dmitry
message.date: -1
Константин
подскажите как mongoose в схеме указать, что это полнотекстовый индекс
например простой индекс указываем
index: true
не могу в документации найти про это информацию, нашел только как создавать полнотекстовый индекс через createIndex()