Или я тупой или сани не едут :)
const userSchema = new Schema({
phone: {
type: String,
validate: {
validator: function(v) {
return /\d{3}-\d{3}-\d{4}/.test(v);
},
message: props => `${props.value} is not a valid phone number!`
},
required: [true, 'User phone number required']
}
});
В их примерах у ключа пропсами прописывается валидация и тд. Но я же не могу заменитьусловную стрингу своим объектом вместо type
у вас где описывается массив? там првоеряете что у массива длина больше нуля
 Nick


 Astra
Привет, подскажите, пожалуйста, как хранить цены продукта в монге? Т.е цена может быть разной в зависимости от времени, у цены есть поля
1) цена
2) дата начала действия
3) дата окончания действия
Как это можно организовать ума не приложу. Чтобы допустим при запросе на клиент подтягивалась только актуальная цена
 Talentless
Привет, подскажите, пожалуйста, как хранить цены продукта в монге? Т.е цена может быть разной в зависимости от времени, у цены есть поля
1) цена
2) дата начала действия
3) дата окончания действия
Как это можно организовать ума не приложу. Чтобы допустим при запросе на клиент подтягивалась только актуальная цена
ну в монго только TTL index из похожего вроде
Talentless
тут скорее крон какой-то для сканирования коллекций на просроченные цены
 Alexander
Привет, подскажите, пожалуйста, как хранить цены продукта в монге? Т.е цена может быть разной в зависимости от времени, у цены есть поля
1) цена
2) дата начала действия
3) дата окончания действия
Как это можно организовать ума не приложу. Чтобы допустим при запросе на клиент подтягивалась только актуальная цена
У меня есть такое...
Есть некая сущность с ценой. У неё есть правила. Прямо вот встроенный список документов. Почти в том формате, в каком у тебя показано.
Но у меня специфика в том, что мне не нужно искать текущие цены и как-то с ними работать. Достаточно уже в коде проекта перебрать правила и найти текущую. За целостность так же отвечает код приложения, а не БД.
Astra
У меня есть такое...
Есть некая сущность с ценой. У неё есть правила. Прямо вот встроенный список документов. Почти в том формате, в каком у тебя показано.
Но у меня специфика в том, что мне не нужно искать текущие цены и как-то с ними работать. Достаточно уже в коде проекта перебрать правила и найти текущую. За целостность так же отвечает код приложения, а не БД.
Т.е на бэке идёт поиск цены? Я думал всю историю цен хранить в документе продукта и на бэке уже как то фильтровать
Astra
тут скорее крон какой-то для сканирования коллекций на просроченные цены
Загуглю, не знаю что это, я в монге прям новичек, понаех из MySQL)))
Alexander
Т.е на бэке идёт поиск цены? Я думал всю историю цен хранить в документе продукта и на бэке уже как то фильтровать
Нет поиска цены. У меня тут более сложная штука, не готов погружать в неё. Но если коротко, то есть сущность и в ней есть список изменений цен. В каждый конкретный момент времени, имея сущность можно узнать её цену. Мне этого достаточно.
Но мне не нужно сортировать по текущей цене эти сущности. Это важный момент.
Astra
Понятно. А не посоветуете какие нибудь источники, которыми пользовались при проектировании?
Talentless
Загуглю, не знаю что это, я в монге прям новичек, понаех из MySQL)))
Тебе надо либо переосмыслить как ты вообще поддерживаешь акутальность, либо писать логику под конкретный сценарий, так как монго максимум через определенное время удалит документ
Astra
Мне не нужно удалять, надо сохранять историю цены
Talentless
Ну вот, монго за тебя это не решит
Astra
Есть ли вообще где нибудь готовые структуры для e-commerce проектов? Вроде бы довольно распространенная тема, но не нашёл такого, чтоб была описана прям вся система, с управлением остатками, закупками и разными ценами
Alexander
Понятно. А не посоветуете какие нибудь источники, которыми пользовались при проектировании?
Опыт. 🙂
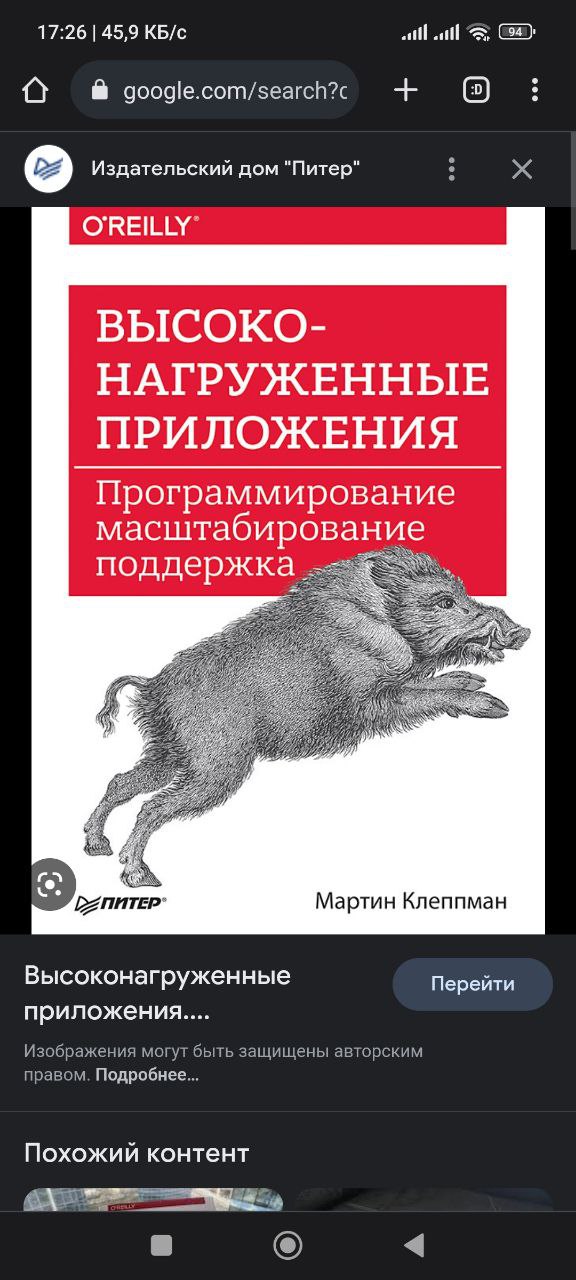
К сожалению, не посоветую. Разве что "книжку с кабанчиком"...
Alexander
Книги, которые не надо читать, чтобы понять, что в них написанно, мне неизвестны.
Alexander
Уж лучше читать.
Alexander
Но ответ хороший. Не подумал. 🙂
Astra
Опыт. 🙂
К сожалению, не посоветую. Разве что "книжку с кабанчиком"...
А что за книга? Не нашёл с кабаном
Astra
 Astra
Вот это?
Alexander
Astra
Ещё вопрос:
У меня стоит задача создать интернет магазин, как СУБД хочу использовать mongodb, но я не знаю где можно развернуть/захостить свой проект. Можете помочь с этим? Что почитать/посмотреть на эту тему. Искал хостинги, но на них используется MySQL/PHP, а мне нужно mongoDB/node.js
Astra
Спасибо
 Andrey
Вопрос про агрегации.
Есть запрос типа, условно:
values = [{'key1': value1, 'key2': value2}, {'key1': value3, 'key2': value4}]
match: {or: values}
по элементам из values - по каждому могут быть много документов.
Можно ли как то вывести только каждый 1 документ из подходящий по условие в values.
Условно, как если было бы много запросов findone по values - из подходящих под условие нужен только 1 документ вообщем
Nick
Вопрос про агрегации.
Есть запрос типа, условно:
values = [{'key1': value1, 'key2': value2}, {'key1': value3, 'key2': value4}]
match: {or: values}
по элементам из values - по каждому могут быть много документов.
Можно ли как то вывести только каждый 1 документ из подходящий по условие в values.
Условно, как если было бы много запросов findone по values - из подходящих под условие нужен только 1 документ вообщем
в агрегации $filter для отсеивания нужных элементов, потом через $slice взять один элемент
Andrey
в агрегации $filter для отсеивания нужных элементов, потом через $slice взять один элемент
Нет, фильтровать ничего не надо, если такие документы нашлись, у них надо просто взять по 1 документу- из кажого документа у него 2 поля нужны.
Условно, нужны те кто вообще нашлись
Andrey
Просто проверить есть ли такие документы с полями. Так как поткаждой паре может быть много документов, у них другие поля отличается, чтотмонга не поднимала все такие - вот и ищу способ
Nick
Andrey
Документ: k1:v1, k2:v2, k3:v3. И таких с отличным полем k3 - условно 100
Документ: k1:v4, k2:v5, k3:v6
Я через match or ищу сразу по всем нужным k1, k2
Но мне из каждой группы нужно по 1.
Andrey
Группировка поднимет все 100 из первой и все условно 200 из 2 группы по k1, k2
Andrey
А мне просто знать - если такие документы с нужными k1,k2. Понятно, что можно по каждой паре k1, k2 сделать findone.
Andrey
Но не хотелось бы делать 1000 запросов
Nick
Документ: k1:v1, k2:v2, k3:v3. И таких с отличным полем k3 - условно 100
Документ: k1:v4, k2:v5, k3:v6
Я через match or ищу сразу по всем нужным k1, k2
Но мне из каждой группы нужно по 1.
что значит "нужно по одному"? limit(1) и вот у вас один
Andrey
что значит "нужно по одному"? limit(1) и вот у вас один
Да но как в агрегации это сделать
Andrey
Из каждой группы нужен 1
Andrey
Первый стейдж match через or пар ключ значение
Andrey
Если после лимит сделать - то будет просто 1 первый документ
Andrey
В первом матче в or 1000 пар ключ- значение. Каждой такой паре n документов соответствует. Надо для каждой пары взять просто 1
Nick
Если после лимит сделать - то будет просто 1 первый документ
так лимит надо делать на каждой группе - ставите группировку на пару, с пушем, слайсом вытаскиваете первый эелмент
Andrey
так лимит надо делать на каждой группе - ставите группировку на пару, с пушем, слайсом вытаскиваете первый эелмент
Не понимаю как стейджи будут выглядеть. И опять про слайс монга же все равно «подгрузит» все документы из каждой группы, и потом только слайс
Nick
Не понимаю как стейджи будут выглядеть. И опять про слайс монга же все равно «подгрузит» все документы из каждой группы, и потом только слайс
а у вас другого варианта нет, на стороне базы будет подгрузка всех данных с дисков. Разве что планировщик чтонить наколдует и чтото проигнорирует
Andrey
а у вас другого варианта нет, на стороне базы будет подгрузка всех данных с дисков. Разве что планировщик чтонить наколдует и чтото проигнорирует
То есть find с лимитом 1 оно же- findone - тянет все документы?
Nick
То есть find с лимитом 1 оно же- findone - тянет все документы?
как повезет, зависит от условий выборки, налчия индексов, сортировок
Andrey
как повезет, зависит от условий выборки, налчия индексов, сортировок
Да нет.
По другому попробую. Как завернуть 1000 findone по одной паре ключей но для разных значений в этих ключах в аггрегацию.
Nick
Да нет.
По другому попробую. Как завернуть 1000 findone по одной паре ключей но для разных значений в этих ключах в аггрегацию.
match
group{push}
project{slice}
Andrey
Так матч потянет все документы для каждой пары
Nick
Так матч потянет все документы для каждой пары
а что значит "первый", базе это не ясно, нормальный критерий вы сформировать не можете, значит да все
Andrey
Первый любой - лимит 1
Andrey
Проверка - если вообще документы с такими значения в ключах
 Alexandrr
вопрос ко всем - не встречал ли кто-то попыток создать орм для носкул?
или всё-таки, были такие отчаянные ребята?
Nick
Alexandrr
вопрос:
иногда ловлю такую ошибку в аппе
"pymongo.errors.OperationFailure: text index required for $text query (no such collection 'name_db.name_collection'), full error: {'ok': 0.0, 'errmsg': "text index required for $text query (no such collection 'name_db.name_collection')", 'code': 27, 'codeName': 'IndexNotFound'}"
т.е. ошибка - нет такой коллекции корневая, как я понял, только коллекция существует.
как такое может вообще быть?
так как у меня "много записей", я обновляю всю коллекцию путём переименования новой, в имя старой (что бы доступность данных была бесперебойной), но эта ошибка не совпадет с временем обновления (перезаписи коллекции).
п.с.
name_db.name_collection - я изменил специально имя, не обращайте на это внимания
 yopp
вопрос:
иногда ловлю такую ошибку в аппе
"pymongo.errors.OperationFailure: text index required for $text query (no such collection 'name_db.name_collection'), full error: {'ok': 0.0, 'errmsg': "text index required for $text query (no such collection 'name_db.name_collection')", 'code': 27, 'codeName': 'IndexNotFound'}"
т.е. ошибка - нет такой коллекции корневая, как я понял, только коллекция существует.
как такое может вообще быть?
так как у меня "много записей", я обновляю всю коллекцию путём переименования новой, в имя старой (что бы доступность данных была бесперебойной), но эта ошибка не совпадет с временем обновления (перезаписи коллекции).
п.с.
name_db.name_collection - я изменил специально имя, не обращайте на это внимания
Ошибка о том, что у вас нет полнотекстового индекса, но в запросе есть оператор $text, который без этого индекса не работает
yopp
Скорее всего после переноса данных вы не пересоздаете этот индекс в новой колллекции
Alexandrr
Ошибка о том, что у вас нет полнотекстового индекса, но в запросе есть оператор $text, который без этого индекса не работает
индекс сразу создаётся после перезаписи старой коллекции.
то есть:
1. существует старая коллекция, в ней изменяется много данных (порядка 70%)
2. что бы не делать данные недоступными "долгое время" (критично более 1 минуты), я в фоне создаю новую коллекцию с данными: данные старой коллекции + данные обновлённые + новые данные
3. получаю коллекцию 2_новую
4. в один момент, как только 2_новая - готова, я удаляю старую, а новую переименовываю в старое название
5. естественно в 2_новая индекс уже создан
yopp
индекс сразу создаётся после перезаписи старой коллекции.
то есть:
1. существует старая коллекция, в ней изменяется много данных (порядка 70%)
2. что бы не делать данные недоступными "долгое время" (критично более 1 минуты), я в фоне создаю новую коллекцию с данными: данные старой коллекции + данные обновлённые + новые данные
3. получаю коллекцию 2_новую
4. в один момент, как только 2_новая - готова, я удаляю старую, а новую переименовываю в старое название
5. естественно в 2_новая индекс уже создан
Возможно есть какое-то окно когда индекс еще не создался, но чтение уже переключено на новую коллекцию
Alexandrr
в этом случае пользователи ловят timeout_error - это я понимаю, я опускаю этот момент, а вот именно с отсуствием индекса/коллекции - мне не пноятно...
yopp
Могу посоветовать посмотреть в логи в районе +-6 часов от времени возникновения ошибки. Там будет больше информации.
Больше всего похоже на то, что индекс не создался, а то что время ошибки не коррелирует с временем переключения, может быть из-за того, что запрос с этим оператором возникает редко
Alexandrr
Могу посоветовать посмотреть в логи в районе +-6 часов от времени возникновения ошибки. Там будет больше информации.
Больше всего похоже на то, что индекс не создался, а то что время ошибки не коррелирует с временем переключения, может быть из-за того, что запрос с этим оператором возникает редко
у меня логируется всё поверх приложения ещё, логи монги + аппы я разбираю сразу и куда нужно распределяю
Alexandrr
но за совет спасибо, буду смотреть по таймингам, что и когда происходило.
только не понимаю зачем +-6 часов?
Alexandrr
Возможно есть какое-то окно когда индекс еще не создался, но чтение уже переключено на новую коллекцию
тут нет, невозможно, код построчно выполняется.
я с помощью питона управляю монгой, строка создания индекса идёт последней, потом всё остальное - переименование и т.д.
yopp
тут нет, невозможно, код построчно выполняется.
я с помощью питона управляю монгой, строка создания индекса идёт последней, потом всё остальное - переименование и т.д.
Создание индекса на больших объемах может много времени занимать. Вы можете попробовать создавать индексы до вставки данных. Данные будут добавляться чуть медленнее, но при этом индекс сразу будет доступен для использования
Alexandrr
Создание индекса на больших объемах может много времени занимать. Вы можете попробовать создавать индексы до вставки данных. Данные будут добавляться чуть медленнее, но при этом индекс сразу будет доступен для использования
но монгоsh который собственно и управляется модулем pymongo возвращает ответ в std.out же, он подхватывается и далее сигнализирует о выполнении кода дальнейшем, или, монга может раньше выполнения задачи вернуть ответ? разве такое возможно?
Viktar
Создание индекса на больших объемах может много времени занимать. Вы можете попробовать создавать индексы до вставки данных. Данные будут добавляться чуть медленнее, но при этом индекс сразу будет доступен для использования
Если большой объем, то вставка будет намного дольше. Но если данные нужны ещё до момента добавления данных, то это хорошее решение
yopp
с версии 4.2, все индексы создаются асинхронного, по этому createIndex() вернёт ответ практически сразу, не ожидая завершения создания индекса
yopp
https://www.mongodb.com/docs/manual/reference/command/createIndexes/
Changed in version 4.2.
For feature compatibility version (fcv) "4.2", all index builds use an optimized build process that holds the exclusive lock only at the beginning and end of the build process. The rest of the build process yields to interleaving read and write operations. MongoDB ignores the background option if specified.
yopp
https://www.mongodb.com/docs/manual/core/index-creation/#monitor-in-progress-index-builds
здесь указано что прогресс можно отслеживать через currentOp
Viktar
Да. Я практикую такой способ. Но это дисковые операции и часто диск бутлнек для вставки. Практическим способом определил, на своих серверах, вставка без индекса большого массива данных(~12 Тб) занимает у меня без индекса около 30 часов. С индексом около 50.
Viktar
Если суммировать время вставки без индекса и создание индекса то те же 50 часов +-.
Alexandrr
Да. Я практикую такой способ. Но это дисковые операции и часто диск бутлнек для вставки. Практическим способом определил, на своих серверах, вставка без индекса большого массива данных(~12 Тб) занимает у меня без индекса около 30 часов. С индексом около 50.
ну у меня не 12 Тб)
но много записей, порядка 150 млн, но они лёгкие
Alexandrr
с версии 4.2, все индексы создаются асинхронного, по этому createIndex() вернёт ответ практически сразу, не ожидая завершения создания индекса
аааа, важное уточнение, не знал, благодарю
это скорее всего и будет решением
Viktar
ну у меня не 12 Тб)
но много записей, порядка 150 млн, но они лёгкие
Тогда этот вариант вам должен подойти
Alexandrr
Тогда этот вариант вам должен подойти
ну получается буду сразу создавать индекс, а потом наполнять коллекцию, будет немного дольше, но за то без ошибок