 Yury


Товарищи, подскажите, пожалуйста.
У меня есть коллекция posts, в которой хранятся статьи сайта.
Yury
Каждая статья может быть в двух или более языках.
Yury
Структура БД примерно такая:
_id:...
languages: {
ru: {title: string} (unique),
eng: {title: string} (unique)
}
Yury
Когда я вставляю первую статью только на русском языке, все норм
Yury
 Yury
Как я понял, у меня после вставки первой статьи на русском языке английский title равен null
Yury
И при вставке следующей статьи идёт ошибка, что статья с title null уже существует
Yury
Сразу скажу, что title должны быть уникальны в обоих переводах в любых статьях. Как-то можно это решить? Сказать, что null можно не считать дубликатом?
 Ilya
использовать частичный индекс
Ilya
https://www.mongodb.com/docs/v5.0/core/index-partial/#std-label-partial-index-with-unique-constraints
только в условии поменять допустим что тип равняется строке и тогда все null будут пропущены
Yury
 Глеб
Привет всем.
Подскажите что можно сделать с этим?
InitialSyncOplogSourceMissing: No valid sync source found in current replica set to do an initial sync
После этого демон соответственно падает и я не могу подключиться к монге.
 Dmitry
 Dmitry
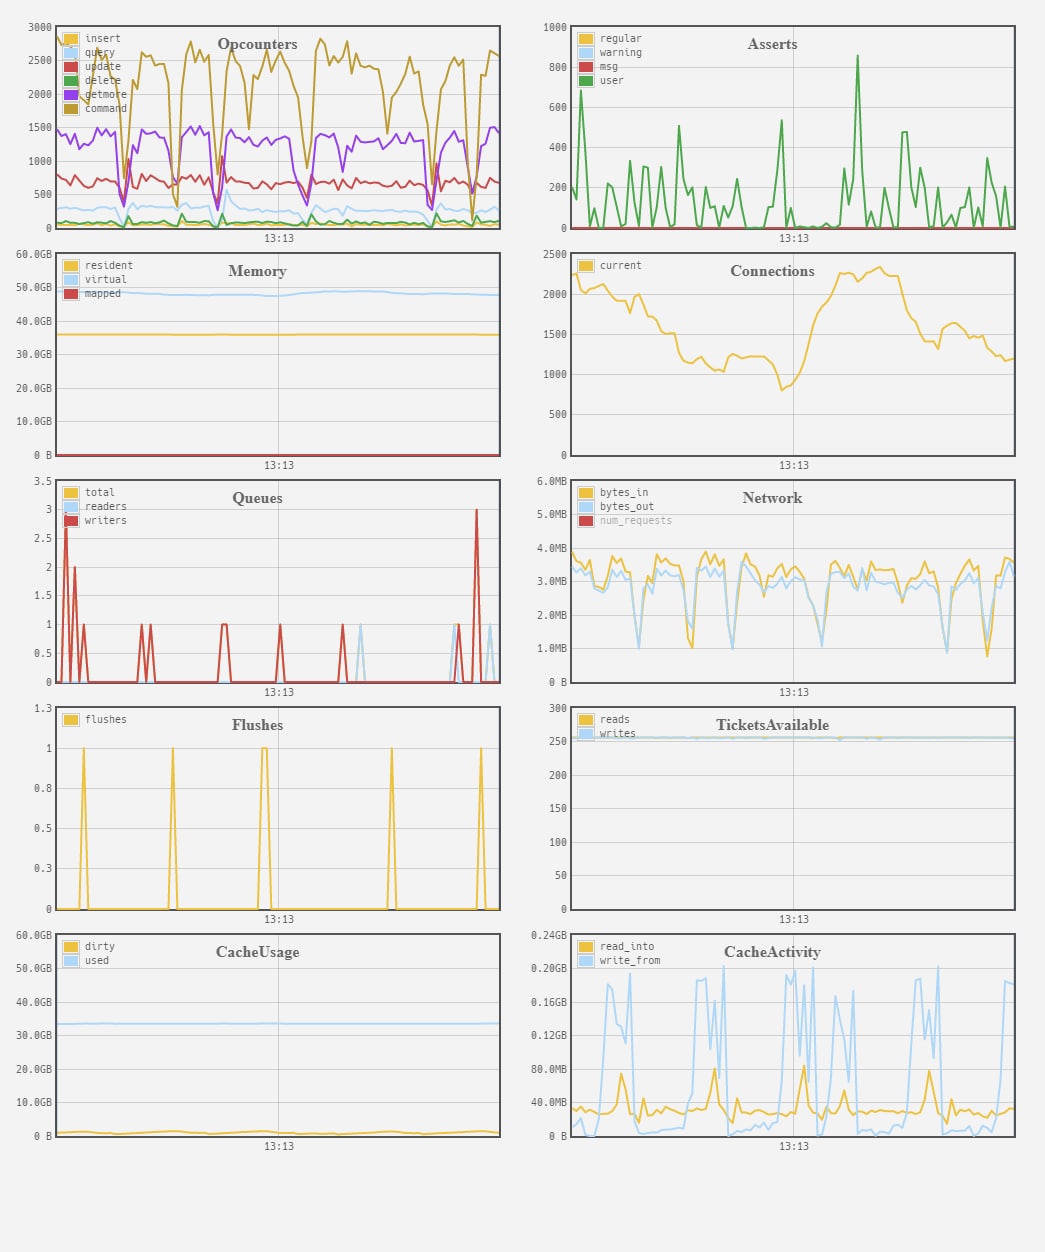
Пробовали играться с настройками для WiredTiger, в части снапшотинга, максимум что получилось это размазать создание снапшотов, что бы они делались чаще (на раз в минуту) но при этом занимали меньше времени
Dmitry
Может у кого есть мысли по этому поводу
Dmitry
версия монги 5
 Александр
Привет, подскажите, пожалуйста, методы интеграции данных из mongodb в elasticsearch. смотрел какие-то коннекторы, но многие устарели. остановился на интеграции с logstash. но, может, есть другие варианты, более лучшие?
 Yaroslav
Может у кого есть мысли по этому поводу
Слишком много записей в сек как по мне. Нужно повоерить current operations, проверить индексы или проставить там где необходимо. У studio 3t на сайте есть много туториалов по оптимизации монги, рекомендую!
Александр
Ты хочешь логи монги в elastic складывать?
нет, я хочу сделать поиск по документам. например, есть документ вида {_id, title, some other fields}. для реализации fulltext поиска, но по части слова, я бы складывал в эластик id и title. сам поиск был бы в эластике, который возвращал список найденных айди. со списком айди уже шел бы в монго.
Yaroslav
нет, я хочу сделать поиск по документам. например, есть документ вида {_id, title, some other fields}. для реализации fulltext поиска, но по части слова, я бы складывал в эластик id и title. сам поиск был бы в эластике, который возвращал список найденных айди. со списком айди уже шел бы в монго.
Я написал просой скрипт который по крону наполняет данные в эластик
Yaroslav
Это лучше всего, потому что с помощью api эластика ты контролируешь запись и можешь влиять на индекс более глубже
Dmitry
Слишком много записей в сек как по мне. Нужно повоерить current operations, проверить индексы или проставить там где необходимо. У studio 3t на сайте есть много туториалов по оптимизации монги, рекомендую!
ну ограничить запись мы не можем )) так падают запросы))
Индексы все необходимы есть, это в первую очередь проверили
Yaroslav
ну ограничить запись мы не можем )) так падают запросы))
Индексы все необходимы есть, это в первую очередь проверили
Возможно требует оптимизировать запросы и перейти к примеру на bulk operations
Yaroslav
Чисто делюсь своими кейсом если что))
Александр
Я написал просой скрипт который по крону наполняет данные в эластик
да, тоже можно, но, может, есть способ, чтобы как-то автоматизировать без участия скриптов.
просто хотелось бы для разных баз реализовать поиск, но тогда для каждой придется тратить время на реализацию своих скриптов. не сложно, конечно, но хотелось бы автоматизации
Yaroslav
да, тоже можно, но, может, есть способ, чтобы как-то автоматизировать без участия скриптов.
просто хотелось бы для разных баз реализовать поиск, но тогда для каждой придется тратить время на реализацию своих скриптов. не сложно, конечно, но хотелось бы автоматизации
Честно, даже не искал тут инструментов, я накидал скрипт за полчаса и все))
Александр
Честно, даже не искал тут инструментов, я накидал скрипт за полчаса и все))
да, скрипт можно сделать, но если их много будет, то что-то не айс
Yaroslav
да, скрипт можно сделать, но если их много будет, то что-то не айс
А зачем, скрипт 1 просто научи его работаь с разными коннектами
Александр
А зачем, скрипт 1 просто научи его работаь с разными коннектами
вдруг разные схемы будут. ну и не люблю все в один скрипт кидать. но да, без знания схем нет смысла говорить про количество скриптов
Yaroslav
И вот ещё кейс, не уверен, что у стороних решений для интеграции с elk есть возможность прописывать синонимы без лишних манипуляций. Пример, у тебя есть поле name и по нему ты хочешь нагенерить синонимов, для более глубокого и продуманного поиска
Александр
 A
2500 insert в сек. На xfs работа с снапшотами лучше... Профайлинг ещё включи с 0ms посмотри что логах будет
A
Но при такой записи удивляюсь что чтение не взлетает
A
Бд большие?
Dmitry
нет 100гб
A
Ну это не маленькие, а индексы?
Dmitry
2500 insert в сек. На xfs работа с снапшотами лучше... Профайлинг ещё включи с 0ms посмотри что логах будет
ну в тот то и прикол, что объёмы не огромные и не должно быть сними проблем
Dmitry
Ну это не маленькие, а индексы?
индексы все необходимы есть, есть пара "лишних", мы в процессе избавления от них
A
Ну не совсем. А как вообще с железом? Raid есть-ли контроллер? Какой iops
A
индексы все необходимы есть, есть пара "лишних", мы в процессе избавления от них
Я больше про их размеры
Dmitry
Я больше про их размеры
самая большая коллекция 45гб, 15 гб индексы, два из них по 7 гб от которых планируем избавиться как раз
A
Думаю после перехода на xfs проблема уйдет
Dmitry
Ну не совсем. А как вообще с железом? Raid есть-ли контроллер? Какой iops
по железу детально не скажу с ходу, надо запрашивать эти данные
на диск приходится 4Kops
 Stan
Добрый вечер!
Подскажите пожалуйста.
Как быстрее писать?
Использую updateOne с upsert и в bulkWrite.
Монга в облаке яндекса, процессор грузит на 100%, а скорость записи 1 документ / 1,2 сек. Коллекция 2.8 млн документов
Ilya
Может индексов много?
Stan
getIndexes вернул один ..
 yopp
Добрый вечер!
Подскажите пожалуйста.
Как быстрее писать?
Использую updateOne с upsert и в bulkWrite.
Монга в облаке яндекса, процессор грузит на 100%, а скорость записи 1 документ / 1,2 сек. Коллекция 2.8 млн документов
скорее всего у вас выражение в update части не попадает под этот индекс
yopp
По этому вставка требует полного сканирования коллекци
Stan
скорее всего у вас выражение в update части не попадает под этот индекс
то есть нужно создать индекс с этими полями?
yopp
то есть нужно создать индекс с этими полями?
да, так как при upsert монге нужно проверить есть ли документ с такими полями. если индекса нет, то проверка будет происходит читая все документы в коллекции
Stan
 oxxz
Здравствуйте решил подключить бд много, и сайт даже не регистрирует, и не заходит в sign up включение впн не помогает
oxxz
И вот вопрос если даже регнусь то к бд не подключиться?? Если сайт не работает в России
 Alexandrr
доброго дня всем
вопрос по деревьям.
нашёл часть ответов тут:
https://www.mongodb.com/docs/manual/applications/data-models-tree-structures/
так же тут:
https://www.mongodb.com/docs/manual/tutorial/model-tree-structures-with-materialized-paths/
мне подходит 2 вариант: "Структуры дерева моделей с материализованными путями", однако, в доке показан example с разделителями в виде "," запятой.
есть-ли вариант как-то это изменить (разделитель)?
и общий вопрос:
стоит-ли пользоваться этим дефолтным инструментом и подстраивать свою архитектуру под него, либо можно и свою реализацию написать?
какая необходима функциональность:
- у меня есть статьи (объекты данных с полями)
- каждая из статей расположена в какой то конечной точке иерархии
- каждая конечная точка иерархии может становиться НЕ конечной, то есть становиться вложенной
- при этом названия любой точки из иерархии могут меняться (не важно это конечная или вложенная структура)
подойдёт-ли "Структуры дерева моделей с материализованными путями"?
и какие могут быть подводные камни?
если какой-то инфы не хватает, дополню, пните
 Vladyslav
доброго дня всем
вопрос по деревьям.
нашёл часть ответов тут:
https://www.mongodb.com/docs/manual/applications/data-models-tree-structures/
так же тут:
https://www.mongodb.com/docs/manual/tutorial/model-tree-structures-with-materialized-paths/
мне подходит 2 вариант: "Структуры дерева моделей с материализованными путями", однако, в доке показан example с разделителями в виде "," запятой.
есть-ли вариант как-то это изменить (разделитель)?
и общий вопрос:
стоит-ли пользоваться этим дефолтным инструментом и подстраивать свою архитектуру под него, либо можно и свою реализацию написать?
какая необходима функциональность:
- у меня есть статьи (объекты данных с полями)
- каждая из статей расположена в какой то конечной точке иерархии
- каждая конечная точка иерархии может становиться НЕ конечной, то есть становиться вложенной
- при этом названия любой точки из иерархии могут меняться (не важно это конечная или вложенная структура)
подойдёт-ли "Структуры дерева моделей с материализованными путями"?
и какие могут быть подводные камни?
если какой-то инфы не хватает, дополню, пните
стоит-ли пользоваться этим дефолтным инструментом - я бы сказал он добавляет сложности только, плюсов никаких в статье не вижу.
Проще выглядит обычная реализация, пример: вам нужен Books.Programming.Language - то такое query и пишете, без всяких запятых, циферок и тд.
С того, как вы описали ваши модели - структура может быть довольно вложенная или наоборот довольно нуллабл - главное помнить, чтобы вложенность объектов не была выше 100эл суммарно.
Alexandrr
стоит-ли пользоваться этим дефолтным инструментом - я бы сказал он добавляет сложности только, плюсов никаких в статье не вижу.
Проще выглядит обычная реализация, пример: вам нужен Books.Programming.Language - то такое query и пишете, без всяких запятых, циферок и тд.
С того, как вы описали ваши модели - структура может быть довольно вложенная или наоборот довольно нуллабл - главное помнить, чтобы вложенность объектов не была выше 100эл суммарно.
да, со стандартами json, bson по вложенности знаком
благодарю за ответ
C
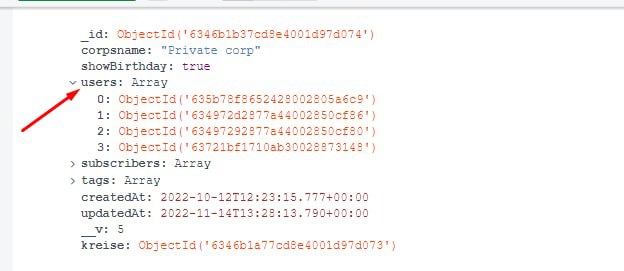
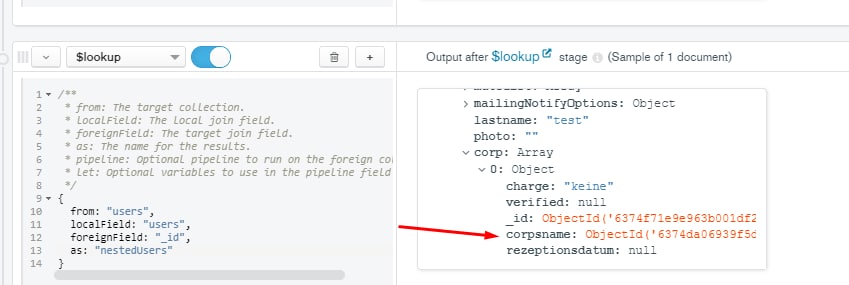
Может кто с вложенной агрегацией помочь? Не могу сообразить, как её сделать
C
 C
 C
Это уже выходит находится в nestedUsers.corp.corpsname, и его необходимо тоже запопулейтить, но у меня что-то не выходит с переменными поработать нормально
4R7
1. как подключить к нескольким базам монго одновременно ?
2. как юзать модели у определенной базы ?
4R7
хочу разные базы, для юзеров и токенов и для форумов и тд
 fλüggåɘnk∂€čhiœßøλ∫ên
хочу разные базы, для юзеров и токенов и для форумов и тд
Создай разные коллекции, зачем разные бд под это?
4R7
Создай разные коллекции, зачем разные бд под это?
мне нужна коллекция в коллекции, я так понимаю это проблема ?
4R7
база->коллекция(форумы)->коллекция(топик)->соообщения(документ)
fλüggåɘnk∂€čhiœßøλ∫ên
База ->
Коллекция 1
Коллекция 2
...
4R7
это получится полный треш тк у меня несколько сервисов
4R7
поэтому хочу в отдельную базу под каждый сервис выделить
fλüggåɘnk∂€čhiœßøλ∫ên
Я имею ввиду:
У тебя есть монга, там под разные сервисы бд со своими коллекциями
 📱DeltaDEV❄️ | iOS 10
можно ли это реализовать через монгу?
например у меня 123 людей в базе
нужно сделать топ 100 людей и отсортировать по значению
4R7
ну так я и испрашиваю, как подрубиться к разным базам и вызывать модели у разных баз =)
тк есть база юзеров и токенов
и есть база форумов
и есть база чатов
fλüggåɘnk∂€čhiœßøλ∫ên
https://www.mongodb.com/docs/manual/reference/method/connect/
Vladyslav
📱DeltaDEV❄️ | iOS 10
Можно, а в чем проблема?
я не знаю как, можно перебирать каждого человека, но это займет больше времени. например скл так умеет, а монга умеет?