 Dmitry


А вообще лучше в find закинь условие
 Hannibal
А раз его нет, а дальше только ожидание, то надо завернуть всё в скобки () и уже от них вызывать filter
Попробую, как дома буду. Благодарю 😊
Hannibal
А вообще лучше в find закинь условие
Ты был прав, весь геморр из-за неправильного использования метода
Leksey
если в цпу и диск не упирается, то значит проблема в запросах и возможности их параллелизации монгой (увы не все параллельно делается). Тут либо принудительно разбивать на разные коллекции/разные запросы для мержа результатов либо и вправду ехать на на что-то другое для работы аналитики. В целом монга под аналитику не самое лучшее решение, так что вы уперлись в ее пределы и нужен другой инстурмент)
ну вот да
здесь конечно и ко мне есть вопросы
может в аггрегациях что-то не так
может еще можно распараллелить (на уровне кода у меня)
какие варианты с другим инструментом есть?
(пока не совсем понимаю как правильно можно сделать)
можно ссылки / статьи / книги / прочее
Leksey
если в цпу и диск не упирается, то значит проблема в запросах и возможности их параллелизации монгой (увы не все параллельно делается). Тут либо принудительно разбивать на разные коллекции/разные запросы для мержа результатов либо и вправду ехать на на что-то другое для работы аналитики. В целом монга под аналитику не самое лучшее решение, так что вы уперлись в ее пределы и нужен другой инстурмент)
а как понимать "возможности их параллелизации монгой"?
в плане есть надстройки определенные?
или я не о том?
Leksey
а вот еще вопрос интересный
возможно есть какие-то решения не на уровне кода
у меня 100к промокодов (просто _id документов)
мне по каждому надо собрать данные из одной коллекции
как быть в данном случае?
у меня сейчас все на уровне кода решается
формально я запускаю 50/100 параллельных запросов к монге
тем самым обработка медленная
я могу сделать 100к одновременно, но результат плачевный
оптимальный вариант остается 50-100 параллельных запросов
как данный момент может решаться не на уровне кода?
я замерил все запросы - они все быстрые, но их 100к
по 50-100 параллельных запросов - занимает 20 секунд
хотелось бы как-то максимально быстро сделать
а-ля bulk read operations)))
есть какие-то варианты решений в данном случае?
Leksey
я выполняю 100к запросов к монге
50-100 запросов параллельно
результат - 20 секунд
за 20 секунд я получаю все данные по 100к документов
но и я понимаю, что 1 запрос - это 1-3ms
чисто в теории, если все правильно сделать параллельно, то я должен получить результат по всем 100к документам от 1 до 3ms + отдельные накладные расходы (если будут)
вопрос как это можно сделать параллельно
пока я ничего не нагуглил даже
хотя ситуация рядовой кажется
Leksey
я тут уже 20 часов сижу, эксперементирую
буду рад если сообщат подскажет куда смотреть / что почитать
любые ключевые слова))
Roman
Подскажите как обычно id для обращения к конкретному документу в монго генерируются? При сохранении документа самим монго формируется _id. Его используют в качестве уникального значения или как-то по другому?
 ᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠ
Подскажите как обычно id для обращения к конкретному документу в монго генерируются? При сохранении документа самим монго формируется _id. Его используют в качестве уникального значения или как-то по другому?
Вообще по дефолту - само генерируется, в виде ObjectID.
А так, ты можешь сам задать любое значение, если тебя не устраивает стандартное
ᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠᅠ
Также присваиваешь кастомное значение к ключу _id
Dmitry
Подскажите как обычно id для обращения к конкретному документу в монго генерируются? При сохранении документа самим монго формируется _id. Его используют в качестве уникального значения или как-то по другому?
Соглашусь с тем, что выше написали, но его лучше оставить ObjectId т.к. там timestamp защит + мб ещё что-то.
spectrum
 Dmitry
spectrum
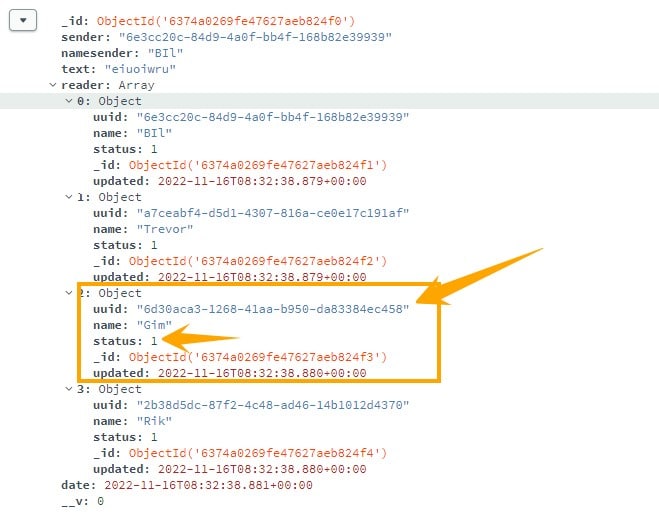
updateOne({"render.uuid": "6d..."}, {$set: {status: 2}})
А если нужно именно внутри данного головного документа вложенный документ изменить, правильно будет такое условие использовать: updateOne({"_id":"6374a...", "render.uuid": "6d..."}, {$set: {status: 2}}) ?
Roman
 Dmitry
А всё
Dmitry
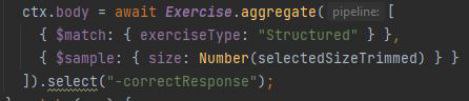
Метод select не доступен у aggregation
spectrum
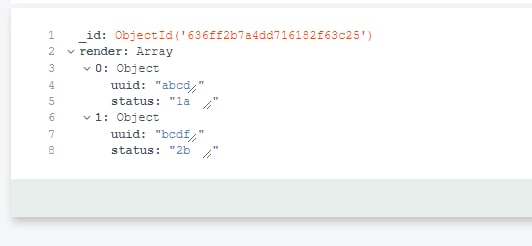
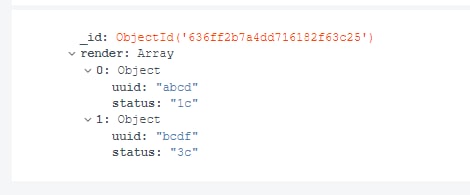
updateOne({"render.uuid": "6d..."}, {$set: {status: 2}})
В чем может быть проблема? запрос выполняется, но возвращает "acknowledged":false, если запрос сменить на findOneAndUpdate, то возвращается документ, но поле status также не изменяется.
 Taras Kosyi (ง•̀o•́)ง
В результате моих пайплайнов приходит такой массив: [ { totalUsers: 12, users: […]} ]. Есть какойто стейт типа $unwined, чтобы пришел обычный объект?
Dmitry
Dmitry
В базе нет никаких изменений, смотрю напрямую
 Nick
В результате моих пайплайнов приходит такой массив: [ { totalUsers: 12, users: […]} ]. Есть какойто стейт типа $unwined, чтобы пришел обычный объект?
массив возвращается, потому что это результат работы пайплайна - массив доков. Дальше в коде вытащите первый док
Nick
я выполняю 100к запросов к монге
50-100 запросов параллельно
результат - 20 секунд
за 20 секунд я получаю все данные по 100к документов
но и я понимаю, что 1 запрос - это 1-3ms
чисто в теории, если все правильно сделать параллельно, то я должен получить результат по всем 100к документам от 1 до 3ms + отдельные накладные расходы (если будут)
вопрос как это можно сделать параллельно
пока я ничего не нагуглил даже
хотя ситуация рядовой кажется
а вам реально надо быстрее 20 секунд? какие требования, а не хотелки?
Leksey
Собрать данные, что имеется ввиду?
формально:
const promo_ids = ['1', '2', '3', '4', etc.]; // понятно что здесь objectid и их 100к
далее promo.findOne({ _id }) по всем 100к документов
 Vladyslav
формально:
const promo_ids = ['1', '2', '3', '4', etc.]; // понятно что здесь objectid и их 100к
далее promo.findOne({ _id }) по всем 100к документов
так, а что делаете, обьясните простыми словами
Leksey
так, а что делаете, обьясните простыми словами
есть промокоды
есть с ними связанные данные по id
связанные данные - не могу сказать что за данные
приходит таск - вот тебе 100к ид промокодов
давай по каждому данные и как можно скорее
Vladyslav
есть промокоды
есть с ними связанные данные по id
связанные данные - не могу сказать что за данные
приходит таск - вот тебе 100к ид промокодов
давай по каждому данные и как можно скорее
может вам нужен процесинг батчами?
без полной картины сложно сказать
Nick
есть промокоды
есть с ними связанные данные по id
связанные данные - не могу сказать что за данные
приходит таск - вот тебе 100к ид промокодов
давай по каждому данные и как можно скорее
и где здесь требование к скорости быстрее 20 секунд? "как можно скорее" вполне себе укладывается
Nick
не стоит глупо выполнять хотелки манагеров и продактов про "хотим супер быстро", нужно собирать требования в цифрах и обоснования почему они такие. Потом говорить этим людям - решение с такими параметрам будет стоить Xтыщ баксов в месяц для этой таски, которая работает секунду, но потом час все железо просто стоит без работы
Leksey
может вам нужен процесинг батчами?
без полной картины сложно сказать
я попробую чуть больше инфы предоставить
есть промокод - promocode
в другой коллекции X есть определенные данные по промокодам, структура, примерно:
{
promocodeId,
...etc.
}
далее есть колллекция Y, где есть данные по каждой X, структура, примерно:
{
xId
etc.
}
логика примерно следующая
1) промокод ид от пользователя: 1
2) получили все ids из коллекции X
3) по каждому полученному xIds получили данные из коллекции Y
4) выполнили какие-то действия
в пункт 2 мы получили примерно 100к ids (дальше будет больше)
и тащим по каждому id из коллекции Y данные
данных много в Y
пытался ранее чуть проще рассказать о проблеме
Leksey
и где здесь требование к скорости быстрее 20 секунд? "как можно скорее" вполне себе укладывается
здесь масса проблем в совокупности
таких запросов много
и много промокодов с данными
Leksey
не стоит глупо выполнять хотелки манагеров и продактов про "хотим супер быстро", нужно собирать требования в цифрах и обоснования почему они такие. Потом говорить этим людям - решение с такими параметрам будет стоить Xтыщ баксов в месяц для этой таски, которая работает секунду, но потом час все железо просто стоит без работы
я как раз разбираюсь в этом моменте))
Leksey
так агргеация и $lookup для связывания
каким образом?
аггрегация от Y?
т.е. у нас нет матчинга первично
мы просто по нашим миллиардам делаем lookup?)
или я не понял?
Nick
каким образом?
аггрегация от Y?
т.е. у нас нет матчинга первично
мы просто по нашим миллиардам делаем lookup?)
или я не понял?
шаги 1 и 2 увязываются как минимум в один лукап, дальше при необходимости фильтрация и возможно преобразования
Leksey
шаги 1 и 2 увязываются как минимум в один лукап, дальше при необходимости фильтрация и возможно преобразования
шаг 1 и 2 - быстрые максимально
ids получаем от коллекции X максимально быстро
главная загвоздка потом - получить данные из коллекции Y
но возможно я вас не так понял
Nick
шаг 1 и 2 - быстрые максимально
ids получаем от коллекции X максимально быстро
главная загвоздка потом - получить данные из коллекции Y
но возможно я вас не так понял
покажите просто запросы который вы делаете
Leksey
покажите просто запросы который вы делаете
const { id } = bodyRequest; // получили запрос от юзера с id (промокод ид)
const xIds = await X.find({ promocodeId: id }, { _id: 1 }); // получили все ids из коллекции X
далее по каждому xId выполняем следующее:
const result = await Y.find({ xId, status: 1 });
формально, псевдо-код:
const Y = await Promise.all(xIds.map(xId => {
const result = await Y.find({ xId, status: 1 });
etc. (еще логика без запросов)
}));
в моем случае Promise.all параллельно запускает 50-100 запросов
Nick
const { id } = bodyRequest; // получили запрос от юзера с id (промокод ид)
const xIds = await X.find({ promocodeId: id }, { _id: 1 }); // получили все ids из коллекции X
далее по каждому xId выполняем следующее:
const result = await Y.find({ xId, status: 1 });
формально, псевдо-код:
const Y = await Promise.all(xIds.map(xId => {
const result = await Y.find({ xId, status: 1 });
etc. (еще логика без запросов)
}));
в моем случае Promise.all параллельно запускает 50-100 запросов
вам точно нужна агрегация и лукап https://www.mongodb.com/docs/manual/reference/operator/aggregation/lookup/
Leksey
вам точно нужна агрегация и лукап https://www.mongodb.com/docs/manual/reference/operator/aggregation/lookup/
аггрегация и лукап - активно использую
но здесь я вас точно не понимаю
аггрегация по Y должна быть?
я себе это слабо представляю
я сейчас подумаю
Nick
аггрегация и лукап - активно использую
но здесь я вас точно не понимаю
аггрегация по Y должна быть?
я себе это слабо представляю
я сейчас подумаю
агргеация тут просто должна быть, как вы будете работать с результатом значения не имеет, поулчите json и просто работайте с ним
Leksey
агргеация тут просто должна быть, как вы будете работать с результатом значения не имеет, поулчите json и просто работайте с ним
я не могу сделать агрегацию по Y
lookup сработает, но база лопнет
Nick
я не могу сделать агрегацию по Y
lookup сработает, но база лопнет
а зачем по Y?
X.agregate([
$lookup:{
from: Y
}
])
Nick
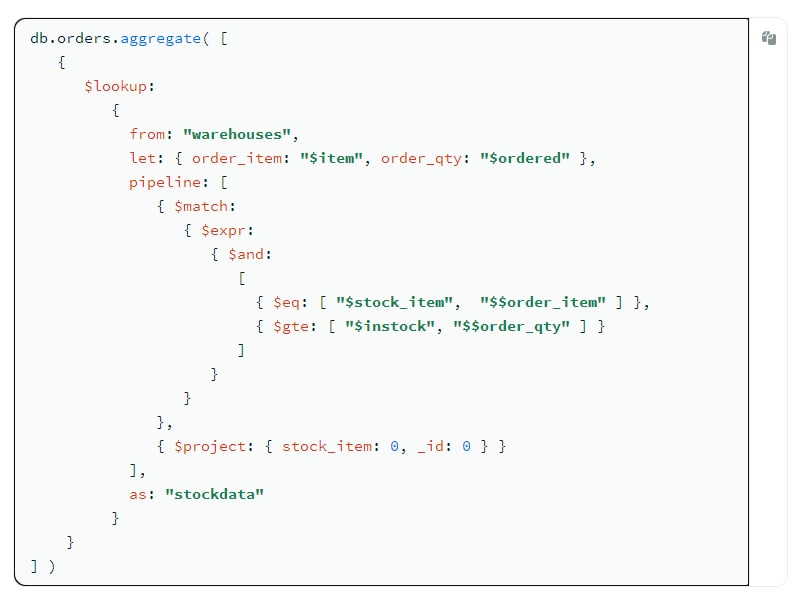
матч секция будет по данным из X для первичной фильтрации. Потом связывание. Потом уже возможно доп фильтрация.
Dmitry
матч секция будет по данным из X для первичной фильтрации. Потом связывание. Потом уже возможно доп фильтрация.
 Leksey
X.aggregate([
{
$match: {
promocode: id // матчим по X (промокод ид, полученный от юзера)
}
},
{
$project: {
xId: "$_id" // для удобства
}
}
{
$lookup: {
from: 'Y', // коллекция Y
localField: 'xId', // локальный ключ - xId, полученный с $project (выше)
foreignField: '_id', // ключ в коллекции Y
as: 'dataY'
}
},
{ unwind: '$dataY' },
{
$project: {
dataFromY: {
status: "$dataY.status",
etc.
}
}
},
{
$match: {
'dataFromY.status': 1
}
}
])
Leksey
странно
не понимаю почему я тогда раньше не догадался
что-то смущало кажется
Leksey
пошел проверять)))
@yatoba спасибо за подсказку
Leksey
Leksey
а зачем по Y?
X.agregate([
$lookup:{
from: Y
}
])
слушайте
сработало))
скоро будут тесты в продакшене среде
но предполагаю что результат будет положительным
Leksey
а зачем по Y?
X.agregate([
$lookup:{
from: Y
}
])
не
не сработало
вышли за 20 секунд
я бы даже сказал за 10 минут
Leksey
показывайте пайплайн
X.aggregate([
{
$match: {
promocodeId: id
}
},
{
$project: {
_id: 0,
xId: '$_id'
}
},
{
$lookup: {
from: 'Y',
let: { xId: '$xId' },
pipeline: [
{
$match: {
$and: [
{ $expr: { $eq: ['$$xId', '$xId'] } },
{ status: { $eq: 1 } }
]
}
},
{ $sort: { _id: 1 } },
{ $limit: 1 },
{
$match: {
ts: { $gte: start, $lt: end }
}
},
{
$project: {
_id: 0,
yId: '$_id'
}
}
],
as: 'dataY'
}
}])
Nick
X.aggregate([
{
$match: {
promocodeId: id
}
},
{
$project: {
_id: 0,
xId: '$_id'
}
},
{
$lookup: {
from: 'Y',
let: { xId: '$xId' },
pipeline: [
{
$match: {
$and: [
{ $expr: { $eq: ['$$xId', '$xId'] } },
{ status: { $eq: 1 } }
]
}
},
{ $sort: { _id: 1 } },
{ $limit: 1 },
{
$match: {
ts: { $gte: start, $lt: end }
}
},
{
$project: {
_id: 0,
yId: '$_id'
}
}
],
as: 'dataY'
}
}])
почему {
$match: {
ts: { $gte: start, $lt: end }
}
после limit?
и сразу, есть ли индекс по _id+status в Y?
Leksey
почему {
$match: {
ts: { $gte: start, $lt: end }
}
после limit?
и сразу, есть ли индекс по _id+status в Y?
здесь бизнесовая задача
все корректно
Leksey
почему {
$match: {
ts: { $gte: start, $lt: end }
}
после limit?
и сразу, есть ли индекс по _id+status в Y?
компаунд индекса нет такого
_id: 1, status: 1
есть раздельные
_id по дефолту есть
status: 1 также есть
Nick
компаунд индекса нет такого
_id: 1, status: 1
есть раздельные
_id по дефолту есть
status: 1 также есть
имелся ввиду xId, т.к. у вас он используется в матче
{ $expr: { $eq: ['$$xId', '$xId'] } },
{ status: { $eq: 1 } }
индекс xId-status
Leksey
Leksey
компаунд есть
xId: 1, status: 1
Nick
компаунд есть
xId: 1, status: 1
а сортировка точно по _id тогда должна быть?
{ $sort: { _id: 1 } },
Leksey
тогда возвращайтесь на первый вариант, нормально такие запросы работать не будут
пришел к этому же выводу
в текущем запросе лукапиться может 1 миллион документов))
хотя нужен по факту 1 документ по определенным критериям
Leksey
вообщем ладно
буду думать в сторону кастомизации своего первого варианта
попробую может через батчинг (хотя не понимаю как если только не так xId: { $in: [100k ids] }
в доке не советую вроде так делать
Nick
если есть возможнсть внести promocodeId в Y то все упростится и можно будет и индексы заюзать
Leksey
если есть возможнсть внести promocodeId в Y то все упростится и можно будет и индексы заюзать
да
но это каюк (миграция по терабайту и сбор данных)
данных терабайт
+ данные динамическими могут быть
сегодня должен быть xId у Y документа, а завтра нет