Есть проблема с поиском по числам:
Есть структура: Items - array, в нем Discounts - array, в нем 2 свойства Type, Value.
если искать find('Items.Discounts.Type': 'abc') - то получаю результаты, а вот если по Value, то не получаю уже никаких.
Думаю проблема в типе number и по нему нужно как-то другому искать??
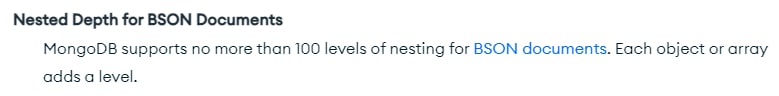
Не по теме, но с такой реализацией далеко не уехать т.к. у монги ограничение на вложенность есть. Любое элемент / объект и т.д. это -1 к вложенности
 Dmitry


 Vladyslav
Не по теме, но с такой реализацией далеко не уехать т.к. у монги ограничение на вложенность есть. Любое элемент / объект и т.д. это -1 к вложенности
NumberDecimal нужно использовать для поиска по таким полям)
Dmitry
NumberDecimal нужно использовать для поиска по таким полям)
Суть не в этом, а в том что сильно много объектов вы не вставите в свой массив
Vladyslav
Суть не в этом, а в том что сильно много объектов вы не вставите в свой массив
Вы о чем? у меня проблем нету
Vladyslav
Мда, это совет на будущие т.к. сразу написал, что не по теме
не понимю, в чем совет?
уменя полно мест где массив, в массиве и тд по N вложеностей и все ок
 Alexandrr
Есть проблема с поиском по числам:
Есть структура: Items - array, в нем Discounts - array, в нем 2 свойства Type, Value.
если искать find('Items.Discounts.Type': 'abc') - то получаю результаты, а вот если по Value, то не получаю уже никаких.
Думаю проблема в типе number и по нему нужно как-то другому искать??
у каждого поля должен быть ключ, если хотите искать по значениям, делайте к нему ключ, либо ищите по вложенным объектам.индексу
Dmitry
Vladyslav
у каждого поля должен быть ключ, если хотите искать по значениям, делайте к нему ключ, либо ищите по вложенным объектам.индексу
ответ очень прост: для decimal -для поиска нужно использовать NumberDecimal, простой find 'prop': 'value' не будет работать
Vladyslav
 Alexandrr
ответ очень прост: для decimal -для поиска нужно использовать NumberDecimal, простой find 'prop': 'value' не будет работать
зачем тут вопрошать тогда, если ответ прост?
 (в отпуске) Alexandr
Это полный цикл? Напишите от куда именно вы начинаете изменять и где заканчиваете
Могу код показать. Удобно будет посмотреть?
Nan0
Всем привет, ребята🖐
Подскажите, пожалуйста, по такому вопросу:
У меня есть 2 коллекции в MongoDB: Account, Information.
Account:
{
"_id": {
"$oid": "6348dc197a7b552660170d8b"
},
"username": "12345",
"password": "123dsgfdsgdfsg",
"email": "1243",
"role": "123",
"_infoid": {
"$oid": "6348dc197a7b552660170d8a"
}
}
и соответственно Information:
{
"_id": {
"$oid": "6348dc197a7b552660170d8a"
},
"avatar": "hello",
"name": "Abcd",
"phonenumber": "012345678",
"address": "abcd"
}
Я хочу изменить "phonenumber" на "123", но у меня есть только "_id" Account-a. Могу ли я изменить это с помощью aggregation pipeline?
Alexandrr
yep
 Тим
Ребят что можно сделать? поле сделал уникольным в модуле, но теперь надо что бы она было не уникальным, исправил в модуле, но все равно идет проверка на уникальность
 yopp
Ребят что можно сделать? поле сделал уникольным в модуле, но теперь надо что бы она было не уникальным, исправил в модуле, но все равно идет проверка на уникальность
Скорее всего у вас есть индекс по этому полю в самой монге
Вам нужно его удалить:
https://www.mongodb.com/docs/manual/tutorial/manage-indexes/
Тим
yopp
С помощью $ оператора:
https://www.mongodb.com/docs/manual/reference/operator/update/positional/#update-documents-in-an-array
 Arthur
всем привет. в монге относительно новичок, посему такой вопрос: как можно аггрегировать данные по определенным временным интервалам, к-ые начинаются с сего дня ?
условно, есть 4 вида группировки
- неделя
- месяц
- год
- все время
везде группировка не по календарному дню / месяцу / году, а начиная с текущего дня (включительно). и вот стоит задача разбить данные в каждом типе группировки на равные интервалы
для недели — по дню (7 дней от текущего)
для месяца — по неделе (4 недели с текущего дня)
для года — по месяцу (12 месяцев с текущего дня)
для N лет — по году с текущего дня
данные вида
{id, date, ...otherFields}
вопрос заключается в том, как в aggregation пайплайне нарезать данные на такие вот кастомные слайсы, саму агрегацию я как-нить сам докручу. спасибо всем, кто откликнется )
Arthur
кажется, есть мысль добавлять оффсет к дате в виде кол-ва дней (для недели — кол-во дней от начала недели, для месяца — кол-во дней от начала месяца и тд). но не уверен, насколько хорошо это будет работать
Arthur
либо 2 вариант обычный find с $gte
вопрос не в поиске данных в диапазоне, а группировке данных внутри диапазона по неделе / месяцу / году-ам от текущей даты юзера. кажется, вариант с оффсетом должен помочь, попробую проверить, как дойду до компа
 Yaroslav
Vladyslav
вопрос не в поиске данных в диапазоне, а группировке данных внутри диапазона по неделе / месяцу / году-ам от текущей даты юзера. кажется, вариант с оффсетом должен помочь, попробую проверить, как дойду до компа
вот как раз ваши "для .."
и делаются обычным find + gte, lte
Arthur
вот как раз ваши "для .."
и делаются обычным find + gte, lte
кажется, я плохо сформулировал задачу )
есть сиквенс данных формата [{id, date, ...}, {id, date, ...}, {id, date, ...}]
нужно
1) фильтрануть данные по нужному мне интервалу (это очевидно, как сделать, как раз через find + lte / gte)
2) по отфильтрованным данным сделать группировку и агрегацию по промежуткам. условно, groupBy isoWeek, но мне нужен не isoWeek / month/ etc, а текущая дата юзера. т.е. isoWeek нарежет мне данные за месяц на 4 недели календарные, с понедельника по воскресенье. мне же нужно нарезать с текущего дня + 7 дней назад. например, сегодня среда, значит мне нужно нарезать данные начиная со среды - 7 дней, потом среды - 14, среды - 21 и тд
Arthur
сейчас основная идея заключается в том, чтобы для дат в моем сиквенсе добавлять оффсет и уже группировать по isoWeek / month / year. но я пока не проверял, как это будет работать
Vladyslav
кажется, я плохо сформулировал задачу )
есть сиквенс данных формата [{id, date, ...}, {id, date, ...}, {id, date, ...}]
нужно
1) фильтрануть данные по нужному мне интервалу (это очевидно, как сделать, как раз через find + lte / gte)
2) по отфильтрованным данным сделать группировку и агрегацию по промежуткам. условно, groupBy isoWeek, но мне нужен не isoWeek / month/ etc, а текущая дата юзера. т.е. isoWeek нарежет мне данные за месяц на 4 недели календарные, с понедельника по воскресенье. мне же нужно нарезать с текущего дня + 7 дней назад. например, сегодня среда, значит мне нужно нарезать данные начиная со среды - 7 дней, потом среды - 14, среды - 21 и тд
сложно понять ваше "групировка", мне кажется это не то, что имеется ввиду.
группировка, это - показать сколько раз встерачется id и тд.
Ваша ж формулировка - чисто "разбитие" по рейнджу дат - не вижу самой группировки - по чем она должна быть или вам она вовсе и ненужна?
Arthur
сложно понять ваше "групировка", мне кажется это не то, что имеется ввиду.
группировка, это - показать сколько раз встерачется id и тд.
Ваша ж формулировка - чисто "разбитие" по рейнджу дат - не вижу самой группировки - по чем она должна быть или вам она вовсе и ненужна?
мне дальше нужно будет агрегировать вот эти нарезанные слайсы и показывать сумму / avg значений из этого слайса
т.е. если я выбираю
- недельный слайс, то нужно показать агрегацию значений за 7 дней начиная с текущего (на графике должно быть 7 баров)
- месячный слайс, то нужно показывать агрегацию значений за неделю, начиная с текущего дня (на графике должно быть 4 бара)
- годовой - значение за месяц (у нас усредненно 28 дней) начиная с текущего дня, на графике 12 баров
Dmitry
Не получится т.к. есть риски упереться в лимит на размер BSON
Vladyslav
мне дальше нужно будет агрегировать вот эти нарезанные слайсы и показывать сумму / avg значений из этого слайса
т.е. если я выбираю
- недельный слайс, то нужно показать агрегацию значений за 7 дней начиная с текущего (на графике должно быть 7 баров)
- месячный слайс, то нужно показывать агрегацию значений за неделю, начиная с текущего дня (на графике должно быть 4 бара)
- годовой - значение за месяц (у нас усредненно 28 дней) начиная с текущего дня, на графике 12 баров
вот тут совсем другой разговор)
Гляньте примеры:
https://www.mongodb.com/docs/manual/reference/operator/aggregation/sum/
Alexandrr
мне дальше нужно будет агрегировать вот эти нарезанные слайсы и показывать сумму / avg значений из этого слайса
т.е. если я выбираю
- недельный слайс, то нужно показать агрегацию значений за 7 дней начиная с текущего (на графике должно быть 7 баров)
- месячный слайс, то нужно показывать агрегацию значений за неделю, начиная с текущего дня (на графике должно быть 4 бара)
- годовой - значение за месяц (у нас усредненно 28 дней) начиная с текущего дня, на графике 12 баров
я бы вывод обрабатывал в приложении, а не пытался делать оверхард через СУБД, которая не для этого предназначена
Arthur
Не получится т.к. есть риски упереться в лимит на размер BSON
там данных не оч много. это статистические данные для конкретного юзера, за 5 лет будет штук 500 - 800 записей
Dmitry
там данных не оч много. это статистические данные для конкретного юзера, за 5 лет будет штук 500 - 800 записей
Один хрен не надо всё перекладывать на БД т.к. иногда на беке проще сделать, чем в агрегации крутиться и думать о лимитах
Vladyslav
я бы вывод обрабатывал в приложении, а не пытался делать оверхард через СУБД, которая не для этого предназначена
групировка - это обычная задача бд, какой оверхед?
Arthur
да кажется, что это простейшая задача для aggregation pipeline, вопрос просто в том, как считать не календарные значения, а от текущего дня
Vladyslav
Alexandrr
групировка - это обычная задача бд, какой оверхед?
группировка - это поиск по заданному условию, а не обработка и форматирование выводного результата
Vladyslav
match - это и есть ваш find
Arthur
смотри, как работает монга при группировке по неделе.
сегодня среда. юзер хочет посмотреть данные за неделю. при группировке по номеру календарной недели даты он получит данные только за 3 дня (пн-вт-ср). мне нужно, чтобы он получил данные за 7 (ср-вт-пн-вс-сб-пт-чт)
Vladyslav
группировка - это поиск по заданному условию, а не обработка и форматирование выводного результата
задайте себе вопрос: зачем вытаскивть всю бд, грузить ее на бек, чтобы сделать групировку, которая просто вернет avg.
Когда тоже самое может сделать бд, быстрее и получить сразу готовый результат
Vladyslav
плюс, увидим как вы это на беке будет делать на больших объёмах данных - никак
Vladyslav
смотри, как работает монга при группировке по неделе.
сегодня среда. юзер хочет посмотреть данные за неделю. при группировке по номеру календарной недели даты он получит данные только за 3 дня (пн-вт-ср). мне нужно, чтобы он получил данные за 7 (ср-вт-пн-вс-сб-пт-чт)
так ты в match и кидаешь ОТ - ДО, в чем проблема?
Arthur
так ты в match и кидаешь ОТ - ДО, в чем проблема?
как это будет работать в случае месяца / года ?) оно будет обрезать часть значений и не будет учитывать оффсет
Alexandrr
задайте себе вопрос: зачем вытаскивть всю бд, грузить ее на бек, чтобы сделать групировку, которая просто вернет avg.
Когда тоже самое может сделать бд, быстрее и получить сразу готовый результат
какую всю бд?
я написал такое? где?
сделать 4 операции внутри с возможностью упереться в bson, о котором выше написали идея для слабой реализации с критическими точками и низкой отказоустойчивостью
а вот вывести 4 нужных участка и разложить как нужно, переформатировать, это другое
Vladyslav
как это будет работать в случае месяца / года ?) оно будет обрезать часть значений и не будет учитывать оффсет
какой офсет? у вас в бд дата ж лежит
Vladyslav
я бы вывод обрабатывал в приложении, а не пытался делать оверхард через СУБД, которая не для этого предназначена
ну так прочтите еще раз, что написали.
Alexandrr
Один хрен не надо всё перекладывать на БД т.к. иногда на беке проще сделать, чем в агрегации крутиться и думать о лимитах
завязываю тоже с объяснениями 😁 не хочет человек слышать, ну и бог с ним
Arthur
какой офсет? у вас в бд дата ж лежит
ну вот смотри пример выше. у календарной недели есть номер от 0 до 53
считается она с пн по вс. сегодня среда, пользователь хочет посмотреть статистику за месяц, например, март.
что мне даст монга в аутпут:
3 дня от текущей недели (пн-ср)
7 дней от предыдущей недели (пн-вс)
7 дней от предыдущей - 1 недели (пн-вс)
7 дней от предыдущей - 2 недели (пн-вс)
что мне необходимо
7 дней от текущего дня (чт прошлой недели - ср текущей)
7 дней от предыдущей недели
7 дней от предыдущей недели
7 дней от предыдущей недели
Arthur
т.е. группировка просто по календарной неделе здесь не подходит
Arthur
кажется, что тут к датам нужно добавлять какое-то кол-во дней смещения, чтобы выровнять календарные неделю / месяц / год и получить нужный мне результат
Vladyslav
ну вот смотри пример выше. у календарной недели есть номер от 0 до 53
считается она с пн по вс. сегодня среда, пользователь хочет посмотреть статистику за месяц, например, март.
что мне даст монга в аутпут:
3 дня от текущей недели (пн-ср)
7 дней от предыдущей недели (пн-вс)
7 дней от предыдущей - 1 недели (пн-вс)
7 дней от предыдущей - 2 недели (пн-вс)
что мне необходимо
7 дней от текущего дня (чт прошлой недели - ср текущей)
7 дней от предыдущей недели
7 дней от предыдущей недели
7 дней от предыдущей недели
так и высылайте такие параметры в фильтрах, которые вам и нужны.
1 и 2 ваши примеры - вы сами шлете фильтра. попробуйте сделать и, думаю, вопросы все отпадут
Dmitry
ну вот смотри пример выше. у календарной недели есть номер от 0 до 53
считается она с пн по вс. сегодня среда, пользователь хочет посмотреть статистику за месяц, например, март.
что мне даст монга в аутпут:
3 дня от текущей недели (пн-ср)
7 дней от предыдущей недели (пн-вс)
7 дней от предыдущей - 1 недели (пн-вс)
7 дней от предыдущей - 2 недели (пн-вс)
что мне необходимо
7 дней от текущего дня (чт прошлой недели - ср текущей)
7 дней от предыдущей недели
7 дней от предыдущей недели
7 дней от предыдущей недели
{ "$group": { "_id": { "$week": { "$add": [ "$timestamp", 6*24*60*60000 ] } } } }
Dmitry
{ "$group": { "_id": { "$week": { "$add": [ "$timestamp", 6*24*60*60000 ] } } } }
За место 6 подставляй на сколько смещение сделать
Dmitry
Сегодня суббота, поэтому 6
Arthur
а так да, такая идея была. вот как раз до компа дошел, проверю щас
Arthur
Что один?
оффсет. не 6, а 1
мне же нужно текущую неделю выровнять, чтобы все дни, к-ые не влезли, попали в нее. т.е. offset = daysInWeek - currentDay
Arthur
ну и аналогично для месяца (кол-во дней в месяце - кол-во прошедших дней) и для года
Dmitry
оффсет. не 6, а 1
мне же нужно текущую неделю выровнять, чтобы все дни, к-ые не влезли, попали в нее. т.е. offset = daysInWeek - currentDay
Если ты хочешь получить с 9 по 15 | c 8 по 2 и т.д., то надо указать 6
Vlad
Здравствуйте есть юзеры и есть баланс юзера (очень много балансов) хранить это все в одной коллекции (инфа юзера, балансы) или вынести балансы в отдельную коллекцию?
Dmitry
Vlad
один юзер может иметь несколько валют к примеру
Dmitry
В отдельную тогда
Vlad
а как быть с атомарностью?
Vlad
транзакции?
Dmitry
Ну, сильно большой один документ хранить то же не ахти
Dmitry
Не важно SQL или NoSQL, надо строить с минимальной зависимостью, с имеющимся ограничениями и придерживаться хотя бы NF-3 (но не всегда)
Arthur
Если ты хочешь получить с 9 по 15 | c 8 по 2 и т.д., то надо указать 6
в общем, вот так смог получить то, что мне нужно
aggregate([
{
$group: {
_id: {
$isoWeek: {
date: { $dateAdd: { startDate: "$date", unit: "day", amount: 1 } },
},
},
distance: { $sum: "$distance" },
maxSpeed: { $max: "$maxSpeed" },
avgSpeed: { $avg: "$avgSpeed" }
},
},
{
$sort: { _id: -1 },
},
]);
всем спасибо за дискасс )
 Promise.all([🥚, 🥚,
Ну, сильно большой один документ хранить то же не ахти
А с чего вывод, что это множество валют = большое данные?