 Murad


Как думаете если я внутри lookup агрегации добавляю pipeline с $project, ускорит ли это работу или сделает хуже?
Murad
У меня есть чисто интуитивное ощущение что project в данном случае может даже хуже сделать
 Alexandrr
Как думаете если я внутри lookup агрегации добавляю pipeline с $project, ускорит ли это работу или сделает хуже?
зачем интуиция, когда есть дока?
 Nick
Как думаете если я внутри lookup агрегации добавляю pipeline с $project, ускорит ли это работу или сделает хуже?
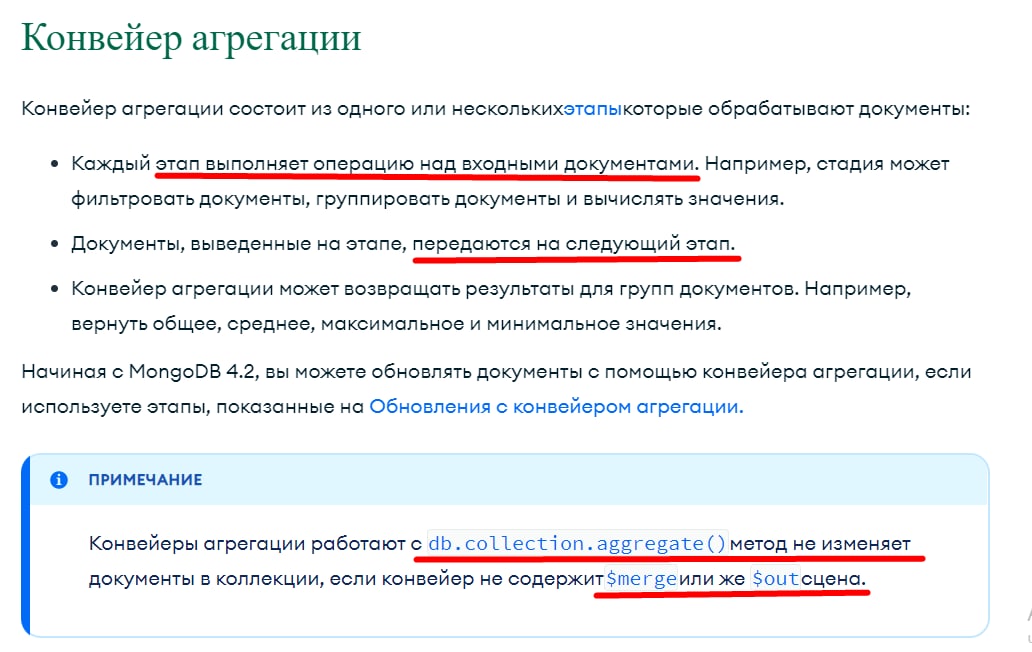
по сути как и в обычном пайплайне - в некоторых случаях project снижает объем памяти для последущих итераций и дает ускорение, в некоторых бесполезно добавляет лишний стейдж и замедляет работу, в некоторых планировщик просто его выкидывает изза оптимизаций - какой случай у вас выстрелит покажет только тестирваоине на ваших данных и на ожидаемых объемах (то что ускоряет на 10к начинает замедлять на 10кк и наоборот)
берем в руки explain и смотрим что будет
 Murad
Но в целом у меня разница была в 0.1 секунду
Murad
Думаю не такая существенная
Nick
ух, 0.1 секунда как же по разному может быть интерпретирована) для когото лишние 10мс уже катастрофа))
Alexandrr
ух, 0.1 секунда как же по разному может быть интерпретирована) для когото лишние 10мс уже катастрофа))
верно, дополню - при умножении на 100к запросов, это уже существенное процессорное время или дисковое
 Глеб
Привет всем!
Можно ли как - то вытащить пароль от юзера в mongo?
 Alexander
Всем привет!
Alexander
Нужна помощь в какую сторону думать
Alexander
Есть база данных 250Гб,
переодически сервер по CPU вываливает в 100%,
в основном когда идут операции insert и/или update
когда нет операция CPU ~30%
Document Query Executor ~ 1,5 Mil
Document Operation ~60K
В какую сторону смотреть шардирование или кластер с разнесением write/read операции?
Alexandrr
Есть база данных 250Гб,
переодически сервер по CPU вываливает в 100%,
в основном когда идут операции insert и/или update
когда нет операция CPU ~30%
Document Query Executor ~ 1,5 Mil
Document Operation ~60K
В какую сторону смотреть шардирование или кластер с разнесением write/read операции?
посчитай относительно возможностей железа и операций/сек при операциях в среднем, от сюда установишь - разносить или шарды
 yopp
Есть база данных 250Гб,
переодически сервер по CPU вываливает в 100%,
в основном когда идут операции insert и/или update
когда нет операция CPU ~30%
Document Query Executor ~ 1,5 Mil
Document Operation ~60K
В какую сторону смотреть шардирование или кластер с разнесением write/read операции?
Посмотрите на профили запросов, возможно где-то мимо индекса запросы на update
Если у вас под монгой nvme, то посмотрите утилизацию полосы, если она не полностью используется, то посмотрите хватает ли read/write tickets
Alexander
Посмотрите на профили запросов, возможно где-то мимо индекса запросы на update
Если у вас под монгой nvme, то посмотрите утилизацию полосы, если она не полностью используется, то посмотрите хватает ли read/write tickets
хватает ли read/write. Да! по профилю запросов посмотрю, хорошая идея
 Yaroslav
хватает ли read/write. Да! по профилю запросов посмотрю, хорошая идея
https://studio3t.com/knowledge-base/articles/optimize-mongodb-queries/
Yaroslav
Я по их гайдам оптимизацию делал, вообще самые толковые ребята!
Alexander
посчитай относительно возможностей железа и операций/сек при операциях в среднем, от сюда установишь - разносить или шарды
Средняя загрузке по железу 40%, в нормальном режиме всего хватает с большим запасом, возможно вариант программно затормозить update и insert, но выглядит очень колхозом...
Alexandrr
Средняя загрузке по железу 40%, в нормальном режиме всего хватает с большим запасом, возможно вариант программно затормозить update и insert, но выглядит очень колхозом...
тогда смотрите сюда, тут всё верно написали
https://t.me/mongodb_ru/117874
склоняюсь к 1 пункту - запросы мимо индекса идут
Yaroslav
Пароли хранятся в шифрованом виде, только если заменить их
Yaroslav
Средняя загрузке по железу 40%, в нормальном режиме всего хватает с большим запасом, возможно вариант программно затормозить update и insert, но выглядит очень колхозом...
Возможно тебе стоит использовать bulk operations
Yaroslav
Они взначительной степени оптимизированы под запись
Alexander
Они взначительной степени оптимизированы под запись
Да, спасибо. Я уточню, используем мы bulk operations сейчас. Но это по описанию не улучшит ситуацию в разы
 Viktar
Есть база данных 250Гб,
переодически сервер по CPU вываливает в 100%,
в основном когда идут операции insert и/или update
когда нет операция CPU ~30%
Document Query Executor ~ 1,5 Mil
Document Operation ~60K
В какую сторону смотреть шардирование или кластер с разнесением write/read операции?
Много cpu потребляет компрессия.
Alexander
Много cpu потребляет компрессия.
Возможно, потому, как видим некий отложенный эффект при массовом заполнении данных. По какой метрике можно посмотреть, сколько потребляет компрессия данных?
Yaroslav
Много cpu потребляет компрессия.
компрессия тупит из-за объема данных передаваемых по сети?
Yaroslav
Типа этого https://www.mongodb.com/developer/products/mongodb/mongodb-network-compression/?
Yaroslav
Просто интересный кейс) Жаль что у нас не такие. объемы(( было бы интересно в этом покопаться
Viktar
Возможно, потому, как видим некий отложенный эффект при массовом заполнении данных. По какой метрике можно посмотреть, сколько потребляет компрессия данных?
Тут вам не подскажу. Я разбирал компрессию в разрезе дискового пространства. У меня базы по 4-8 Тб
Alexander
компрессия тупит из-за объема данных передаваемых по сети?
Пока нет с сетью все хорошо! Сеть - это следующая проблема которая нас ждет, уже не в далеком будущем.
Alexander
Тут вам не подскажу. Я разбирал компрессию в разрезе дискового пространства. У меня базы по 4-8 Тб
Какое значение сжатия по умолчанию?
Alexandrr
Какое значение сжатия по умолчанию?
https://www.google.com/search?q=default+compression+mongodb
Alexander
https://www.google.com/search?q=default+compression+mongodb
Нашел вот что: storage.wiredTiger.engineConfig.zstdCompressionLevel
Type: integer
Default: 6
Specifies the level of compression applied when using the zstd compressor.
Values can range from 1 to 22.
The higher the specified value for zstdCompressionLevel the higher the compression which is applied.
Only applicable when
blockCompressor
is set to zstd.
Available starting in MongoDB 5.0
Alexandrr
Нашел вот что: storage.wiredTiger.engineConfig.zstdCompressionLevel
Type: integer
Default: 6
Specifies the level of compression applied when using the zstd compressor.
Values can range from 1 to 22.
The higher the specified value for zstdCompressionLevel the higher the compression which is applied.
Only applicable when
blockCompressor
is set to zstd.
Available starting in MongoDB 5.0
если хочешь максимально понимать как это всё работает - копай wiredTiger.engine - основы
lmn
https://www.mongodb.com/docs/manual/reference/log-messages/
lmn
https://www.mongodb.com/docs/manual/reference/log-messages/#mongodb-data-ACCESS
 Дмитрий
Зеркало Зеркало repo.mongodb.org доступное из СНГ не доступно. Кто-нибудь знает другие зеркала?
Yaroslav
Yaroslav
У них правда 4 версия
 Andrey
db.Place.find({})
Yaroslav
Надо поискать, я лично убунту люблю))
Yaroslav
Ну можно простецкий туннель сделать на забугорный сервак
 mfgskv ✙
всем привет, у меня такой кейс, надо внутри коллекции анкет у каждой анкеты хранить пользователей которые её просмотрели чтобы соответственно пользователям дубликаты не совать, этот массив обещает быть громадным, скажите - это не кейс для NoSQL, когда есть такого вида сложный поиск?
Viktar
всем привет, у меня такой кейс, надо внутри коллекции анкет у каждой анкеты хранить пользователей которые её просмотрели чтобы соответственно пользователям дубликаты не совать, этот массив обещает быть громадным, скажите - это не кейс для NoSQL, когда есть такого вида сложный поиск?
Насколько громадный? Размер документа не может быть больше 16мб. А так addToSet вам сможет помочь, при добавлении в массив, что бы не было дубликатов
 Игорь
всем привет, у меня такой кейс, надо внутри коллекции анкет у каждой анкеты хранить пользователей которые её просмотрели чтобы соответственно пользователям дубликаты не совать, этот массив обещает быть громадным, скажите - это не кейс для NoSQL, когда есть такого вида сложный поиск?
Как вариант можете сделать отдельной коллекцией. Один документ это один уникальный просмотр.
в документе будут поля Id документа, id пользователя, id анкеты.
Раз вам нужно не показывать дубликаты, то и индексы так проще будет построить.
Ну и в ограничение 16мб на документ не упрётесь
mfgskv ✙
Как вариант можете сделать отдельной коллекцией. Один документ это один уникальный просмотр.
в документе будут поля Id документа, id пользователя, id анкеты.
Раз вам нужно не показывать дубликаты, то и индексы так проще будет построить.
Ну и в ограничение 16мб на документ не упрётесь
так в таком случае надо будет делать иннер джоин(в монге?). При итерации по коллекции профилей надо будет идти в коллекцию просмотров и смотреть не просматривал ли этот пользователь этот профиль
mfgskv ✙
не думаю шо такое можно в монге сделать
mfgskv ✙
Насколько громадный? Размер документа не может быть больше 16мб. А так addToSet вам сможет помочь, при добавлении в массив, что бы не было дубликатов
я о том чтобы проверять какие пользователю профили подсовывать(проверять посмотрел ли пользователь этот профиль ранее)
Игорь
Может нужно у пользователя хранить список просмотренных, а к анкетам обращаться с условием не просмотренных?
Viktar
Как вариант можете сделать отдельной коллекцией. Один документ это один уникальный просмотр.
в документе будут поля Id документа, id пользователя, id анкеты.
Раз вам нужно не показывать дубликаты, то и индексы так проще будет построить.
Ну и в ограничение 16мб на документ не упрётесь
Это больше похоже на линковочную табличку из мира реляционок
Yaroslav
Абсолютно нормальное явление, но я бы сделал отделнеую коллекцию, как Вам подсказали выше, т.к. неудобно хранить в массиве большое количество данных
Yaroslav
Плюс можно записи сделать TTL index и без всяких кронов все будет чистить
Yaroslav
так в таком случае надо будет делать иннер джоин(в монге?). При итерации по коллекции профилей надо будет идти в коллекцию просмотров и смотреть не просматривал ли этот пользователь этот профиль
Делается обычный lookup, а итерацию чанковать. Т.е. выводить за раз не более 50 результатов, чтобы апишка не ахевала
 Дмитрий
Ага, ну всё понятно
Andrey
Посмотрите на профили запросов, возможно где-то мимо индекса запросы на update
Если у вас под монгой nvme, то посмотрите утилизацию полосы, если она не полностью используется, то посмотрите хватает ли read/write tickets
Если у вас под монгой nvme, то посмотрите утилизацию полосы, если она не полностью используется, то посмотрите хватает ли read/write tickets - подскажите где почитать или как посмотреть
Alexandrr
https://www.mongodb.com/docs/v4.2/reference/method/db.cloneCollection/
Nick
Если клон не подходит, то агрегация с $out стейджем
 chpotl.eth
 Nick
chpotl.eth
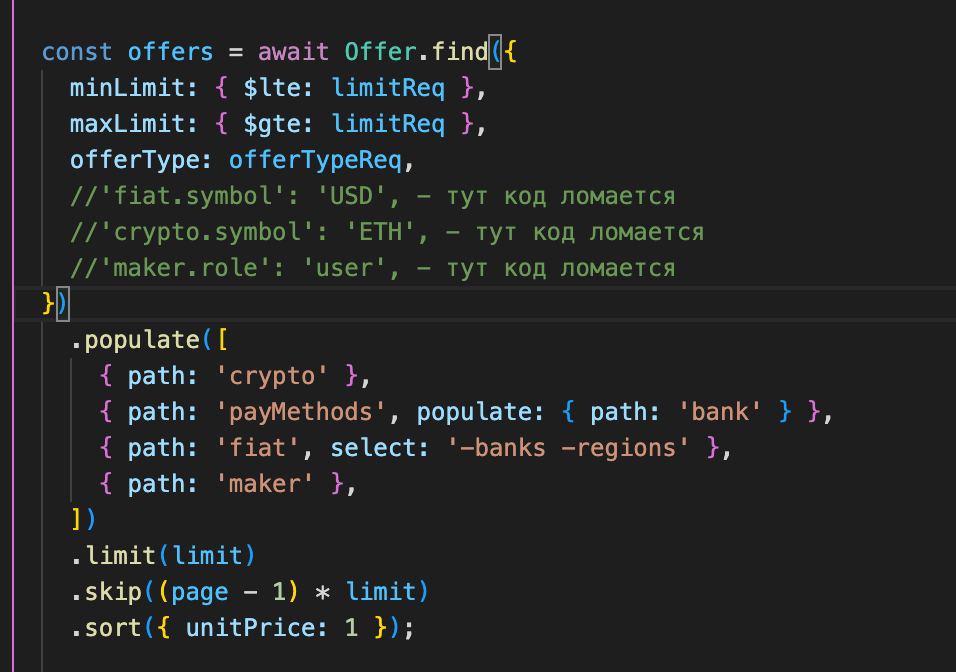
т.е. в поле fiat ссылка (id) на док в другой коллекции и вам надо свериться со значением с полем symbol там?
да, везде пишут, что можно match добавить в populate, но это только если одно поле. Я хочу условно сначала получить ответ со всеми ‘раскрытыми полями’, а потом отфильтровать.
chpotl.eth
или так нельзя?)
Nick
да, везде пишут, что можно match добавить в populate, но это только если одно поле. Я хочу условно сначала получить ответ со всеми ‘раскрытыми полями’, а потом отфильтровать.
специфика популейта в монгусе про то что именно подтянуть, т.е. матч который вы туда поместите никак не повлияет на исходную выборку. Если вам надо сделат ьсложную выборку с задействованием нескольких коллекций, то для этого нужно использовать агрегации, там опосредовано можно сформировать нужную выборку
Nick
проще можно - использовать в выборке идентификаторы и не лазить в связанные коллекции
 access_denied
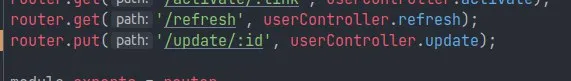 access_denied
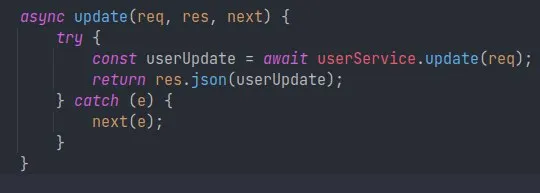 access_denied
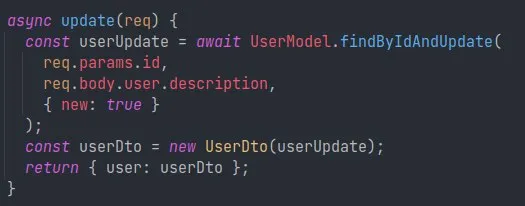 access_denied
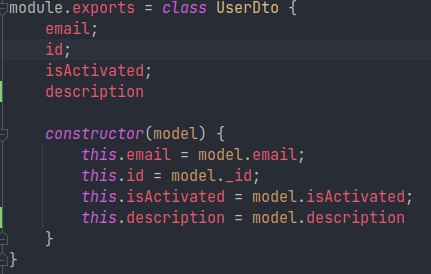 access_denied
 ᅠ ᅠ ᅠ ᅠ
Всем привет, ребята. Такой вопрос:
Я хочу добавить одно значение в кортеж из MongoDB. Ключ — это query, а переменная - position должна быть добавлена как consumer в кортеж со следующим кодом:
MongoCollection<Document> collection = ...
Bson filter = Filters.eq("query", queryName);
Bson update = Updates.addToSet("consumer", position);
collection.findOneAndUpdate(filter, update);
Однако, в базе данных, выглядит так, что список «consumer»: [NumberLong(88760)] был вставлен, а не одно значение, как показано в поле producer:
{ "_id" : ObjectId(...), "query" : "1000", "consumer" : [ NumberLong(88760) ], "producer" : NumberLong(88760) }
При использовании Update.push() тот же результат.
В связи с чем вопрос:
как можно добавить только одно значение, не имея его в виде списка?
.set() вместо .addToSet()
или есть ещё варианты?
Заранее благодарю за любую дельную информацию по данному вопросу.
Alexandrr
Всем привет, ребята. Такой вопрос:
Я хочу добавить одно значение в кортеж из MongoDB. Ключ — это query, а переменная - position должна быть добавлена как consumer в кортеж со следующим кодом:
MongoCollection<Document> collection = ...
Bson filter = Filters.eq("query", queryName);
Bson update = Updates.addToSet("consumer", position);
collection.findOneAndUpdate(filter, update);
Однако, в базе данных, выглядит так, что список «consumer»: [NumberLong(88760)] был вставлен, а не одно значение, как показано в поле producer:
{ "_id" : ObjectId(...), "query" : "1000", "consumer" : [ NumberLong(88760) ], "producer" : NumberLong(88760) }
При использовании Update.push() тот же результат.
В связи с чем вопрос:
как можно добавить только одно значение, не имея его в виде списка?
.set() вместо .addToSet()
или есть ещё варианты?
Заранее благодарю за любую дельную информацию по данному вопросу.
сталкивался с таким, когда надо было апдейтнуть только 1 объект из списка внутри, так писал:
.update_one({"_id": ObjectId(_id)}, {"$set": {"i.5": list[2]}})
где "i.5" - 5 индекс списка i
 (в отпуске) Alexandr
Добрый день.
Вопрос, безусловно, может показаться тупым, но гугл и чтение документации пока ни к чему не привёл.
Прошу оказать консультацию или даже ткнуть носом в ссылку. Буду благодарен.
Пишу небольшой микросервис на Go (вряд ли это важно).
Одна из функций подключается к AWS DocumentDB с TLS, подключается к нужной БД, создает документ в коллекции (JSON в BSON по сути) и возвращает ObjectID.
В общем-то простой функционал, но по времени это занимает примерно 2.5-4 секунды.
Подскажите, пожалуйста, где могут быть у меня слабые места?
Чего могу не учесть? Куда смотреть, чего читать?
Заранее спасибо.
 Vladyslav
Есть проблема с поиском по числам:
Есть структура: Items - array, в нем Discounts - array, в нем 2 свойства Type, Value.
если искать find('Items.Discounts.Type': 'abc') - то получаю результаты, а вот если по Value, то не получаю уже никаких.
Думаю проблема в типе number и по нему нужно как-то другому искать??
Dmitry
Добрый день.
Вопрос, безусловно, может показаться тупым, но гугл и чтение документации пока ни к чему не привёл.
Прошу оказать консультацию или даже ткнуть носом в ссылку. Буду благодарен.
Пишу небольшой микросервис на Go (вряд ли это важно).
Одна из функций подключается к AWS DocumentDB с TLS, подключается к нужной БД, создает документ в коллекции (JSON в BSON по сути) и возвращает ObjectID.
В общем-то простой функционал, но по времени это занимает примерно 2.5-4 секунды.
Подскажите, пожалуйста, где могут быть у меня слабые места?
Чего могу не учесть? Куда смотреть, чего читать?
Заранее спасибо.
Это полный цикл? Напишите от куда именно вы начинаете изменять и где заканчиваете