
 Nick


 Вячеслав
Тогда после переезда на локальные диски индексы будут в нормальном доступе (оперативы на четверть данных точно за глаза) и никаких переделок не потребуется. Если хочется монгу попробовать, то будет плюс минус также
у комьюнити версии никаких ограничений по размеру нет?
 Александр
 Anonymous
☺️
Александр
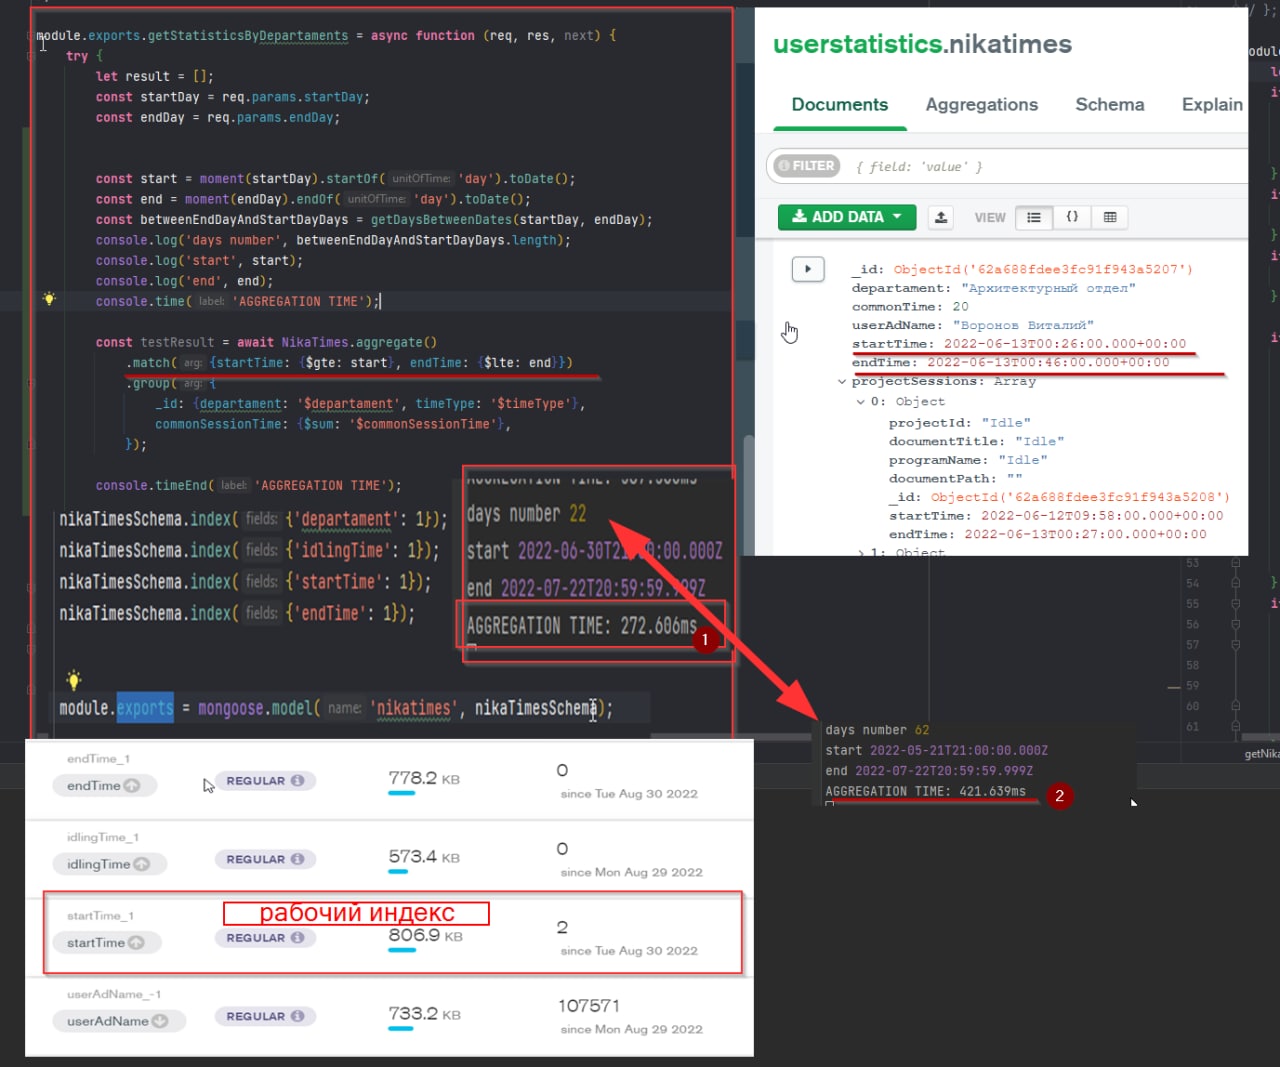
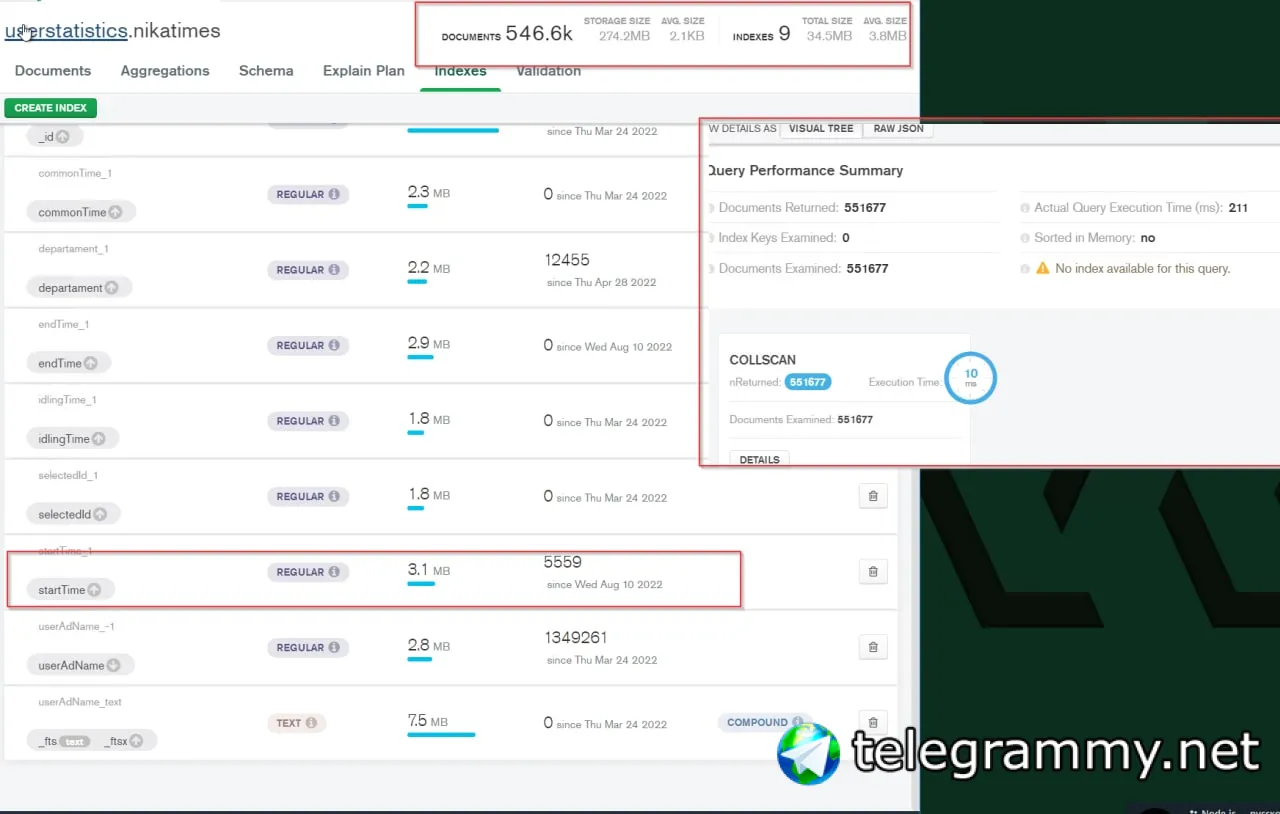
Кто может платную консультацию провести по агрегациям, индексам и оптимизации монги? Включая эти вопросы
Александр
 Александр
 first_name
Подскажите, нужно каждому пользователю разослать сообщение.
Я выполняю findAll, в итоге, по моим расчётам функция должна длиться как минимум час.
Но, она останавливается где-то и всё.
Это из-за неживучести сессии?
Как увеличить её долгую жизнь?
 Alaout
Подскажите как при наличии id получить индекс в агрегации?
Бд:
"user_id":"1",
"user_id":"2"
 Vladyslav
Nick
Подскажите, нужно каждому пользователю разослать сообщение.
Я выполняю findAll, в итоге, по моим расчётам функция должна длиться как минимум час.
Но, она останавливается где-то и всё.
Это из-за неживучести сессии?
Как увеличить её долгую жизнь?
Выбирайте либо в память во временный массив, либо пачками. Держать сессию час не комильфо
Nick
Подскажите как при наличии id получить индекс в агрегации?
Бд:
"user_id":"1",
"user_id":"2"
Что такое индекс в вашем вопросе?
Vladyslav
Я не уверен но подозреваю что в агрегации можно это сделать
опиши полностью то, что хочешь сделать
Nick
first_name
Выбирайте либо в память во временный массив, либо пачками. Держать сессию час не комильфо
А как пачками? Во время рассылки могут добавятся ещё пользователи.
Nick
А как пачками? Во время рассылки могут добавятся ещё пользователи.
Так вы же наверняка проставляете метку временнУю когда отправка была. Вот и выбирайте тех кому не доставлено и лимитом получайте пачку например по тыще
first_name
Так вы же наверняка проставляете метку временнУю когда отправка была. Вот и выбирайте тех кому не доставлено и лимитом получайте пачку например по тыще
У меня есть время регистрации пользователя (timestamp)
first_name
Как это можно использовать?
Nick
У меня есть время регистрации пользователя (timestamp)
А как вы решаете проблему повторной отправки писем?
first_name
А как вы решаете проблему повторной отправки писем?
Никак не решал. Я выполнял просто find({"alive": True})
first_name
Но при рассылке на 100к пользователей я заметил проблему
Nick
Никак не решал. Я выполнял просто find({"alive": True})
Пора озаботиться и добавить какието флаги и/или таймстемпы и начать работать с базой пачками
first_name
 vasyok28
Всем привет findOne({ email: dto.email }), как узазать какие поля нужно исключить. по типу exclude
 Харамбус
projection: { field: 0 }
 Нурлан
FindOne({email:dto.email},{username:-1})
Нурлан
Кажись так
Нурлан
find( { type: 'food' }, { type:0 } )
Нурлан
https://stackoverflow.com/questions/14559200/how-to-exclude-one-particular-field-from-a-collection-in-mongoose
Нурлан
//Return the User document without having password field
User.findOne({_id: userId}).select("-password")
//Incase wants to add excluded field
User.findOne({_id: userId}).select("+password")
 endlessNight
 Alaout
опиши полностью то, что хочешь сделать
У меня есть бд в которой хранятся айди юзеров, и прочая информация, у меня есть код который делает обычную агрегацию по убыванию, и он занимает ~1.5-2 секунд на пользователя при запросе, это происходит из-за того что я делаю это на маленьком сервере и средствами python'a, а я хочу попробовать получить индекс пользоватея по айди из агрегации, средствами монги

 Alex
Всем привет. Есть вопрос по локам в монге 4.4.15, может кто сталкивался с таким.
Есть условно два типа процессов, A и B. Процесс A время от времени вычитывает коллекцию полностью, процесс B читает и апдейтит один и только один конкретный док (какой именно - зависит от того, с какими параметрами запущен), апдейтит чаще, чем читает. Процессов типа B намного больше, чем процессов типа A, где-то 10х, всего процессов в разные моменты может быть около 700+.
Верно ли, что в такой ситуации можно ожидать, что операция вычитки всей коллекции будет тормозиться об множество операций записи в коллекцию и, условно, висеть в очереди монги, пока не выполнятся все поступившие ранее запросы на запись? Есть ли в монге какие-то встроенные средства дать больший приоритет вычитке? Сама коллекция небольшая, где-то 10 мб, вычитка производится довольно быстро. Буду благодарен за линки на доку, где что-нибудь подобное описано, читал вот это https://www.mongodb.com/docs/v4.4/faq/concurrency/, но подходящих ответов не нашел.
 𝕭𝖔𝖘𝖘 𝕮𝖆𝖙
Как получить ссылку на mongodb базу в power she’ll
 Yaroslav
У меня есть бд в которой хранятся айди юзеров, и прочая информация, у меня есть код который делает обычную агрегацию по убыванию, и он занимает ~1.5-2 секунд на пользователя при запросе, это происходит из-за того что я делаю это на маленьком сервере и средствами python'a, а я хочу попробовать получить индекс пользоватея по айди из агрегации, средствами монги
ну как пример, я не понимаю что ты агрегируешь, но как я бы сделал
есть документу User
db.collection('users').find().sort({_id: -1}) - забираю всех юзеров и сортирую decs по полю _id
Yaroslav
если тебе требуется преобраозование данных или видоизменить результат, то есть множество методов, к примеру
db.collection('users').find().map(item=> item.name) -   вернет масиив имен (если поле существует в документе User)
 of Astora 𒉭
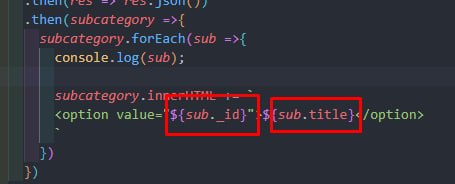
не подскажите как юзать ejs внутри js script?
of Astora 𒉭
 𝕭𝖔𝖘𝖘 𝕮𝖆𝖙
Netangels норм хостинг для js?
Alaout
ну как пример, я не понимаю что ты агрегируешь, но как я бы сделал
есть документу User
db.collection('users').find().sort({_id: -1}) - забираю всех юзеров и сортирую decs по полю _id
У меня почти такой же код, но я хочу чтобы find сразу возвращал позицию пользователя в агрегации по убыванию
Alex
Nick
Гляну, благодарю.
Также есть возможность сделать реплику и туда слать запросы на чтение, но в вашем случае это смысла не имеет, т.к. данных мало и запросов на чтение много меньше запросов обновления данных.
Alex
Также есть возможность сделать реплику и туда слать запросы на чтение, но в вашем случае это смысла не имеет, т.к. данных мало и запросов на чтение много меньше запросов обновления данных.
Т.е. если читать из secondary, а писать в primary - теоретически это могло бы снизить задержку, если бы коллекция была больше, например?
Nick
Т.е. если читать из secondary, а писать в primary - теоретически это могло бы снизить задержку, если бы коллекция была больше, например?
Да, так обычно делают, если надо например под жирную аналитику только ресурсы на чтение выделить. Или профиль 80-90% запросов на чтение и праймари не вывозит их
Alex
Да, так обычно делают, если надо например под жирную аналитику только ресурсы на чтение выделить. Или профиль 80-90% запросов на чтение и праймари не вывозит их
Наш юзкейс - это скорее что-то ближе к персистентному кэшу, вероятно не подойдет, да :(
Vadim

 Alexander Cheprasov
Всем привет! Монга гарантирует последовательность хранения элементов во вложенном в документ массиве?
Харамбус
Всем привет! Монга гарантирует последовательность хранения элементов во вложенном в документ массиве?
гарантирует, она работает по принципу bson, почитайте про это
 Victim
 Victim
 Null
 Null
У меня грамматика плохая я не Россиян
Null
 Null
Из Узбекистана
Null
Null
Я думаю и ты тоже
 Flake
Null
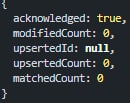
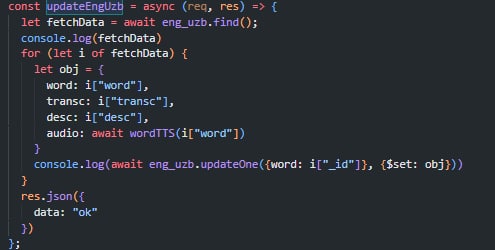
Он и не вернёт тебе жсон. Апдейты возвращают успешно/не успешно. Если кратко. Если нужно именно модель вернуть, поищи в документации что-то похожее на upsert: true, new :true
Мне просто нужно зделать update, но не работает этот updated
Null
I joined your group👍
 Abdurazzoq
Nick
Victim
vasyok28
Подскажите пожалуйста
Есть выборка
{
activate: false,
installed: false,
}
Как сказать что мне нужно чтобы обе свойства должны быть false. Допустим если installed будет true, то выборка произойдет. Благодарю заранее)
 Mike
Такой вопрос.
При конвертации данных с файла в монгу - время данных получается '- 3 часа'
Не существует ли какой то команды для данных которая бы запрещала модифицировать время получаемое с файла?
Mike
Если нет - то какой самый оптимальный подход существует для такой задачи?
Nick
Такой вопрос.
При конвертации данных с файла в монгу - время данных получается '- 3 часа'
Не существует ли какой то команды для данных которая бы запрещала модифицировать время получаемое с файла?
Время в базе без часового пояса импортируется, видимо в этом проблема. Решения тут либо в файле корректировать время на utc и если надо еще заводить поле с таймзоной, либо опять же в файле корректировать смещение по часовому поясу, либо после импорта апдейтом добавлять потерянную разницу. Последний способ это про разовые импорты, первые два если такое постоянно надо проделывать. Ну и можно просто забить и учитывать что в монге будет отличие при работе с запросами
Харамбус
подскажите как сделать $inc чтобы был декремент и если значение в результате негативное то сделать его 0, например было 10, сделали инк -15, результат вышел -5 и как его сразу на 0 засетить?