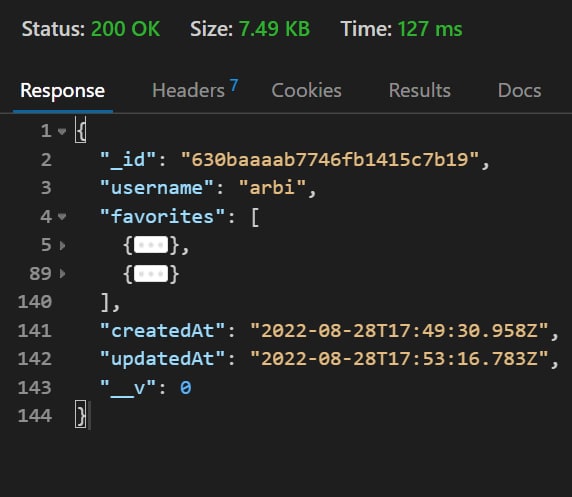
вместо этих 2-х id в виде строки, хочу чтобы там были 2 документа Dish
Ну хранить так смысла нет честно, но можешь сделать favorites: [Dish],
Но похоже тебе просто нужен populate
 Харамбус


 Арби
 Nef007
 Харамбус
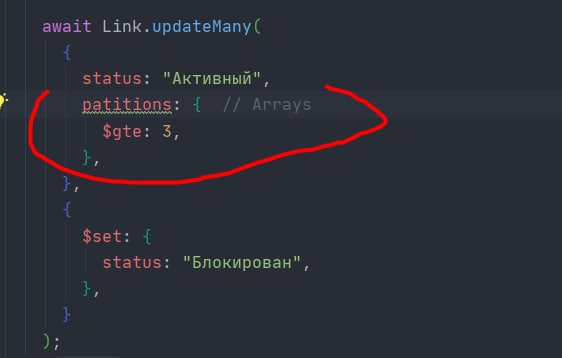
Мб paRtitions?
Nef007
db.collection.find( { $where: "this.patitions.length > 3" } );
Спасибо , попробую
 yopp
Nef007
С помощью $size,
https://docs.db-ai.co/docs/manual/reference/operator/query/size/
Да спасибо , увидел что он не работает с $lte $gte ... и для это нужно создавать поле size. ну посмотрим как пойдет)
yopp
Да спасибо , увидел что он не работает с $lte $gte ... и для это нужно создавать поле size. ну посмотрим как пойдет)
По-моему в aggregate нет такого ограничения
https://docs.db-ai.co/docs/manual/reference/operator/aggregation/size/
Nef007
 Alaout
Подскажите как при наличии id получить индекс в агрегации?
 Вячеслав
Добрый день. сижу на реляционной субд (4 основные таблицы по 65-100 млн записей).
Под виртуалку выделено 4 ядра ЦП и 48 Гб ОЗУ.
Запросы выполняются довольно медленно.
Вот думаю на mongodb уйти, чтобы была 1 коллекция с 65 млн записей
Вячеслав
за месяц записывается ~1.8 млн записей. иногда происходят операции чтения (когда нужно что-то найти по одному или паре полей)
Вячеслав
подойдёт mongo для такой задачи? 100 млн это много или как? )
Вячеслав
записываются заголовки и тело почтовых писем (от кого, кому, тема письма, дата/время, имена файлов вложений, текст тела письма без тегов и стилей)
Харамбус
Добрый день. сижу на реляционной субд (4 основные таблицы по 65-100 млн записей).
Под виртуалку выделено 4 ядра ЦП и 48 Гб ОЗУ.
Запросы выполняются довольно медленно.
Вот думаю на mongodb уйти, чтобы была 1 коллекция с 65 млн записей
Смысла переходить думаю нет на другую бд, наоборот нужно заняться оптимизацией и масштабированием, поделить бд на куски на разные серваки например
 Andrey
записываются заголовки и тело почтовых писем (от кого, кому, тема письма, дата/время, имена файлов вложений, текст тела письма без тегов и стилей)
Смотря как и что будете писать и читать из базы. 500 млн записей с одной стороны не много, но какие запросы будут. Опять, что там за носитель используется.
Сложно сказать в общем. Какая цель, экономия средств, производительность?
Вячеслав
Смотря как и что будете писать и читать из базы. 500 млн записей с одной стороны не много, но какие запросы будут. Опять, что там за носитель используется.
Сложно сказать в общем. Какая цель, экономия средств, производительность?
производительность + интерфейс пользовательский написать хочу на flask.
а mongodb в json возвращает умеет. да и вообще, с mongodb никогда не работал, но ощущение что он мне нравится 🙃
Andrey
производительность + интерфейс пользовательский написать хочу на flask.
а mongodb в json возвращает умеет. да и вообще, с mongodb никогда не работал, но ощущение что он мне нравится 🙃
Не знаю, в 2022 использовал бы FastAPI или aiohttp. Без знания вашим запросов к данным и чтения их сложно сказать. А что за диск у вас?
Вячеслав
Не знаю, в 2022 использовал бы FastAPI или aiohttp. Без знания вашим запросов к данным и чтения их сложно сказать. А что за диск у вас?
там NAS... IT-шники сетевой диск подогнали
Вячеслав
диски быстрые. сеть до NASa 1 Гбит
Вячеслав
какие точно - не знаю
Andrey
Сомневаюсь, что переезд на иную базу изменит что-то.
Вячеслав
так... могу в принципе физический сервер выделить под СУБД
Andrey
так... могу в принципе физический сервер выделить под СУБД
Приведу плохой пример, но, что есть, 8.9 млрд записей в 1 коллекции, сложная запись в базу, в день новых записей ну 1 млн, апдейт еще несколько миллионов, 8vCPU(desktop), 32 RAM, диск nvme на 2 Tb - поиск до 1 секунды - до 2-4 тысяч записей выгрузка.
Вячеслав
Есть свободный с 32 ядрами, 64 Гб ОЗУ
Вячеслав
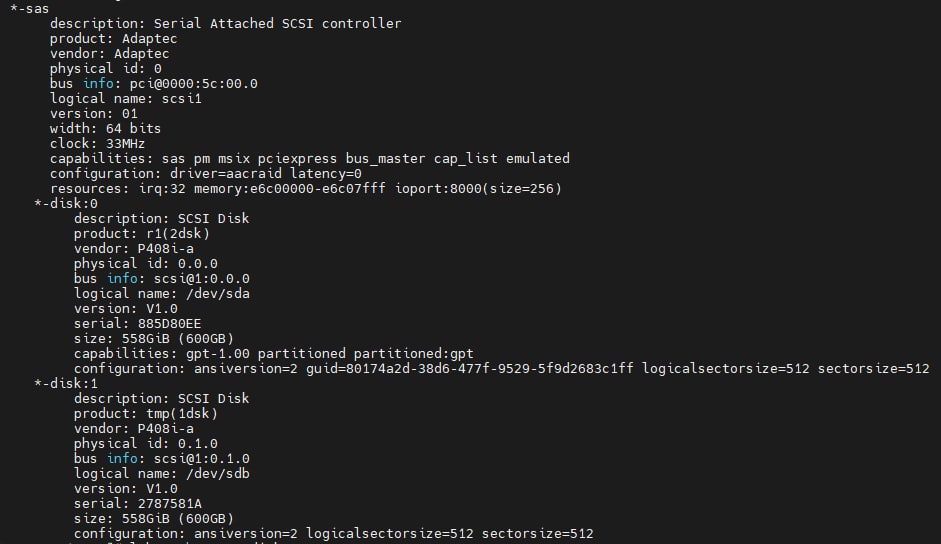
что-то не пойму как понять какой диск )
Вячеслав
 Харамбус
Andrey
Это пример плохого физ сервера?
Это плохой пример, потому что, исключительно для локальных задач небольшой команды внутри компании. Это не прод решение.
Вячеслав
ну у меня тоже для локальных задач
Вячеслав
мы ещё сами оригиналы сообщений храним в eml-файлах. но они на отдельном NAS. Там 30 ТБ
Andrey
Но по скорости - все устраивает. Единственное, что проблемы с релокейшеном сервера и данных.
Andrey
мы ещё сами оригиналы сообщений храним в eml-файлах. но они на отдельном NAS. Там 30 ТБ
Я бы хранил в аналоге s3, в записях в «базе» указывал «адрес- ключ» до «файла».
 Роман
Всем привет
Есть таблица у нас к примеру:
db.testtbl.insertMany([
{field: [{id: 1, name: "first"}, {id: 2, name: "second"}]},
{field: [{id: 3, name: "three"}]},
{field: [{id: 4, name: "four"}, {id: 5, name: "five"}]},
])
У меня есть список активных id - 1, 3, 4, 5
Все вложенные записи с не валидными id надо удалить (в данном случае это {id: 2, name: "second"})
Можно это как-то это одним запросом сделать?
Роман
Пока в голову только приходит вычитывать записи, проверять id, удалять не валидные строки и обратно записывать после
Харамбус
мб перед тем как передавать данные в инсерт их как то форматнуть?
 Vladyslav
Всем привет
Есть таблица у нас к примеру:
db.testtbl.insertMany([
{field: [{id: 1, name: "first"}, {id: 2, name: "second"}]},
{field: [{id: 3, name: "three"}]},
{field: [{id: 4, name: "four"}, {id: 5, name: "five"}]},
])
У меня есть список активных id - 1, 3, 4, 5
Все вложенные записи с не валидными id надо удалить (в данном случае это {id: 2, name: "second"})
Можно это как-то это одним запросом сделать?
одним запросом сделать - имеется ввиду перед записью?
то обыным жсом делается
Роман
одним запросом сделать - имеется ввиду перед записью?
то обыным жсом делается
Сейчас я могу сделать только написанием программы, которая будет вычитывать все записи из базы, обрабатывать и обратно записывать
Я хочу один запрос отправить в базу и чтобы она сделала
Что-то можно думаю полуучить при объединении forEach + $nin + $pull, но в голову не приходит
Vladyslav
Сейчас я могу сделать только написанием программы, которая будет вычитывать все записи из базы, обрабатывать и обратно записывать
Я хочу один запрос отправить в базу и чтобы она сделала
Что-то можно думаю полуучить при объединении forEach + $nin + $pull, но в голову не приходит
ты можешь просто почистить базу
и написать код, который отфильтрует ненужные елементы перед записью
Роман
так данные уже в таблице и их много
Роман
я не могу подругому записать
Vladyslav
пишешь скрипт на удаление + запускаешь его на бд - все
Роман
Хм, похоже это сработало
db.testtbl.updateMany({}, {$pull: {field: {id: {$nin: [1, 3, 4, 5]}}}})
Вячеслав
шляпа?
Вячеслав
это скорость чтения командой hdparm -t
 Flake
 Alaout
Подскажите как при наличии id получить индекс в агрегации?
Бд:
"user_id":"1",
"user_id":"2"
 Nick
там NAS... IT-шники сетевой диск подогнали
Если именно NAS тип то забудьте про производительность, любая бд будет медленная
Вячеслав
Если именно NAS тип то забудьте про производительность, любая бд будет медленная
не, я попросил уже, мне физический воткнули.
Вячеслав
 Nick
не, я попросил уже, мне физический воткнули.
После этого скорость выполнения запросов возросла? Какие сейчас времена и какие нужны по требованиям? И вообще какого плана запросы делаются
Вячеслав
После этого скорость выполнения запросов возросла? Какие сейчас времена и какие нужны по требованиям? И вообще какого плана запросы делаются
я просто планирую переезд с реляционной бд на монго
Вячеслав
После этого скорость выполнения запросов возросла? Какие сейчас времена и какие нужны по требованиям? И вообще какого плана запросы делаются
100 млн записей планирую мигрировать. + постоянная запись около 60 тыс записей в день.
в целом, информацию надо хранить 3 года. раз в месяц затирать крайний месяц
Nick
вот тест на чтение
Увы но скорость линейного чтения это бесполезная информация, пока профиль выборки не чтение больших объемов информации, как если бы вы файл читали. В базах редко когда такой профиль нагрузки.
Вячеслав
иногда надо что-то найти, поэтому будут селекты по паре-тройке полей
Вячеслав
храниться будут заголовки почтовых сообщений + ссылка на оригинальный файл сообщения
Вячеслав
крч, бэкап всей почты организации сроком в 3 года (срок исковой давности)
Вячеслав
сами файлы на отдельном NASe
Вячеслав
сейчас это всё крутится на mysql с сетевым диском и убогим пользовательским интерфейсом
Вячеслав
1 основная таблица с 65 млн записями и ещё 3 дополнительные по 100 млн записей one-to-many
Вячеслав
Flask - Flask-Admin - FastAPI - mongo
Вячеслав
планирую так
Вячеслав
вот думаю mongo подойдёт вообще или нет... если я всё в одну коллекцию сваливать буду
Nick
100 млн записей планирую мигрировать. + постоянная запись около 60 тыс записей в день.
в целом, информацию надо хранить 3 года. раз в месяц затирать крайний месяц
Важно как вы читать будете, сколько данных в выборки будет попадать, можно ли под эти выборки индексы построить и .т.п Поэтому отталкивайтесь от того как вы будете читать данные (особенно если решитесь на монгу переходить). Так собственно как примерно выглядят сейчас запросы? Судя по всему вы ищите по словам, а не по полному совпадению темы например, так?
Вячеслав
Важно как вы читать будете, сколько данных в выборки будет попадать, можно ли под эти выборки индексы построить и .т.п Поэтому отталкивайтесь от того как вы будете читать данные (особенно если решитесь на монгу переходить). Так собственно как примерно выглядят сейчас запросы? Судя по всему вы ищите по словам, а не по полному совпадению темы например, так?
зачастую по совпадению отправителя и получателя
Вячеслав
редко через subject like '%keyword%'
Вячеслав
поля которые ищутся по полному совпадению, конечно же индексированы
Nick
зачастую по совпадению отправителя и получателя
Это в ррляционке должно быть очень быстро. Какие у вас требования по скорости и что сейчас не устраивает?
Вячеслав
Это в ррляционке должно быть очень быстро. Какие у вас требования по скорости и что сейчас не устраивает?
сейчас по отправителю поиск занимает 15 минут )
Вячеслав
по получателю около 25 минут )
Вячеслав
но я думаю что дело в том что сейчас используются сетеве диски
Вячеслав
мне всё равно сейчас переписывать всё
Nick
Объем базы сейчас какой?
