 Вадим


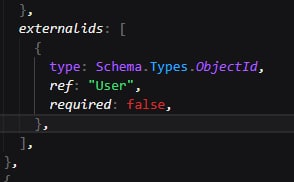
Ребят, как сделать массив ссылок по дефолту пустым? Вылазит ошибка связанная с дублированием ключей
 Nick
Ребят, как сделать массив ссылок по дефолту пустым? Вылазит ошибка связанная с дублированием ключей
создавать его пустым в коде перед сохранение документа в базу
 Komronbek.
диспетчер задач -> службы -> mongodb запустить
Как изменить путь к монге, когда через службы запускаю, он пытается запустить файл в другом месте
Вадим
 Вадим
 Konstantin
Вадим
создавать его пустым в коде перед сохранение документа в базу
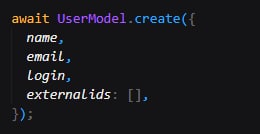
Один пользователь создаётся, а второй уже нет
Nick
Как изменить путь к монге, когда через службы запускаю, он пытается запустить файл в другом месте
там же в диспетчере на службе монго нажать "Открыть службы", найти сервис монгодб (у меня mongodb server) в списке глянуть путь как формируется и например по аналогии с ответом https://stackoverflow.com/a/51838198 перенастроить путь
Nick
Вадим
Nick
Nick
сдается мне так задизайнено
Nick
собственно похоже ошибка связана не с этим
Nick
Вадим
 Вадим
У меня этого subscriptions даже нет в модели
Nick
ошибка говорит об обратном, ищите где оно и почему там проставляется дефолтное null
 Відьма🐝👈
 Dev
Подскажите, у меня есть коллекции users и posts. Как я могу одним запросом получить пользователя со всеми его постами?
Dev
Вот такой результат я хотел бы получить
{
_id: '<id>',
email: 'user1@gmail.com,
posts: [
{
_id: '<id>',
title: 'Post 1 from User 1',
isPublished: true
},
{
_id: '<id>',
title: 'Post 2 from User 1',
isPublished: true
},
{
_id: '<id>',
title: 'Post 3 from User 1',
isPublished: true
}
]
}
Вадим
Подскажите, у меня есть коллекции users и posts. Как я могу одним запросом получить пользователя со всеми его постами?
Напиши, userModel.findById().populate(“posts”)
Dev
Напиши, userModel.findById().populate(“posts”)
Я хотел бы сначала разобраться, как это должно выглядеть в нативном коде монго. Подскажите, могу ли я посмотрть, какой запрос генерирует эта комманда в mongoose?
Вадим
Не понял вопрос
Dev
populate делается на уровне бд или на уровне приложения?
Nick
populate делается на уровне бд или на уровне приложения?
В нативe это $lookup, монгус в популейте делает доп трансформации выбранных из базы доков методом популейт
Dev
В нативe это $lookup, монгус в популейте делает доп трансформации выбранных из базы доков методом популейт
Подскажите, как я могу посмотреть нативный запрос, который генерирует mongoose?
Kaizoku
Привет народ, частенько начал зависать сервер монго, из за чего может быть такое? и когда все зависает такая картина https://clip2net.com/s/4eCf35t
 Амир
Привет! Подскажите пожалуйста, как будет корректнее: к примеру, есть две сущности - КНИГА и ЖАНР
У каждой книги есть жанр.
Задача: нужно получить все книги по жанру. Чтобы это сделать нужно с клиента отправлять id жанра, пусть оно равно genreID
Как я понимаю, чтобы реализовать это у нас есть два варианта:
1. Хранить в сущности Книги поле genreID
либо
2. Хранить в сущности Жанра поле books, хранящее массив из bookID, принадлежащие жанру.
Реализация:
// Напомню, genreID приходит с клиента.
1. Book.find({ genreID: genreID }) => выдаст все книги, у которых поле genreID === genreID
либо
2. Genre.findById(genreID) => выдаст один Жанр. Жанр имеет поле books => можно сделать
Book.find({ _id: books })
Оба варианта, по сути, должны вернуть одинаковый результат. Но какой подход будет проще с точки зрения расширения приложения и оптимизации?
 Nikita
Может кто помочь с этим плз?
https://stackoverflow.com/questions/70723903/how-to-fit-to-memory-limit-during-file-reading-in-node-js
 P1GAS
Может кто помочь с этим плз?
https://stackoverflow.com/questions/70723903/how-to-fit-to-memory-limit-during-file-reading-in-node-js
https://stackoverflow.com/questions/53230823/fatal-error-ineffective-mark-compacts-near-heap-limit-allocation-failed-javas
P1GAS
Nikita
Спасибо, изучаю
Nick
Привет! Подскажите пожалуйста, как будет корректнее: к примеру, есть две сущности - КНИГА и ЖАНР
У каждой книги есть жанр.
Задача: нужно получить все книги по жанру. Чтобы это сделать нужно с клиента отправлять id жанра, пусть оно равно genreID
Как я понимаю, чтобы реализовать это у нас есть два варианта:
1. Хранить в сущности Книги поле genreID
либо
2. Хранить в сущности Жанра поле books, хранящее массив из bookID, принадлежащие жанру.
Реализация:
// Напомню, genreID приходит с клиента.
1. Book.find({ genreID: genreID }) => выдаст все книги, у которых поле genreID === genreID
либо
2. Genre.findById(genreID) => выдаст один Жанр. Жанр имеет поле books => можно сделать
Book.find({ _id: books })
Оба варианта, по сути, должны вернуть одинаковый результат. Но какой подход будет проще с точки зрения расширения приложения и оптимизации?
если у вас нет плана по дальнейшему развитию - как первый так и второй, так тритий и даже четвертый, кторые решают конкретные проблемы на уже разросшихся проекта с зафиксированной функциональностью. Такчто выбирайте как вам сейчас удобнее и просто закладывайте время на полную перестройку структуры БД когда все неявное оперделится
Амир
если у вас нет плана по дальнейшему развитию - как первый так и второй, так тритий и даже четвертый, кторые решают конкретные проблемы на уже разросшихся проекта с зафиксированной функциональностью. Такчто выбирайте как вам сейчас удобнее и просто закладывайте время на полную перестройку структуры БД когда все неявное оперделится
спасибо! ответ в принципе логичный. но если все таки выбирать из двух зол оптимальное?
Nick
спасибо! ответ в принципе логичный. но если все таки выбирать из двух зол оптимальное?
первое, это стандартный подход в реляционных БД, который уже полвека существует и до появления проблем с производительностью и менеджерством структуры бд очень удобен.
Второй уже прямо сейчас может создать для вас проблемы, т.к. почемуто при добавлении книги вам зачемто нужно обновлять данные целого жанра
Nick
ну и что вы будете делать, когда книгу захочется отнести к нескольким жанрам?
фантастика
комедия
детское
Амир
первое, это стандартный подход в реляционных БД, который уже полвека существует и до появления проблем с производительностью и менеджерством структуры бд очень удобен.
Второй уже прямо сейчас может создать для вас проблемы, т.к. почемуто при добавлении книги вам зачемто нужно обновлять данные целого жанра
вы совершенно правы. огромное спасибо за развернутый ответ!)
Nick
вы совершенно правы. огромное спасибо за развернутый ответ!)
еще можно посмотреть немного с другой стороны, отвлеченно от БД. Жанр книги - это ее свойство, причем субъективное, в первом варианте как раз так и описываете в БД. Во втором же получается что жанр знает о книгах, т.е. условно жанр определяет какие книги к нему относятся, а не по содержимому книги мы определяем к какому жанру его отнести.
Амир
еще можно посмотреть немного с другой стороны, отвлеченно от БД. Жанр книги - это ее свойство, причем субъективное, в первом варианте как раз так и описываете в БД. Во втором же получается что жанр знает о книгах, т.е. условно жанр определяет какие книги к нему относятся, а не по содержимому книги мы определяем к какому жанру его отнести.
да, это так правильно и очевидно. все это было в голове в похожем виде, но никак не мог объяснить почему второй вариант плох. очень рад, что есть такие чаты и люди, как вы, готовые помогать) 🙏🏼
Dev
да, это так правильно и очевидно. все это было в голове в похожем виде, но никак не мог объяснить почему второй вариант плох. очень рад, что есть такие чаты и люди, как вы, готовые помогать) 🙏🏼
Думаю, лучше наоборот, в коллекции books хранить список ganreIds.
Dev
У одной книги может быть несколько жанров, но оно ограничено. А у одного жанра неограниченное количество книг. Хранить в жанре Фантастика список из 1000 id книг будет неэффективно.
 Hunter
Как провести поиск на совпадение в масиве
Есть обект
{
name:"...."
genre:["..","..",".."]
}
{
name:"...."
genre:["..","..",".."]
}?
Hov.
Как провести поиск на совпадение в масиве
Есть обект
{
name:"...."
genre:["..","..",".."]
}
{
name:"...."
genre:["..","..",".."]
}?
https://docs.mongodb.com/manual/reference/operator/query/in/
Амир
Hunter
А в mongoose тоже будет работать?
Амир
А подскажите пожалуйста еще такой момент. Есть у нас User. И нужно каким-то образом хранить понравившиеся ему книги. Я придумал такой вариант: у User создать поле likedBooks, которое хранит id понравившихся Книг.
1 Вопрос. Есть ли другие хорошие варианты реализации такого?
2 Вопрос. Мы можем в массив likedBooks сохранять id в виде String, а можем в виде ObjectID с ссылкой.
Есть ли существенная разница в том, какой тип использовать? Если книгу удалить из БД, как поведет себя id в этом массиве при разных способах сохранения в массив id?
Nick
А подскажите пожалуйста еще такой момент. Есть у нас User. И нужно каким-то образом хранить понравившиеся ему книги. Я придумал такой вариант: у User создать поле likedBooks, которое хранит id понравившихся Книг.
1 Вопрос. Есть ли другие хорошие варианты реализации такого?
2 Вопрос. Мы можем в массив likedBooks сохранять id в виде String, а можем в виде ObjectID с ссылкой.
Есть ли существенная разница в том, какой тип использовать? Если книгу удалить из БД, как поведет себя id в этом массиве при разных способах сохранения в массив id?
1. "Хорошо" определяется потребностями/задачами, если потребность быстро сделать прототип - то вариант "хороший", если надо потом будет экспортировать эти лайки в рекомендательную систему - уже не очень, и там предпочтительнее отдельная коллекция лайков/дизлайков причем в формате заточнном под эту задачу. Возможно даже для производительности придется и так и так хранить, решая отдельные задачи.
2. Т.к. _id лайка похоже не будет сам по себе участвовать в формировании связей в качестве ключа и наверняка даже на фронты не будет выводиться, то по сути неважно даже будет ли он вообще сохранен, не говоря уже о типе. Для уникальных значений ObjectId будет меньше есть места, но это будет иметь смысл только на больших объемах и возможно вам будет проще работать со строками в самом коде
а вот про удаление книги из БД это отдельный прикол, потому как монга сама не предоставляет ни механизма foreign ключей и каскадного удаления ни триггеров для автоматизации этой части. Собственно все это реализуется в вашем коде (в монгусе например есть middleware перехватчики, которые могут использоваться для скрытия этого из основного кода). И как следствие вы выбираете как вам удобнее реализовать это по вашей структуре БД, подчищая все места, где эта книга упоминалась.
Viktar
Кто шарит в вложенных полях? Как их добавлять к имеющимся, я использовал $set, но оно удаляет все вложенные поля, и добавляет новое, и в итоге вложенных полей 1
Посмотрите $addToSet и $push
https://docs.mongodb.com/manual/reference/operator/update/push/
https://docs.mongodb.com/manual/reference/operator/update/addToSet/
 Roma
подскажите нужно ли как-то превентить инъекции в монго? юзаю mongo-sanitize, достаточно этого?
Anton
Привет, а как сделать поиск по вхождению числа в поле числа? например у меня есть поле phone где значение 9205311111 мне нужен по поиску 531 его найти
Nick
Хз как у дискорда у меня было 16 лярдов в шардах на 12 тб с репликами и нормально работало, потом уволился и сейчас не в курсе что там. Видимо их специфика данных и запросов при работе на касандре дает преимущества
Nick
Привет, а как сделать поиск по вхождению числа в поле числа? например у меня есть поле phone где значение 9205311111 мне нужен по поиску 531 его найти
Если номер строкой, то регулярка. Если числом то никак
 Cloud
не ну можно попробовать в $where передать функцию, где число будет приводиться к строке, и там уже искать
Nick
не ну можно попробовать в $where передать функцию, где число будет приводиться к строке, и там уже искать
это из категории вредные советы, $where это всегда колскан и вычиткой всего плюс сверху накладываются ограничения $where и что он выполняется в медленном интерпретаторе js под капотом монги
Cloud
ну тогда это из категории - есть решение, но у него есть опр недостатки
пусть уж их тл решает устраивает их это решение или нет
 Sergey
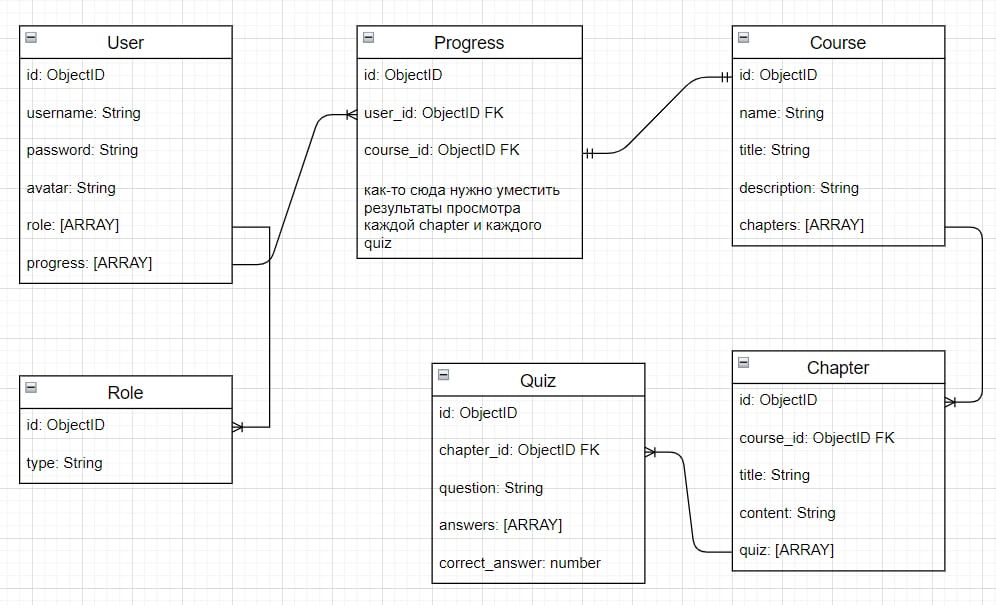 Roma
вопрос не по теме:
const startPayload = sanitize({toSanitize: ctx.startPayload});
db.collection('users').insertOne(new User({tg_id: ctx.chat.id, ref: startPayload.toSanitize}))
Такого sanitize достаточно или нет. это mongo-sanitize
 Dmitry
Sergey
может лучше вместо прогресса хранить проходимые курсы? типа SavedCource. и у него может быть ссылка на курс и статы про пройденным главам и тп
спасибо за ответ.
Да, под прогрессом я примерно это и имел в виду. Только пока не очень понимаю как это в схему БД засунуть.
Dmitry
спасибо за ответ.
Да, под прогрессом я примерно это и имел в виду. Только пока не очень понимаю как это в схему БД засунуть.
схемами монги можно вертеть как угодно
Sergey
схемами монги можно вертеть как угодно
ладно, поковыряю. Спасибо.🙏🙏
Если есть какая-то ссылочка под рукой на пример чего-то отдаленно похожего, может статью какую-то, пришли, пожалуйста. Не мойму куда копать. Пока мой опыт в БД - это просмотр нескольких видео на ютубе по созданию фуллстек-приложений с Монгой, но там схемы данных попроще )
Dmitry
ладно, поковыряю. Спасибо.🙏🙏
Если есть какая-то ссылочка под рукой на пример чего-то отдаленно похожего, может статью какую-то, пришли, пожалуйста. Не мойму куда копать. Пока мой опыт в БД - это просмотр нескольких видео на ютубе по созданию фуллстек-приложений с Монгой, но там схемы данных попроще )
в той же документации монги неплохо объяснено
а так всё сводится к продумыванию объектов аля ООП
Sergey
Дима
Как решить проблему с закрытием монгодб при запуске на винде?
В инете не понял как
Дима
Я создал папку для базы на другом диске и как теперь указать путь?
Dmitry
Как решить проблему с закрытием монгодб при запуске на винде?
В инете не понял как
запускать как службу
Дима
Мне надо указать путь чтобы базы были на другом диске
 Anton
Всем привет!
Использую mongoose + typescript
Вопрос следующий:
В схеме есть поле, являющее собой массив и помеченное как необязательное
const taskSchema = new Schema<Task>({
...
attachments: {type: [{name: String, url: String}], required: false}
});
В соответствующем схеме интерфейсе оно также помечено как nullable
interface Task {
...
attachments?: Array<{
name: string,
url: string
}>
}
Но когда делается запрос к документу, в котором
attachments
отсутствует - mongo возвращает пустой массив вместо null
Вопрос в том, как это починить?
Anton
Всем привет!
Использую mongoose + typescript
Вопрос следующий:
В схеме есть поле, являющее собой массив и помеченное как необязательное
const taskSchema = new Schema<Task>({
...
attachments: {type: [{name: String, url: String}], required: false}
});
В соответствующем схеме интерфейсе оно также помечено как nullable
interface Task {
...
attachments?: Array<{
name: string,
url: string
}>
}
Но когда делается запрос к документу, в котором
attachments
отсутствует - mongo возвращает пустой массив вместо null
Вопрос в том, как это починить?
Нашёл ответ тут: https://stackoverflow.com/questions/20713650/mongoose-creating-empty-arrays
Чего то с нескольких раз не загуглилось
 Ilya
уж лучше пустой массив чем null
 Николай
Здравствуйте, подскажите новичку. Пишу на java
Есть код
for (i=1;;i++) {
код...
Document Document = new Document("id", i)
.append...
collection.insertOne(Document);
код...
}
в коллекции много документов, у каждого свой id (равный увеличивающемуся i), как вытащить из всех добавленных документов
максимальное значение поля с ключем id
Все это к тому, что когда я остановлю приложение на java и затем запущу его, то i (а значит и id) снова будет 1
Если плохо объяснил, закидайте помидорами)
Винер
Хей монгоуз Хей Хей монгооуз
 Р00-👨🏻💻Михаил
Сделай ка мне scheme abuse
Vadim
Приветствую!
Что делать с ref ссылками на другие коллекции, если по какой-то причине пользователь из связной коллекции удаляется, на population возвращается null, есть какая-то встроенная защита от удаления?
Пример:
const Logger = new Schema(
{
username: { type: Schema.Types.ObjectId, ref: "users" },
}
);
Запрос:
Logger.find({}).populate("username").sort({ createdAt: "descending" }).exec()
Vadim
Приветствую!
Что делать с ref ссылками на другие коллекции, если по какой-то причине пользователь из связной коллекции удаляется, на population возвращается null, есть какая-то встроенная защита от удаления?
Пример:
const Logger = new Schema(
{
username: { type: Schema.Types.ObjectId, ref: "users" },
}
);
Запрос:
Logger.find({}).populate("username").sort({ createdAt: "descending" }).exec()
Сейчас просто в лог пишу строку с именем, но хотелось бы связную ссылку иметь