Получается это не сама MongoDB, а cosmodb, котооая работает точ в точ как монго?
Да причём до перехода на sspl лицензию, то есть 2-3 летняя давность.
 Nikolay


 Dev
С менеджерами надо говорить их языком. Не знаю правда, что у тебя за компания.
1) покажи как охеренно выросли акции монго за последний год,
2) укажи что у Гугл сам внутри использует другую базу и spanner
https://storage.googleapis.com/pub-tools-public-publication-data/pdf/65b514eda12d025585183a641b5a9e096a3c4be5.pdf
3) в атласе можно делать online backup и хранить его за пределом облака и это снижает риски business continuity
4) ACID транзакции из NoSQL это только монга, почему важно придумай сам
Спасибо большое за идеи! Там пока упирается дело в стоимость, $1700 не хотят платить в месяц, но если через сам cloud.mongodb.com оформить, то можно меньше тариф выбрать....
Nikolay
Опиши приложение и компанию я ещё каких нибудь важных менеджерам мантр набросаю ;)
Nikolay
Лучше в личку наверное
Шынгыс
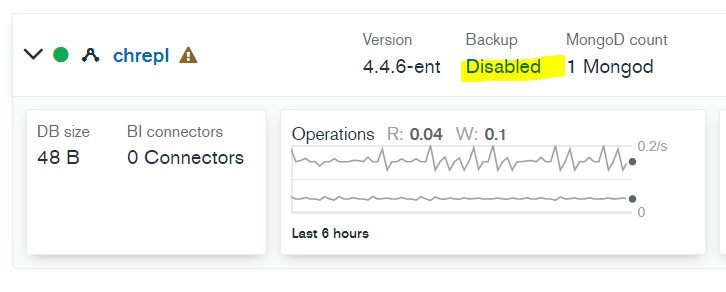
добрый день, ребята. кто нибудь настраивал бэкапирование средствами Ops Manager? Кто сможет подсказать как включить опцию бэкапа ?
Шынгыс
 Глеб
Приветствую. Подскажите такой вопрос, по поводу pbm-agent'a
Он просто весит в inactive.
Куда копать? Как логи посмотреть?
pbm logs
Пустой
Вот такая строка есть
pbm-agent[13443]: 2022/01/12 12:21:30 connect to the node: connect: create mongo client: a direct connection cannot be made if multiple hosts are specified
И главный вопрос, он вообще умеет в ноды? Или только сингл таргеты?
 Александр
Привет всем. Есть коллекция на 11 миллионов документов. По ней будет выполняться текстовый поиск. Нужно ли сразу думать о шардировании в этом случае? И вообще когда оно целесообразно?
 Nick
Привет всем. Есть коллекция на 11 миллионов документов. По ней будет выполняться текстовый поиск. Нужно ли сразу думать о шардировании в этом случае? И вообще когда оно целесообразно?
Шардирование больше про запись - позволяет решать проблемы ограничения по скорости записи и размерам хранилищ на отдельных серверах.
Чтобы размазать чтение обычно достаточно настроить реплики в количестве необходимом для покрытия вашей нагрузки на чтение.
Думать о шардировании при чтении надо в случаях, когда ожидается что будете упираться в диски и памяти не будет хватать чтобы держать индексы в памяти, т.к. на репликах по сути будет копия данных и если у вас проблемы с тем чтобы запихнуть данные под выборки в память, то реплики не помогут.
Так что если у вас планируется большой рост по объемам хранимых документов (терабайты), то стоит смотреть в шарды. Также если у вас большие тексты и уже сейчас вы можете понять, что условно через полгода вы исчерпаете ресурс оперативной памяти под хранение индексов, то тоже смотрите на шарды. В остальных случаях это может лишь сильно усложнить жизнь и возможно стоит тупо закинуть рейд ссд дисков для хранения и оперативы и жить дальше.
Александр
Шардирование больше про запись - позволяет решать проблемы ограничения по скорости записи и размерам хранилищ на отдельных серверах.
Чтобы размазать чтение обычно достаточно настроить реплики в количестве необходимом для покрытия вашей нагрузки на чтение.
Думать о шардировании при чтении надо в случаях, когда ожидается что будете упираться в диски и памяти не будет хватать чтобы держать индексы в памяти, т.к. на репликах по сути будет копия данных и если у вас проблемы с тем чтобы запихнуть данные под выборки в память, то реплики не помогут.
Так что если у вас планируется большой рост по объемам хранимых документов (терабайты), то стоит смотреть в шарды. Также если у вас большие тексты и уже сейчас вы можете понять, что условно через полгода вы исчерпаете ресурс оперативной памяти под хранение индексов, то тоже смотрите на шарды. В остальных случаях это может лишь сильно усложнить жизнь и возможно стоит тупо закинуть рейд ссд дисков для хранения и оперативы и жить дальше.
Данные там будут каждый день обновляться по расписанию. Так что история и про запись тоже. Спасибо большое за развернутый ответ
 Pt. Loki
Доброго времени. Есть mongo, mongoose и mongoose-gridfs. получаю файл через input морды, шлю (через сокеты, а не форму) file на бек. там приходится сохранять файл
const file_path = "files/"+(new Date().valueOf())+'_'+randomInt(1000);
fs.writeFile(file_path, file.data, {},async() => {
const bigImage = fs.createReadStream(file_path);
а потом уже делать стрим для gridfs. есть ли способ файл не сохранять, а напрямую в стрим "конвертировать"?
Гена
привет
запускаем запрос с array на find и падает с такой ошибкой
[js] InternalError: allocation size overflow :
что делать, подскажите пожалуйста
 Danil
Здравствуйте, а как можно сделать, я вот ищю документы coll.find() и сортирую их .sort("balance", -1), и .limit(10), как можно сделать что бы например вот пропустить первые 10 и показывать другие документы
Тоесть с помощью
coll.find({}).sort("balance", -1).limit(10)
Выводит 10 тех у кого самый большой баланс, я хочу сделать что бы эти 10 документов пропускало, и давало следующие 10 документов
 Cloud
skip
Ruslan
привет, а кто рабоатл с mongos? при запуске нужно каждый раз делать sh.addShard при запуске? или 1 раз достаточно и все новые монгос которые будут стартовать будут без проблем подключаться и делать запись?
 Andrii
Всем привет.
Направьте в нужное русло, пожалуйста.
Ищу способ ограничивать используемые ресурсы (CPU, memory, etc) в разрезе user/database.
Проблема в чём: если один из коннектов mongodb для своей базы данных выполнит неаккуратных запросов, от этого пострадает весь сервер и все остальные пользователи этого сервера (в других БД).
Хочется сделать что-то около "ограничить максимальное использование ресурсов для db_loyalty до Memory 1GB, CPU 2".
Андрей
Всем привет.
Направьте в нужное русло, пожалуйста.
Ищу способ ограничивать используемые ресурсы (CPU, memory, etc) в разрезе user/database.
Проблема в чём: если один из коннектов mongodb для своей базы данных выполнит неаккуратных запросов, от этого пострадает весь сервер и все остальные пользователи этого сервера (в других БД).
Хочется сделать что-то около "ограничить максимальное использование ресурсов для db_loyalty до Memory 1GB, CPU 2".
Не видел, чтоб монга умела в изоляцию на таком уровне. Кроме увода чтения на стэндбаи либо вообще податься в шарды, наверное вариантов нет.
Nick
Всем привет.
Направьте в нужное русло, пожалуйста.
Ищу способ ограничивать используемые ресурсы (CPU, memory, etc) в разрезе user/database.
Проблема в чём: если один из коннектов mongodb для своей базы данных выполнит неаккуратных запросов, от этого пострадает весь сервер и все остальные пользователи этого сервера (в других БД).
Хочется сделать что-то около "ограничить максимальное использование ресурсов для db_loyalty до Memory 1GB, CPU 2".
на уровне БД такого нет. Вы можете накастомайзить отслеживание медленных запросов от юзеров в логах монги и отстреливать их https://www.mysoftkey.com/mongodb/profiling-for-slow-query-log-in-mongodb/
 J
Здравствуйте! Я студент, только начал осваивать Монго, в практическом задании указано: установить ключ документа по полю: Номер. Задача заключается в импорте таблицы json с большим количеством строк, каждой строке присваивается _id (objectid), нужно чтобы это значение не генерировалось, а равнялось значению поля "Номер". Подскажите как?
Andrii
на уровне БД такого нет. Вы можете накастомайзить отслеживание медленных запросов от юзеров в логах монги и отстреливать их https://www.mysoftkey.com/mongodb/profiling-for-slow-query-log-in-mongodb/
Вы имеете в виду в realtime отслеживать и убивать коннекты (или убивать запросы)?
Nick
Здравствуйте! Я студент, только начал осваивать Монго, в практическом задании указано: установить ключ документа по полю: Номер. Задача заключается в импорте таблицы json с большим количеством строк, каждой строке присваивается _id (objectid), нужно чтобы это значение не генерировалось, а равнялось значению поля "Номер". Подскажите как?
при вставке проставляйте _id равным нужному значению
Muzaffar
ребят можете помочь с запросом?:
есть такой запрос вроде как все нормально работает
db.user_action.aggregate([
// Get only records created in a time span
{$match: {createdDate: {$gte: ISODate("2022-01-01T00:00:00Z"), $lte: ISODate("2022-01-01T00:59:59Z")}}},
// Get the year, month and day from the createdTimeStamp
{$project: {yearMonthDayUTC: {$dateToString: {format: "%Y-%m-%d %H", date: "$createdDate"}}}},
// Group by year, month, day and hour and get the count
{
$group: {
_id: {yearMonthDayUTC: "$yearMonthDayUTC"},
"count": {$sum: 1}
}
}
])
но выводит количество всех записей т.к. группировка только по времени стоит а сделать чтоб и учитывалось ещё userId?
т.е. выводил количество уникальных юзеров
Vadim
Приветствую, делаю запрос в базу посредством mongoose, с целью проверки на уникальность имени.
В итоге запроса, естественно находит свою же запись, я хочу проверять на уникальность имя исключая текущего пользователя.
Как мне исключить из запроса _id пользователя?
Запрос и последующая проверка:
const checkName = await User.findOne({ username }).lean().exec();
if (checkName && (checkName._id === id) {
return res.status(400).json({
message: Пользователь с таким именем:${username} уже существует,
});
}
checkName._id = new ObjectId("61dfc1488b52378ae0f318f0")
id = "61dfc1488b52378ae0f318f0"
Проще как то бы привести к выводу одному _id
 P1GAS
Приветствую, делаю запрос в базу посредством mongoose, с целью проверки на уникальность имени.
В итоге запроса, естественно находит свою же запись, я хочу проверять на уникальность имя исключая текущего пользователя.
Как мне исключить из запроса _id пользователя?
Запрос и последующая проверка:
const checkName = await User.findOne({ username }).lean().exec();
if (checkName && (checkName._id === id) {
return res.status(400).json({
message: Пользователь с таким именем:${username} уже существует,
});
}
checkName._id = new ObjectId("61dfc1488b52378ae0f318f0")
id = "61dfc1488b52378ae0f318f0"
Проще как то бы привести к выводу одному _id
https://stackoverflow.com/questions/49643755/how-to-get-all-users-except-select-user-from-mongodb-using-mongoose
Vadim
Приветствую, делаю запрос в базу посредством mongoose, с целью проверки на уникальность имени.
В итоге запроса, естественно находит свою же запись, я хочу проверять на уникальность имя исключая текущего пользователя.
Как мне исключить из запроса _id пользователя?
Запрос и последующая проверка:
const checkName = await User.findOne({ username }).lean().exec();
if (checkName && (checkName._id === id) {
return res.status(400).json({
message: Пользователь с таким именем:${username} уже существует,
});
}
checkName._id = new ObjectId("61dfc1488b52378ae0f318f0")
id = "61dfc1488b52378ae0f318f0"
Проще как то бы привести к выводу одному _id
Да тут скорее нужно было объекты к строке привести и сравнить. Так как ищу одно значение. Вопрос некорректно задал, но все равно спасибо за помощь)
Александр
Привет. Можете подсказать что можно сделать для оптимизации полнотекстового поиска в монге? Есть запросы которые по 4 минуты выполняются. В коллекции миллионы записей. Текстовый индекс один и большой. Увеличение CPU и RAM не влияет на время отдачи, ssd тоже не помог
Nick
Александр
Какого плана запросы делаются?
mongoose используется, по идее так должны выглядеть запросы
db.collection.find( { $text: { $search: "someText"} }).limit(100)
Nick
Nick
mongoose используется, по идее так должны выглядеть запросы
db.collection.find( { $text: { $search: "someText"} }).limit(100)
Например, ищется похожее, или ищется корректировки ошибок с опечатками, или может только по префиксу?
Александр
Например, ищется похожее, или ищется корректировки ошибок с опечатками, или может только по префиксу?
На полное совпадение слова в поле. Есть логика и на частичное вхождение, конечно, но я это пока отключил и сейчас рассматриваю только full text search. Например у компании есть поле название, поле руководитель. Можно искать и по названию и по руководителю
Nick
На полное совпадение слова в поле. Есть логика и на частичное вхождение, конечно, но я это пока отключил и сейчас рассматриваю только full text search. Например у компании есть поле название, поле руководитель. Можно искать и по названию и по руководителю
Если по полному совпадению, то должно было быстро работать
Андрей
На полное совпадение слова в поле. Есть логика и на частичное вхождение, конечно, но я это пока отключил и сейчас рассматриваю только full text search. Например у компании есть поле название, поле руководитель. Можно искать и по названию и по руководителю
У меня на млрд записей коллекция с текстовым поиском по очень длинным значениям. Работает моментально практически поиск
Vlad Kutuev
Подскажите плиз. Коллекция. В ней набор сущностей. У каждой сущности есть поле например x. В поле x записано число типа Integer. Это число может повторятся у каких-то других сущностей. Задача написать такой запрос к колекции, чтобы на выходе был массив сущностей, НО в среди этих сущностей поле x НЕ будет повторятся
 Komronbek.
collection.find не итерируется в for
Komronbek.
К монге подключался через motor
Komronbek.
И кстати, pymongo не ассинхронный ?
Andrey
Подскажите плиз. Коллекция. В ней набор сущностей. У каждой сущности есть поле например x. В поле x записано число типа Integer. Это число может повторятся у каких-то других сущностей. Задача написать такой запрос к колекции, чтобы на выходе был массив сущностей, НО в среди этих сущностей поле x НЕ будет повторятся
В чем смысл такого запроса, у вас несколько разных документов с одинковым значением x, и получится, что они «потеряются»
Vlad Kutuev
В чем смысл такого запроса, у вас несколько разных документов с одинковым значением x, и получится, что они «потеряются»
Мне это и нужно. Мне нужен по одной из сущности. Просто в итоговом массиве поле x должно быть уникальное. Я бы и просто через findAll все выдернул, но коллекция большая
Vlad Kutuev
В чем смысл такого запроса, у вас несколько разных документов с одинковым значением x, и получится, что они «потеряются»
Просто нужно избавится от дубликатов сущностей. Дубликат значит у них в поле x например 12. И у первого и у второго. Вот мне нужно чтобы в итоговый массив зашел только первый
Vlad Kutuev
В чем смысл такого запроса, у вас несколько разных документов с одинковым значением x, и получится, что они «потеряются»
Distinct как я вычитал лишь по 1 полю работает. Уникальные остаются значения документа, а мне нужно чтобы уникальность документа таким образом определялась
 Andrey
Nick
Distinct как я вычитал лишь по 1 полю работает. Уникальные остаются значения документа, а мне нужно чтобы уникальность документа таким образом определялась
Вам нужна агрегация с $group у которого в _id составной объект из ваших полей, а в теле группировки $first
 Hunter
E11000 duplicate key error collection: myFirstDatabase.films index: name_1 dup key: { name: "Thelllll" }(Обновляю информация о фильме, первый норм обновляется, а для других выдает такую ошибку, как ее можно исправить?)
Hunter
использую findOneAndUpdate
Nick
Danil
Здравствуйте, а как можно искать в каком ключе какое-то значение?
Вот например такой документ:
doc = {
'_id': 1,
'name': ...,
'items': {
'1': ...,
'2': ...,
'3': ...
}
}
И например есть значение в каком-то поле из поля 'items', как узнать в каком подполе находится какое-то значение? И ещё как вывести все под поля?
Danil
Здравствуйте, а как можно искать в каком ключе какое-то значение?
Вот например такой документ:
doc = {
'_id': 1,
'name': ...,
'items': {
'1': ...,
'2': ...,
'3': ...
}
}
И например есть значение в каком-то поле из поля 'items', как узнать в каком подполе находится какое-то значение? И ещё как вывести все под поля?
Про последнее я наверное догадываюсь, но это не точно
Тип
f = collection.find_one({'_id': 1})[f"{items["1"]}"]
Но я не уверен конечно
Danil
Базы
Nick
Тогда что именно требуется не ясно, вы хотите поиск сделать по вложенным полям?
Danil
Тогда что именно требуется не ясно, вы хотите поиск сделать по вложенным полям?
Ну да, типо есть ли в вложенных полях поле, в котором есть такое то значение
Danil
Про последнее я наверное догадываюсь, но это не точно
Тип
f = collection.find_one({'_id': 1})[f"{items["1"]}"]
Но я не уверен конечно
@yatoba А поиск по вложенным полям будет работать так как я написал тут?
Danil
Я тупо обьяснил наверное
 Sheff
Здравствуйте, подскажите пожалуйста можно ли получить дату создания записи?
Проблема в том что изначально не было это нужно и по этой причине данного поля просто нет, может можно как-то получить из ObjectId или ещё как то?
Nikita
Здравствуйте, подскажите пожалуйста можно ли получить дату создания записи?
Проблема в том что изначально не было это нужно и по этой причине данного поля просто нет, может можно как-то получить из ObjectId или ещё как то?
https://docs.mongodb.com/manual/reference/method/ObjectId.getTimestamp/
 brodyaga
ребят, всем привет, понимаю, что можно почитать, но все же, кто может подсказать, почему все так негативно реагируют на смену лицензии монги? Если в двух словах: магазин продуктов из 5 микросервисов, которые пишут в монгу и держат сорцы в приват репо могут остаться на монге или нужно уже переезжать?
 Konstantin
ребят, всем привет, понимаю, что можно почитать, но все же, кто может подсказать, почему все так негативно реагируют на смену лицензии монги? Если в двух словах: магазин продуктов из 5 микросервисов, которые пишут в монгу и держат сорцы в приват репо могут остаться на монге или нужно уже переезжать?
это вообще касается только облачных провайдеров, которые продают монгу как сервис и конкурируют с Mongo Atlas, типа AWS, Azure, Google Cloud Platform и т. п., но при этом никак не спонсируют разрабов. обычным юзерам изменения вообще никак ни на что не влияет – то же опенсорс, хочешь ставь на свою машину, хочешь плати за атлас – всё как раньше…
brodyaga
это вообще касается только облачных провайдеров, которые продают монгу как сервис и конкурируют с Mongo Atlas, типа AWS, Azure, Google Cloud Platform и т. п., но при этом никак не спонсируют разрабов. обычным юзерам изменения вообще никак ни на что не влияет – то же опенсорс, хочешь ставь на свою машину, хочешь плати за атлас – всё как раньше…
Благодарю за разъяснение) Вопрос не давал покоя
Ок, интересно, а как тогда сейчас все клауды себя поведут?
Вы думаете эта лицензия у монги надолго или клауды просто переубедят монгу?)
brodyaga
Ну наверное монга в новых версиях зонды внедрит в серверный код или уже)
Daniil
Благодарю за разъяснение) Вопрос не давал покоя
Ок, интересно, а как тогда сейчас все клауды себя поведут?
Вы думаете эта лицензия у монги надолго или клауды просто переубедят монгу?)
Да пофиг в общем то как поведут, монга настроена хорошо продавать атлас, поэтому защищается как может, да и атлас крутой продукт
brodyaga
Да пофиг в общем то как поведут, монга настроена хорошо продавать атлас, поэтому защищается как может, да и атлас крутой продукт
Только для обычного разработчика, не бизнеса – атлас это жёсткий оверпрайс)
Такого же конфига можно добиться, если собрать инсталл у себя в кубе например, но будет в 5-6 раз дешевле, но бтв уже в оффтоп веду
Хотя тулинг в атласе да, классный
Daniil
Daniil
Или вообще себе на локальную машину поставить, этого же никто не запрещает
Daniil
А так аналогичный конфиг DBaaS всегда будет дороже чем аналогичный конфиг развёрнутый в принципе где угодно, тк ты платишь ещё за всякие плюшки вокруг
brodyaga
А так аналогичный конфиг DBaaS всегда будет дороже чем аналогичный конфиг развёрнутый в принципе где угодно, тк ты платишь ещё за всякие плюшки вокруг
+, единственная трабла, что пинг до атласа из России получается долгим)
brodyaga
Ну на этот кейс как понял, монга предлагает Ops-Manager
Или enterprise-kubernetes-operator
Daniil
Ну на этот кейс как понял, монга предлагает Ops-Manager
Или enterprise-kubernetes-operator
Монга в яндекс облаке))
Олег
День добрый, не подскажите как для последней монги убрать ограничение в 4cpu?
 Sergey
парни, такой вопрос... можно как-то дампануть из всех коллекций только N документов? надо для консистентности dev окружений
Sheff
https://docs.mongodb.com/manual/reference/method/ObjectId.getTimestamp/
а это можно сделать в pymongo? если можно можете показать пример, не могу найти, заранее спасибо)
Komronbek.
Как документ получить искомый документ ( find_one ) и скопировать ( это не знаю ) его в словарь ( python )