 Nikita


Потому что с монгой работаю
 Vladislav
Потому что с монгой работаю
Во первых паспорт дб агностик
Во вторых ошибка далеко не с монгой
@js_noobs_ru
Vladislav
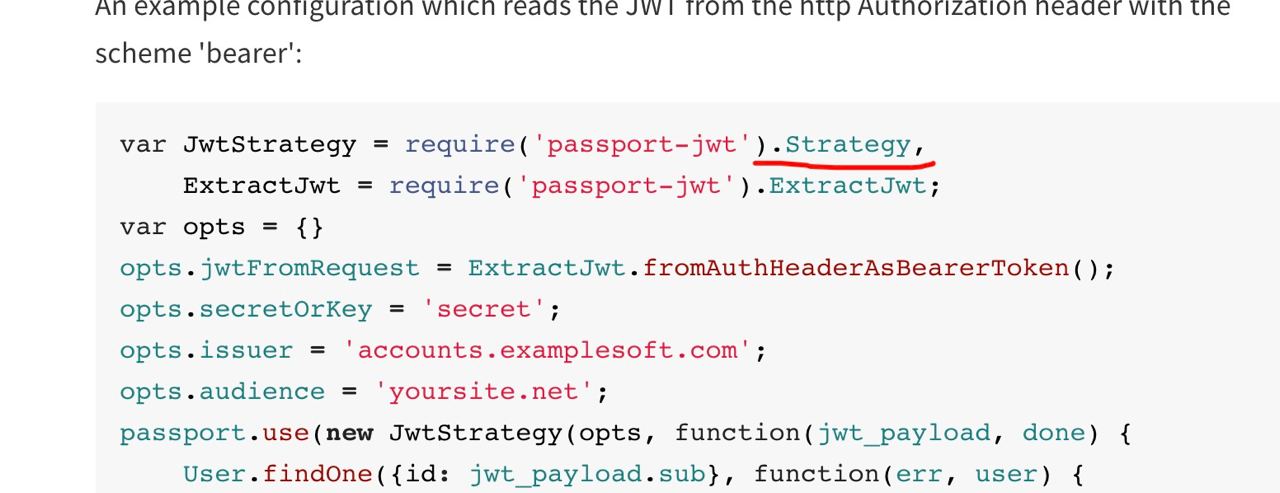
посмотри откуда надо импортировать стратегию
Nikita
const passport = require("passport")
const LocalStrategy = require('passport-local').Strategy
const JwtStrategy = require('passport-jwt')
const User = require('../models/user.js')
Nikita
вот мои импорты
Vladislav
 Ярослав
Кто-нибудь может подсказать, или ссылкой кинуть, мне интересно, если есть уникальный индекс на поле email (и дефолтный _id тоже есть) допустим, при шардировании монги он гарантирует эту уникальность при вставке нового документа?
 yopp
Кто-нибудь может подсказать, или ссылкой кинуть, мне интересно, если есть уникальный индекс на поле email (и дефолтный _id тоже есть) допустим, при шардировании монги он гарантирует эту уникальность при вставке нового документа?
https://docs.mongodb.com/manual/core/index-unique/#sharded-clusters-and-unique-indexes
Ярослав
 yopp
да
yopp
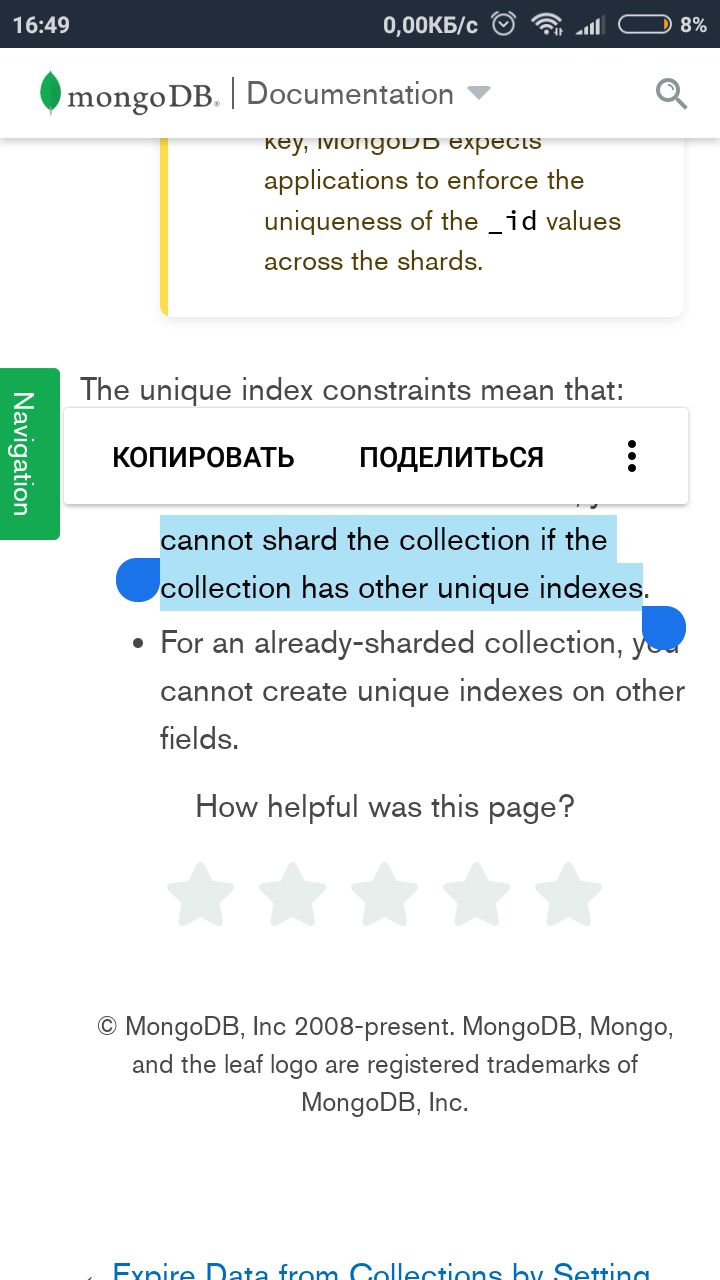
если вам нужен unique индекс, то только шардкей
 Artem
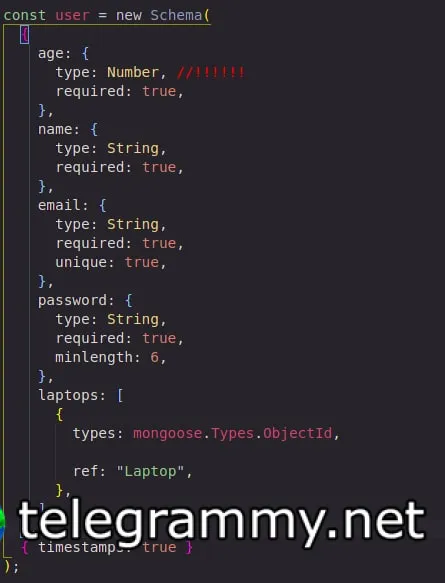 Artem
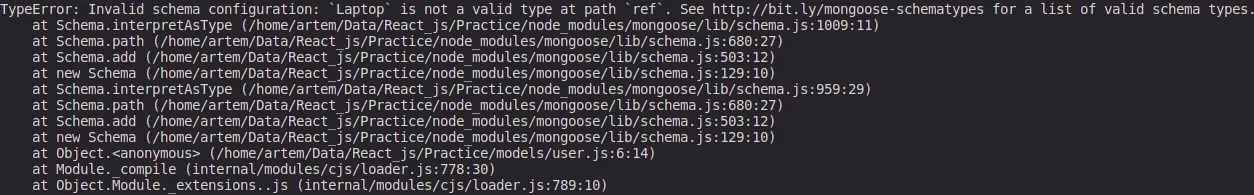 Artem
 Emad
Всем привет
{
_id: .....
likes:[ObjectId, ObjectId,...]
....
}
Есть коллекция и так выглядит ее документ
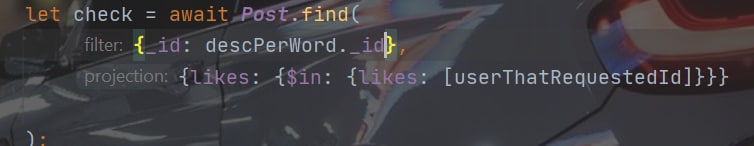
Я хочу квери которая будет искать по _id и проверять есть ли в массиве likes переданный мною айдишник, как я могу это реализовать
 Ilya
$in оператор
 Emad
 Emad
в чем ошибка моей квери
Ilya
likes: { $in: [1, 2] }
Ilya
оно будет работать
Ilya
$in это по сути простое или
Ярослав
Ярослав
Интересно, как большие компании, с большим кол-вом нагрузки, у которых бдшки наверняка шардированны, справляются с уникальностью некоторых полей в таблицах!?
Допустим им железобетонно нужно чтобы на всё приложение не было двух одинаковых email ни вкоем случае в бд.
Они что ли на уровне приложения делают эту проверку? Типа сначала запрос в бд а есть ли такой email, и если нету, то создай там запись с таким email. Но это же не гарантирует уникальность email'ов в бд ;D
Если вот между запросом на проверку существование емейла и вставкой в бд, другой поток вставит в бд с этим емейлом запись, то всё ж, пздц
if !userRepo.UserExistsByEmail(email) {
...... // Но вот тут же условно после проверки на существования емейла в бд что-то другое может вставить запись с таким емейлом ;D
// Вставка документа в бд
}
Или они начинают изощряться с какими-нибудь distributed lock через какой-нибудь redis?
success, err := redisClient.SetNX(context.Background(), "some_email@gmail.com, "any_value", time.Minute).Result()
if success {
// Вот тут уже проверка что в бд нету записи с таким емейлом и создании записи если ещё нету
// Не забываем снять лок в конце
_, err := redisClient.Del(context.Background(), "some_email@gmail.com").Result()
}
 behran
Ярослав
Через транзакции это решается. Если нужна атомарность данных
Во первых всё в контекста шардирования я имею ввиду.
В контексте монги вообще не понимаю как транзакция поможет в плане НЕ вставить дубликат с существующим емейлом в коллекцию.
Да и с классическими SQL бд тоже не совсем понимаю..
Представь что у тебя таблица/коллекция с пользователями шардирована на кусочки, по первых индексы если и будут, то для каждого шарда свои же
андрей
Привет, можно ли bson напрямую записать в монгу ?
 I
Там есть утилиты, backup и restore
I
В папке с монгой
I
Или юзать Studio 3t
yopp
Интересно, как большие компании, с большим кол-вом нагрузки, у которых бдшки наверняка шардированны, справляются с уникальностью некоторых полей в таблицах!?
Допустим им железобетонно нужно чтобы на всё приложение не было двух одинаковых email ни вкоем случае в бд.
Они что ли на уровне приложения делают эту проверку? Типа сначала запрос в бд а есть ли такой email, и если нету, то создай там запись с таким email. Но это же не гарантирует уникальность email'ов в бд ;D
Если вот между запросом на проверку существование емейла и вставкой в бд, другой поток вставит в бд с этим емейлом запись, то всё ж, пздц
if !userRepo.UserExistsByEmail(email) {
...... // Но вот тут же условно после проверки на существования емейла в бд что-то другое может вставить запись с таким емейлом ;D
// Вставка документа в бд
}
MongoDB does not support unique indexes across shards, except when the unique index contains the full shard key as a prefix of the inde
yopp
Решают через использование поля к которому есть требование уникальности как шард ключа
Ярослав
Решают через использование поля к которому есть требование уникальности как шард ключа
Ну представь у тебя классический _id все дела с индексом по уникальность, и тут второе поле появляется на котором тоже нужна уникальность ;) тут уже ж всё не так просто будет
Ярослав
MongoDB does not support unique indexes across shards, except when the unique index contains the full shard key as a prefix of the inde
Поэтому и интересно как решить вопрос уникальность на шардированных кластерах
yopp
Просто — никак. Масштабирование это всегда набор компромиссов
yopp
В 4.4 относительно просто — через транзакции
yopp
Т.е application level guaranties, если вы не можете использовать поле как префикс шард ключа.
_id как шард-ключ это так себе идея в любом случае, а так как есть требование уникальности, то у вас уже и так будет идентификатор который имеет гарантии эквивалентные _id
yopp
Ещё есть смешная опция денормализовать поле в отдельную коллекцию и не шардировать её :)
yopp
Нужно понимать, что любые гарантии в распределённом кластере, где писать можно в много мест сразу требуют какой-то синхронизации между всеми участниками. А такая синхронизация сама по себе нетривиальная задача
 Семён
Привет. Кто может помочь сохранить массивы перед перезагрузкой скрипта, а потом их запустить как скрипт включится.
Serhii
Привет. Есть ли возможность проиндексировать поле которое мы вычисляем динамически?
Есть коллекция, с такими документами:
{ members: { username1: { …}, username2: { …} }}.
Query выглядит примерно так, ‘members.username(имя юзера подставляем динамически)’: { $exists: true }.
 olga
Привет! У меня два вопроса, касающиеся нереляционных бд: 1) что делать, если получается много "связей" между коллекциями; 2) можно ли не юзать _id для того, чтобы связать две коллекции, а взять другое уникальное значение и потом не пожалеть?
Anonymous
Добрый день.
Есть ли возможность в Mongodb настроить политики хранения?
В Influxdb эту задачу решает RETENTION Policy
 D
Добрый вечер. Как можно узнать максимальную глубину вложенности документа в монге, желательно не прибегая к тупому рекурсивному перебору?
 Nick
Добрый день.
Есть ли возможность в Mongodb настроить политики хранения?
В Influxdb эту задачу решает RETENTION Policy
https://docs.mongodb.com/manual/core/index-ttl/
Nick
Добрый вечер. Как можно узнать максимальную глубину вложенности документа в монге, желательно не прибегая к тупому рекурсивному перебору?
вложенность по типу f1.f2.f3.f4.f5: 123 -> вложенность 5?
или у вас граф по связей между доками надо посчитать в глубину?
Nick
Привет! У меня два вопроса, касающиеся нереляционных бд: 1) что делать, если получается много "связей" между коллекциями; 2) можно ли не юзать _id для того, чтобы связать две коллекции, а взять другое уникальное значение и потом не пожалеть?
можно брать другое значение, при лукапе просто указывать условие мапинга. Главное индексы по этим полям иметь
D
вложенность по типу f1.f2.f3.f4.f5: 123 -> вложенность 5?
или у вас граф по связей между доками надо посчитать в глубину?
Ну насколько я понимаю, второе можно превратить в первое с помощью graphLookup
D
Вообще там массив маленьких объектов, содержащих ссылки на другие документы (в т.ч. друг на друга), и нужна именно глубина связей
olga
Nick
Вообще там массив маленьких объектов, содержащих ссылки на другие документы (в т.ч. друг на друга), и нужна именно глубина связей
ничего не подскажу, на обычном графе с циклами, а не дереве это на монге думаю не решить
 Oleh
olga
Спасибо, чекну)
 Max
Кто нибудь сталкивался с багом, когда делаешь обычную выборку с skip=1000 и limit=1000 - выдает результат 0, а если skip=1000 и limit=245 (ровно сколько осталось строк), то выдает 245? Версия монги 4.0.2-rc0
Nick
 Александр
 Александр
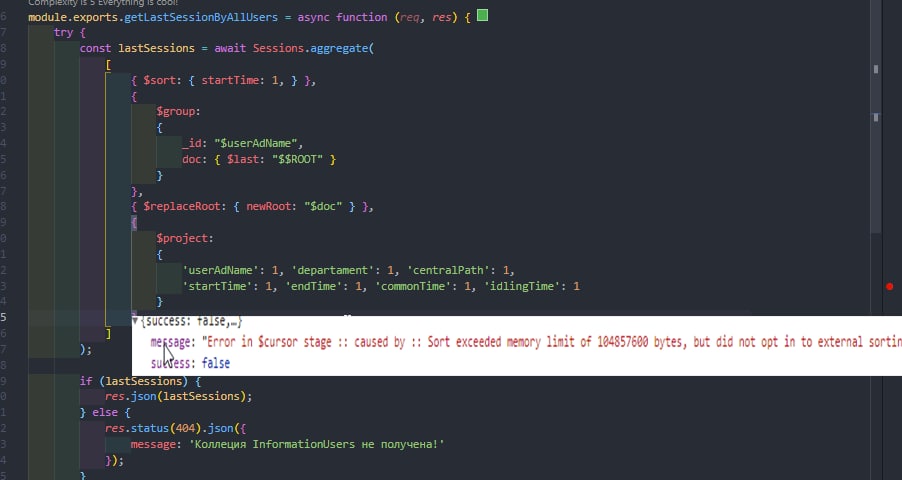
Документов стало больше и появилась такая ошибка
Александр
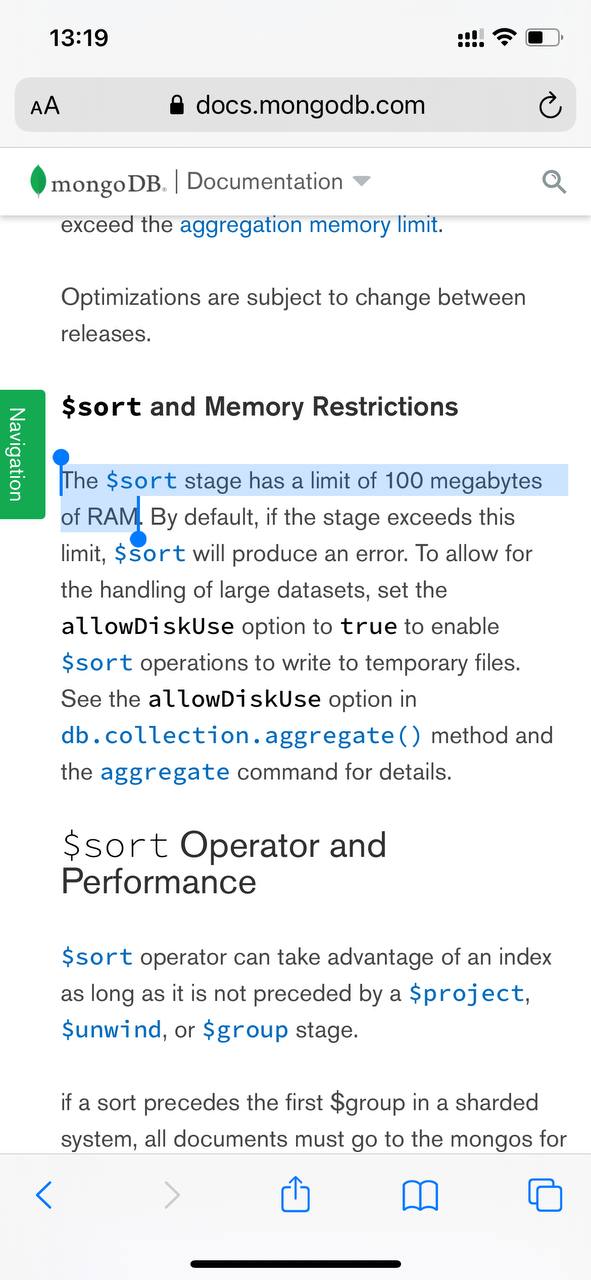
Поставил project перед sort все заработало, мб кто - нибудь пояснение дать по этому поводу ?
 Daniel
Я конечно не уверен, но вроде если вощникают прососы по памяти при поиске, то ты явно забыл про индексы
Vladislav
 Arthur
А если мне нужно в schema сделать некоторые ключи необязательными, для этого тоже нужно менять все объекты созданные по schema?
Ilya
не
 Игорь
 Joe
 Tilek
всем привет, у меня есть вопрос как можно сделать частичный back up базы
Vladislav
всем привет, у меня есть вопрос как можно сделать частичный back up базы
частичный это как? Последние X записей? Только определенные коллекции?
Tilek
частичный это как? Последние X записей? Только определенные коллекции?
Я хочу каждый месяц делать back up(на те данные которые за месяц накопились )
Vladislav
Я хочу каждый месяц делать back up(на те данные которые за месяц накопились )
https://stackoverflow.com/questions/7828817/is-it-possible-to-mongodump-the-last-x-records-from-a-collection
 germon
Добрый день. Пишу диплом, столкнулся с тем, что не могу реализовать его на реляционной бд, наткнулся на монго и теперь не могу его запустить. Скачал с офф сайта для винды, создал папки data\db, запустил через cmd путь к mongod.exe с указанием директории db, запустил через вторую консоль путь к mongod.exe ещё раз, выдаёт ошибку о том, что служба уже используется. Что я сделал не так?
yopp
Добрый день. Пишу диплом, столкнулся с тем, что не могу реализовать его на реляционной бд, наткнулся на монго и теперь не могу его запустить. Скачал с офф сайта для винды, создал папки data\db, запустил через cmd путь к mongod.exe с указанием директории db, запустил через вторую консоль путь к mongod.exe ещё раз, выдаёт ошибку о том, что служба уже используется. Что я сделал не так?
для подключения к базе вам необходимо использовать не mongod (это сам сервер), а просто mongo (без d, это клиет) или официальный GUI https://www.mongodb.com/products/compass
germon
благодарю!
yopp
Я хочу каждый месяц делать back up(на те данные которые за месяц накопились )
если у вас данные только добавляются и никогда не имзеняются или удаляются, то через query filter в mongodump https://docs.mongodb.com/v4.2/reference/program/mongodump/#cmdoption-mongodump-query
в обратном случае, к сожалению, никак
yopp
есть другой вариант делать резервные копии через слепки файловой системы
https://docs.mongodb.com/manual/tutorial/backup-with-filesystem-snapshots/
Дамир
Всем привет. Подскажите, пожалуйста, как в монгузе сделать запрос find сразу к нескольким моделям одной строкой?
Nick
Всем привет. Подскажите, пожалуйста, как в монгузе сделать запрос find сразу к нескольким моделям одной строкой?
find - метод модели, поэтому никак. Вы можете только подгрузить связанные данные через populate() если они имеются