 George


косяк понятный ) и надо его тупо недопускать
 Dmitry
Не хотел бы я работать на таком проекте. Программисты те ещё писатели, надо воспитывать как-то что-ли
да ладно, обычно дело жеж =)
George
 Alexander
тоже верно. Но в рамках стейджа же обычно другая команда может не ожидать, что треться команда решила потестить свой сервис с другой их версией. Все равно ведь хочется все это затетсить, потом в стейдж, потом в прод.
Ты имеешь в виду, что команда может выкатить чужой сервис на стейдж? Такое, конечно, недопустимо. Нужно тестить на тех версиях остальных компонентов, которые уже на стейдже.
Alexander
друг, это могут быть разрабы из вообще внешних команд. Или не часто общающихся друг с другом
Ну тогда вопросы к менеджменту :)
 Nikus
можно и так, да
в голову приходят nodeport и сервис с ext ip, ну, еще ingress. Есть еще варианты?
Nikus
И других вариантов нет получается?
Dmitry
Ты имеешь в виду, что команда может выкатить чужой сервис на стейдж? Такое, конечно, недопустимо. Нужно тестить на тех версиях остальных компонентов, которые уже на стейдже.
Не, что команда 1 ожидала что в стейдже у команды 16 будет сервис с версией v1.0.16, а команде 16 нужно выкатывать свою версию v1.0.15 и они щас тестят ее в этом стейдже и скоро выкатят в прод
 M
 Alexander
Не, что команда 1 ожидала что в стейдже у команды 16 будет сервис с версией v1.0.16, а команде 16 нужно выкатывать свою версию v1.0.15 и они щас тестят ее в этом стейдже и скоро выкатят в прод
Может, наоборот: ожидали v1.0.15, а тестят v1.0.16?
M
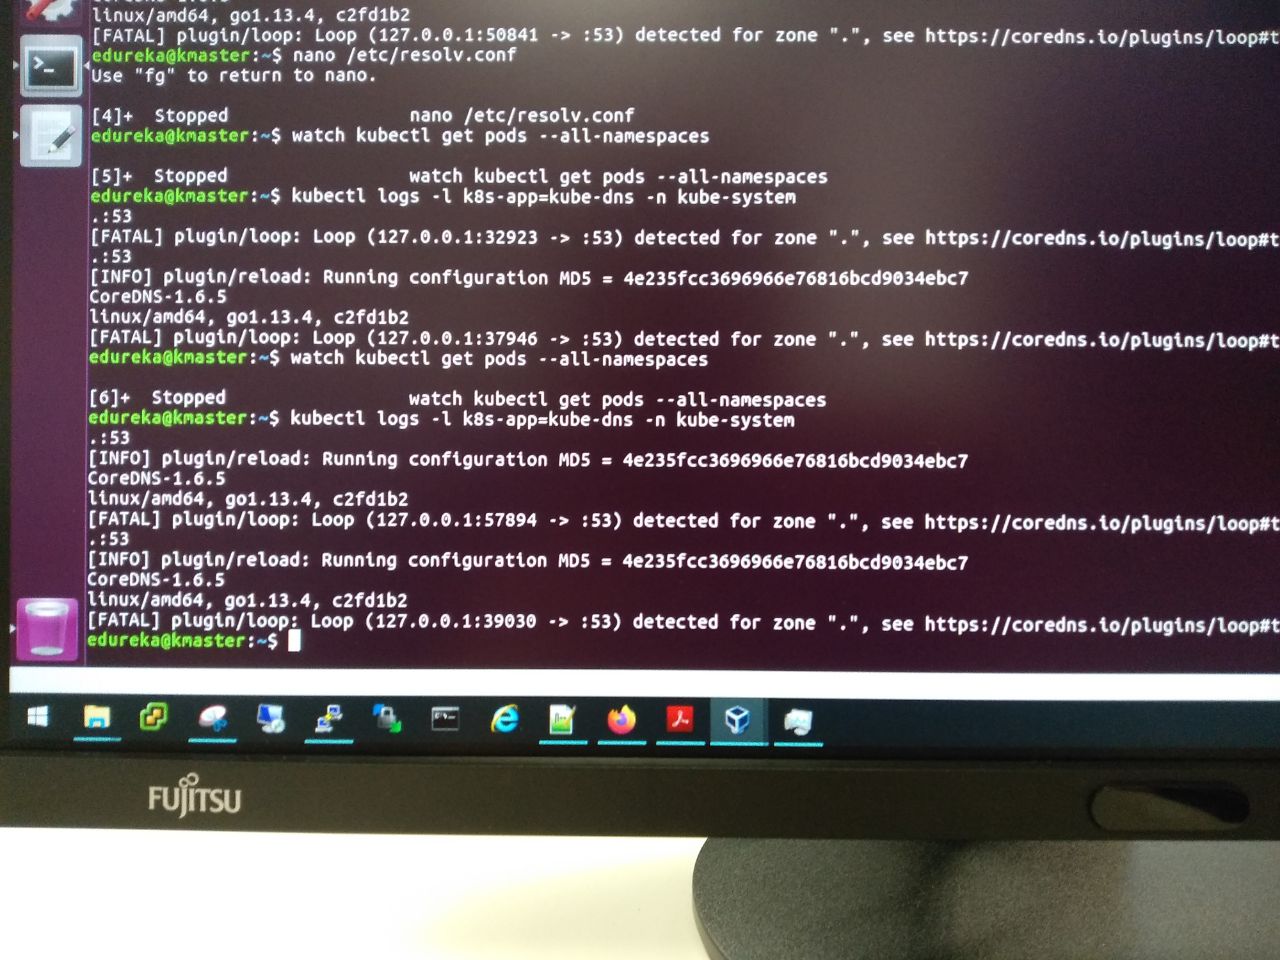
Что делать? Куда копать?
M
Всего два сервера мастер и нода
Dmitry
Может, наоборот: ожидали v1.0.15, а тестят v1.0.16?
не, типо ожидали последнюю develop версию v1.0.16, а у них стабильная в стейдже v1.0.15, а в проде v1.0.14. Ну это как пример просто. Версии же не важны
Dmitry
Alexander
не, типо ожидали последнюю develop версию v1.0.16, а у них стабильная в стейдже v1.0.15, а в проде v1.0.14. Ну это как пример просто. Версии же не важны
Тут тогда возникает вопрос о политике обратной совместимости в проектах.
Dmitry
Тут тогда возникает вопрос о политике обратной совместимости в проектах.
конечно. Если все будет круто с политикой, а программисты зайчики, это легко решить. На практике я обычно вижу обратное. Но я за обратную совместимость, всеми конечностями
M
по ссылке из логов ходил? Смотрел что пишут?
When a CoreDNS Pod deployed in Kubernetes detects a loop, the CoreDNS Pod will start to "CrashLoopBackOff". This is because Kubernetes will try to restart the Pod every time CoreDNS detects the loop and exits.
A common cause of forwarding loops in Kubernetes clusters is an interaction with a local DNS cache on the host node (e.g. systemd-resolved). For example, in certain configurations systemd-resolved will put the loopback address 127.0.0.53 as a nameserver into /etc/resolv.conf. Kubernetes (via kubelet) by default will pass this /etc/resolv.conf file to all Pods using the default dnsPolicy rendering them unable to make DNS lookups (this includes CoreDNS Pods). CoreDNS uses this /etc/resolv.conf as a list of upstreams to forward requests to. Since it contains a loopback address, CoreDNS ends up forwarding requests to itself.
There are many ways to work around this issue, some are listed here:
Add the following to your kubelet config yaml: resolvConf: <path-to-your-real-resolv-conf-file> (or via command line flag --resolv-conf deprecated in 1.10). Your "real" resolv.conf is the one that contains the actual IPs of your upstream servers, and no local/loopback address. This flag tells kubelet to pass an alternate resolv.conf to Pods. For systems using systemd-resolved, /run/systemd/resolve/resolv.conf is typically the location of the "real" resolv.conf, although this can be different depending on your distribution.
Disable the local DNS cache on host nodes, and restore /etc/resolv.conf to the original.
A quick and dirty fix is to edit your Corefile, replacing forward . /etc/resolv.conf with the IP address of your upstream DNS, for example forward . 8.8.8.8. But this only fixes the issue for CoreDNS, kubelet will continue to forward the invalid resolv.conf to all default dnsPolicy Pods, leaving them unable to resolve D
Alexander
конечно. Если все будет круто с политикой, а программисты зайчики, это легко решить. На практике я обычно вижу обратное. Но я за обратную совместимость, всеми конечностями
Как в таком случае, вообще, что-то работает, если разработчики плюют на ОС в патч-релизах и выкатывают их без уведомления других команд? Как на прод тогда деплоитесь?
Dmitry
Как в таком случае, вообще, что-то работает, если разработчики плюют на ОС в патч-релизах и выкатывают их без уведомления других команд? Как на прод тогда деплоитесь?
все ломается 🤷♂️так и живем, бизнесу так норм. Говорят зато быстрые релизы
Alexander
все ломается 🤷♂️так и живем, бизнесу так норм. Говорят зато быстрые релизы
Ну раз норм, то норм. Почему то, что норм в проде — не норм на стейдже?
Dmitry
Ну раз норм, то норм. Почему то, что норм в проде — не норм на стейдже?
В стейдже ломается как правило чаще, до прода не все поломки доедят, но могут доехать
Alexander
В стейдже ломается как правило чаще, до прода не все поломки доедят, но могут доехать
Ну и что, что ломается? Я-то исходил из того, что такая ситуация ненормальна, а в вводной оказалось, что это норма и просто часть выбранного руководством трейдофф-а. Тогда в чем проблема?
Dmitry
Ну и что, что ломается? Я-то исходил из того, что такая ситуация ненормальна, а в вводной оказалось, что это норма и просто часть выбранного руководством трейдофф-а. Тогда в чем проблема?
Ну с обозначенной проблемы. Люди пытаются тестить это и улучшать. Деплоить все сервисы скопом в отдельное окружение и тестить. Ну то есть проблема не выдуманна, просто по другому к ней подходят
Alexander
Ну с обозначенной проблемы. Люди пытаются тестить это и улучшать. Деплоить все сервисы скопом в отдельное окружение и тестить. Ну то есть проблема не выдуманна, просто по другому к ней подходят
Ну да, осознанно решили мириться к данным неудобством, получив при этом преимущество в виде быстрых релизов. Это не проблема, это компромисс. Проблема-то в чем?
Dmitry
Ну да, осознанно решили мириться к данным неудобством, получив при этом преимущество в виде быстрых релизов. Это не проблема, это компромисс. Проблема-то в чем?
Вот изначальное сообщение: https://t.me/kubernetes_ru/228254
Можете человека научить, как решать это другим способом. Я уже давно сдался пытаться менять политику. Но можете научить меня за одно, я только за =)
M
а в describe в евентах что пишет?
https://stackoverflow.com/questions/53075796/coredns-pods-have-crashloopbackoff-or-error-state/53414041#53414041
Alexander
Вот изначальное сообщение: https://t.me/kubernetes_ru/228254
Можете человека научить, как решать это другим способом. Я уже давно сдался пытаться менять политику. Но можете научить меня за одно, я только за =)
Да тут несложно, вроде. Берешь и эскалируешь. Желательно, подкрепив расчетом бюджета и показателями доступности сервиса: так и так, расходы на эксплуатацию из-за данной политики составляют X, потому что тратится время админов/девопсов/sre (или как там сейчас модно называть инженеров эксплуатации). При этом вклад в уровень доступности сервиса составляет -Y% (по бабкам, которые они на этом теряют, посчитают уже без тебя). Пишешь, ясное дело, продактам (можно с лидами разработки в копии).
Если команда эксплуатации большая и надо соблюдать субординацию, то убеждай сделать это руководителя, помогая при этом ему в сборе данных.
Если не катит, и при этом такие практики невыносимы для тебя лично — меняй работу, ее сейчас завались.
Alexander
https://stackoverflow.com/questions/53075796/coredns-pods-have-crashloopbackoff-or-error-state/53414041#53414041
Ты просто кидаешь сюда ссылки, которые тебе выдает гугл, или, все-таки, читаешь их?
Dmitry
Да тут несложно, вроде. Берешь и эскалируешь. Желательно, подкрепив расчетом бюджета и показателями доступности сервиса: так и так, расходы на эксплуатацию из-за данной политики составляют X, потому что тратится время админов/девопсов/sre (или как там сейчас модно называть инженеров эксплуатации). При этом вклад в уровень доступности сервиса составляет -Y% (по бабкам, которые они на этом теряют, посчитают уже без тебя). Пишешь, ясное дело, продактам (можно с лидами разработки в копии).
Если команда эксплуатации большая и надо соблюдать субординацию, то убеждай сделать это руководителя, помогая при этом ему в сборе данных.
Если не катит, и при этом такие практики невыносимы для тебя лично — меняй работу, ее сейчас завались.
спасибо, я как раз на пути к этому. Только расходы на эксплуатацию трудно посчитать
M
Читаю! Проблему решил!
Dmitry
Alexander
спасибо, я как раз на пути к этому. Только расходы на эксплуатацию трудно посчитать
Так а тебе и не надо с точностью до минуты/рубля. Главное — без откровенного вранья, а так плюс-минус километр вполне сойдет. Даже если у тебя оценка временных затрат команды на решение проблемы будет 20% времени с погрешностью в 5%, ничего критичного не будет (тем более, что даже если ты сам затрудняешься оценить, то никто со стороны тоже это сделать не сможет).
Alexander
Бизнесу главное — масштаб проблемы (желательно в бабках, но если он в состоянии их сам вывести, то тоже сойдет) и риски.
Dmitry
Так а тебе и не надо с точностью до минуты/рубля. Главное — без откровенного вранья, а так плюс-минус километр вполне сойдет. Даже если у тебя оценка временных затрат команды на решение проблемы будет 20% времени с погрешностью в 5%, ничего критичного не будет (тем более, что даже если ты сам затрудняешься оценить, то никто со стороны тоже это сделать не сможет).
Блин а хотели просто деплоить сервисы скопом для e2e тестов. Ну как так то =)
Alexander
Блин а хотели просто деплоить сервисы скопом для e2e тестов. Ну как так то =)
Могу тогда только посоветовать монорепу (ну или ее имитацию через git-repo) :)
Alexander
Пусть разработка потом страдает тоже :)
 Vadim
народ по трассировке запрос на сервиснейм сначала в инет лезет, также неправильно наверно
Vadim
как исправить это
George
народ по трассировке запрос на сервиснейм сначала в инет лезет, также неправильно наверно
.ndots в днс настройках ?
Vadim
options ndots:5
Vadim
есть в /etc/resolv.conf подов
Vadim
кибана не видит эластик, думаю из-за этого, и ваще вроде некоторые сервисы друг друга видят другие нет
George
Опции типа dnsSearch: ClusterFirst в описвнии деплоймента ?
Vadim
Опции типа dnsSearch: ClusterFirst в описвнии деплоймента ?
была, я ее убрал и без нее пробовал, но ваще щас тестовым metshoot контейнером проверяю
 Anonymous
Vadim
Опции типа dnsSearch: ClusterFirst в описвнии деплоймента ?
в resolv.conf в списке локальные домены идут, почему он не находит сервис в них и в инет лезет
George
в resolv.conf в списке локальные домены идут, почему он не находит сервис в них и в инет лезет
Резолв - это не абсолют
George
Сначала смотрится nsswitch.conf или как его там
George
И это реальное дно 😭
 да, это я
У тебя вариантов нет. Этот захардкожено
Я в курсе, я просто не понимаю, что тебе не нравится.
George
И тогда до resolv.conf может дело не дойти
George
Как вариант
George
Все может быть
George
Это же опенсурс 😂
No1
тогда нет смысла не доверять 🙂
Vadim
ну вот в алпайне нет nsswitch
Dmitry
resolv.conf тоже?
А resolv.conf это симлинк на /run/systemd/resolve/stub-resolv.conf а кофниг DNS вообше в /run/systemd/network/ где-нибудь =)
Vadim
у меня из пода адреса интернета пингуются, а внутренние Айпи не пингуются как так)
George
А resolv.conf это симлинк на /run/systemd/resolve/stub-resolv.conf а кофниг DNS вообше в /run/systemd/network/ где-нибудь =)
Только если у тебя запущен systemd-resolved
George
у меня из пода адреса интернета пингуются, а внутренние Айпи не пингуются как так)
Ты все проверил, что я тебе сказал ?
George
Бонус - проблема во всех подах ? Или в определенных ?
George
От ноды зависит ?
 Отделение Bereke Bank