 Etki


в чем реально выражается проблема? какие технические требования нарушаются?
 Max
в данный момент у нас просто запущен сервис который сам скедулит себе, хотим его расколоть на несколько джобов и получить больше профита от того что мы испоьзуем k8s
Max
например рестарт джобы ручками
Max
или еще какие то плюшки - который мы пока не знаем))
Etki
то есть пока проблемы с запуском жвм как таковой нет?
Max
ну вот я и справшиваю может вы мне расскажете какие плюшки еще можно сделать
 George
а для крон джобы просто рестарт
т.е. у вас нет критерия, что джоба должна быть сделана здесь и сейчас ?
George
тгогда какая ценность в том, чтобы писать свой шедюлер ?
George
тебе свой шедюлер нужен, если ты хочешь шедюлить таски, скажем, гарантированно чаще, чем раз в пять минут, НО при этом тебе нужно, чтобы таска гарантированно отрабатывала
George
придумываешь там какую-то схему синхронизации и поехало
Max
свой шедулер? то есть если использовать кронджоб это значит писать свой шедулер?
Max
то есть пока проблемы с запуском жвм как таковой нет?
проблема в неповоротливости этого распухшего менеджера джоб который делает абсолютно все внутри себя - и в основном все видно только в логах
George
свой шедулер? то есть если использовать кронджоб это значит писать свой шедулер?
нет, меня неправильно понял
Etki
крч, если ты стеснен в ресурсах (я тут подразумеваю время, а не деньги), то попробуй просто разбить на кронжобы и не волноваться за время запуска жвм
там уже поймешь, есть проблемы с запуском или нет
Max
крч, если ты стеснен в ресурсах (я тут подразумеваю время, а не деньги), то попробуй просто разбить на кронжобы и не волноваться за время запуска жвм
там уже поймешь, есть проблемы с запуском или нет
ну скажем так, мы уже обсудили и все сошлись на том что наш код в джвм лучше не рестартовать каждые 5 минут. Не хочется быть человеком, который придет скажет - ну ребят k8s не может не рестартовать, давайте либо рестартовать либо спарк
Max
у нас там и кешики и коннекшн пулы
Etki
ну, в текнолоджи индустрии есть удовлетворяющие и неудовлетворяющие требованиям решения, а хочется и не хочется это второе
 Отделение Bereke Bank
подскажите инструмент для следующей задачи. И вообще как это реализуется по человечески?))
Есть набор репозиториев/сервисов (штук 40). Нужно чтоб при пуше в любую ветку любого микросервиса деплоился весь этот зоопарк (в свой неймспейс типа feature_abcd и т.д).
Какой есть инструмент кроме Helm для этих задач? Сейчас вижу следующие затруднения:
1) деплойменты БД, редисы и прочее должны стартануть до приложений
2) откуда брать image tag приложений? Они должны где-то храниться получается
 Сергей
подскажите инструмент для следующей задачи. И вообще как это реализуется по человечески?))
Есть набор репозиториев/сервисов (штук 40). Нужно чтоб при пуше в любую ветку любого микросервиса деплоился весь этот зоопарк (в свой неймспейс типа feature_abcd и т.д).
Какой есть инструмент кроме Helm для этих задач? Сейчас вижу следующие затруднения:
1) деплойменты БД, редисы и прочее должны стартануть до приложений
2) откуда брать image tag приложений? Они должны где-то храниться получается
по второму пункту - хранить можно в редисе, предварительно записывая их туда из деплоя соседних контейнеров
Сергей
подскажите инструмент для следующей задачи. И вообще как это реализуется по человечески?))
Есть набор репозиториев/сервисов (штук 40). Нужно чтоб при пуше в любую ветку любого микросервиса деплоился весь этот зоопарк (в свой неймспейс типа feature_abcd и т.д).
Какой есть инструмент кроме Helm для этих задач? Сейчас вижу следующие затруднения:
1) деплойменты БД, редисы и прочее должны стартануть до приложений
2) откуда брать image tag приложений? Они должны где-то храниться получается
по поводу первого пункта,я думаю, поможет - https://kubernetes.io/docs/concepts/workloads/pods/init-containers/
George
подскажите инструмент для следующей задачи. И вообще как это реализуется по человечески?))
Есть набор репозиториев/сервисов (штук 40). Нужно чтоб при пуше в любую ветку любого микросервиса деплоился весь этот зоопарк (в свой неймспейс типа feature_abcd и т.д).
Какой есть инструмент кроме Helm для этих задач? Сейчас вижу следующие затруднения:
1) деплойменты БД, редисы и прочее должны стартануть до приложений
2) откуда брать image tag приложений? Они должны где-то храниться получается
1. Не проблема. Делаешь либо на уровне пайплайна, либо приложение должно ждать твои ресурсы (бд, редисы)
Отделение Bereke Bank
А ну еще должен быть доступ к манифестам всех остальных приложений. Ну тут вроде не сложно
Отделение Bereke Bank
George
Тег Гита -> тег образа
Отделение Bereke Bank
Тег Гита -> тег образа
ну так репа в которую пушат ничего не знает про теги остальных 39 реп. В этом изначальное затруднение
George
ну так репа в которую пушат ничего не знает про теги остальных 39 реп. В этом изначальное затруднение
А ты сделай тег лейтест на все
George
Ну, ты же должен знать относительно какой версии других прикладов линковаться
George
Добро пожаловать в микросервисный адок
 Вадим
Из latest только в тест окружениях деплоить, имхо
Вадим
Вообще интересный вопрос, мне этот же квест предстоит
Что, если деплоить изменившиеся сервисы по тегам, а в остальных дергать последний успешный pipeline?
https://gitlab.com/gitlab-org/gitlab-foss/issues/39099
Anonymous
как будет выгледить создания секрета для кубера для того что бы пулить имеджи в класте
kubectl create secret ИМЯМОЕГОРЕДЖЕСТРИ ИМЯСЕКРЕТА \
--docker-username=МОЙЮЗЕР --docker-password=МОЙ ПАРОЛЬ \
ВОТ так ?
Anonymous
Гитлаб
 Антон
А зачем при изменении одного сервиса деплоить все остальное?
Антон
Речь просто вот о чем: каждый сервис выполняет определенную функцию и мы должны знать, как до него добраться, URL. Почему измененный сервис, который только что возник, не может обращаться по известным урлам к ранее задеплоенным другим сервисам?
 Lucky SB
как будет выгледить создания секрета для кубера для того что бы пулить имеджи в класте
kubectl create secret ИМЯМОЕГОРЕДЖЕСТРИ ИМЯСЕКРЕТА \
--docker-username=МОЙЮЗЕР --docker-password=МОЙ ПАРОЛЬ \
ВОТ так ?
Нет. Та надо указать тип секрета специальный. В докн все есть ггулить k8s docker pull secret
Антон
Что изменится от того, что мы задеплоим старые сервисы ещё раз? Они ведь будут точно такими же
Антон
как будет выгледить создания секрета для кубера для того что бы пулить имеджи в класте
kubectl create secret ИМЯМОЕГОРЕДЖЕСТРИ ИМЯСЕКРЕТА \
--docker-username=МОЙЮЗЕР --docker-password=МОЙ ПАРОЛЬ \
ВОТ так ?
https://kubernetes.io/docs/tasks/configure-pod-container/pull-image-private-registry/ вот так
 M
 Lucky SB
Hell. Пять дев окружений, два стейджа. Плюч кучка прогерских. Один отрелизил новую версию, и ее неплохо было бы зажеплоить всюду
 Dmitry
 Serhii
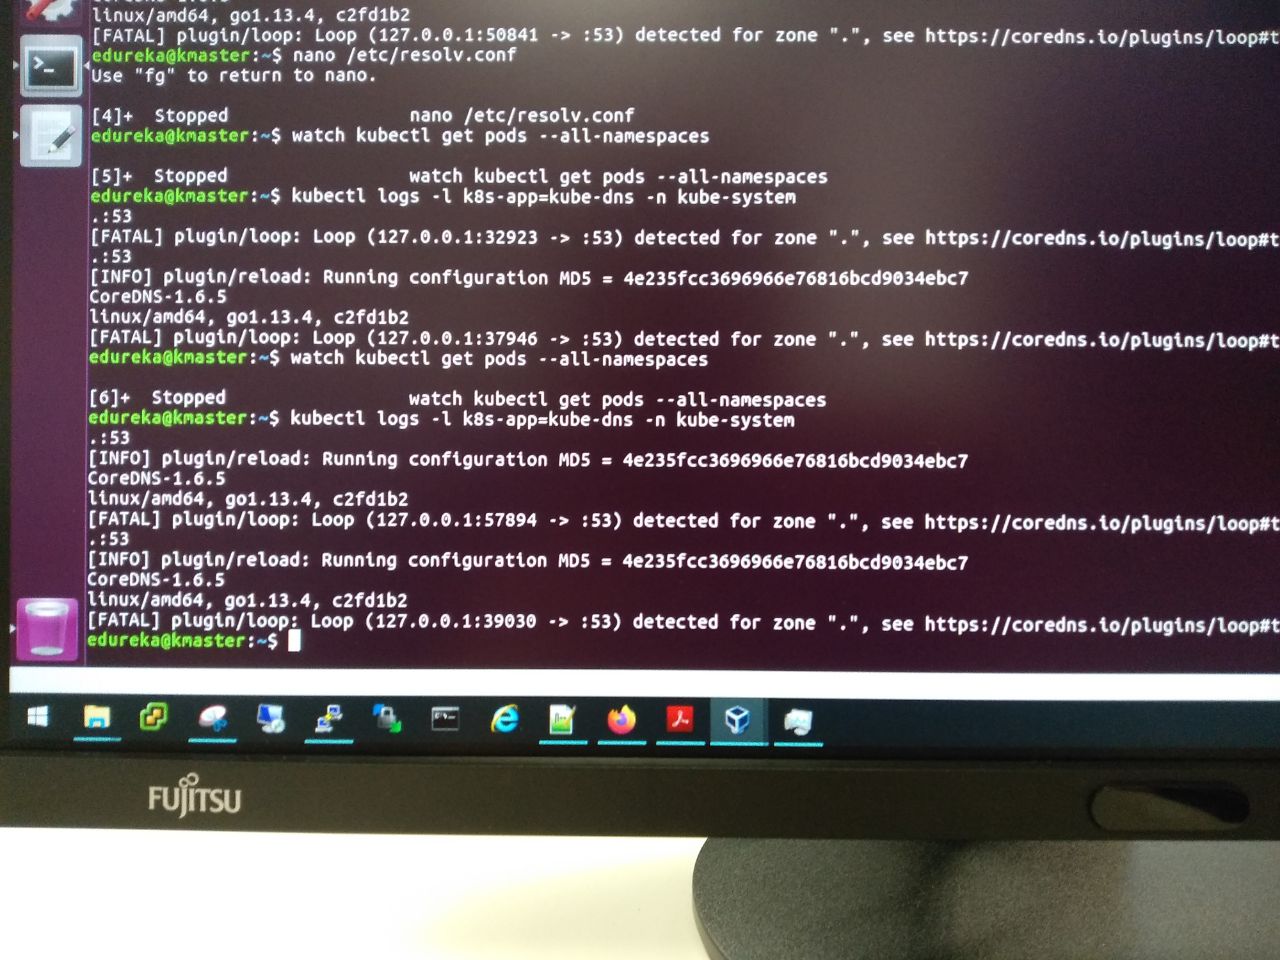
kubectl logs
George
George
вторая пачка - для целей отладки-разработки-тестирования
George
вот представь себе, что у тебя тестовый сервис задеплоился и он ходит в продакшен сервис - во-первых, это риски того, что данные в мусор, труху превратятся
 Alexander
подскажите инструмент для следующей задачи. И вообще как это реализуется по человечески?))
Есть набор репозиториев/сервисов (штук 40). Нужно чтоб при пуше в любую ветку любого микросервиса деплоился весь этот зоопарк (в свой неймспейс типа feature_abcd и т.д).
Какой есть инструмент кроме Helm для этих задач? Сейчас вижу следующие затруднения:
1) деплойменты БД, редисы и прочее должны стартануть до приложений
2) откуда брать image tag приложений? Они должны где-то храниться получается
Из вменяемого могу предложить только мета-репу на базе git-repo (который гугловый) и куча инклюдов в gitlab-ci.yml
Но, вообще, я бы лучше засетапить общий стейдж и гонял бы фичебранч-сборки отдельных компонентов, интегрируя из в общий стейдж.
George
а , во-вторых, у тебя может быть зависимость не от ТЕКУЩЕЙ версии сервиса в кластере (=последняя стабильная), а от какой-то еще не зарелизенной
Dmitry
вот представь себе, что у тебя тестовый сервис задеплоился и он ходит в продакшен сервис - во-первых, это риски того, что данные в мусор, труху превратятся
я думаю он имел в виду, тестовым сервисам ходить в стейджы
Антон
вот представь себе, что у тебя тестовый сервис задеплоился и он ходит в продакшен сервис - во-первых, это риски того, что данные в мусор, труху превратятся
Да кто ж вас в продакшн гонит? Держите долгоживущее дев окружение, и все дев сборки гоняйте через него
M
 Антон
Андрей
Привет, кто-нибудь ставил elasticsearch из официального helm repo эластика?
Dmitry
Да кто ж вас в продакшн гонит? Держите долгоживущее дев окружение, и все дев сборки гоняйте через него
ну я думаю человеку надо затетсить. 1 сервис v1.0.1 со вторым сервисом v2.03 с третьим v9.0.6 и так далее. И хочется все это задеплоить отдельно и прогнать e2e
Alexander
M
😂
Антон
а , во-вторых, у тебя может быть зависимость не от ТЕКУЩЕЙ версии сервиса в кластере (=последняя стабильная), а от какой-то еще не зарелизенной
А вот это уже плохая архитектура. Не надо так. Все сервисы в рамках одной версии апи должны друг с другом работать, не смотря на номер билдп
George
George
можно с тем же успехом рассуждать на тему того, что все внешние зависимости должны быть замоканы
Alexander
ну я думаю человеку надо затетсить. 1 сервис v1.0.1 со вторым сервисом v2.03 с третьим v9.0.6 и так далее. И хочется все это задеплоить отдельно и прогнать e2e
Ну пусть он деплоит в стейдж сервисы в порядке зависимостей. В прод же он все равно будет выкатывать не все скопом с даунтаймом.
Антон
ну я думаю человеку надо затетсить. 1 сервис v1.0.1 со вторым сервисом v2.03 с третьим v9.0.6 и так далее. И хочется все это задеплоить отдельно и прогнать e2e
Тогда выше правильно сказали, накатывать все из latest
Dmitry
George
George
если у тебя дизастер рекавери, то ты со своими зависимостями лососнешь
George
опять же вопрос - как ты будешь разруливать циклические зависимости сервисов
George
ну типа было:
сервис А и сервис Б. Независимые
George
в какой-то момент
Alexander
если у тебя дизастер рекавери, то ты со своими зависимостями лососнешь
Если у тебя дизастер, то деплой в любом удобном, ибо уже даунтайм.
George
Сервис А стал зависеть от Б. Потом спустя какое-то время сервис Б перестал стартовать без А.
George
ну, так написали программисты, никто этого не отловил, потому что деплоили уже в готовое окружение
George
пример фантастический, но тем не менее
Dmitry
Ну пусть он деплоит в стейдж сервисы в порядке зависимостей. В прод же он все равно будет выкатывать не все скопом с даунтаймом.
тоже верно. Но в рамках стейджа же обычно другая команда может не ожидать, что треться команда решила потестить свой сервис с другой их версией. Все равно ведь хочется все это затетсить, потом в стейдж, потом в прод.
Антон
Не хотел бы я работать на таком проекте. Программисты те ещё писатели, надо воспитывать как-то что-ли
George
 Nikus
Всем привет!
А у кого-нибудь был такой супер странный кейс, чтобы заставить работать к8с с реджистри, который хостится на этом же самом к8с?
Alexander
Сервис А стал зависеть от Б. Потом спустя какое-то время сервис Б перестал стартовать без А.
За такое могу посоветовать только пиздить ногами. Ну или наймите архитектора, если у программистов с дизайном архитекруры системные проблемы.
George
За такое могу посоветовать только пиздить ногами. Ну или наймите архитектора, если у программистов с дизайном архитекруры системные проблемы.
друг, это могут быть разрабы из вообще внешних команд. Или не часто общающихся друг с другом