 Roman


так которого ингресса анотации будет ЛБ принимать?
 Andrey
никакого
Andrey
у тебя nginx ingress controller
Roman
ну и я ему передаю настройки
Roman
annotations = {
"kubernetes.io/ingress.class" = "nginx"
"service.beta.kubernetes.io/do-loadbalancer-protocol" = "http"
"service.beta.kubernetes.io/do-loadbalancer-algorithm" = "least_connections"
"service.beta.kubernetes.io/do-loadbalancer-sticky-sessions-type" = "cookies"
"service.beta.kubernetes.io/do-loadbalancer-sticky-sessions-cookie-name" = "setup-do-lb"
"service.beta.kubernetes.io/do-loadbalancer-sticky-sessions-cookie-ttl" = "60"
"service.beta.kubernetes.io/do-loadbalancer-enable-proxy-protocol" = "true"
}
Roman
иначе непередать никак
Andrey
все аннотации service.beta.kubernetes.io/do- можно выкинуть, они не будут работать для nginx
Roman
ну работают вроде
Roman
весь конфиг для лб проставился
Andrey
с чего ты взял, что он проставился из аннотаций ингреса?
 Lucky SB
Это шмагия тераформа. Нафигачил нкпойми ченго и вроде как чото работает
Roman
создался лб в ДО
Roman
и там конфиг поменялся
Lucky SB
Почитал бы ты чем ингресс от сервиса отличается
Andrey
ну, тогда это DO-шники игнорируют ingress class
Andrey
ладно, ещё один первоклассник начал изучать интегрирование до таблицы умножения. Пойду работать
Roman
ладно молчу
Roman
Почитал бы ты чем ингресс от сервиса отличается
а как тогда хотя бы "service.beta.kubernetes.io/do-loadbalancer-enable-proxy-protocol" = "true"
передать балансеру?
Roman
надо понимать nginx controller создал LoadBalancer ресурс
Roman
понятно The client IP address will be set based on the use of PROXY protocol or from the X-Forwarded-For header value when use-forwarded-headers is enabled
Andrey
надо понимать nginx controller создал LoadBalancer ресурс
вот через него и управляй lb. Для остального читай доки nginx
Andrey
Хм. Наверное мне следует посмотреть какие экспортеры есть у какого-нибудь nginx-ingress-controller
Необязательно пользоваться экспортерами, достаточно дергать апи, получать метрику и отправлять в pushgateway прома, influx, итд.
 Dmitry
Делимся очередным полезным переводом — на сей раз с большой блок-схемой по подходу к troubleshooting'у в Kubernetes: https://habr.com/ru/company/flant/blog/484954/
 Evgeny
ops D
 Viktor
Кто нибудь собирался с kaniko в yandex cloud managed kubernetes ?
 Alexander
Всем привет
Подскажите, пожалуйста, кто сталкивался с такой проблемой
Мне нужно пробрасывать реальный client ip внутрь пода, но вместо этого приходит ip lb
Пробовал поставить externalTrafficPolicy: Local, запросы отваливаются по таймауту
Кластер bare metal, canico, metallb, ingress-nginx
 Peter
Всем привет
Подскажите, пожалуйста, кто сталкивался с такой проблемой
Мне нужно пробрасывать реальный client ip внутрь пода, но вместо этого приходит ip lb
Пробовал поставить externalTrafficPolicy: Local, запросы отваливаются по таймауту
Кластер bare metal, canico, metallb, ingress-nginx
Привет, у nginx ingress есть прокси протокол. Но если у тебя трансляция идет на уровне metallb то тебе сначала там стоит почитать документацию
Peter
Всем привет
Подскажите, пожалуйста, кто сталкивался с такой проблемой
Мне нужно пробрасывать реальный client ip внутрь пода, но вместо этого приходит ip lb
Пробовал поставить externalTrafficPolicy: Local, запросы отваливаются по таймауту
Кластер bare metal, canico, metallb, ingress-nginx
Забыл добавить, если ты ставишь externalTrafficPolicy: Local то поды должны быть на той же ноде куда приходит трафик. Так как там отключена трансляция и форвардинг. Можешь сделать externalTrafficPolicy: Local в связке с DaemonSet. Проблема тут в том что почти все поды будут простаивать без нагрузки.
cent
Коллеги, а как можно раздебажить nginx proxy_pass в istio?
Если врубить envoy то я получаю в nginx 404 в простейшем кофиге, вроде
proxy_http_version 1.1;
location /some {
proxy_pass http://some_upstream;
}
Alexander
Забыл добавить, если ты ставишь externalTrafficPolicy: Local то поды должны быть на той же ноде куда приходит трафик. Так как там отключена трансляция и форвардинг. Можешь сделать externalTrafficPolicy: Local в связке с DaemonSet. Проблема тут в том что почти все поды будут простаивать без нагрузки.
понял, "запросы отваливаются по таймауту" скорее всего в этом проблема, спасибо
Roman
коллеги, может кто-то сможет подсказать, как для helm можно добавить репозиторий на сервере без выхода в интернет?
$ helm repo add stable https://kubernetes-charts.storage.googleapis.com
 Russia9
Здравствуйте. Вопрос по kubespray/ansible.
Когда выполняю команду
ansible-playbook -i inventory/mycluster/hosts.yml cluster.yml -b -v \
--private-key=~/.ssh/id_ecdsa
Выдает ошибку:
TASK [download : download | Download files / images] *****************************************************************************************************************************************
Thursday 23 January 2020 12:29:01 +0300 (0:00:00.020) 0:00:00.365 ******
fatal: [node1]: FAILED! => {"msg": "with_dict expects a dict"}
 Dmitry
Здравствуйте. Вопрос по kubespray/ansible.
Когда выполняю команду
ansible-playbook -i inventory/mycluster/hosts.yml cluster.yml -b -v \
--private-key=~/.ssh/id_ecdsa
Выдает ошибку:
TASK [download : download | Download files / images] *****************************************************************************************************************************************
Thursday 23 January 2020 12:29:01 +0300 (0:00:00.020) 0:00:00.365 ******
fatal: [node1]: FAILED! => {"msg": "with_dict expects a dict"}
в плейбуке нужен словарь там где написано with_dict.... 😊
Dmitry
Привет всем. :) Есть вопрос:
В наличии rancher 2.3.4 и kubernetes 1.17 - на новом пустом кластере загрузка CPU kernel-space (sys) - стабильно 25-30% на всех ядрах.
Подов которые что-то могут есть - в наличии нет. Куда копать? Нет ли известных каких-то проблем с 1.17?
Lucky SB
Привет всем. :) Есть вопрос:
В наличии rancher 2.3.4 и kubernetes 1.17 - на новом пустом кластере загрузка CPU kernel-space (sys) - стабильно 25-30% на всех ядрах.
Подов которые что-то могут есть - в наличии нет. Куда копать? Нет ли известных каких-то проблем с 1.17?
ssh node-1 ; man top
и смотри какой процесс работает.
видимо кублет. а процессоры у тебя слабенькие
Dmitry
ну в общем да, он в топе
Dmitry
а делать то с ним что? ))))
Lucky SB
Здравствуйте. Вопрос по kubespray/ansible.
Когда выполняю команду
ansible-playbook -i inventory/mycluster/hosts.yml cluster.yml -b -v \
--private-key=~/.ssh/id_ecdsa
Выдает ошибку:
TASK [download : download | Download files / images] *****************************************************************************************************************************************
Thursday 23 January 2020 12:29:01 +0300 (0:00:00.020) 0:00:00.365 ******
fatal: [node1]: FAILED! => {"msg": "with_dict expects a dict"}
бывает... мало данных для анализа.
версия кубспрея, версия ансибля,
выкладывай полный инвентарь со всеми переменными и полный лог на пастебин.
Russia9
в плейбуке нужен словарь там где написано with_dict.... 😊
А откуда его взять? В доках по kubespray не сказано об этом
Lucky SB
может у тебя 100 емпти дир-томов на хосте и кублет постоянно du им делает
Alex
Dmitry
какие процессоры стоят
выяснилось, что наше ИБ могло поставить auditbeat / journalbeat, поэтому в топе ни чего ценного нету. Пока ищу способ выключить на одной ноде и посмотреть результат...
Anonymous
Привет, скажите пожалуйста как понять какие плагины подключены у coreDNS который в minikube
Lucky SB
Привет, скажите пожалуйста как понять какие плагины подключены у coreDNS который в minikube
зайти в под и посмотреть конфиг. аив.
 Slach
https://youtrack.jetbrains.com/issue/IDEA-231265
Народ, а поставьте VOTE если не трудно
Andrei
вопрос будет ли трафик литься с 2-х ip если установить 2 ingress в один namespace
helm install stable/nginx-ingress --namespace=test1 --name=v1
helm install stable/nginx-ingress --namespace=test1 --name=v2
 Григорий
Подскажите пожалуйста
Чтобы под рестартовал заново при apply даже если ничего не изменилось, что и куда прописывать?
 Igor
Подскажите пожалуйста
Чтобы под рестартовал заново при apply даже если ничего не изменилось, что и куда прописывать?
удалить и создать заново не пойдет ?
Григорий
это некрасивое решение)
там должна быть какая-то policy
Peter
Подскажите пожалуйста
Чтобы под рестартовал заново при apply даже если ничего не изменилось, что и куда прописывать?
Используй helm
В противном случае можете определить в деплойменте какую нибудь переменную, например
metadata:
annotations:
variable: ${VAR}
а потом делай что то наподобие VAR=date %s && kubectl apply -f
Григорий
Спасибо, да, тоже подумал примерно о таком решении
 Alexander
коллеги, может кто-то сможет подсказать, как для helm можно добавить репозиторий на сервере без выхода в интернет?
$ helm repo add stable https://kubernetes-charts.storage.googleapis.com
Подними реверс-прокси у себя. Или купи артифактори, если лень.
Cholovik
Привет
У меня вопрос
Равны ли запросы для Cgroups CPU shares при работе Kubernetes на нодах с разным количеством ядер (используя Docker)?
Я провел пару экспериментов
На 8 ядерной системе и на 4 ядерной выставлял 100m реквест CPU для контейнера в Kubernetes
в обоих случаях он прокидывался в итоге до уровня cgroups одинаково (как собственно я и ожидал)
cpu.shares=102
В документации Kubernetes в разделе “Meaning of CPU” написано
https://kubernetes.io/docs/concepts/configuration/manage-compute-resources-container/#meaning-of-cpu
CPU is always requested as an absolute quantity, never as a relative quantity; 0.1 is the same amount of CPU on a single-core, dual-core, or 48-core machine.
Что меня немного смутило, но чуть ниже есть еще раздел
“How Pods with resource limits are run”
https://kubernetes.io/docs/concepts/configuration/manage-compute-resources-container/#how-pods-with-resource-limits-are-run
И там пишут про трансформацию:
When using Docker:
- The spec.containers[].resources.requests.cpu is converted to its core value, which is potentially fractional, and multiplied by 1024. The greater of this number or 2 is used as the value of the --cpu-shares flag in the docker run command.
Из чего я сделал вывод что
0.1 is the same amount of CPU on a single-core, dual-core, or 48-core machine
0.1 в любой ситуации преобразуется в 100m (это я проверял тоже) и в шары везде протечет значение 102 . Получается имелось в виду что при задании реквествов тебе не надо что-то считать, но т.к. shares используется в расчете как коэффициенты:
Шара – это относительный числовой параметр; его значение имеет смысл только в сравнении со значениями других шар, входящих в ту же cgroup
то в итоге все равно мы на разных системах будем получать разную мощность при одинаковых реквестах.
Если кто-то детально изучал вопрос, помогите пожалуйста
 Sergey
подписываюсь, интересный вопрос
Alexander
Привет
У меня вопрос
Равны ли запросы для Cgroups CPU shares при работе Kubernetes на нодах с разным количеством ядер (используя Docker)?
Я провел пару экспериментов
На 8 ядерной системе и на 4 ядерной выставлял 100m реквест CPU для контейнера в Kubernetes
в обоих случаях он прокидывался в итоге до уровня cgroups одинаково (как собственно я и ожидал)
cpu.shares=102
В документации Kubernetes в разделе “Meaning of CPU” написано
https://kubernetes.io/docs/concepts/configuration/manage-compute-resources-container/#meaning-of-cpu
CPU is always requested as an absolute quantity, never as a relative quantity; 0.1 is the same amount of CPU on a single-core, dual-core, or 48-core machine.
Что меня немного смутило, но чуть ниже есть еще раздел
“How Pods with resource limits are run”
https://kubernetes.io/docs/concepts/configuration/manage-compute-resources-container/#how-pods-with-resource-limits-are-run
И там пишут про трансформацию:
When using Docker:
- The spec.containers[].resources.requests.cpu is converted to its core value, which is potentially fractional, and multiplied by 1024. The greater of this number or 2 is used as the value of the --cpu-shares flag in the docker run command.
Из чего я сделал вывод что
0.1 is the same amount of CPU on a single-core, dual-core, or 48-core machine
0.1 в любой ситуации преобразуется в 100m (это я проверял тоже) и в шары везде протечет значение 102 . Получается имелось в виду что при задании реквествов тебе не надо что-то считать, но т.к. shares используется в расчете как коэффициенты:
Шара – это относительный числовой параметр; его значение имеет смысл только в сравнении со значениями других шар, входящих в ту же cgroup
то в итоге все равно мы на разных системах будем получать разную мощность при одинаковых реквестах.
Если кто-то детально изучал вопрос, помогите пожалуйста
Реевесты - это в первую очередь количество ресурсов для аллокатора. На хостах из него выводится только относительный приоритет сигрупп в потреблении cpu (исходя из соотношения между реквестами разных контейнеров). При этом эти веса начинают работать только если cpu всем не хватает. Если нужно жестко управлять ресурсами, доступными контейнерам, используй limits.
Cholovik
Реевесты - это в первую очередь количество ресурсов для аллокатора. На хостах из него выводится только относительный приоритет сигрупп в потреблении cpu (исходя из соотношения между реквестами разных контейнеров). При этом эти веса начинают работать только если cpu всем не хватает. Если нужно жестко управлять ресурсами, доступными контейнерам, используй limits.
Спасибо, я все это понимаю, я просто пытаюсь закрепить все что знаю по этому вопросу, и вот тут потерялся немного.
Я хочу понять что произойдет когда действительно есть конкуренция за выделение ресурсов через CFS, но не рассматривая лимиты.
Насколько я могу судить, если мы возьмем 2 ноды с 8 и 4 ядрами, с идентичными конфигурациями (количество и веса) всех cgroups, то по итогу моя нагрузка с реквестом в 100m на 8 ядерной системе он всегда будет получать большее количество процессорного времени?
Что по сути противоречит утверждению - 0.1 is the same amount of CPU on a single-core, dual-core, or 48-core machine
P.S. Если интересно зафиксировать дискуссию я создал еще вопрос на тостере - https://qna.habr.com/q/702960
 Roman
мне кажется, то что ты говоришь это про cpu.shares. но в кубере не shares, а cpu.cfs_quota_us которая абсолютная а не относительная.
upd а нет вру, нифига cfs_quota_us не выставляется только для реквестов, хотя мне почему-то казалось что выставляется
Alexander
Спасибо, я все это понимаю, я просто пытаюсь закрепить все что знаю по этому вопросу, и вот тут потерялся немного.
Я хочу понять что произойдет когда действительно есть конкуренция за выделение ресурсов через CFS, но не рассматривая лимиты.
Насколько я могу судить, если мы возьмем 2 ноды с 8 и 4 ядрами, с идентичными конфигурациями (количество и веса) всех cgroups, то по итогу моя нагрузка с реквестом в 100m на 8 ядерной системе он всегда будет получать большее количество процессорного времени?
Что по сути противоречит утверждению - 0.1 is the same amount of CPU on a single-core, dual-core, or 48-core machine
P.S. Если интересно зафиксировать дискуссию я создал еще вопрос на тостере - https://qna.habr.com/q/702960
Абсолютное значение requests на ноде играет слабую роль. Оно влияет только на shares, который относителен и, соответственно, его влияение определяется конкретной ситуацией: сколько соседей, какое количество ресурсов они потребляют и т.д.
 𝚔𝚟𝚊𝚙𝚜
Вопрос на засыпку: если разместить etcd-кластер на серверах с разными мощностями, то скорость etcd будет зависеть от самого слабого из них?
Cholovik
мне кажется, то что ты говоришь это про cpu.shares. но в кубере не shares, а cpu.cfs_quota_us которая абсолютная а не относительная.
upd а нет вру, нифига cfs_quota_us не выставляется только для реквестов, хотя мне почему-то казалось что выставляется
Вы немного путаете понятия
CPU requests в Kubernetes преобразуется в Docker CpuShares (можно увидеть сделав docker inspect) а они в свою очередь в cgroups cpu.shares
CPU limits будут представлены в виде Docker CpuPeriod и CpuQuota
cpu.cfs_period_us и cpu.cfs_quota_us соответственно
Alex
Вопрос на засыпку: если разместить etcd-кластер на серверах с разными мощностями, то скорость etcd будет зависеть от самого слабого из них?
В elasticsearch именно так. Обычно во всех кластерах БД с синхронной репликацией именно так. по etcd не нашел такого упоминания. Что за вопросы от гуру? :)
𝚔𝚟𝚊𝚙𝚜
В elasticsearch именно так. Обычно во всех кластерах БД с синхронной репликацией именно так. по etcd не нашел такого упоминания. Что за вопросы от гуру? :)
Ну вот пора заводить новый акк для тупых вопросов, этот уже прокачан до 80lvl :)
 Pavel
Вопрос на засыпку: если разместить etcd-кластер на серверах с разными мощностями, то скорость etcd будет зависеть от самого слабого из них?
на самом деле скорость будет зависеть от самого медленного только в случае если без него невозможно принятие решения кворумом. Так как при записи данных требуется подтверждение не от всех, а только от большинства.
𝚔𝚟𝚊𝚙𝚜
Cholovik
Да, пишут только про консенсус
Raft is only as fast as the slowest machine in the majority. You can mitigate this issue by properly tuning the cluster. etcd has been pre-tuned on cloud providers with highly variable networks.
https://etcd.io/
 Victor
Привет
У меня вопрос
Равны ли запросы для Cgroups CPU shares при работе Kubernetes на нодах с разным количеством ядер (используя Docker)?
Я провел пару экспериментов
На 8 ядерной системе и на 4 ядерной выставлял 100m реквест CPU для контейнера в Kubernetes
в обоих случаях он прокидывался в итоге до уровня cgroups одинаково (как собственно я и ожидал)
cpu.shares=102
В документации Kubernetes в разделе “Meaning of CPU” написано
https://kubernetes.io/docs/concepts/configuration/manage-compute-resources-container/#meaning-of-cpu
CPU is always requested as an absolute quantity, never as a relative quantity; 0.1 is the same amount of CPU on a single-core, dual-core, or 48-core machine.
Что меня немного смутило, но чуть ниже есть еще раздел
“How Pods with resource limits are run”
https://kubernetes.io/docs/concepts/configuration/manage-compute-resources-container/#how-pods-with-resource-limits-are-run
И там пишут про трансформацию:
When using Docker:
- The spec.containers[].resources.requests.cpu is converted to its core value, which is potentially fractional, and multiplied by 1024. The greater of this number or 2 is used as the value of the --cpu-shares flag in the docker run command.
Из чего я сделал вывод что
0.1 is the same amount of CPU on a single-core, dual-core, or 48-core machine
0.1 в любой ситуации преобразуется в 100m (это я проверял тоже) и в шары везде протечет значение 102 . Получается имелось в виду что при задании реквествов тебе не надо что-то считать, но т.к. shares используется в расчете как коэффициенты:
Шара – это относительный числовой параметр; его значение имеет смысл только в сравнении со значениями других шар, входящих в ту же cgroup
то в итоге все равно мы на разных системах будем получать разную мощность при одинаковых реквестах.
Если кто-то детально изучал вопрос, помогите пожалуйста
Вот это правильно заданный вопрос - моё почтение! :)
А вот что меня смущает, что куб считает cpu threads за полноценные ядра при планировании ресурсов. Где-то читал что для того же Golang это может быть проблема на нагруженной системе, так как он будет планировать тред на одни и те же физические ядра, что сведет на нет плюсы многопоточности для математики, которая не ходит в память.
Victor
Также остается нерешенной проблема разных по характеристикам CPUв одном кластере (например, с разной производительностью на Мгц)
Cholovik
Также остается нерешенной проблема разных по характеристикам CPUв одном кластере (например, с разной производительностью на Мгц)
Спасибо, хочу закрыть гештальт, не могу уже видеть эти ресурсы :)
Victor
Спасибо, хочу закрыть гештальт, не могу уже видеть эти ресурсы :)
Пока на 100% тоже не разобрался, но прошел тоже через весь ваш путь.
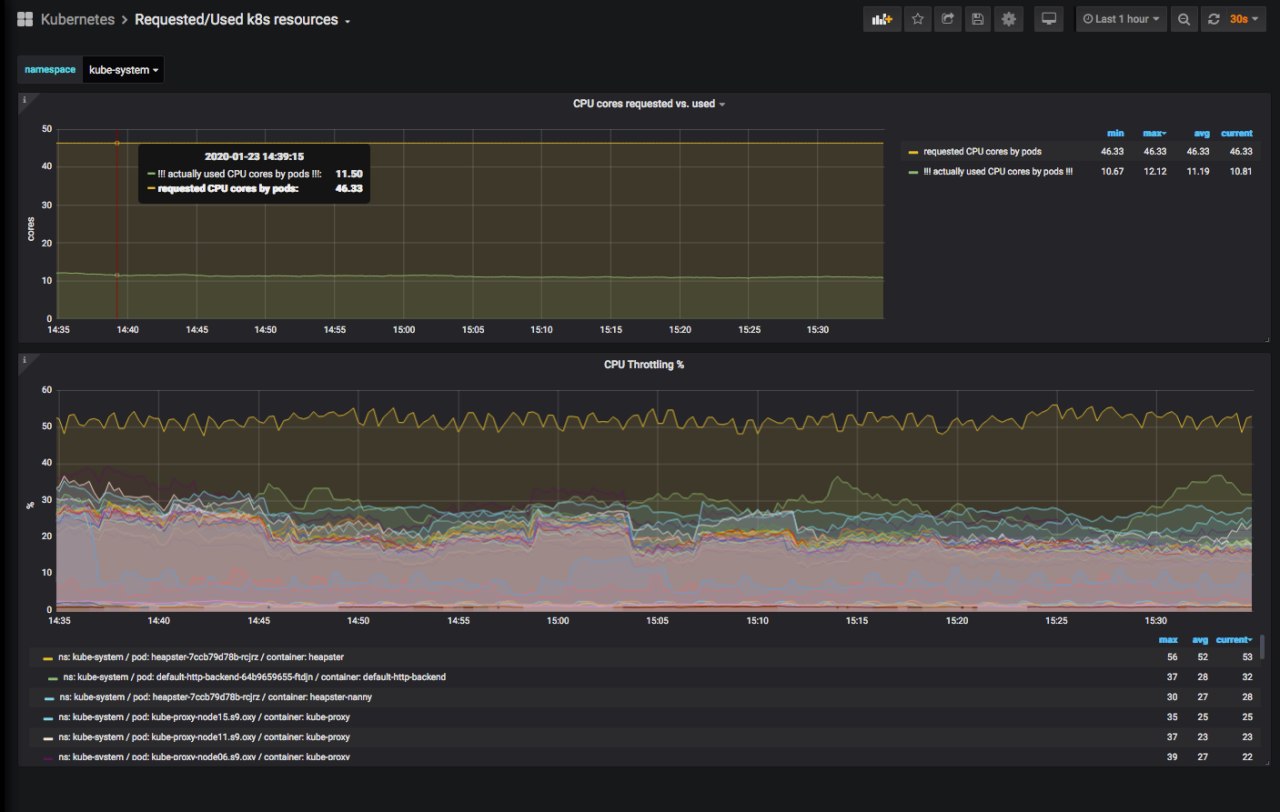
В итоге - у нас на графиках появились метрики про тротлинг.
Victor
 Victor
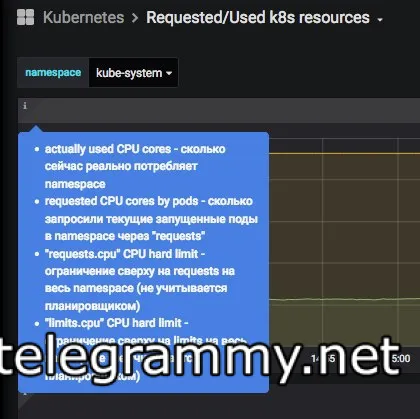
там еще лимиты показывает, но для kube-system их нет
Victor
 Victor
Спасибо, хочу закрыть гештальт, не могу уже видеть эти ресурсы :)
Также рекомендую всем читать вот эту статью
https://medium.com/@betz.mark/understanding-resource-limits-in-kubernetes-cpu-time-9eff74d3161b
Sergey
 Sergei
для гпу это не актуально, у вас вся карта прокидывается